Ложка супа и тяжёлый шар
После этого урока ты посчитаешь число обновлений за эпоху, значение learning rate по любому расписанию и первый шаг Adam — и объяснишь, чем schedule отличается от optimizer.
Повар сварил суп на 50 000 порций и хочет понять, досолить ли. Всю кастрюлю он, понятно, не съедает: размешивает и пробует ложку. Вопрос на интуицию: если взять вместо ложки черпак в 100 раз больше, во сколько раз надёжнее станет вердикт?
Не в 100. В 10. А супа на пробу уйдёт в 100 раз больше.
На этой арифметике держится обучение всех больших сетей: градиент ошибки там тоже пробуют ложкой. В последнем уроке разберёмся, почему ложке можно верить, что делать с тем, что она слегка врёт, и при чём тут тяжёлый шар, который катится по оврагу.
Вся кастрюля, одна капля или ложка
В уроке 13 шаг спуска выглядел просто: посчитать градиент ошибки и сдвинуть веса против него. Только ошибка сети — это среднее по всем примерам training set:
- \(N\)
- число примеров в training set
- \(E(\vb{x}_n, \vb{w})\)
- ошибка на одном примере, например \((t_n - g(\vb{x}_n|\vb{w}))^2\)
Значит, и градиент — среднее \(N\) градиентов. Один честный шаг требует прогнать через сеть все примеры: при \(N = 50\,000\) это пятьдесят тысяч forward и backward pass ради одного маленького сдвига весов. Профессор говорит об этом коротко (лекция 2, слайд 27): считать по всем точкам — "unpractical".
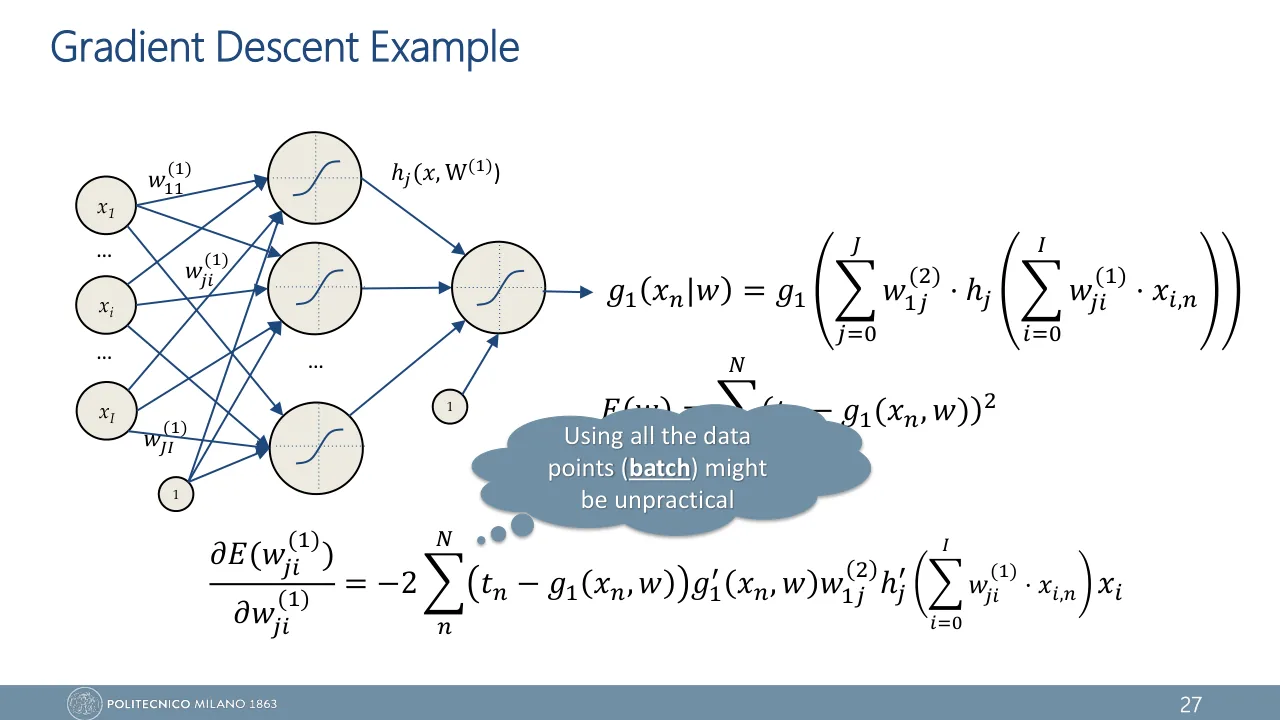
Попробовать суп можно тремя способами. Они отличаются только тем, по скольким примерам усредняют градиент перед каждым шагом.
Batch gradient descent — вся кастрюля. Градиент точный, но на каждый шаг уходит весь датасет.
\[ \pd{E(\vb{w})}{\vb{w}} = \frac{1}{N}\sum_{n=1}^{N} \pd{E(\vb{x}_n, \vb{w})}{\vb{w}} \]Stochastic gradient descent (SGD) — одна капля: шаг по одному случайно выбранному примеру. Ключевые слова профессора (лекция 2, слайд 28): unbiased, но high variance.
\[ \pd{E(\vb{w})}{\vb{w}} \approx \pd{E(\vb{x}_n, \vb{w})}{\vb{w}} \]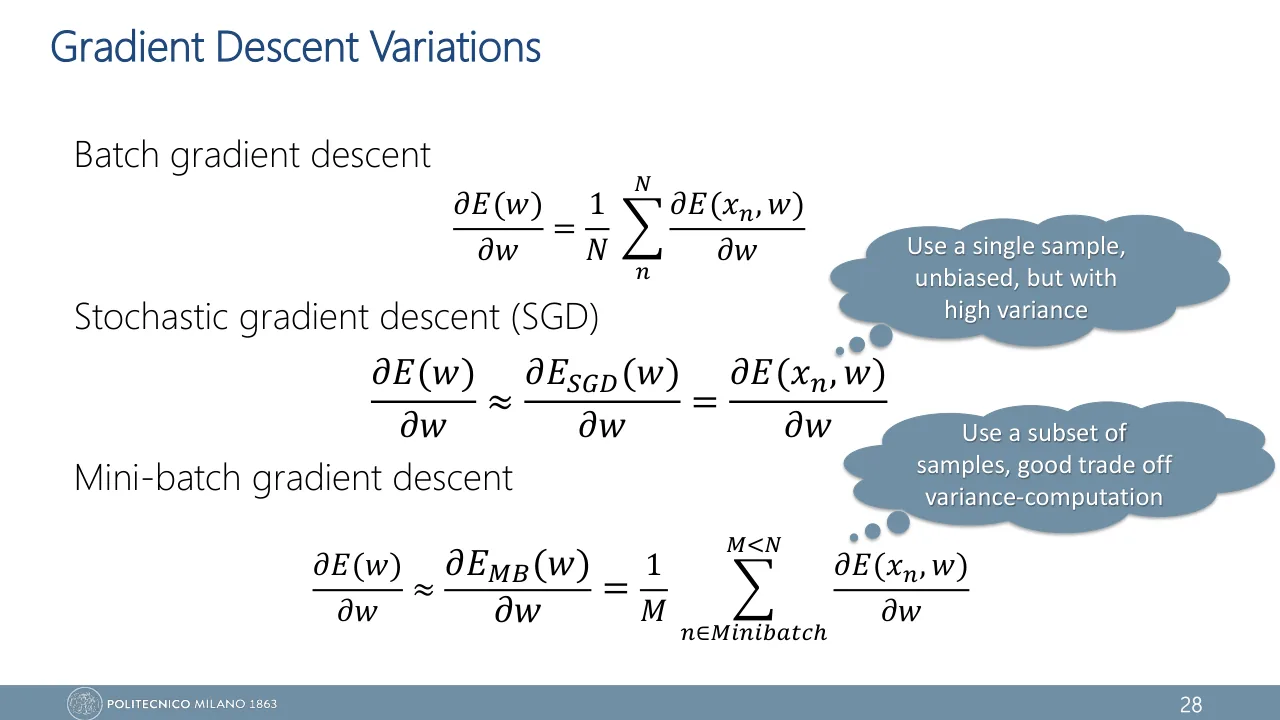
Mini-batch gradient descent — ложка: среднее по \(M\) случайным примерам, \(M \lt N\). На том же слайде про него сказано: "good trade off variance-computation".
\[ \pd{E(\vb{w})}{\vb{w}} \approx \frac{1}{M}\sum_{n \in \text{mini-batch}} \pd{E(\vb{x}_n, \vb{w})}{\vb{w}} \]Что значат unbiased и variance, разберём в следующем разделе. Сначала — сколько шагов даёт каждый способ. Для этого нужны два слова.
Iteration — одно обновление весов. Epoch (эпоха) — один полный проход по training set. В одной эпохе \(\lceil N / M \rceil\) iterations.
| Способ | Примеров на шаг | Обновлений за эпоху | Оценка градиента |
|---|---|---|---|
| Batch | 50 000 | 1 | точная |
| SGD | 1 | 50 000 | unbiased, high variance |
| Mini-batch, \(M = 32\) | 32 | 1563 | unbiased, variance в 32 раза меньше |
| Mini-batch, \(M = 256\) | 256 | 196 | unbiased, variance в 256 раз меньше |
Откуда 1563: \(50\,000 / 32 = 1562.5\). Это 1562 полных mini-batch и один «хвост» из 16 примеров. Хвост — тоже обновление, поэтому округляют вверх.
Рисунок 1 — это весь алгоритм из листинга 9 конспекта. В начале каждой эпохи датасет перемешивают, режут на куски по \(M\) примеров и для каждого куска делают одно обновление: веса сдвигаются против градиента, посчитанного только по этому куску.
Перемешивание — то самое «размешать суп». Если примеры лежат по порядку (сначала все кошки, потом все собаки), ложка из верхнего слоя расскажет только про кошек.
«SGD — это всегда один пример на шаг». У профессора (лекция 2, слайд 28) и в конспекте — да. Но в Keras, PyTorch и почти во всех статьях словом SGD называют mini-batch SGD, а batch size там — это размер mini-batch. На экзамене держись определений слайда, в коде — читай документацию.
И ещё один термин из конспекта. Среднюю ошибку по датасету \(E(\vb{w})\) там называют empirical risk. Она стоит на месте величины, которую хочется минимизировать на самом деле, — true risk, ожидаемой ошибки на любом примере из распределения данных \(D\):
\[ \E_{(\vb{x},\,t) \sim D}\bigl[E(\vb{x}, \vb{w})\bigr] \]Посчитать true risk нельзя: \(D\) неизвестно, есть только \(N\) примеров из него. Поэтому математическое ожидание заменяют средним по этим примерам — и минимизируют его.
Почему ложке можно верить
Градиент по mini-batch — это среднее по случайной выборке. Про такие средние ты всё знаешь из Applied Statistics: выборочное среднее в среднем попадает в истинное, а его стандартная ошибка равна \(\sigma / \sqrt{n}\). Перенесём это на градиент за четыре шага.
-
Оценка по mini-batch — среднее \(M\) градиентов отдельных примеров. Обозначим её \(\vb{g}_{MB}\) (буква \(g\) здесь от слова gradient, это не выход сети):
\[ \vb{g}_{MB} = \frac{1}{M}\sum_{n \in \text{mini-batch}} \nabla E(\vb{x}_n, \vb{w}) \] -
Примеры в mini-batch выбраны случайно. Поэтому каждое слагаемое в среднем равно среднему по всему датасету, то есть полному градиенту:
\[ \E\bigl[\vb{g}_{MB}\bigr] = \nabla E(\vb{w}) \]Оценка несмещённая (unbiased): она ошибается, но не систематически.
-
Градиенты отдельных примеров разбросаны вокруг полного. Пусть дисперсия одной их компоненты равна \(\sigma^2\). У среднего \(M\) независимых слагаемых дисперсия в \(M\) раз меньше:
\[ \operatorname{Var}\bigl[g_{MB}\bigr] = \frac{\sigma^2}{M} \] -
Типичная ошибка оценки — корень из дисперсии:
\[ \text{шум оценки} = \frac{\sigma}{\sqrt{M}} \]Это та самая стандартная ошибка среднего. Mini-batch в 100 раз больше стоит в 100 раз дороже, а шум уменьшает в \(\sqrt{100} = 10\) раз.
В разделе конспекта про mini-batch слов unbiased и variance нет: там градиент просто «noisy». На слайде они есть (лекция 2, слайд 28), и на экзамене отвечать нужно именно ими.
Что из этого следует
Большой mini-batch покупает точность по невыгодному курсу: от \(M = 32\) к \(M = 3200\) шаг дорожает в 100 раз, а шум падает только в 10. Слишком маленький тоже плох: простаивает GPU, а статистики batch normalization из урока 26 считаются по горстке примеров и шумят. Поэтому обычно начинают с \(M\) = 32, 64 или 128.
Шум не исчезает у минимума. Полный градиент там равен нулю, а градиенты отдельных примеров — нет: каждому примеру хочется сдвинуть веса в свою сторону. Поэтому спуск с постоянным \(\eta\) не останавливается, а дрожит в «шумовом шаре». Шар тем больше, чем больше \(\eta\) и чем меньше \(M\).
Отсюда связь двух ручек: размах дрожания определяется отношением \(\eta / M\). Увеличив mini-batch в \(k\) раз, обычно увеличивают в \(k\) раз и \(\eta\) — это называют linear scaling rule.
| Свойство | Маленький, \(1 \le M \le 32\) | Большой, \(256 \le M \le 8192\) |
|---|---|---|
| Стоимость шага | очень низкая | очень высокая |
| Обновлений за эпоху | очень много | очень мало |
| Шум градиента | высокий | низкий |
| Сходимость | быстрая, но шумная | гладкая, но медленнее в расчёте на пример |
| Параллелизм GPU | используется плохо | используется хорошо |
У шума есть и польза — о ней стр. 196 конспекта. Случайные толчки помогают спуску выбраться из мелкого локального минимума и не застрять на плато, где точный градиент почти нулевой. И они мешают сети подогнать веса под каждый пример в отдельности: шум работает как regularizer.
«Маленький mini-batch обобщает лучше — это закон». На стр. 196 конспекта цепочка «большой mini-batch → sharp minima → плохая generalization» подана как факт. Это часто наблюдаемый эффект и популярное объяснение, но не теорема: если заново подобрать \(\eta\) и добавить warm-up, разница во многом исчезает. На экзамене пиши осторожно: «is often observed», «acts as a regularizer».
Расписание: длинные шаги в начале, короткие в конце
В виджете клубок у минимума сжимался, стоило уменьшить \(\eta\). Но маленький \(\eta\) с самого начала — это медленный спуск, который легко вязнет на плато. А слишком большой, как в уроке 13, качается или расходится. Выход напрашивается: менять \(\eta\) по ходу обучения. Сначала идти широким шагом, чтобы быстро спуститься со склона, потом укорачивать шаг, чтобы перестать прыгать через ручей на дне.
Learning rate schedule (расписание шага обучения) — заранее заданная функция \(\eta_t\) от номера эпохи \(t\). Она не смотрит на градиенты и одна для всех весов.
В конспекте четыре расписания, формулы (81)–(84). Везде \(\eta_0\) — стартовое значение, \(t\) — номер эпохи.
Step decay — лестница: каждые \(s\) эпох шаг умножается на число \(\mathrm{drop}\), например на 0.5.
\[ \eta_t = \eta_0 \cdot \mathrm{drop}^{\lfloor t / s \rfloor} \]Exponential decay — плавное убывание: за каждую эпоху шаг уменьшается в одно и то же число раз.
\[ \eta_t = \eta_0\, e^{-\lambda t} \]1/t decay — убывание медленнее экспоненты; классическое правило из теории stochastic approximation. Его смысл: шаги убывают достаточно медленно, чтобы в сумме пройти любое расстояние до минимума, и достаточно быстро, чтобы шум к концу затих.
\[ \eta_t = \frac{\eta_0}{1 + \lambda t} \]Cosine annealing — половинка косинуса: медленно в начале, быстро в середине, снова медленно к концу, и ровно ноль на последней эпохе \(T\).
\[ \eta_t = \frac{\eta_0}{2}\left(1 + \cos\frac{\pi t}{T}\right) \]| Расписание | Параметры | Эпоха \(t\) | \(\eta_t\) |
|---|---|---|---|
| step decay | \(\mathrm{drop} = 0.5\), \(s = 10\) | 25 | \(0.1 \cdot 0.5^2 = 0.025\) |
| exponential | \(\lambda = 0.05\) | 20 | \(0.1 \cdot e^{-1} \approx 0.0368\) |
| 1/t | \(\lambda = 0.1\) | 20 | \(0.1 / 3 \approx 0.0333\) |
| cosine | \(T = 100\) | 25 | 0.0854 |
| cosine | \(T = 100\) | 50 | 0.05 |
| cosine | \(T = 100\) | 75 | 0.0146 |
Warm-up — обратная идея для самого начала: первые \(T_w\) эпох шаг не убывает, а линейно растёт от нуля до значения из расписания.
\[ \eta_t^{\text{warm}} = \frac{t}{T_w}\,\eta_t, \qquad t \lt T_w \]Зачем: в первые шаги веса случайные, градиенты большие, а у Adam (о нём ниже) ещё не накоплена статистика. Широкий шаг в этот момент может забросить сеть туда, откуда она долго выбирается. В коде warm-up нередко считают не в эпохах, а в iterations: формула та же, только \(t\) — номер обновления. В конспекте warm-up не разобран; на стр. 199 упомянуты только warm restarts, а это другое.
«Шаг уменьшают, потому что к концу обучения градиенты маленькие». Наоборот: маленький градиент сам укорачивает сдвиг \(\eta\,\nabla E\). Причина в шуме: с постоянным \(\eta\) спуск по mini-batch не сходится, а дрожит в шаре, который растёт вместе с \(\eta\). Уменьшаешь \(\eta\) — сжимаешь шар.
Насколько сужается полоса, если уменьшить шаг вдвое?
В \(\sqrt{2}\) раз, а не в два. В нижнем графике вес обновляется так: \(w \leftarrow (1 - \eta)\,w - \eta\,\sigma\,\xi\), где \(\xi\) — случайный шум с единичной дисперсией. Когда дрожание установилось, дисперсия \(V\) веса после шага равна дисперсии до шага:
\[ V = (1 - \eta)^2\,V + \eta^2 \sigma^2 \] \[ V = \frac{\eta\,\sigma^2}{2 - \eta} \approx \frac{\eta\,\sigma^2}{2} \]Дисперсия пропорциональна \(\eta\), значит, ширина полосы — \(\sqrt{\eta}\). Чтобы сжать дрожание в 10 раз, шаг нужно уменьшить в 100.
Тяжёлый шар: momentum
Расписание решает, какой длины шаг. Но есть беда, которую длиной шага не вылечить, — овраг (ravine): поверхность ошибки, крутая в одном направлении и пологая в другом.
Возьмём самый простой овраг — вытянутую чашу:
\[ E(w_1, w_2) = \tfrac{1}{2}\left(0.2\,w_1^2 + 10\,w_2^2\right) \]Поперёк оврага, по \(w_2\), кривизна равна 10; вдоль, по \(w_1\), — всего 0.2. На параболе с кривизной \(c\) спуск расходится при \(\eta \gt 2/c\) (так было в уроке 13), поэтому предел \(\eta \lt 0.2\) диктует крутая стенка. А вдоль дна один шаг проходит долю \(0.2\,\eta\) оставшегося пути: даже при \(\eta = 0.18\) это меньше 4 %.
Получается вилка. Большой \(\eta\) — зигзаг от стенки к стенке. Маленький \(\eta\) — зигзага нет, но вдоль дна спуск ползёт. Один общий шаг не подходит обоим направлениям.
Momentum даёт весам инерцию. Вместо шага по текущему градиенту заводят скорость \(\vb{v}\), которая помнит прошлые шаги:
- \(\vb{v}_k\)
- скорость (velocity), в начале \(\vb{v}_0 = 0\)
- \(\alpha\)
- momentum coefficient, \(0 \le \alpha \lt 1\), обычно 0.9
- \(k\)
- номер обновления (iteration)
- \(\nabla E(\vb{w}_k)\)
- градиент в точке \(\vb{w}_k\); на слайдах он записан как \(\pd{E(w)}{w}\big|_{w^{k}}\)
Если развернуть рекурсию, скорость окажется суммой всех прошлых градиентов с убывающими весами:
\[ \vb{v}_k = -\eta \sum_{j \ge 0} \alpha^{j}\,\nabla E(\vb{w}_{k-j}) \]Вдоль дна оврага все градиенты смотрят в одну сторону и складываются. При постоянном градиенте \(g\) с \(\eta\,g = 0.01\) и \(\alpha = 0.9\) сдвиги растут: 0.010, 0.019, 0.027, …, 0.065 на десятом шаге — и стремятся к пределу
\[ \abs{v_\infty} = \frac{\eta\,\abs{g}}{1 - \alpha} = \frac{0.01}{0.1} = 0.1 , \]в десять раз больше обычного шага. Поперёк оврага шар перелетает дно, градиент меняет знак, и его вклады в скорость гасят друг друга: качания затухают.
Без momentum: \(\alpha = 0\)
С momentum: \(\alpha = 0.9\)
Шар не идеален: он тяжёлый и не умеет тормозить. Он раскачивается и может проскочить минимум. Поэтому с momentum берут \(\eta\) поменьше — скорость всё равно накопится.
У профессора momentum записан иначе, чем в конспекте. Формула стоит на двух слайдах: лекция 2, слайд 24, и лекция 3, слайд 38 (в углу напечатано 39). Второй называется "Recall about Backpropagation" и повторяет первый. Ошибка \(E(w)\) на обоих записана суммой квадратов без \(1/N\): постоянный множитель просто уходит в \(\eta\). Сравни:
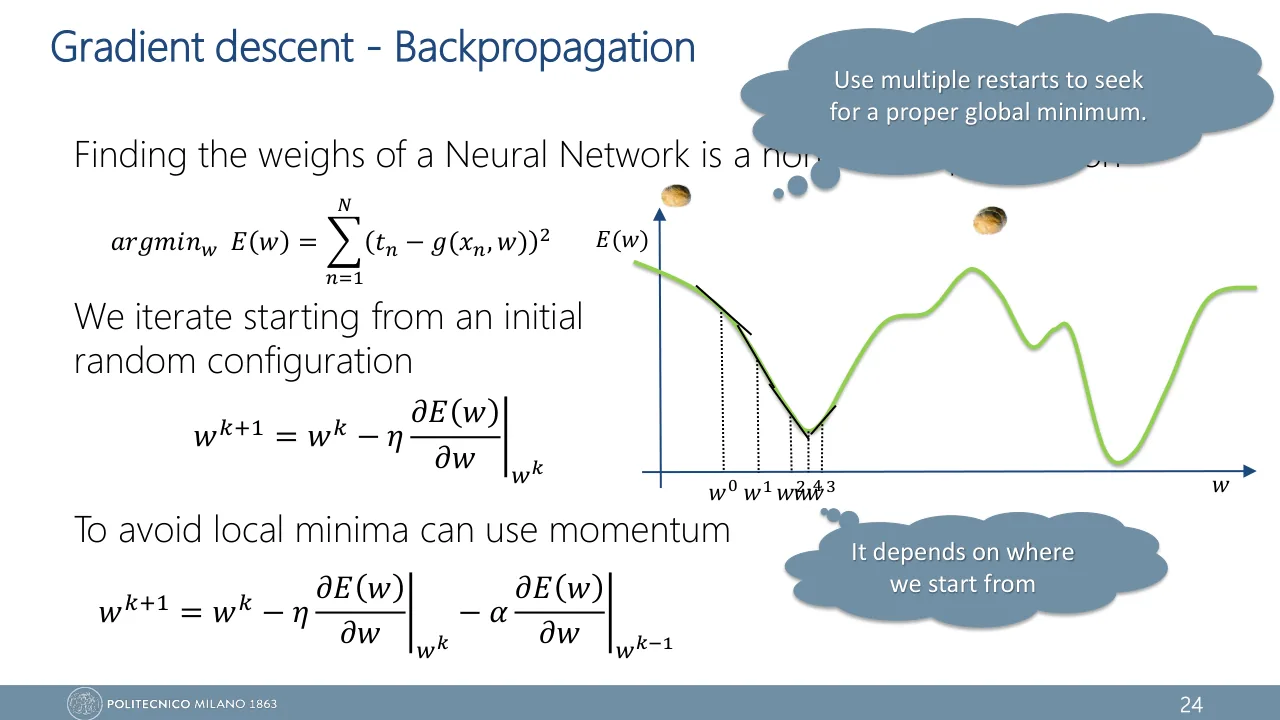
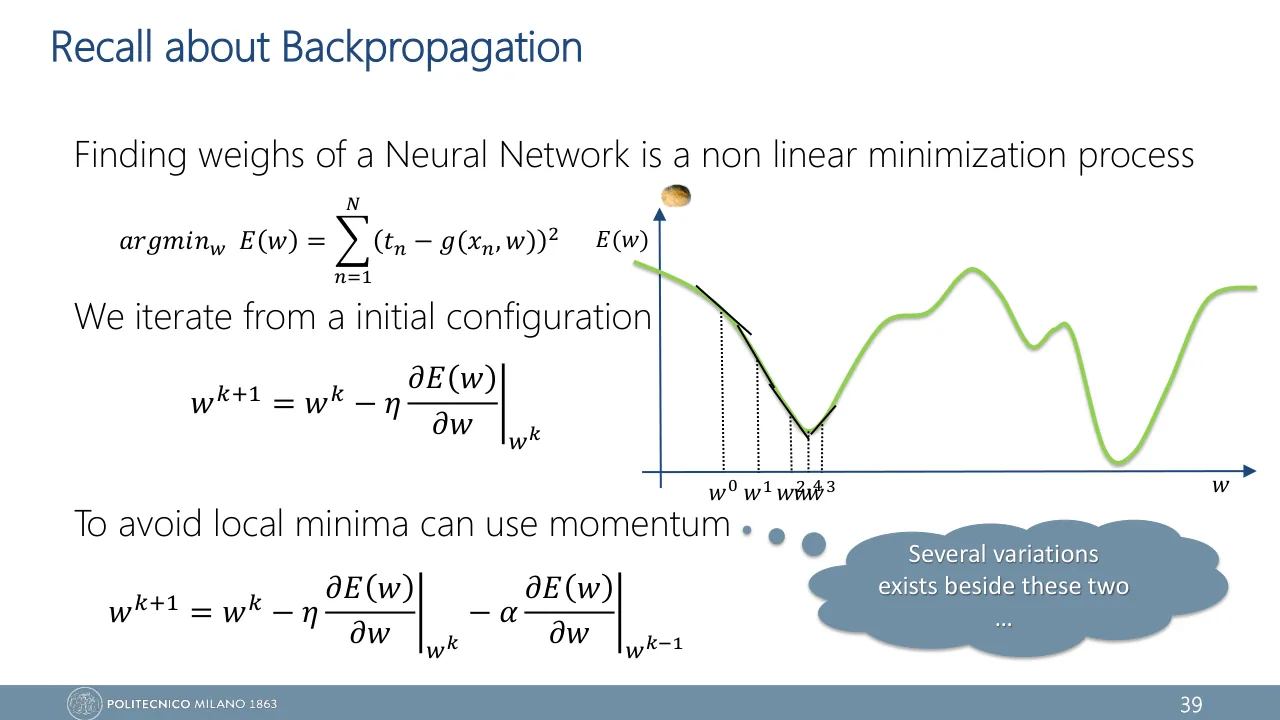
К текущему градиенту добавлен один предыдущий, с коэффициентом \(\alpha\). Цель по слайду — "To avoid local minima can use momentum": инерция перекатывает через мелкую ямку.
Скорость помнит все прошлые градиенты с весами \(\eta,\ \eta\alpha,\ \eta\alpha^2, \dots\) Цель по конспекту — не вязнуть в овраге.
Это две записи одной идеи, а не ошибка: слайд 38 лекции 3 оставляет от суммы первые два слагаемых, а множитель \(\eta\alpha\) при втором называет просто \(\alpha\). Если на экзамене просят формулу «as seen in class», пиши вариант слайда; объяснять удобнее через скорость. Обе цели — и локальные минимумы, и овраг — верны.
Nesterov accelerated gradient: сначала прыжок, потом поправка
Слайд 38 лекции 3 заканчивается репликой в облачке:"Several variations exists beside these two ...". These two — обычный шаг спуска и momentum. Первая вариация стоит на следующем слайде (лекция 3, слайд 39; в углу напечатано 40): "Nesterov Accelerated gradient: make a jump as momentum, then adjust".
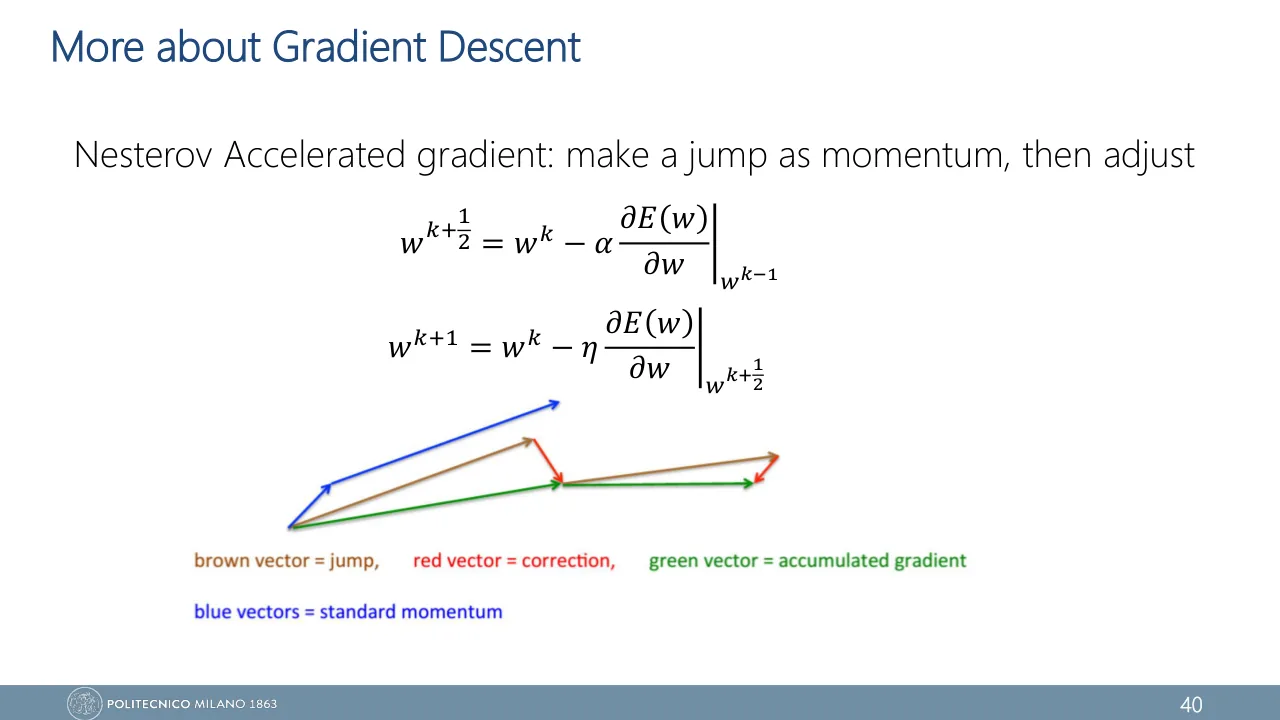
Тяжёлый шар решает, куда катиться, глядя под ноги на старте: градиент он меряет в точке \(w^k\), и к этому шагу прибавляется инерция. Nesterov accelerated gradient (NAG) меняет порядок. Сначала шар делает прыжок, который инерция всё равно заставит его сделать. Потом смотрит под ноги уже на новом месте и поправляет шаг.
- \(w^{k+\frac{1}{2}}\)
- точка после прыжка; \(k + \frac{1}{2}\) — метка «между шагами \(k\) и \(k + 1\)», а не степень
- \(\alpha\)
- тот же momentum coefficient: он задаёт длину прыжка
- \(\eta\)
- learning rate: он задаёт длину поправки
Первая строка — прыжок (jump): то самое слагаемое с \(\alpha\) из формулы momentum, только сделанное отдельным ходом. Вторая — поправка (adjust): обычный шаг по градиенту, но градиент взят не в \(w^k\), а в точке после прыжка.
Momentum: градиент взят на старте
Nesterov: градиент взят после прыжка
На рис. 4 видно, что это даёт. Прыжок вынес шар на противоположный склон. Градиент, взятый на старте, про этот склон ничего не знает и толкает шар дальше. Градиент, взятый после прыжка, уже смотрит назад и тормозит шар на этом же шаге, а не на следующем. Поэтому Nesterov меньше раскачивается и реже проскакивает минимум.
На слайде 39 лекции 3 вторая строка начинается с \(w^k\). Если прочитать её буквально, прыжок нужен только чтобы выбрать точку для градиента, а сами веса его не делают. Но слайд говорит "make a jump as momentum, then adjust", и на его картинке красная стрелка поправки начинается там, где кончается коричневый прыжок. Значит, поправку прибавляют к точке после прыжка:
\[ w^{k+1} = w^{k+\frac{1}{2}} - \eta\,\pd{E(w)}{w}\Big|_{w^{k+\frac{1}{2}}} \]На экзамене пиши обе строки как на слайде и добавь одну фразу: the correction is applied after the jump.
Теперь оба метода можно поставить рядом. Собери две строки Nesterov в одну и сравни с momentum:
Оба градиента взяты там, где веса уже были: в \(w^k\) и в \(w^{k-1}\).
Свежий градиент взят там, куда веса только что прыгнули: в \(w^{k+\frac{1}{2}}\).
Отличие в одном месте: в точке, где взят градиент при \(\eta\). У momentum порядок слагаемых не важен, оба посчитаны до того, как веса сдвинулись. У Nesterov важен: пока прыжок не сделан, нет точки для второго градиента.
В учебниках Nesterov записывают через скорость, как momentum в (85)–(86). Меняется одно: аргумент градиента.
| Что это | Слайд 39 лекции 3 | Через скорость |
|---|---|---|
| прыжок, jump | \(-\alpha\,\pd{E(w)}{w}\big|_{w^{k-1}}\) | \(\alpha\,\vb{v}_{k-1}\) |
| точка после прыжка | \(w^{k+\frac{1}{2}}\) | \(\vb{w}_k + \alpha\,\vb{v}_{k-1}\) |
| поправка, correction | \(-\eta\,\pd{E(w)}{w}\big|_{w^{k+\frac{1}{2}}}\) | \(-\eta\,\nabla E(\vb{w}_k + \alpha\,\vb{v}_{k-1})\) |
| весь шаг, accumulated gradient | прыжок + поправка | \(\vb{v}_k\) |
Разница между столбцами та же, что у momentum: слайд берёт в прыжок один последний градиент, учебник — всю накопленную скорость. Слова в первом столбце взяты из подписи к картинке на слайде: "brown vector = jump, red vector = correction, green vector = accumulated gradient". Синие стрелки там — "standard momentum": короткий шаг по градиенту в текущей точке и за ним длинный прыжок.
На овраге с рис. 3 разница заметна сразу, если посчитать оба метода в записи через скорость. При тех же \(\eta = 0.05\) и \(\alpha = 0.9\) momentum перелетает дно до \(w_2 = -0.84\), Nesterov — только до \(-0.20\). Ошибка уходит ниже 0.01 насовсем на шаге 60 у momentum и на шаге 47 у Nesterov.
Свой шаг каждому весу: adaptive learning rates
Momentum и Nesterov оставляют один \(\eta\) на все веса. Вторая идея — дать каждому весу свой масштаб шага. Зачем это сети, видно из урока 24: градиенты в первых слоях бывают на порядки меньше, чем в последних, и \(\eta\), подходящий одним, не подходит другим.
У профессора этому отведён слайд "Adaptive Learning Rates" (лекция 3, слайд 40; в углу напечатано 41). Довод занимает четыре строки:
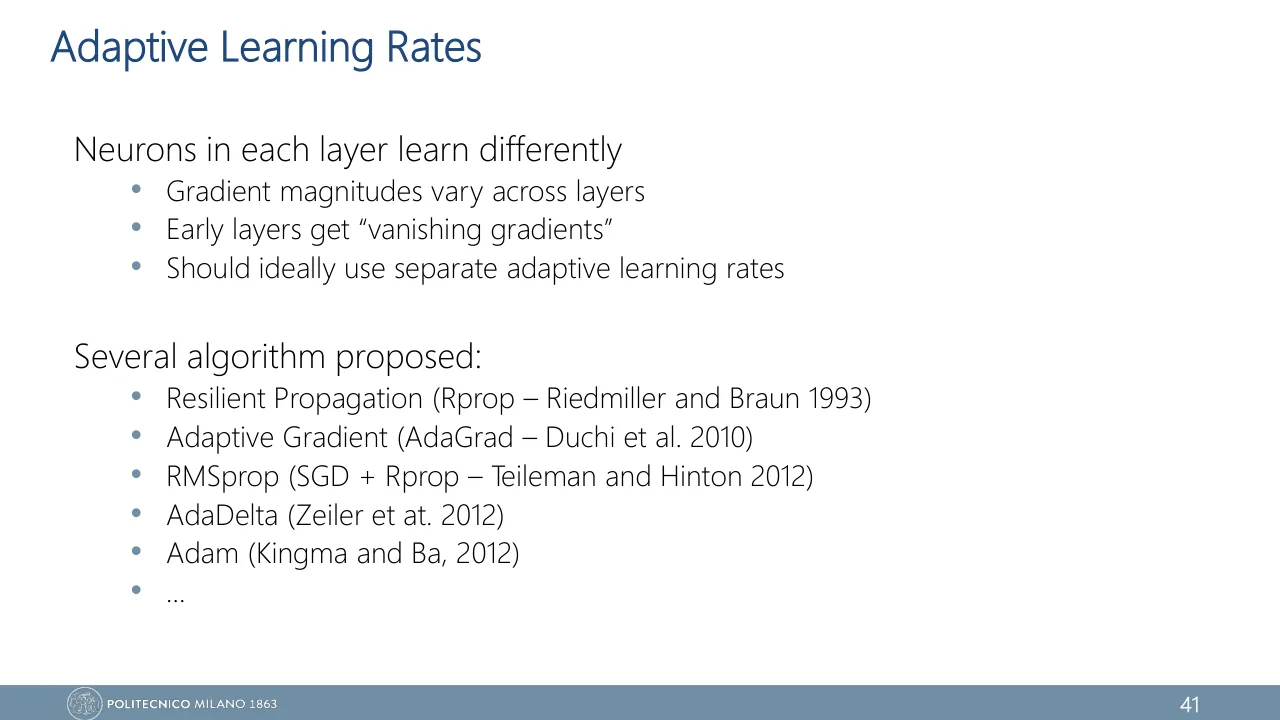
- "Neurons in each layer learn differently" — нейроны разных слоёв учатся по-разному;
- "Gradient magnitudes vary across layers" — величина градиента от слоя к слою разная;
- "Early layers get "vanishing gradients"" — до первых слоёв градиент доходит ослабленным;
- "Should ideally use separate adaptive learning rates" — в идеале шаг должен быть у каждого свой и подстраиваться сам.
Ниже на слайде список "Several algorithm proposed" из пяти имён: Rprop, AdaGrad, RMSprop, AdaDelta, Adam. Конспект разбирает только два из них — RMSprop (там он пишется RMSProp) и Adam. Пройдём все пять по порядку: каждый следующий чинит слабое место предыдущего.
Обозначим градиент по mini-batch на шаге \(k\) буквой \(\vb{g}_k\) (в конспекте \(g_t\); с выходом сети \(g(\vb{x}_n|\vb{w})\) не путать). Квадрат, корень и деление ниже выполняются отдельно для каждого веса.
Rprop (resilient propagation; Riedmiller и Braun, 1993) берёт от градиента только знак. У каждого веса свой размер шага \(\Delta\): вес сдвигается на \(\Delta\) против знака своего градиента. Если знак тот же, что на прошлом шаге, \(\Delta\) растёт (обычно в 1.2 раза). Если знак сменился — уменьшается вдвое.
Оврага Rprop не боится: величина градиента ему безразлична. Но ему нужен точный градиент по всему датасету. Представь вес, у которого девять mini-batch подряд дают градиент \(+0.1\), а десятый даёт \(-0.9\). В сумме ноль: вес должен стоять на месте. Rprop же девять раз сдвинет его в одну сторону, с каждым разом дальше: знак не меняется, и \(\Delta\) растёт. Десятый шаг вернёт лишь малую часть пути. Вес уедет.
AdaGrad (adaptive gradient; Duchi, Hazan и Singer, 2011) с mini-batch работает. Он копит для каждого веса сумму квадратов всех его прошлых градиентов и делит шаг на корень из этой суммы:
\[ \vb{G}_k = \vb{G}_{k-1} + \vb{g}_k^2 \] \[ \vb{w}_{k+1} = \vb{w}_k - \frac{\eta}{\sqrt{\vb{G}_k} + \varepsilon}\,\vb{g}_k \]Вес с крупными градиентами получает маленький шаг, вес с мелкими — большой. Слабое место: сумма только растёт. При постоянном градиенте шаги идут так: \(\eta,\ \eta/\sqrt{2},\ \eta/\sqrt{3},\ \dots\) На сотом шаге остаётся десятая часть. Рано или поздно обучение замирает.
RMSprop (Tieleman и Hinton, 2012) заменяет сумму скользящим средним: старые квадраты понемногу забываются, и знаменатель перестаёт расти. Для каждого веса он помнит скользящее среднее квадратов его градиента и делит шаг на корень из этого среднего:
- \(\rho\)
- decay rate, обычно 0.9
- \(\varepsilon\)
- малая константа, чтобы не делить на ноль
Вес с крупными градиентами делится на большое число, вес с мелкими — на маленькое. В итоге оба шагают примерно на \(\eta\).
На слайде про RMSprop сказано коротко: "SGD + Rprop". Это идея Rprop, переделанная под mini-batch. Rprop делит градиент на его собственный модуль, и остаётся знак. RMSprop делит на корень из среднего квадрата за последние шаги (root mean square — отсюда название), поэтому у соседних mini-batch делитель почти один и тот же. Проверь на примере с девятью \(+0.1\) и одним \(-0.9\). Корень из среднего квадрата за эти десять шагов:
\[ \sqrt{\frac{9 \cdot 0.1^2 + 0.9^2}{10}} = \sqrt{0.09} = 0.3 \]Делим на него каждый градиент и складываем десять сдвигов:
\[ \begin{aligned} 9 \cdot \Bigl(-\eta\,\frac{0.1}{0.3}\Bigr) + \eta\,\frac{0.9}{0.3} &= -3\eta + 3\eta \\ &= 0 \end{aligned} \]Девять маленьких шагов и один большой гасят друг друга. Вес остаётся на месте, как и должен.
AdaDelta (Zeiler, 2012) появился в том же году и лечит AdaGrad тем же способом — скользящим средним квадратов градиента. И идёт на шаг дальше: вместо общего \(\eta\) он ставит корень из скользящего среднего квадратов прошлых сдвигов того же веса. Подбирать \(\eta\) руками не нужно.
Adam (adaptive moment estimation; Kingma и Ba, 2014) складывает обе идеи урока: скользящее среднее самих градиентов \(\vb{m}\) — как скорость в momentum — и скользящее среднее их квадратов \(\vb{v}\) — как \(\vb{s}\) в RMSprop. Коротко: Adam — это RMSprop плюс momentum.
- \(\vb{m}_k\)
- first moment: среднее градиентов, \(\vb{m}_0 = 0\)
- \(\vb{v}_k\)
- second moment: среднее квадратов градиентов, \(\vb{v}_0 = 0\)
- \(\beta_1, \beta_2\)
- decay rates, обычно 0.9 и 0.999; \(\beta^{\,k}\) — степень
- \(\hat{\vb{m}}_k, \hat{\vb{v}}_k\)
- те же средние после bias correction
- \(\varepsilon\)
- около \(10^{-8}\)
Зачем шляпки, конспект не объясняет. Причина в старте с нуля: \(\vb{m}\) и \(\vb{v}\) начинают с нулевых значений, и первые средние занижены. Посмотрим на самый первый шаг для одного веса.
-
Приходит первый градиент \(g_1\). Средние стартовали с нуля, поэтому от него остаётся малая доля:
\[ m_1 = 0.1\,g_1, \qquad v_1 = 0.001\,g_1^2 \] -
Обе величины занижены: настоящее «среднее» по единственному градиенту равно \(g_1\), а не десятой его части. Делим на \(1 - \beta^{1}\) — поправка возвращает правильный масштаб:
\[ \hat m_1 = \frac{0.1\,g_1}{1 - 0.9} = g_1 \] \[ \hat v_1 = \frac{0.001\,g_1^2}{1 - 0.999} = g_1^2 \] -
Подставляем в шаг. Корень из квадрата — модуль:
\[ \Delta w = -\eta\,\frac{g_1}{\abs{g_1} + \varepsilon} \approx -\eta \cdot \sign(g_1) \]Длина первого шага равна \(\eta\) и от величины градиента не зависит: при \(\eta = 0.001\) шаг будет 0.001 и для \(g_1 = 10\), и для \(g_1 = 0.001\).
-
Без поправки отношение получилось бы другим:
\[ \frac{m_1}{\sqrt{v_1}} = \frac{0.1\,\abs{g_1}}{\sqrt{0.001}\,\abs{g_1}} \approx 3.16 \]Первый шаг был бы втрое длиннее задуманного. Дальше знаменатель \(1 - \beta^{\,k}\) стремится к единице, и поправка сама выключается. Для \(v\) с \(\beta_2 = 0.999\) на это уходит порядка тысячи шагов.
Первый шаг Adam по каждому весу равен \(\eta\) — каким бы ни был градиент.
Теперь вся семья в одной таблице. Читай её сверху вниз как цепочку: Rprop и AdaGrad — два предка, RMSprop берёт у первого идею и чинит второй, AdaDelta убирает \(\eta\), Adam добавляет momentum.
| Метод | Что делает с шагом веса |
|---|---|
| Rprop, 1993 | берёт только знак градиента; размер шага у каждого веса свой: растёт, пока знак держится, и падает, когда знак меняется |
| AdaGrad, 2011 | делит \(\eta\) на корень из суммы всех прошлых квадратов градиента; шаг только убывает |
| RMSprop, 2012 | делит \(\eta\) на корень из скользящего среднего квадратов градиента; это Rprop для mini-batch |
| AdaDelta, 2012 | то же скользящее среднее, а вместо \(\eta\) — корень из среднего квадрата прошлых сдвигов |
| Adam, 2014 | RMSprop плюс momentum, с bias correction |
А вот как тот же список напечатан на слайде, дословно:
- "Resilient Propagation (Rprop – Riedmiller and Braun 1993)"
- "Adaptive Gradient (AdaGrad – Duchi et al. 2010)"
- "RMSprop (SGD + Rprop – Teileman and Hinton 2012)"
- "AdaDelta (Zeiler et at. 2012)"
- "Adam (Kingma and Ba, 2012)"
«Имена и годы можно списать со слайда 40 лекции 3 как есть». В списке три неточности. Фамилия пишется Tieleman, а не "Teileman". Статья про AdaGrad вышла в журнале в 2011 году; 2010 — год её первой версии. Adam появился в декабре 2014 года и опубликован на конференции ICLR в 2015-м, а не в 2012-м. Плюс опечатка "et at.": у статьи про AdaDelta один автор. На экзамене хватит названий и авторов. Годы безопаснее не писать вовсе, чем спорить со слайдом.
Слайд "Learning Rate Matters": шесть методов на двух картах
Лекция 3 заканчивается картинкой (лекция 3, слайд 41; в углу напечатано 42). На ней два кадра с одной и той же легендой из шести строк: SGD, Momentum, NAG, Adagrad, Adadelta, Rmsprop. NAG — это Nesterov accelerated gradient. Adam в легенде нет.
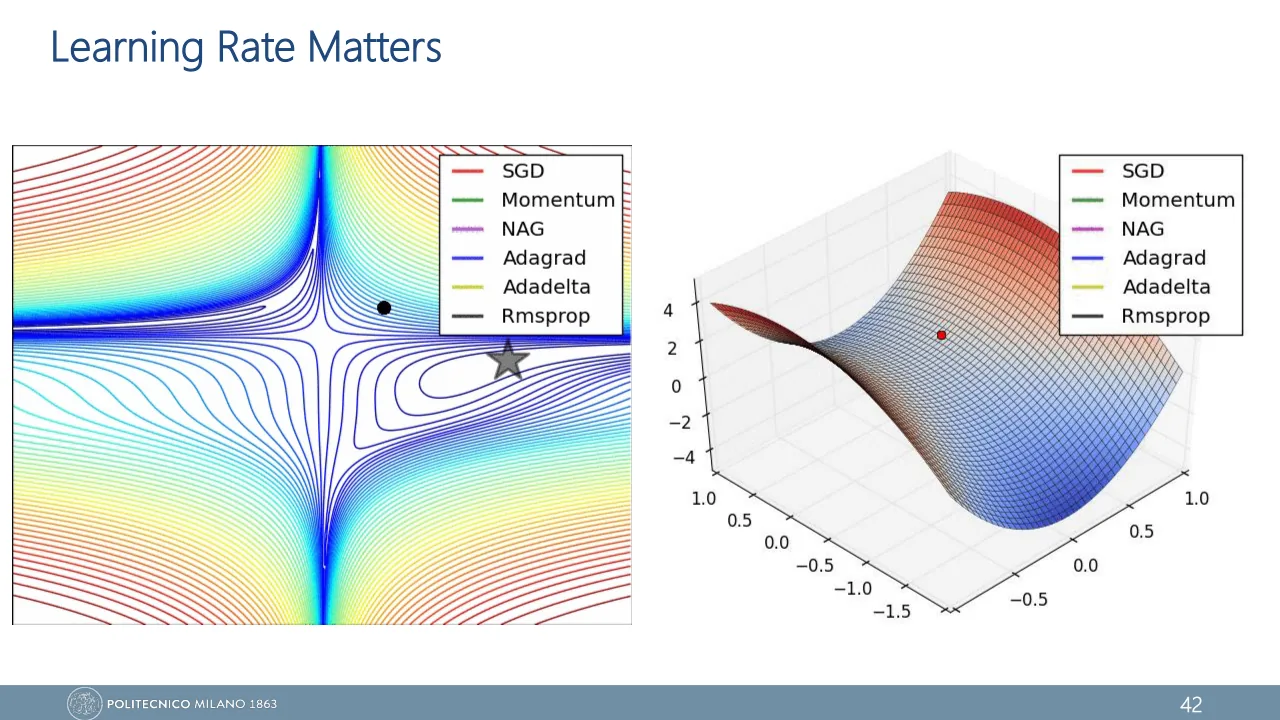
Слева — карта линий уровня ошибки, как в виджете выше, только рельеф сложнее: узкие долины с поворотом. Чёрная точка — общий старт, звезда — минимум. Справа — седло, saddle point из урока 13: вдоль одного направления поверхность поднимается, вдоль другого падает. Красная точка — старт, выше перевала.
В PDF оба кадра неподвижны: все шесть методов ещё стоят на старте. На странице CS231n из списка в конце урока те же две картинки движутся. Происходит на них вот что.
В долине Momentum и NAG разгоняются и проскакивают мимо, как шар на рис. 3. NAG возвращается на курс раньше: он берёт градиент после прыжка. Adagrad, Adadelta и RMSprop почти сразу поворачивают к минимуму, потому что каждый вес у них идёт своим шагом. SGD идёт в верную сторону, но медленнее всех.
На седле дорога от старта ведёт вниз, прямо к перевалу. SGD доходит до него и застревает надолго: градиент там почти нулевой, а шаг SGD пропорционален градиенту. Momentum и NAG тоже задерживаются, но в итоге скатываются. Adagrad, Adadelta и RMSprop уходят вниз быстро: маленький градиент они делят на его же маленький масштаб, и сдвиг получается обычного размера. Рис. 5 повторяет этот кадр на самом простом седле.
Обычный спуск: сдвиг пропорционален градиенту
RMSprop: сдвиг порядка \(\eta\) при любом градиенте
Название слайда — его вывод. От того, как метод распоряжается шагом, зависит, выберется ли он из трудного места и как быстро. Один \(\eta\) на все веса — слабое место обычного спуска. Momentum и NAG правят направление шага, adaptive learning rates — его масштаб у каждого веса. Левый кадр можно повторить в виджете выше: там тот же сюжет на овраге и ещё Adam, которого на слайде нет.
Schedule — не optimizer
Теперь всё можно разложить по полкам. В уроке было три разные ручки, и они не заменяют друг друга.
| Ручка | Что меняет | Смотрит на градиенты? | Одна на все веса? |
|---|---|---|---|
| Schedule: step, exponential, 1/t, cosine, warm-up | общий \(\eta\) как функцию времени | нет | да |
| Momentum, Nesterov | направление шага: копит прошлые градиенты в скорость | да | да |
| Adaptive learning rates: Rprop, AdaGrad, RMSprop, AdaDelta, Adam | масштаб шага каждого веса | да | нет |
Ручки комбинируют. Adam сам содержит momentum, а поверх него обычно ставят ещё и расписание: Adam делит шаг между весами, расписание управляет общим \(\eta\). Так и написано на стр. 199 конспекта.
С чего начинать на практике? Стр. 199 конспекта советует Adam: он быстро приспосабливается, спокойно переносит шумные градиенты и хорошо работает с mini-batch. Обычное стартовое значение для него — \(\eta = 0.001\).
«Adam обобщает хуже, поэтому в конце надо переключаться на SGD с momentum». На стр. 199 это подано как обычная практика. На деле это одна из опубликованных эвристик, а «generalizes worse» — наблюдение, которое зависит от настройки. На экзамене формулируй мягко: «sometimes», «may».
Карта главы 3 и весь рецепт
Вернёмся к кастрюле. Черпак в 100 раз больше ложки надёжнее только в 10 раз, потому что ошибка среднего падает как \(1/\sqrt{M}\). Поэтому сети учат ложками: много дешёвых, слегка неточных шагов вместо одного дорогого точного. Неточность лечат расписанием: к концу шаг укорачивают, и дрожание затихает. А тяжёлый шар — это momentum: в овраге, где обычный спуск мечется или ползёт, шар копит скорость вдоль дна.
Это был последний инструмент главы 3. Вся глава отвечает на три вопроса — посмотри, как по ним раскладываются одиннадцать уроков.
И тот же материал в том порядке, в котором им пользуются. Это рецепт обучения сети целиком:
- Раздели данные на training, validation и test set (урок 18); если данных мало — cross-validation (урок 19).
- Выбери архитектуру и выходной слой под задачу (урок 11); в скрытых слоях — ReLU (урок 24).
- Задай начальные веса: He для ReLU, Xavier для tanh (урок 25); между линейным слоем и активацией поставь batch normalization (урок 26).
- Возьми error function из maximum likelihood (урок 15) и добавь регуляризацию: weight decay (урок 22), dropout (урок 23).
- Обучай по mini-batch: градиент считает backpropagation (урок 14), шаг делает Adam или SGD с momentum, \(\eta\) идёт по расписанию (этот урок).
- Следи за ошибкой на validation set и остановись вовремя: early stopping (урок 20).
- Подбери hyperparameters — \(\eta\), \(M\), силу регуляризации — по validation, а не по test (урок 21).
- Один раз, в самом конце, измерь ошибку на test set. Это и есть честная оценка generalization (уроки 17 и 18).
Каждая строка — готовый вопрос вида «why do we…?». Если на любой из них получается ответить двумя-тремя предложениями по-английски, глава 3 у тебя в руках.
В формате экзамена
Compare batch gradient descent, stochastic gradient descent (SGD) and mini-batch gradient descent. For each of them write the gradient used for one weight update, and explain the trade-off.
Show model answer
Batch gradient descent uses all \(N\) samples:
\[ \pd{E(w)}{w} = \frac{1}{N}\sum_{n=1}^{N} \pd{E(x_n, w)}{w} \]SGD uses a single sample:
\[ \pd{E(w)}{w} \approx \pd{E(x_n, w)}{w} \]Mini-batch gradient descent uses a subset of \(M \lt N\) samples:
\[ \pd{E(w)}{w} \approx \frac{1}{M}\sum_{n \in \text{mini-batch}} \pd{E(x_n, w)}{w} \]Batch: the gradient is exact, but every update costs a pass over the whole dataset (one update per epoch), which is impractical for large \(N\). SGD: \(N\) cheap updates per epoch; the estimate is unbiased but has high variance, so the trajectory is noisy. Mini-batch: still unbiased, with variance reduced by a factor \(M\) (noise \(\propto 1/\sqrt{M}\)); it is a good trade-off between variance and computation and exploits GPU parallelism. Because of the \(1/\sqrt{M}\) law, larger batches give diminishing returns.
Проверяют три вещи: три формулы, слова unbiased / high variance и то, что mini-batch — компромисс между дисперсией и вычислениями. Закон \(1/\sqrt{M}\) — то, что отличает отличный ответ от хорошего.
A training set contains \(N = 50\,000\) samples and the mini-batch size is \(M = 32\). How many weight updates (iterations) are performed in one epoch?
Show model answer
There are 1562 full mini-batches and one last mini-batch with the remaining 16 samples.
Ловушка в округлении: 1562 — это без последнего неполного mini-batch. Если в задаче спросят число обновлений за 10 эпох, умножь на 10.
A step-decay schedule starts from \(\eta_0 = 0.1\) and halves the learning rate every 10 epochs. What is the learning rate at epoch \(t = 25\)?
Show model answer
Показатель степени — целая часть \(t/s\), то есть 2, а не 2.5. С показателем 2.5 получится 0.0177 — это уже не step decay.
Adam is run with \(\beta_1 = 0.9\), \(\beta_2 = 0.999\), \(\eta = 0.001\), \(m_0 = v_0 = 0\) and a negligible \(\varepsilon\). The first gradient of a weight is \(g_1 = 10\). Compute the first update \(\Delta w\) of that weight.
Show model answer
The first step equals \(-\eta \cdot \sign(g_1)\), whatever the size of the gradient. The bias correction is needed because \(m\) and \(v\) start from zero, so the first running averages underestimate the true moments; dividing by \(1 - \beta^{k}\) removes this bias.
Если вышло −0.00316, забыта bias correction. Если +0.001 — потерян минус: шаг идёт против градиента.
Which of the following statements are correct? Select all that apply.
Show model answer
Statements A and C are correct. A schedule is a function \(\eta_t\) of time; momentum changes the direction of the update by accumulating past gradients; adaptive learning-rate methods (RMSprop, Adam) rescale the step per parameter. The three mechanisms are independent and are usually combined. Cosine annealing as written decreases monotonically from \(\eta_0\) to 0 on \([0, T]\); a restart is a separate reset of \(t\).
Вопрос на различение трёх ручек. Конспект их смешивает (стр. 176 и 197), поэтому заученная оттуда фраза здесь стоит баллов.
Write the gradient-descent update rule with momentum. Explain why momentum helps when the error surface has a narrow valley (a ravine).
Show model answer
As seen in class:
\[ \begin{aligned} w^{k+1} = w^{k} &- \eta\,\pd{E(w)}{w}\Big|_{w^{k}} \\ &- \alpha\,\pd{E(w)}{w}\Big|_{w^{k-1}} \end{aligned} \]The standard (velocity) form of the same idea accumulates all past gradients, not only the previous one:
\[ \begin{aligned} v_k &= \alpha\,v_{k-1} - \eta\,\nabla E(w_k) \\ w_{k+1} &= w_k + v_k \end{aligned} \]with \(0 \le \alpha \lt 1\), typically 0.9. In a ravine a single learning rate is limited by the steep direction, so plain gradient descent either zig-zags across the valley or crawls along its flat bottom. The velocity is an exponentially weighted sum of past gradients: components that keep the same sign (along the valley) add up, up to a factor \(1/(1-\alpha)\); components that change sign (across the valley) cancel. The same inertia helps to roll through small local minima and plateaus.
Формула слайда (лекция 2, слайд 24; лекция 3, слайд 38) плюс объяснение через «складываются — гасятся». Число \(1/(1-\alpha) = 10\) при \(\alpha = 0.9\) показывает, что ты понимаешь, откуда ускорение.
Write the Nesterov accelerated gradient update as seen in class and explain how it differs from momentum.
Show model answer
Nesterov accelerated gradient: make a jump as momentum, then adjust.
\[ w^{k+\frac{1}{2}} = w^{k} - \alpha\,\pd{E(w)}{w}\Big|_{w^{k-1}} \] \[ w^{k+1} = w^{k} - \eta\,\pd{E(w)}{w}\Big|_{w^{k+\frac{1}{2}}} \]The first line is the momentum jump to an intermediate (look-ahead) point \(w^{k+\frac{1}{2}}\). The second line is the correction: a gradient step whose gradient is evaluated at the look-ahead point instead of \(w^k\). The correction is applied after the jump, so the whole update is
\[ \begin{aligned} w^{k+1} = w^{k} &- \alpha\,\pd{E(w)}{w}\Big|_{w^{k-1}} \\ &- \eta\,\pd{E(w)}{w}\Big|_{w^{k+\frac{1}{2}}} \end{aligned} \]Momentum has the same two terms, but both gradients are computed at points already visited, \(w^k\) and \(w^{k-1}\): it measures the gradient first and then jumps. Nesterov jumps first and measures the gradient where the jump lands. If the jump overshoots, that gradient already points back, so the step is corrected immediately and not one iteration later: fewer oscillations, less overshooting. In the standard notation with a velocity:
\[ \begin{aligned} v_k &= \alpha\,v_{k-1} - \eta\,\nabla E(w_k + \alpha\,v_{k-1}) \\ w_{k+1} &= w_k + v_k \end{aligned} \]Ждут две строки слайда 39 лекции 3 и мысль the gradient is evaluated after the jump. Вторую строку слайд начинает с \(w^k\): пиши как на слайде, а следующей фразой скажи, что поправка делается из точки после прыжка. Запись через скорость — запасной вариант, если формула слайда не вспомнится.
Why are adaptive learning rates useful when training a deep network? Name three algorithms that implement them and say in one sentence what each of them does.
Show model answer
Neurons in each layer learn differently: gradient magnitudes vary across layers, and early layers get "vanishing gradients". A single learning rate is therefore too large for some weights and too small for others; ideally every weight should have its own learning rate, adapted during training.
Algorithms (any three):
- Rprop (Riedmiller and Braun): uses only the sign of the gradient and keeps a separate step size for every weight, increased while the sign stays the same and decreased when it flips; it needs full-batch gradients.
- AdaGrad (Duchi et al.): divides the learning rate of every weight by the square root of the sum of all its past squared gradients, so the step can only shrink.
- RMSprop (Tieleman and Hinton): "SGD + Rprop" — divides the gradient by the square root of a running average of its squared values, so it works with mini-batches and the step does not shrink to zero.
- AdaDelta (Zeiler): like RMSprop, and it also replaces the global learning rate with the root of a running average of the squared past updates, so no learning rate has to be set.
- Adam (Kingma and Ba): RMSprop plus momentum — running averages of the gradient and of its square, with bias correction.
Первая половина ответа — строки слайда 40 лекции 3 почти дословно. Во второй хватит трёх имён, но к каждому нужно действие, а не только название. Годы не обязательны: у AdaGrad и Adam на слайде они неточные.
Проверь себя
В датасете \(N = 1000\) примеров, размер mini-batch \(M = 100\), обучение идёт 5 эпох. Сколько раз обновятся веса?
Размер mini-batch увеличили с 16 до 64. Что произошло с шумом оценки градиента (со стандартным отклонением)?
Что верно про градиент, посчитанный по mini-batch?
Картинка для памяти — первый виджет: облако оценок вокруг ромба сжимается вдвое при каждом учетверении \(M\).
Зачем уменьшать \(\eta\) по ходу обучения с mini-batch?
Cosine annealing, \(\eta_0 = 0.1\), \(T = 100\). Чему равен шаг на эпохах 50 и 100?
Momentum с \(\alpha = 0.9\), градиент много шагов подряд одинаковый. Во сколько раз установившийся сдвиг за шаг больше, чем \(\eta\,g\) у обычного спуска?
Adam, \(\eta = 0.001\). Первый градиент по весу A равен 100, по весу B — 0.01. Какими будут первые сдвиги?
Чем Nesterov accelerated gradient отличается от momentum?
Градиент веса много шагов подряд одинаковый. У какого метода сдвиг за шаг убывает как \(\eta/\sqrt{k}\)?
Унести с собой
- Градиент по mini-batch — unbiased оценка полного градиента; её шум падает как \(1/\sqrt{M}\), поэтому большой mini-batch — дорогая покупка.
- Iteration — одно обновление весов, epoch — проход по всему датасету: \(\lceil N/M \rceil\) обновлений.
- С постоянным \(\eta\) спуск по mini-batch не сходится, а дрожит у минимума; learning rate schedule уменьшает \(\eta\) по заранее заданной формуле и сжимает дрожание.
- Step, exponential, 1/t и cosine — функции номера эпохи. Cosine по формуле (84) монотонно падает до нуля и сам не перезапускается; warm-up — подъём шага в первые эпохи.
- Momentum копит скорость: вдоль оврага градиенты складываются, до \(1/(1-\alpha)\) раз, поперёк — гасят друг друга.
- Nesterov accelerated gradient: сначала прыжок по инерции, потом поправка по градиенту, взятому в точке после прыжка. От momentum он отличается только этой точкой.
- Adaptive learning rates дают каждому весу свой масштаб шага. Rprop смотрит на знак градиента, AdaGrad делит на корень из суммы его квадратов, RMSprop и AdaDelta — на корень из скользящего среднего, Adam — это RMSprop плюс momentum.
- Первый шаг Adam равен \(\eta\) при любом градиенте — так работает bias correction.
- Schedule, momentum и adaptive learning rates — три разные ручки; их не путают, а комбинируют.
Что посмотреть и почитать
-
Stochastic Gradient Descent, Clearly Explained!!!
StatQuest
Самое мягкое введение в идею: зачем считать градиент по части данных, а не по всем. Хорошо заходит перед первым разделом.
-
AI Notes: Parameter optimization in neural networks
Katanforoosh, Kunin, Ma · deeplearning.ai
Два живых виджета на те же темы: в первом меняешь batch size и learning rate и смотришь на путь по поверхности ошибки, в третьем гоняешь momentum, RMSprop и Adam по разным ландшафтам.
-
CS231n notes — Neural Networks Part 3: Learning and Evaluation
Stanford CS231n
В разделе про обновление весов — Nesterov momentum, Adagrad, RMSprop и Adam в несколько строк каждый. Сразу под ними те самые две анимации со слайда "Learning Rate Matters", которые в PDF лекции застыли на первом кадре.
-
Dive into Deep Learning, 12.11: Learning Rate Scheduling
d2l.ai
Расписания с графиками и кодом, который можно запустить: ступеньки, косинус и warm-up, которого в конспекте нет.
-
Why Momentum Really Works
Gabriel Goh · Distill
Интерактивная статья для тех, кому захочется понять тяжёлый шар до конца: откуда берутся качания и ускорение и как на них влияют \(\alpha\) и \(\eta\).
-
A Recipe for Training Neural Networks
Andrej Karpathy
Тот же «рецепт целиком», что в конце урока, но глазами практика: сначала добиться, чтобы сеть переобучилась, и только потом регуляризовать. Хорошая точка после трёх глав.