Спуск в тумане
После этого урока ты запишешь ошибку сети как Sum of Squared Errors, сделаешь шаг gradient descent на калькуляторе и по формуле скажешь, при каком learning rate спуск начнёт расходиться.
Ты стоишь на склоне горы в таком тумане, что видно только собственные ботинки. Надо спуститься в долину. Карты нет, но подошвой чувствуется, куда наклонена земля. План напрашивается сам: шагнуть туда, где круче всего вниз, и повторять.
Размах шагов задаёт одно число, \(\eta\). И вот странность. На одной и той же горе (её формула есть в конспекте, ниже она появится) путник с \(\eta = 0.2\) за двадцать шагов оказывается на дне. С \(\eta = 0.5\) он не дойдёт никогда: будет вечно прыгать между двумя точками на одной высоте. А с \(\eta = 0.55\) через те же двадцать шагов окажется на высоте 47 000, хотя стартовал с высоты 57.
Почему граница проходит ровно по 0.5? И можно ли было назвать это число заранее, не сделав ни шага?
Миллион ручек и одна стрелка
В уроке 12 сеть оказалась конструктором, из которого собирается почти любая функция. У теоремы была оговорка, и профессор выносит её на слайд отдельной строкой: то, что нужные веса существуют, не значит, что алгоритм обучения их найдёт. Теперь речь именно об этом: как веса ищут.
Начало знакомо по Applied Statistics. В линейной регрессии были точки и прямая, а «подогнать модель» значило найти два числа: наклон и сдвиг. Слайд 21 лекции 2 так и начинается: «Recall learning a parametric model». С сетью всё то же, только чисел больше.
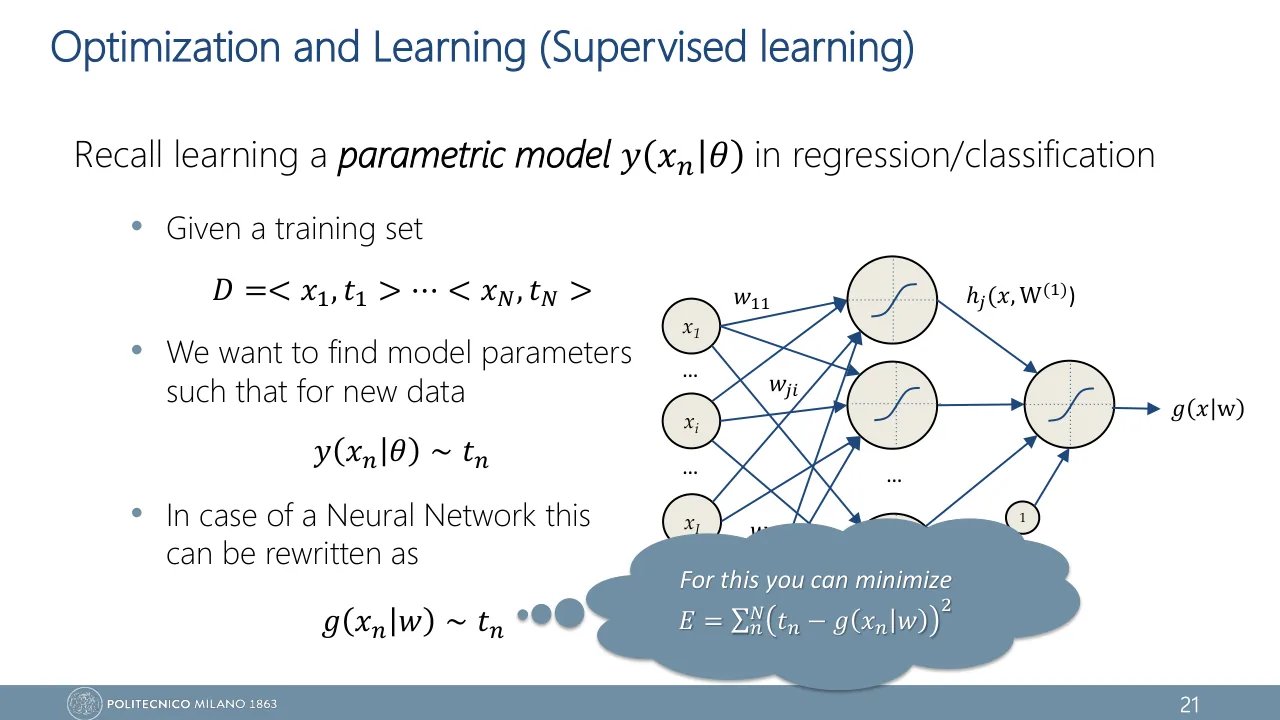
Supervised learning (обучение с учителем) — обучение на примерах, в каждом из которых есть и вход, и правильный ответ. Набор таких пар называется training set, правильный ответ — target.
- \(x_n\)
- вход \(n\)-го примера: картинка, показания датчиков
- \(t_n\)
- target, правильный ответ для него (на слайдах это всегда \(t\), не \(y\))
- \(N\)
- число примеров
- \(g(x|w)\)
- выход сети: parametric model, функция заранее выбранной формы
- \(w\)
- все веса и смещения сети разом
- \(\sim\)
- «примерно равно»; на слайде добавлено: for new data
Удобная картинка — микшерный пульт. Данные лежат на столе и не меняются. У пульта тысячи ручек, это веса \(w\). И есть одна стрелка, которая показывает, насколько плохо получается: одно число на весь training set. Учить сеть значит крутить ручки, пока стрелка не опустится как можно ниже.
Зачем модель параметрическая? «Найти функцию» — задача без краёв: функций бесконечно много. «Найти вектор чисел» — задача для анализа: по числам можно брать производные. Архитектура задаёт семейство функций, обучение ищет в нём одного представителя. Конспект записывает это цепочкой Architecture → Function space → Optimization → Learning.
В эту схему укладываются и regression, и classification: меняются только вид target и способ сравнения с ним. От проектировщика при этом нужны три решения: структура сети, функция ошибки и алгоритм оптимизации. Первое было в уроках 9–12. Второе и третье — здесь.
«Сеть без ошибок воспроизводит training set — значит, научилась». Нет. Цель записана на слайде словами for new data: хорошо отвечать на входы, которых сеть не видела. Ошибка на training set — только заменитель этой цели: другой ошибки под рукой нет. Чем это грозит, покажет урок 17, как проверять честно — урок 18.
Sum of Squared Errors: ошибку меряют площадью
Стрелке нужно одно число. Оно должно быть нулём, когда все ответы точные, и расти, когда сеть ошибается. Профессор называет его error function и обозначает \(E(w)\).
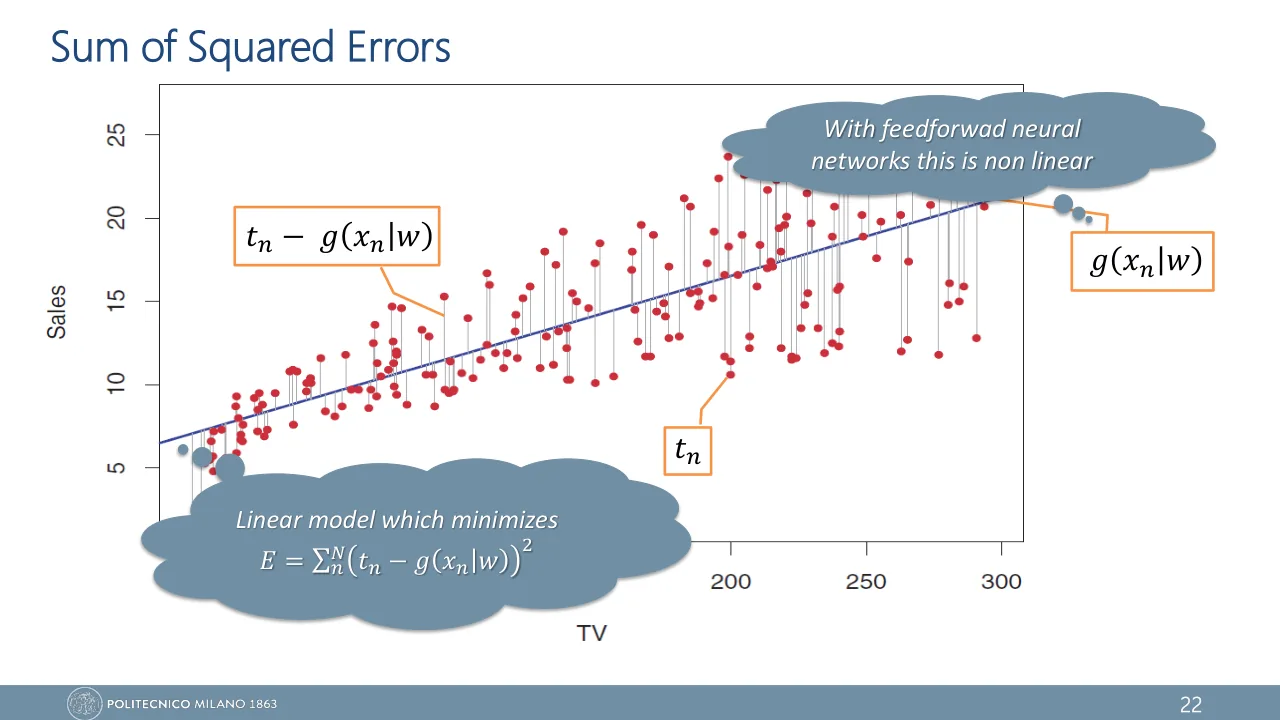
Для одного примера промах — это разность \(t_n - g(x_n|w)\). На слайде 22 лекции 2 она нарисована вертикальным отрезком от точки до прямой (там продажи против рекламы на TV). Просто сложить отрезки нельзя: промах вверх и промах вниз съедят друг друга. Поэтому на каждом отрезке строят квадрат и складывают площади.
До: \(g = 2\), \(E = 11.32\)
После: \(g = 2 + 0.6x\), \(E = 1.24\)
- \(t_n - g(x_n|w)\)
- промах на примере \(n\): сторона квадрата
- \((\,\cdot\,)^2\)
- площадь квадрата
- \(\sum\)
- сумма по всему training set
Это и есть Sum of Squared Errors, коротко SSE. На слайдах формула именно такая: без \(\tfrac12\) впереди и без деления на \(N\).
Проверим на левой картинке. Targets равны 0.5, 0.3, 1.8, 1.4, 2.8, 3.7 и 3.5, модель везде отвечает 2. Промахи: −1.5, −1.7, −0.2, −0.6, 0.8, 1.7, 1.5. Складываем их квадраты:
\[ \begin{aligned} E &= 2.25 + 2.89 + 0.04 + 0.36 \\ &\quad + 0.64 + 2.89 + 2.25 = 11.32 \end{aligned} \]Четыре точки с промахом от 1.5 дают 10.28 из 11.32.
Почему именно квадрат:
- знаки не сокращаются: недолёт и перелёт оба идут в плюс;
- большой промах наказан сильнее, чем пропорционально: вдвое дальше — вчетверо дороже;
- квадрат гладкий: у него есть производная в каждой точке, включая ноль, а у модуля в нуле излом.
Гладкой по весам ошибка будет, только если гладкая сама сеть. Вот зачем в уроке 10 ступеньку заменили сигмоидой. Есть и четвёртая причина, статистическая: при гауссовом шуме в данных минимум SSE совпадает с оценкой максимального правдоподобия. Ей посвящён урок 15.
«Ошибку можно мерить числом неверных ответов». Так она описана в конспекте на стр. 89, в аналогии с учеником и решебником. Для спуска такая ошибка бесполезна: от маленького сдвига весов число неверных ответов не меняется, наклон всюду нулевой, и непонятно, куда шагать. Нужна ошибка, которая чувствует, насколько далеко каждый ответ от правильного.
Три записи одной ошибки
В конспекте встречаются ещё две записи, и их легко перепутать с той, что на слайдах.
| Запись | Формула | Множитель | Где встречается |
|---|---|---|---|
| SSE | \(\sum_n (t_n - g)^2\) | \(-2\) | слайды, экзамен |
| half-SSE | \(\tfrac12 \sum_n (t_n - g)^2\) | \(-1\) | конспект, стр. 103 |
| MSE | \(\tfrac1N \sum_n (t_n - g)^2\) | \(-2/N\) | конспект, стр. 111 |
Умножение на положительное число не двигает дно, поэтому \(\argmin\) общий. Меняется масштаб градиента, то есть размах шага при той же \(\eta\). На экзамене бери запись профессора: при дифференцировании из неё выходит множитель \(-2\), и его ждут в ответе.
И про слова. Конспект различает loss (промах на одном примере, функция \(\ell\)) и error function (сумма по всем примерам), а потом сам называет \(E(w)\) то так, то эдак. В общем виде у него записано так:
\[ E(w) = \sum_{n=1}^{N} \ell\big(t_n,\ g(x_n|w)\big) \]SSE получается при \(\ell = (t_n - g(x_n|w))^2\). Другие \(\ell\) дадут другие функции ошибки, они появятся в уроке 15. На слайдах этой лекции слова loss нет вовсе, только error function \(E(w)\). В этом курсе так же.
Ошибка как рельеф
Правая карта в виджете — главная картинка урока. Каждому набору весов соответствует одна высота \(E(w)\). Все высоты вместе образуют поверхность над пространством весов: низины — хорошие веса, холмы — плохие. Обучение — это поиск самой низкой точки:
\[ w^{\ast} = \argmin_{w}\; E(w) \]Для прямой поверхность оказалась чашей с одним дном. Для сети, как сказано на слайде 22, «this is non linear»: поверхность перестаёт быть чашей. К концу урока это аукнется.
«Поверхность ошибки показывает, как ошибка зависит от входа». Нет: данные заморожены, по осям отложены веса. И осей не две. У сети их столько же, сколько весов: тысячи и миллионы. Двумерная карта — аналогия, а не чертёж.
Шаг против градиента
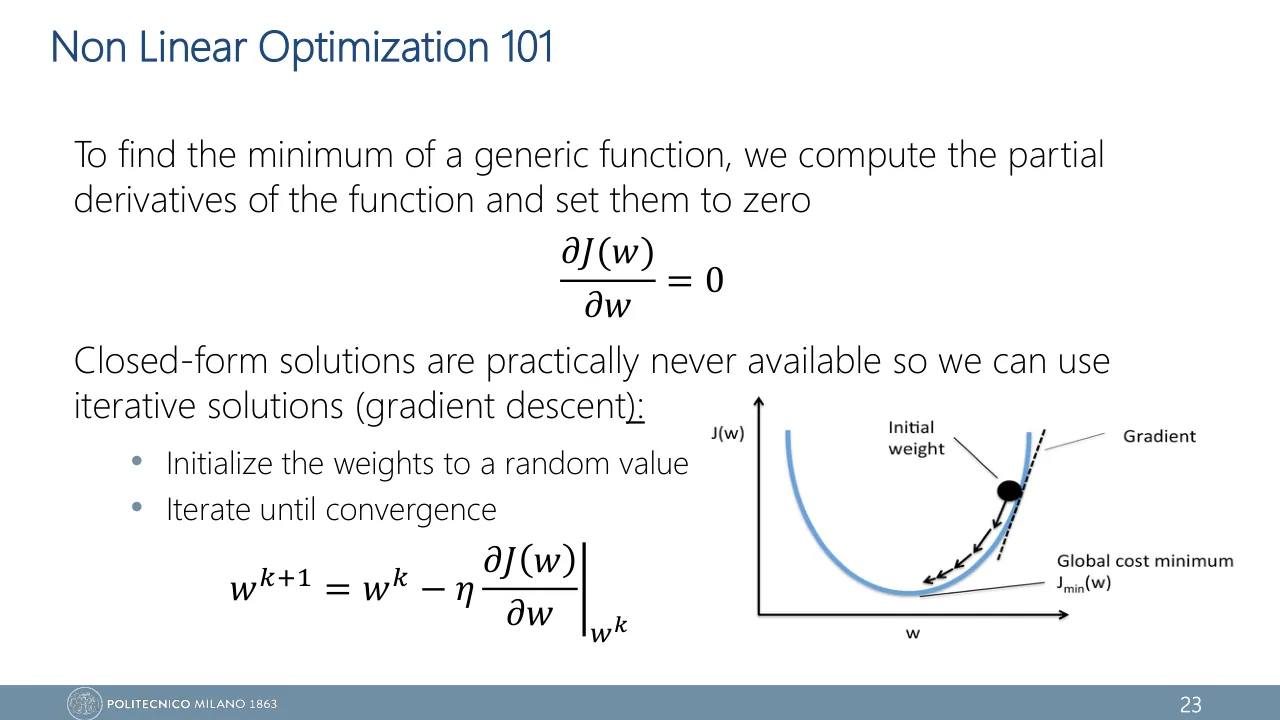
В анализе минимум функции ищут так: приравнять производные к нулю и решить уравнения. Слайд 23 лекции 2 с этого и начинает. Посмотрим, где план ломается.
Для данных из виджета
\[ \pd{E}{w_0} = 14\,(w_0 - 2) \] \[ \pd{E}{w_1} = 56\,(w_1 - 0.6) \]Обе производные обнуляются сразу: \(w_0 = 2\), \(w_1 = 0.6\). Это метод наименьших квадратов из Applied Statistics.
Для \(g = \sigma(wx)\) условие такое:
\[ \begin{aligned} \sum_n\ &\big(t_n - \sigma(w x_n)\big) \\ &\cdot\, \sigma'(w x_n)\, x_n = 0 \end{aligned} \]Неизвестное \(w\) сидит внутри \(\sigma\) в каждом слагаемом, выразить его нельзя. В сети таких уравнений столько же, сколько весов, и все они сцеплены.
Вывод профессора: «Closed-form solutions are practically never available so we can use iterative solutions». Раз нельзя прыгнуть в минимум сразу, будем идти к нему шагами.
Наклон подсказывает сторону
Пусть вес один. Производная \(E'(w)\) в точке — это наклон кривой. Наклон отрицательный: вправо ошибка убывает, значит, идти вправо. Положительный: идти влево. В обоих случаях шагать надо в сторону, противоположную знаку производной.
Когда весов много, производных тоже много: по одной на каждый вес. Их собирают в вектор, градиент (gradient) \(\nabla E(w)\). Профессор пишет его как \(\pd{E(w)}{w}\). Градиент смотрит туда, где ошибка растёт быстрее всего. Нам в обратную сторону.
Gradient descent (градиентный спуск) — итеративный поиск минимума: начать со случайных весов и раз за разом сдвигать их против градиента.
- \(w^{k}\)
- все веса после \(k\) шагов; \(w^{0}\) выбирают случайно (initial random configuration)
- \(\eta\)
- learning rate, положительное число: во сколько раз растянуть шаг
- \(\big|_{w^{k}}\)
- градиент считается в текущей точке \(w^{k}\)
- \(E(w)\)
- так на слайде 24; на слайде 23 то же правило записано для произвольной функции \(J(w)\)
У сети \(w\) — это все веса всех слоёв. Правило применяется к каждому отдельно и ко всем одновременно:
\[ w_{ji}^{(l)} \leftarrow w_{ji}^{(l)} - \eta\, \pd{E}{w_{ji}^{(l)}} \]Здесь \(w_{ji}^{(l)}\) — вес слоя \(l\), идущий в нейрон \(j\) от нейрона \(i\): первым стоит индекс того, куда связь приходит. Смещение \(w_{j0}^{(l)}\) обновляется так же.
Алгоритм целиком умещается в четыре строки.
- Выбрать начальные веса \(w^{0}\) случайно.
- Посчитать градиент в текущей точке.
- Сдвинуть все веса против него.
- Повторять, пока градиент не станет почти нулевым или не кончится лимит итераций.
Второй пункт для сети — отдельная большая задача, ей посвящён урок 14. Здесь считаем, что градиент нам кто-то выдаёт.
Почему именно против градиента
-
Стоим в точке \(w\) и ищем сдвиг \(\Delta\), после которого ошибка меньше. Рядом с точкой поверхность почти плоская, как касательная. Для маленького сдвига:
\[ E(w + \Delta) \approx E(w) + \nabla E(w)\T \Delta \] -
Добавка к ошибке — скалярное произведение градиента и сдвига:
\[ \nabla E\T \Delta = \norm{\nabla E}\,\norm{\Delta}\cos\theta \]При фиксированной длине сдвига оно самое отрицательное, когда \(\cos\theta = -1\): сдвиг смотрит ровно против градиента.
-
Берём \(\Delta = -\eta\,\nabla E(w^{k})\) и подставляем:
\[ E(w^{k+1}) \approx E(w^{k}) - \eta\,\norm{\nabla E(w^{k})}^2 \]Вычитается неотрицательное число: ошибка не растёт.
-
Вся оговорка сидит в знаке \(\approx\). Касательная похожа на поверхность только рядом с точкой, то есть при маленьком шаге. Конспект на стр. 97 обещает после шага \(E(w_1) \lt E(w_0)\) и условия не называет. Честная формулировка: ошибка убывает, если \(\eta\) достаточно мала. Насколько мала — следующий раздел.
Два шага на калькуляторе
Возьмём один вес, ошибку \(E(w) = (w - 3)^2\), старт \(w^{0} = 0\) и \(\eta = 0.25\). Такая задача бывает на экзамене.
-
Производная:
\[ E'(w) = 2\,(w - 3) \] -
Первый шаг. Наклон в старте \(E'(0) = -6\):
\[ w^{1} = 0 - 0.25 \cdot (-6) = 1.5 \]Ошибка упала с 9 до 2.25.
-
Второй шаг. Наклон стал положе, \(E'(1.5) = -3\):
\[ w^{2} = 1.5 - 0.25 \cdot (-3) = 2.25 \]Ошибка 0.5625. Шаг сам укоротился вдвое, хотя \(\eta\) не менялась.
-
Закономерность: расстояние до минимума каждый раз делится пополам, \(3 \to 1.5 \to 0.75\). Это видно, если вычесть 3 из обеих частей правила:
\[ w^{k+1} - 3 = (1 - 2\eta)\,(w^{k} - 3) \]При \(\eta = 0.25\) множитель равен 0.5. Запомни его вид: он решит судьбу спуска.
«\(\eta\) — это длина шага». Длина шага равна \(\eta \cdot \norm{\nabla E}\). Чем положе склон, тем короче шаг при той же \(\eta\): около дна спуск тормозит сам.
Learning rate: ползёт, качается, улетает
Теперь два веса и та самая гора из загадки. Это чаша из конспекта, рисунки 10 и 12:
\[ E(w_1, w_2) = (w_1 - 2)^2 + 2\,(w_2 + 1)^2 \]Дно в точке \((2, -1)\). По \(w_2\) чаша вдвое круче, чем по \(w_1\). Она того же сорта, что на карте весов в первом виджете: у линейной модели SSE всегда квадратичная чаша. Рисовать её будем как топографическую карту: вид сверху, линии соединяют точки одинаковой высоты.
Откуда берётся 0.5
Посчитаем то, что виджет показал. Приём тот же, что в примере на калькуляторе: следить не за весом, а за его расстоянием до дна.
-
Градиент чаши:
\[ \pd{E}{w_1} = 2\,(w_1 - 2) \] \[ \pd{E}{w_2} = 4\,(w_2 + 1) \] -
Подставим в правило обновления и вычтем координату дна из обеих частей. Для каждой оси получается своя строка:
\[ w_1^{k+1} - 2 = (1 - 2\eta)\,(w_1^{k} - 2) \] \[ w_2^{k+1} + 1 = (1 - 4\eta)\,(w_2^{k} + 1) \]Каждый шаг умножает расстояние до дна на постоянное число.
-
Расстояние убывает, только если множитель по модулю меньше единицы:
\[ \abs{1 - 2\eta} \lt 1 \iff 0 \lt \eta \lt 1 \] \[ \abs{1 - 4\eta} \lt 1 \iff 0 \lt \eta \lt 0.5 \]Нужны оба условия сразу, значит, побеждает более строгое: \(\eta \lt 0.5\).
-
Знак множителя \(1 - 4\eta\) объясняет и качели. Пока \(\eta \lt 0.25\), он положителен: \(w_2\) подходит к дну с одной стороны. Между 0.25 и 0.5 он отрицателен: \(w_2\) каждый раз перелетает дно, но приземляется ближе. При \(\eta = 0.5\) он равен \(-1\): перелёт на то же расстояние, вечно.
-
При \(\eta = 0.55\) множитель равен \(-1.2\). Стартовое отклонение по \(w_2\) было 4, после двадцати шагов:
\[ 4 \cdot 1.2^{20} \approx 153 \] \[ E \approx 2 \cdot 153^2 \approx 47\,000 \] -
Числа 2 и 4 перед скобками в градиенте — это кривизна чаши вдоль осей, её вторые производные. Общее правило для квадратичной чаши:
\[ \eta \lt \frac{2}{\lambda_{\max}} \]где \(\lambda_{\max}\) — наибольшая кривизна. Здесь \(2/4 = 0.5\). Для \((w - 3)^2\) кривизна равна 2, и потолок \(\eta \lt 1\).
| \(\eta\) | \(1 - 2\eta\) | \(1 - 4\eta\) | \(E\) в конце | Режим |
|---|---|---|---|---|
| 0.05 | 0.9 | 0.8 | 0.37 | ползёт |
| 0.2 | 0.6 | 0.2 | \(3 \cdot 10^{-8}\) | быстро и ровно |
| 0.45 | 0.1 | −0.8 | 0.004 | качели затухают |
| 0.5 | 0 | −1 | 32 | вечные качели |
| 0.55 | −0.1 | −1.2 | 47 033 | расходится |
Итог про \(\eta\) в трёх словах: мало — медленно, много — качели, слишком много — разлёт. Для настоящей сети потолок заранее не посчитать: поверхность не квадратичная, кривизна меняется от точки к точке и никому не известна. Поэтому \(\eta\) подбирают пробами. Это гиперпараметр, о таких — урок 21.
Что скрывает туман: локальные минимумы
До сих пор у горы было одно дно. У ошибки сети их много: сеть нелинейна, и поверхность \(E(w)\) не выпуклая. Отсюда главное ограничение спуска. Он знает только наклон под ногами. Ямка, из которой во все стороны вверх, для него неотличима от самой глубокой долины.
Локальный минимум (local minimum) — точка, вокруг которой ошибка везде не меньше, чем в ней самой. Глобальный минимум (global minimum) — самая низкая точка всей поверхности. Градиент равен нулю и там, и там.
Один старт
Несколько стартов
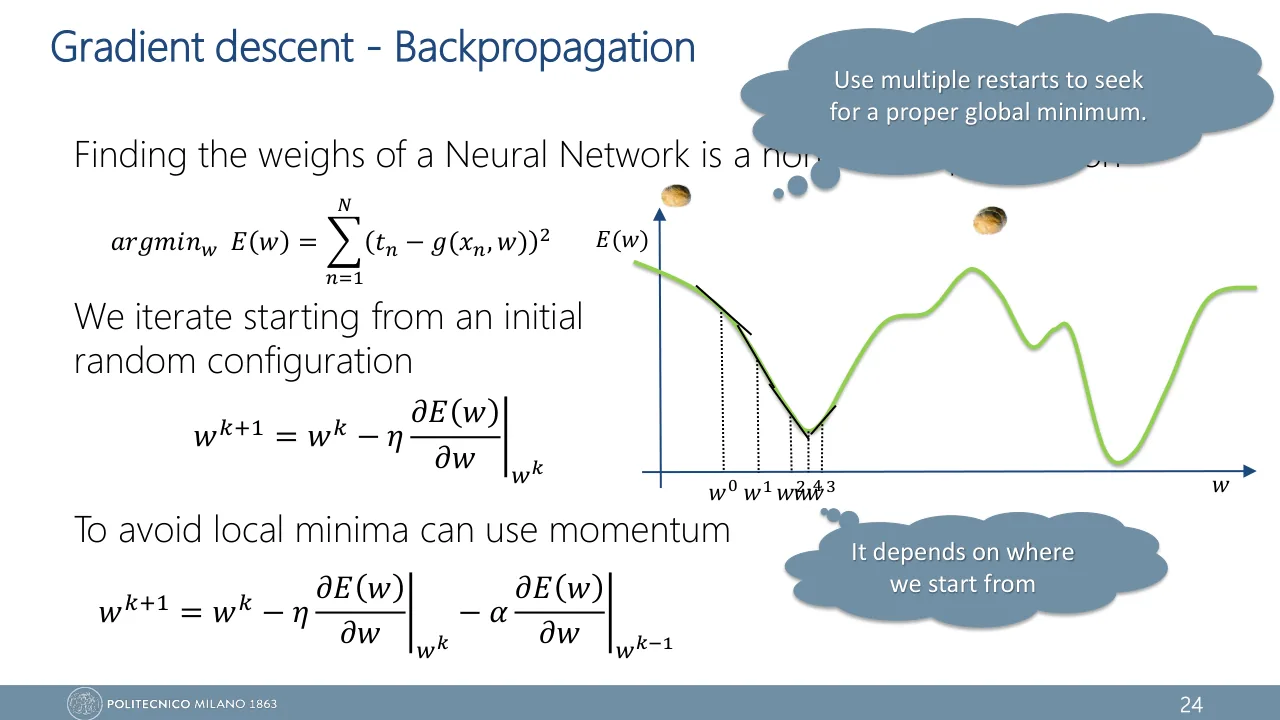
На слайде к этой кривой две подписи. Первая: «It depends on where we start from». Пока градиент считается по всем примерам, сам спуск не случаен: один и тот же старт и одна и та же \(\eta\) дают один и тот же путь. Вся случайность сидит в начальных весах \(w^{0}\). Как выбирать их с умом, расскажет урок 25.
Вторая подпись — лекарство: «Use multiple restarts to seek for a proper global minimum». Multiple restarts значит запустить спуск много раз с разных случайных стартов и оставить лучший результат. Второе лекарство со слайда — momentum: дать шагу память о предыдущем, чтобы шарик не замирал в первой же ямке, а прокатывался дальше по инерции.
- \(\alpha\)
- коэффициент momentum
- \(\big|_{w^{k-1}}\)
- градиент в предыдущей точке: память о прошлом шаге
Почему в учебниках momentum записан не так, как на слайде?
В учебниках и библиотеках шаг помнит не один прошлый градиент, а весь прошлый шаг: \(\Delta w^{k} = -\eta\,g^{k} + \alpha\,\Delta w^{k-1}\), где \(g^{k}\) — градиент в точке \(w^{k}\). Если развернуть эту запись, получится сумма всех прошлых градиентов с убывающими весами:
\[ \begin{aligned} \Delta w^{k} = &-\eta\,g^{k} - \alpha\eta\,g^{k-1} \\ &- \alpha^2\eta\,g^{k-2} - \dots \end{aligned} \]Запись на слайде — первые два слагаемых этой суммы, а её \(\alpha\) играет роль \(\alpha\eta\). Идея общая: шаг зависит не только от текущего наклона. На экзамене пиши формулу так, как она стоит на слайде, и объясняй словами про инерцию. Подробно momentum разобран в уроке 27.
«Градиент равен нулю — веса найдены». Нулевой градиент бывает в глобальном минимуме, в локальном, в максимуме, в седле (saddle point: по одним направлениям вверх, по другим вниз), а на плато он почти нулевой. Конспект на стр. 94 называет только минимум и максимум. По одному градиенту эти случаи не различить.
Есть и хорошая новость, она стоит в конспекте на стр. 99. У больших сетей многие локальные минимумы дают почти одинаковую ошибку, так что оказаться в одном из них не беда. А в пространстве с миллионами осей спуск чаще тормозят не ямы, а сёдла и плато.
Сколько примеров в одном шаге
Остался вопрос цены. \(E(w)\) — сумма по всем \(N\) примерам, значит, и градиент — сумма \(N\) слагаемых. Чтобы сделать один шаг, надо прогнать через сеть весь training set. На слайде 27 лекции 2 об этом сказано так: «Using all the data points (batch) might be unpractical». Слайд 28 даёт три варианта. Отличаются они одним: по скольким примерам считается градиент.
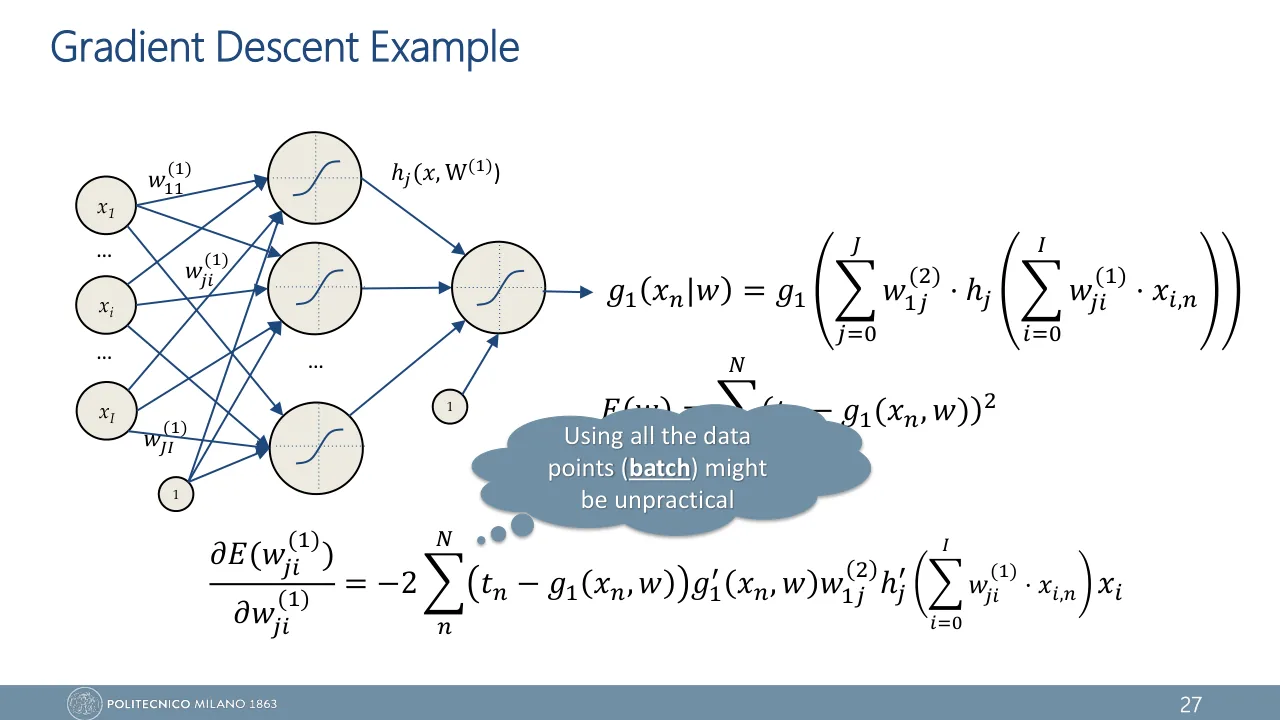
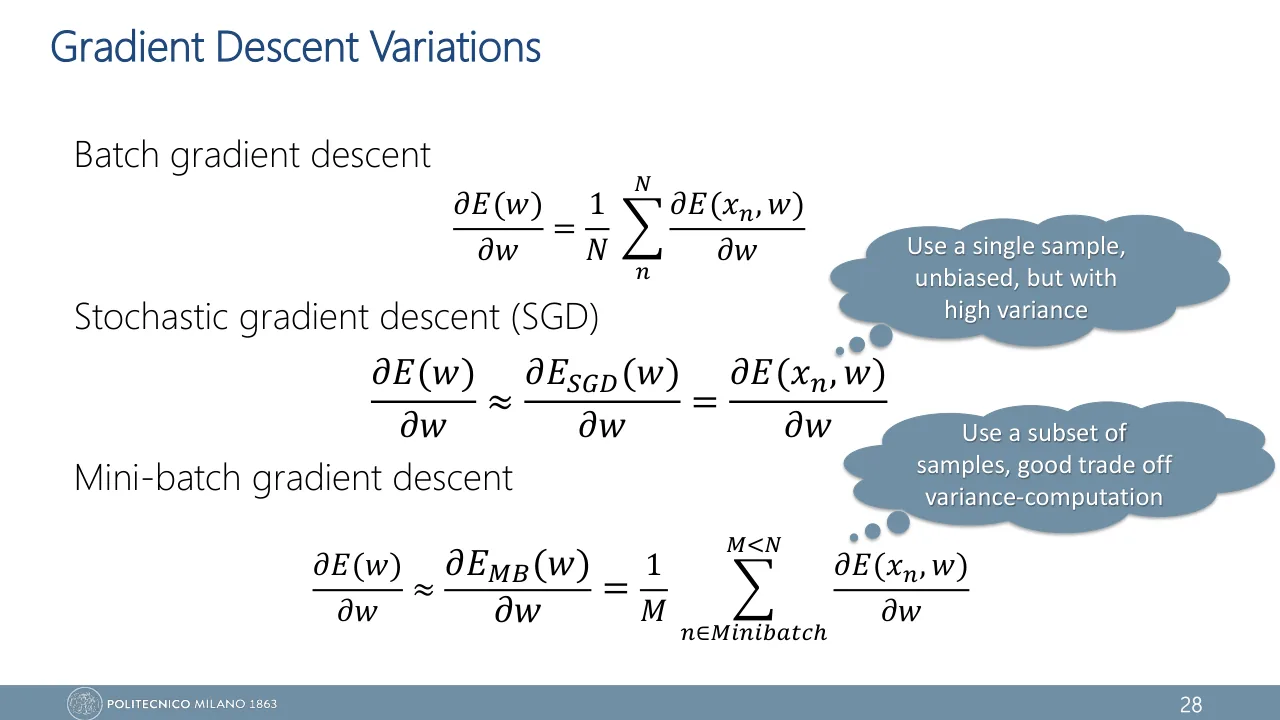
Все \(N\) примеров на каждый шаг. Градиент точный, шаг дорогой.
Один пример на шаг. Подпись на слайде: «Use a single sample, unbiased, but with high variance». Unbiased значит, что в среднем по случайному выбору примера такой градиент равен полному. High variance — что от примера к примеру он сильно скачет.
Группа из \(M \lt N\) примеров. Подпись на слайде: «Use a subset of samples, good trade off variance-computation».
Здесь \(E(x_n, w)\) — ошибка на одном примере \(n\). На этом слайде перед суммой стоит \(1/N\), хотя сама \(E(w)\) на остальных слайдах — сумма без деления. Противоречия нет: постоянный множитель просто уходит в \(\eta\). Что именно шум SGD меняет в обучении и как выбирать \(M\), разобрано в уроке 27.
Развязка: что было в тумане
Вернёмся к путнику. Его гора — чаша из конспекта, старт в точке \((-3,\ 3)\) на высоте 57. Число 0.5 — это \(2/4\): двойка, делённая на кривизну самого крутого направления. При \(\eta = 0.2\) оба множителя, 0.6 и 0.2, по модулю меньше единицы, и путник на дне. При 0.5 множитель по \(w_2\) равен \(-1\): вечные прыжки между \(w_2 = 3\) и \(w_2 = -5\). При 0.55 он равен \(-1.2\), и за двадцать шагов отклонение вырастает в \(1.2^{20} \approx 38\) раз.
Назвать границу заранее можно — но только потому, что гора задана формулой. У настоящей сети формулы рельефа нет, и туман не рассеивается: \(\eta\) подбирают пробами, а от ближних ямок страхуются случайным стартом, рестартами и momentum.
Gradient descent знает только наклон в точке, где стоит: отсюда и его простота, и все его беды.
В формате экзамена
A feed-forward neural network \(g(x|w)\) is trained for regression on \(D = \langle x_1, t_1 \rangle \dots \langle x_N, t_N \rangle\). (a) Write the error function used in the course. (b) Write the gradient descent update rule and explain every symbol. (c) Explain why an iterative procedure is needed.
Show model answer
(a) The Sum of Squared Errors:
\[ E(w) = \sum_{n=1}^{N} \big( t_n - g(x_n|w) \big)^2 \](b) Starting from a random initial configuration \(w^0\), iterate until convergence:
\[ w^{k+1} = w^{k} - \eta \left. \pd{E(w)}{w} \right|_{w^{k}} \]\(w^k\) are the weights at iteration \(k\); \(\eta \gt 0\) is the learning rate; the gradient is evaluated at the current weights. It points in the direction of steepest increase of \(E\), so we move against it.
(c) The minimum satisfies \(\partial E / \partial w = 0\), but \(g\) is a nested non-linear function of \(w\): the resulting equations are non-linear and coupled, and closed-form solutions are practically never available.
Проверяют три вещи: SSE без \(\tfrac12\) и без \(1/N\), знак «минус» вместе со словами «evaluated at \(w^k\)», и причину итеративности через нелинейность \(g\). Ответ «because it is faster» на пункт (c) не годится: дело не в скорости, а в том, что формулы для минимума нет.
A linear model \(g(x|w) = w_0 + w_1 x\) with \(w_0 = 1\), \(w_1 = 2\) is evaluated on the training set \(\langle 0,\ 1.5 \rangle\), \(\langle 1,\ 2.5 \rangle\), \(\langle 2,\ 6 \rangle\). Compute the Sum of Squared Errors \(E(w)\) as defined in the course.
Show model answer
Predictions: 1, 3, 5. Errors \(t_n - g(x_n|w)\): 0.5, −0.5, 1.
\[ E(w) = 0.25 + 0.25 + 1 = 1.5 \]For the record, the gradient component with respect to \(w_1\):
\[ \begin{aligned} \pd{E}{w_1} &= -2 \sum_n \big(t_n - g(x_n|w)\big)\,x_n \\ &= -2\,(0 - 0.5 + 2) = -3 \end{aligned} \]Ловушка — машинально поделить на \(N\) (получится 0.5, это MSE) или на 2 (получится 0.75). У профессора сумма без множителей. Вторая строка ответа показывает, откуда в градиенте берётся \(-2\).
Consider \(E(w) = (w - 3)^2\) with initial weight \(w^0 = 0\) and learning rate \(\eta = 0.25\). Compute \(w^2\), the weight after two iterations of gradient descent.
Show model answer
Типичные потери: забыть двойку в производной (выйдет 1.3125) или прибавить градиент вместо того, чтобы вычесть. Проверка на здравый смысл: вес должен приближаться к 3.
Gradient descent is applied to the error function
\[ E(w_1, w_2) = (w_1 - 2)^2 + 2\,(w_2 + 1)^2 \]Find \(\eta_{\max}\) such that the iterations converge to the minimum from any starting point for every \(0 \lt \eta \lt \eta_{\max}\).
Show model answer
The update decouples: \(w_1^{k+1} - 2 = (1 - 2\eta)(w_1^k - 2)\) and \(w_2^{k+1} + 1 = (1 - 4\eta)(w_2^k + 1)\). Convergence requires \(\abs{1 - 2\eta} \lt 1\) and \(\abs{1 - 4\eta} \lt 1\), i.e. \(\eta \lt 1\) and \(\eta \lt 0.5\).
\[ \eta_{\max} = 0.5 \]At \(\eta = 0.5\) the weight \(w_2\) oscillates forever; above it the iterations diverge.
Ограничение задаёт самая крутая координата. Ответ 1 получается, если посмотреть только на \(w_1\). В общем виде: \(\eta \lt 2/\lambda_{\max}\), где \(\lambda_{\max}\) — наибольшая кривизна, здесь это вторая производная по \(w_2\), равная 4.
Gradient descent is run on the error function of a feed-forward neural network. Which statements are correct? Select all that apply.
Show model answer
Correct: A, C and E. The error surface of a network is non-convex, so gradient descent converges to a stationary point that depends on the initialisation; a zero gradient only identifies a stationary point; the slides propose momentum and multiple restarts.
В вопросах «select all» каждое утверждение проверяй отдельно, как вопрос «верно или нет». Не отмечай утверждения со словами always и never, пока не проверишь их на контрпримере: здесь оба таких утверждения ложны.
Write the gradient used by batch, stochastic and mini-batch gradient descent, and state the trade-off between them.
Show model answer
Batch:
\[ \pd{E(w)}{w} = \frac{1}{N} \sum_{n}^{N} \pd{E(x_n, w)}{w} \]Stochastic:
\[ \pd{E(w)}{w} \approx \pd{E(x_n, w)}{w} \]Mini-batch:
\[ \pd{E(w)}{w} \approx \frac{1}{M} \sum_{n \in \text{Minibatch}}^{M \lt N} \pd{E(x_n, w)}{w} \]Batch uses all \(N\) samples for each update: the gradient is exact but each step is expensive. SGD uses a single sample: an unbiased estimate with high variance, very cheap. Mini-batch uses a subset of \(M \lt N\) samples: a good trade-off between variance and computation.
Слова unbiased, high variance и trade-off variance-computation взяты со слайда 28 лекции 2 дословно: их и ищут в ответе.
Проверь себя
В первом виджете ты перетаскиваешь прямую. Что при этом происходит на плоскости весов?
SSE заменили на MSE: поделили \(E\) на \(N = 100\). Спуск запускают с тем же стартом и той же \(\eta\). Что изменится?
Ошибка \(E(w) = 5\,(w - 1)^2\). При каких \(\eta\) градиентный спуск расходится?
Что верно про градиент \(\nabla E(w)\)? Отметь все верные варианты.
Картинка для памяти: стрелка, торчащая из линии уровня в гору.
Спуск остановился: градиент равен нулю. Что из этого следует?
Одну и ту же сеть обучили десять раз на одних и тех же данных и получили десять разных значений \(E\). Почему, и что с этим делать?
Почему про SGD на слайде сказано «unbiased, but with high variance»?
Унести с собой
- Supervised learning: есть training set из пар \(\langle x_n, t_n \rangle\) и parametric model \(g(x|w)\); ищем веса, при которых \(g(x_n|w) \sim t_n\) на новых данных.
- Ошибка у профессора — Sum of Squared Errors без \(\tfrac12\) и без \(1/N\). Это поверхность над пространством весов; данные при этом заморожены.
- Для нелинейной \(g\) уравнение \(\partial E / \partial w = 0\) в явном виде не решается, поэтому от случайного старта идут шагами против градиента.
- Learning rate: мало — медленно, много — качели, слишком много — расходимость. Для квадратичной чаши потолок точный: \(\eta \lt 2/\lambda_{\max}\).
- Поверхность ошибки сети не выпуклая: финиш зависит от старта. Лекарства со слайда 24 лекции 2 — multiple restarts и momentum.
- Batch, SGD и mini-batch различаются числом примеров на один шаг: \(N\), один или \(M \lt N\).
Что посмотреть и почитать
-
Gradient descent, how neural networks learn
3Blue1Brownоколо 21 мин
Та же картина рельефа над пространством весов, но в движении. Учти словарь: там ошибку называют cost, у профессора это error function.
-
Linear regression: Gradient descent exercise
Google Machine Learning Crash Course
Три задания на те же три режима learning rate, но на настоящей регрессии. Сделай их после второго виджета и нарисуй от руки три кривые ошибки.
-
A Neural Network Playground
Daniel Smilkov, Shan Carter
Проверка на настоящей сети: на данных Circle поставь learning rate на максимум, потом на минимум. Потолок есть и там, только формулой его уже не найти.
-
Using neural nets to recognize handwritten digits
Michael Nielsenраздел про gradient descent
Тот же вывод «почему против градиента» через малое приращение, плюс переход к stochastic gradient descent. Сайт открывается только по http.