Откуда берутся функции ошибки
После этого урока ты выведешь сумму квадратов и cross-entropy из одного принципа — maximum likelihood — и про любую функцию ошибки скажешь, какое предположение о данных в ней спрятано.
Одну и ту же величину измерили три раза и получили 2, 4 и 9. Нужно назвать одно число. Почти любой скажет: «5, среднее». А почему не 4 — то, что стоит посередине? Откуда вообще известно, что усреднять правильно?
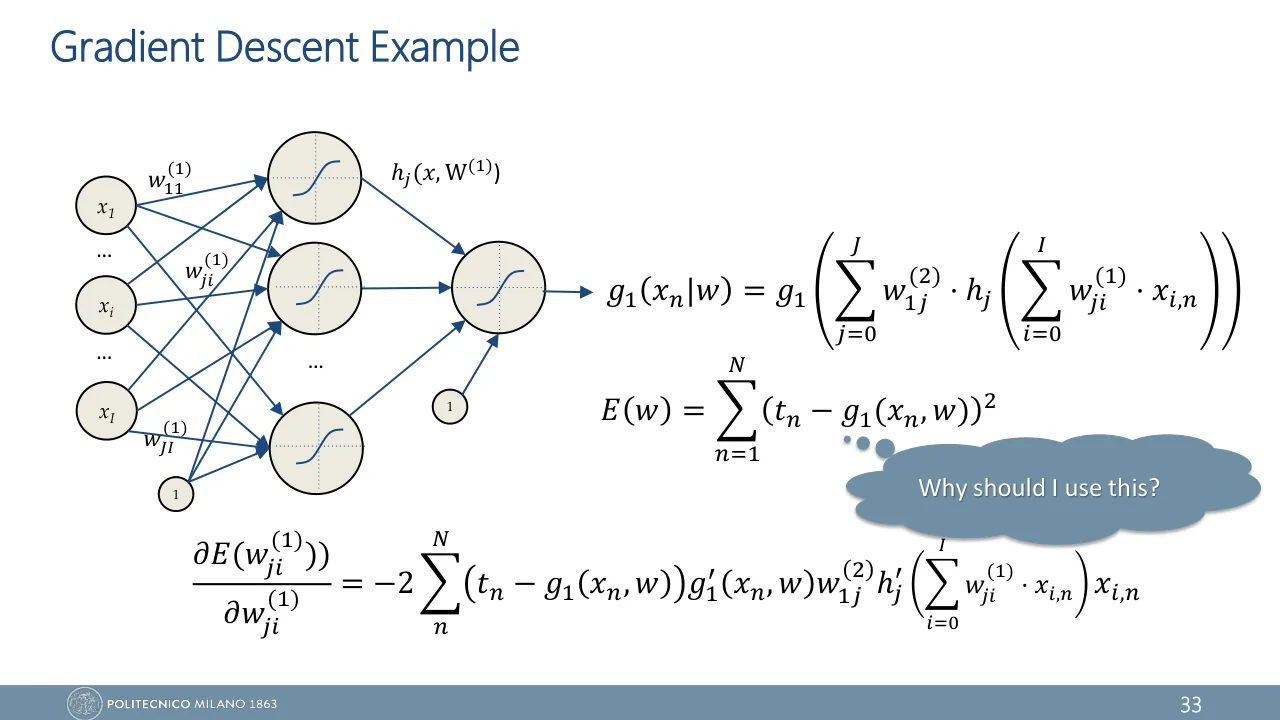
В уроке 11 остался вопрос того же сорта. Для regression сеть учили на сумме квадратов, для classification — на cross-entropy, и обе формулы были выданы как рецепт. На слайде 33 лекции 2 профессор сам пишет рядом с суммой квадратов: "Why should I use this?"
У обоих вопросов один ответ, и он помещается в несколько строк школьной алгебры. К концу урока окажется, что и 5, и 4 могут быть правильными — смотря что предположить о шуме.
Улики и подозреваемые: что такое likelihood
В уроках 13 и 14 мы научились уменьшать \(E(w)\): backpropagation считает градиент, gradient descent делает шаг. Остался вопрос, что уменьшать. Ответ приходит из статистики и называется maximum likelihood estimation (MLE) — оценка наибольшего правдоподобия.
Начнём с монетки. Её подбросили 10 раз: 7 орлов, 3 решки. Есть три «подозреваемых» — три гипотезы о том, с какой вероятностью \(p\) у этой монетки выпадает орёл: 0.5, 0.7 или 0.9. Следователь рассуждает так: если бы всё было устроено по этой гипотезе, насколько ожидаемы были бы такие улики? Для каждой гипотезы считаем вероятность увидеть именно нашу серию бросков: \(p^7 (1-p)^3\).
| гипотеза \(p\) | вероятность данных \(p^7(1-p)^3\) |
|---|---|
| 0.5 | 0.00098 |
| 0.7 | 0.00222 |
| 0.9 | 0.00048 |
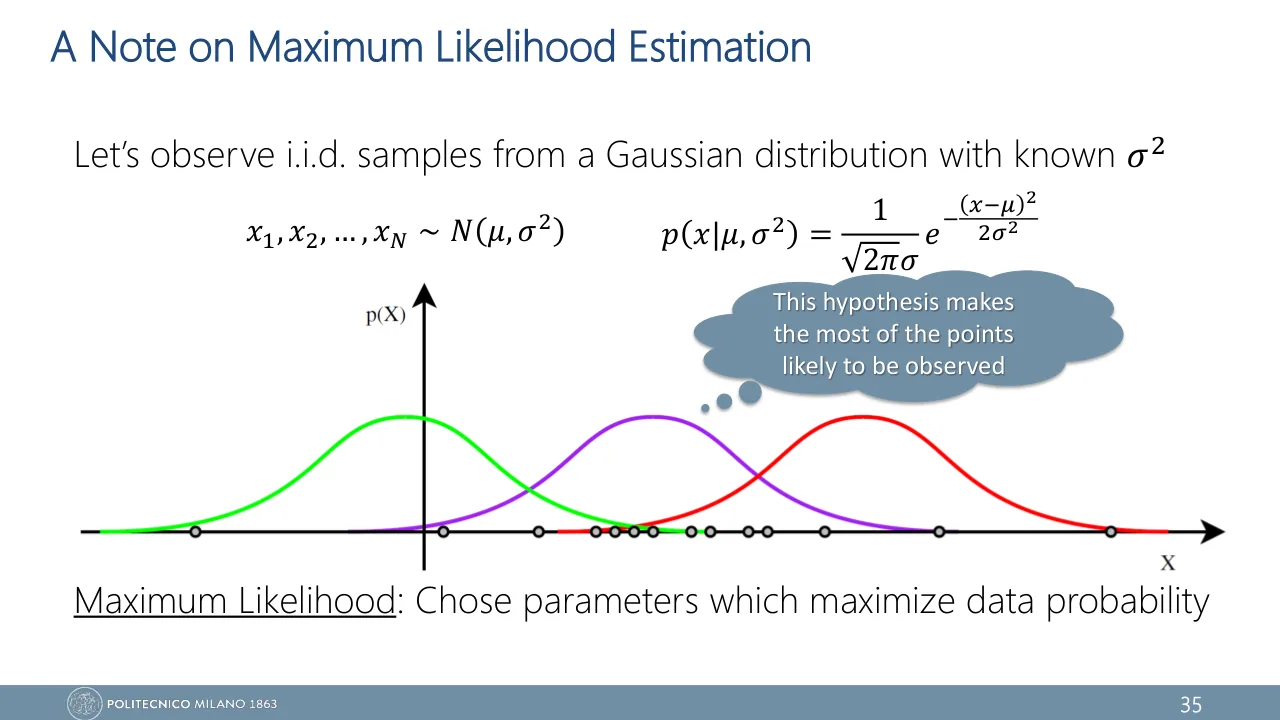
Данные не менялись, менялась только гипотеза. Лучше всех данные объясняет \(p = 0.7\) — ровно доля орлов \(7/10\). В этом весь принцип, и на слайде 35 лекции 2 он записан одной строкой: "Maximum Likelihood: Chose parameters which maximize data probability".
Likelihood (правдоподобие) — вероятность наблюдённых данных, рассмотренная как функция параметров модели \(\theta\). Данные зафиксированы, меняются параметры. Для непрерывных величин на месте вероятности стоит плотность.
- \(\mathcal{D}\)
- данные: наблюдения \(x_1, \dots, x_N\)
- \(\theta\)
- параметры модели: у монетки это \(p\), у сети — веса \(w\)
- \(p(x_n|\theta)\)
- вероятность (или плотность) одного наблюдения при этих параметрах
- \(\prod\)
- произведение по всем наблюдениям — следствие i.i.d.
Откуда произведение? Из предположения i.i.d. — independent and identically distributed. Independent: наблюдения не влияют друг на друга, поэтому вероятность всей серии равна произведению вероятностей отдельных бросков. Identically distributed: все наблюдения приходят из одного распределения с одними и теми же \(\theta\). Без первого не было бы произведения. Без второго у каждого наблюдения могли бы быть свои параметры, и одно общее \(\theta\) по \(N\) наблюдениям было бы не оценить.
«Likelihood — это вероятность того, что гипотеза верна». Нет: это вероятность данных при этой гипотезе. Числа 0.00098, 0.00222 и 0.00048 в сумме не дают единицу и не обязаны: по \(\theta\) likelihood не является распределением. Сравнивать гипотезы им можно, называть «вероятностью гипотезы» — нельзя.
То же самое с колоколом
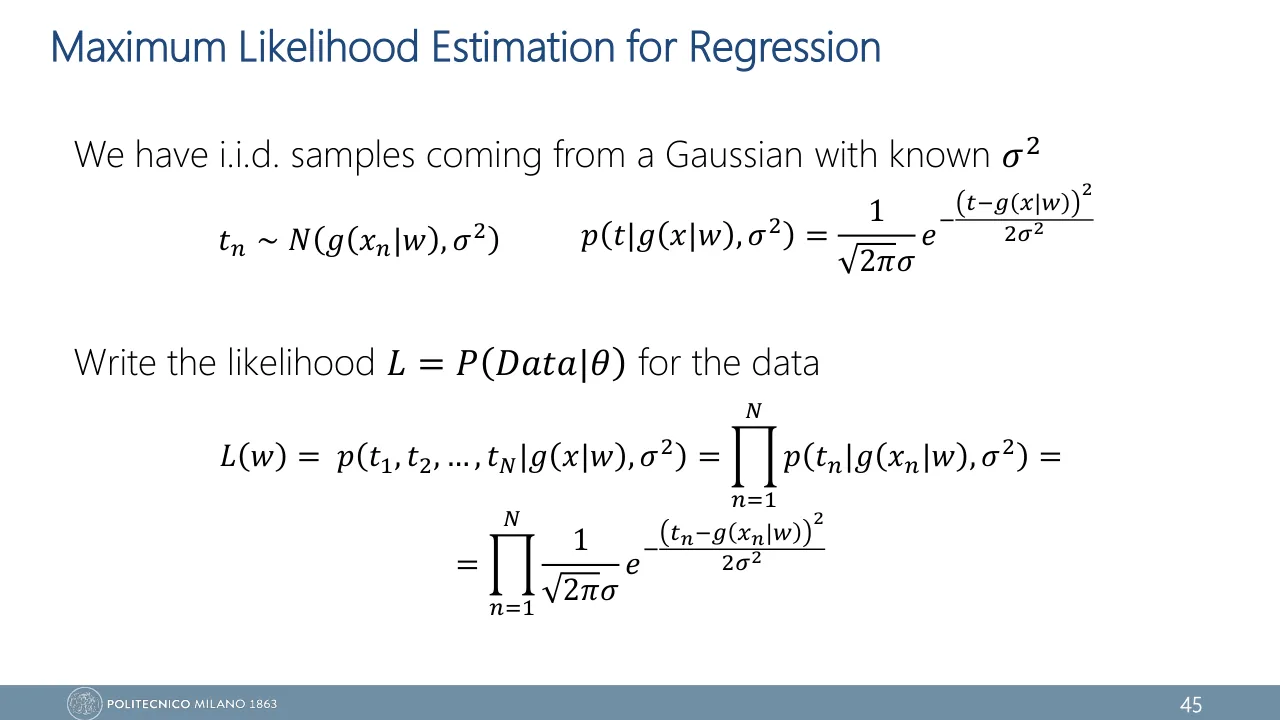
У монетки данные дискретные. На слайдах 34–41 профессор разбирает непрерывный пример, он же нарисован в конспекте на стр. 109. Есть \(N\) измерений, i.i.d. из Gaussian \(N(\mu, \sigma^2)\). Ширина колокола \(\sigma\) известна, центр \(\mu\) — нет. От каждой гипотезы точка получает «оценку» — высоту колокола над собой:
\[ p(x\,|\,\mu, \sigma^2) = \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{\textstyle -\frac{(x-\mu)^2}{2\sigma^2}} \]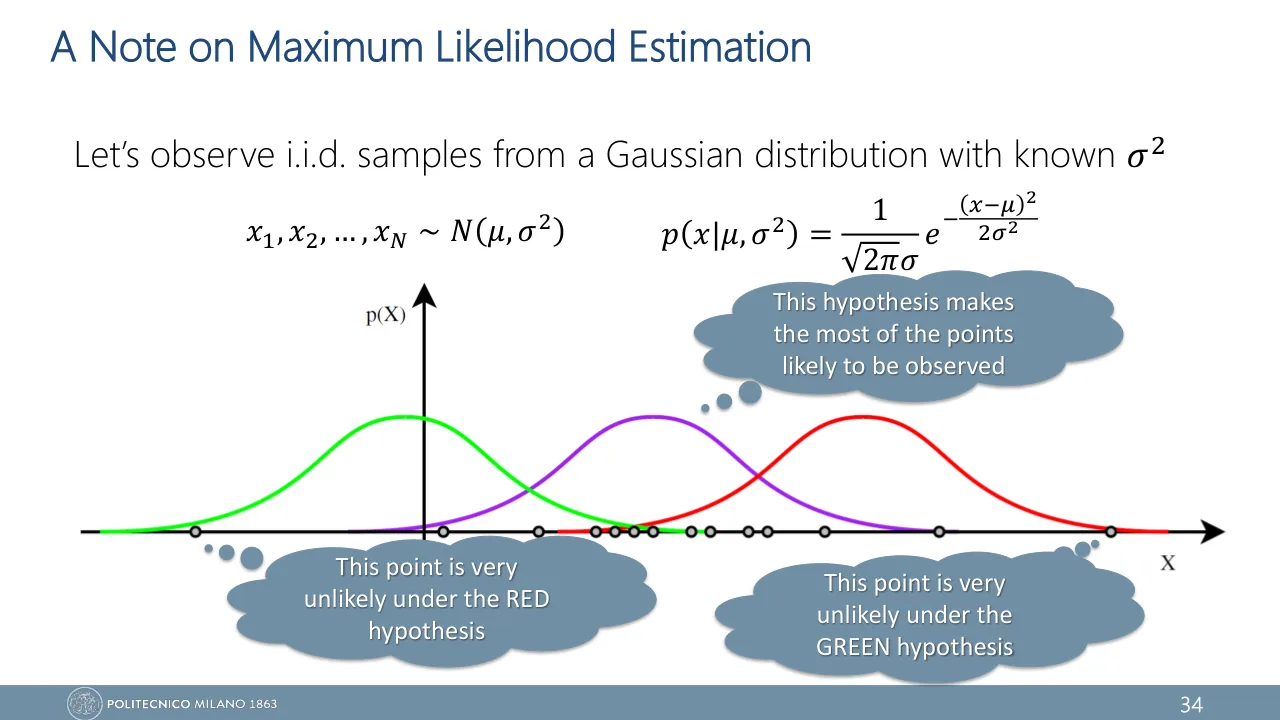
Гипотезы теперь — положения колокола. На слайде 34 их три: зелёный слева, красный справа, фиолетовый посередине, и только про фиолетовый сказано: "This hypothesis makes the most of the points likely to be observed". На рис. 1 — две такие гипотезы на точках из конспекта.
До: \(\mu = 3.5\), \(L \approx 1.9 \cdot 10^{-22}\)
После: \(\mu = 5.82\), \(L \approx 2.8 \cdot 10^{-10}\)
«Высота колокола над точкой — это вероятность получить именно это значение». Нет. Для непрерывной величины \(P(X = x) = 0\) при любом \(x\). Плотность — это вероятность на единицу длины, а сама вероятность получается интегралом по отрезку. Проверка: у Gaussian с \(\sigma = 0.2\) высота пика \(1 / (\sqrt{2\pi} \cdot 0.2) \approx 1.99\). Вероятность не бывает больше единицы, плотность — запросто.
Поэтому и \(L(\mu)\) — не вероятность, а произведение плотностей: само число ничего не значит, значит только сравнение гипотез между собой. В конспекте на стр. 109 про плотность сказано "describes the likelihood of a random variable taking on a specific value" — читай это так, как там же уточнено следующей фразой: "how dense the probability is around that value".
Двигать колокол рукой и следить за числами полезнее, чем читать про это.
Maximum likelihood: из всех значений параметров выбираем то, при котором уже наблюдённые данные наиболее вероятны.
Рецепт из пяти шагов и зачем в нём логарифм
В виджете максимум нашёлся ползунком. На слайде 36 лекции 2 профессор даёт рецепт, как найти его на бумаге. Это готовый план ответа на любую задачу вида "derive the maximum likelihood estimator of…".
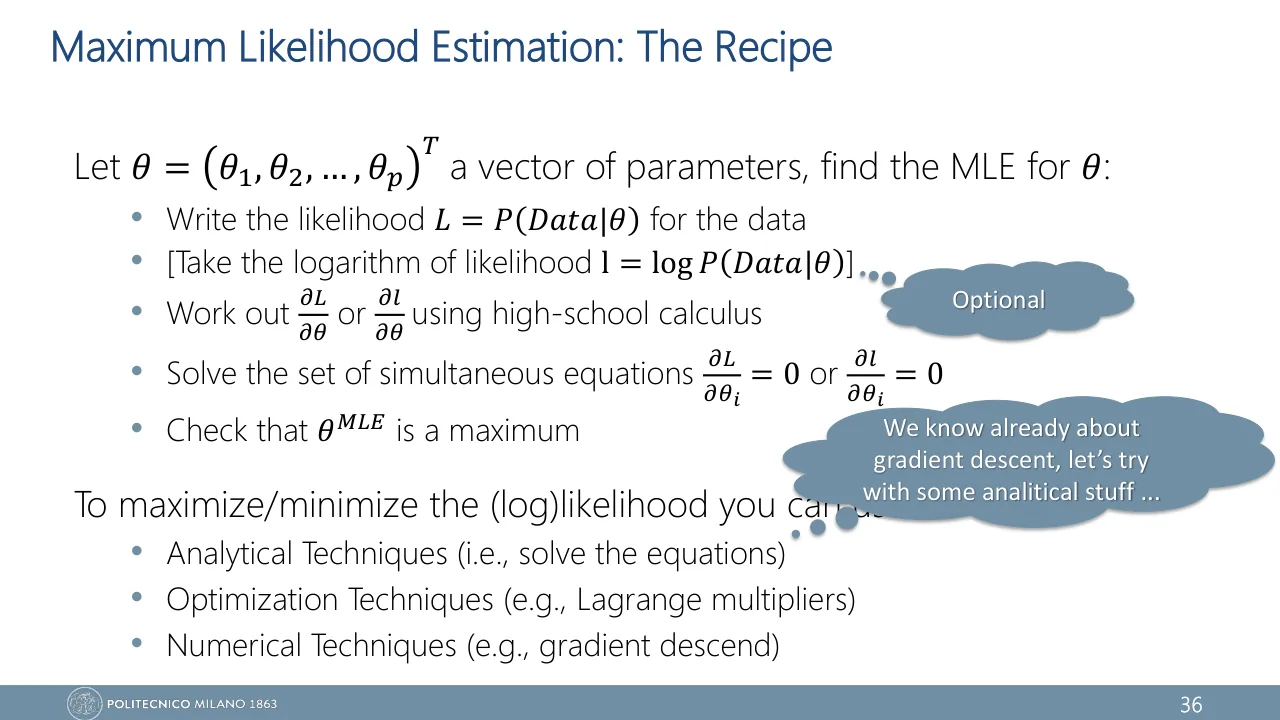
- Запиши likelihood: \(L = P(Data\,|\,\theta)\).
- Возьми логарифм: \(l = \log L\). Шаг помечен «optional», но без него почти никогда не обходится.
- Посчитай производные \(\partial l / \partial \theta\).
- Приравняй их к нулю и реши систему уравнений.
- Проверь, что найденная точка — максимум.
Для шагов 3–4 на слайде названы три инструмента: аналитический (решить уравнения), оптимизационный (например, множители Лагранжа) и численный — тот самый gradient descent. Для среднего Gaussian хватит производной из школы. Для сети уравнения в явном виде не решаются, и там работает спуск.
Зачем логарифм
Причин три, и все уже были видны в виджете.
Максимум не сдвигается. Логарифм монотонно возрастает: если \(L(a) \gt L(b)\), то и \(\log L(a) \gt \log L(b)\). Значение функции меняется, место максимума — нет. Функцию \(l = \log L\) называют log-likelihood.
Произведение становится суммой. \(\log(ab) = \log a + \log b\). Производная суммы — сумма производных, а производная произведения пятнадцати множителей — пятнадцать слагаемых по пятнадцать множителей в каждом.
Числа остаются числами. Произведение многих чисел меньше единицы быстро становится исчезающе малым: для 15 точек лучшее \(L\) уже порядка \(10^{-10}\), а при узком колоколе вдали от данных виджет показывает \(10^{-200}\) и меньше — на тысячах примеров компьютер округлит такое до нуля. Сумма логарифмов при этом — обычное число вроде \(-22\).
До логарифма: произведение \(L(\mu)\)
После: сумма \(l(\mu) = \log L(\mu)\)
Среднее Gaussian — по рецепту
Теперь то же самое на бумаге, шаг за шагом. Прежде чем открывать очередной шаг, попробуй написать его на черновике.
-
Шаг 1: likelihood. Точки i.i.d., поэтому плотность всего набора — произведение плотностей:
\[ L(\mu) = \prod_{n=1}^{N} \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{\textstyle -\frac{(x_n-\mu)^2}{2\sigma^2}} \] -
Шаг 2: логарифм. Логарифм произведения — сумма логарифмов, а \(\log e^{a} = a\). Множитель перед экспонентой одинаков для всех \(n\), поэтому он просто повторяется \(N\) раз:
\[ \begin{aligned} l(\mu) = {} & N \log\frac{1}{\sqrt{2\pi}\,\sigma} \\ & - \frac{1}{2\sigma^2}\sum_{n=1}^{N}(x_n-\mu)^2 \end{aligned} \] -
Шаг 3: производная по \(\mu\). Первое слагаемое от \(\mu\) не зависит и исчезает. У второго по chain rule появляется \(2(x_n-\mu)\cdot(-1)\):
\[ \pd{l}{\mu} = -\frac{1}{2\sigma^2}\sum_{n=1}^{N} 2(x_n-\mu)(-1) \] \[ \pd{l}{\mu} = \frac{1}{\sigma^2}\sum_{n=1}^{N}(x_n-\mu) \] -
Шаг 4: приравниваем к нулю. Множитель \(1/\sigma^2\) положителен, на него можно сократить:
\[ \sum_{n=1}^{N}(x_n-\mu) = 0 \;\;\Rightarrow\;\; \sum_{n=1}^{N} x_n = N\mu \] \[ \mu^{MLE} = \frac{1}{N}\sum_{n=1}^{N} x_n \]Это среднее арифметическое выборки. Известная \(\sigma\) в ответ не вошла — как и было видно в виджете.
-
Шаг 5: это точно максимум? Вторая производная отрицательна при любом \(\mu\):
\[ \frac{\partial^2 l}{\partial \mu^2} = -\frac{N}{\sigma^2} \lt 0 \]Значит, \(l(\mu)\) — перевёрнутая парабола с единственной вершиной. В конспекте этого шага нет, а на слайде 36 он есть: "Check that \(\theta^{MLE}\) is a maximum". Нулевая производная сама по себе обещает только стационарную точку.
Результат выглядит скромно: лучшая оценка среднего — среднее. Но посмотри на шаг 2. После логарифма от \(\mu\) зависит только \(\sum_n (x_n - \mu)^2\), причём со знаком минус. Максимизировать likelihood для Gaussian — то же самое, что минимизировать сумму квадратов. Квадрат никто не «выбирал»: он стоял в показателе экспоненты колокола.
Почему \(l(\mu)\) получается именно параболой с вершиной в среднем?
Сумму квадратов можно разложить вокруг среднего выборки \(\bar{x}\):
\[ \begin{aligned} \sum_n (x_n-\mu)^2 = {} & \sum_n (x_n-\bar{x})^2 \\ & + N(\bar{x}-\mu)^2 \end{aligned} \]Первое слагаемое от \(\mu\) не зависит — это разброс точек вокруг их собственного среднего. Второе — квадрат расстояния от \(\mu\) до \(\bar{x}\). Проверь на трёх точках 2, 4, 9: при \(\mu = 5\) сумма равна \(9 + 1 + 16 = 26\), при \(\mu = 4\) — \(4 + 0 + 25 = 29 = 26 + 3 \cdot 1^2\).
Regression: шум Гаусса превращается в сумму квадратов
Слайд 41 лекции 2 заканчивается словами "Let’s apply this all to Neural Networks!". Замена одна: вместо постоянного центра \(\mu\) — выход сети \(g(x_n|w)\), свой для каждого входа.
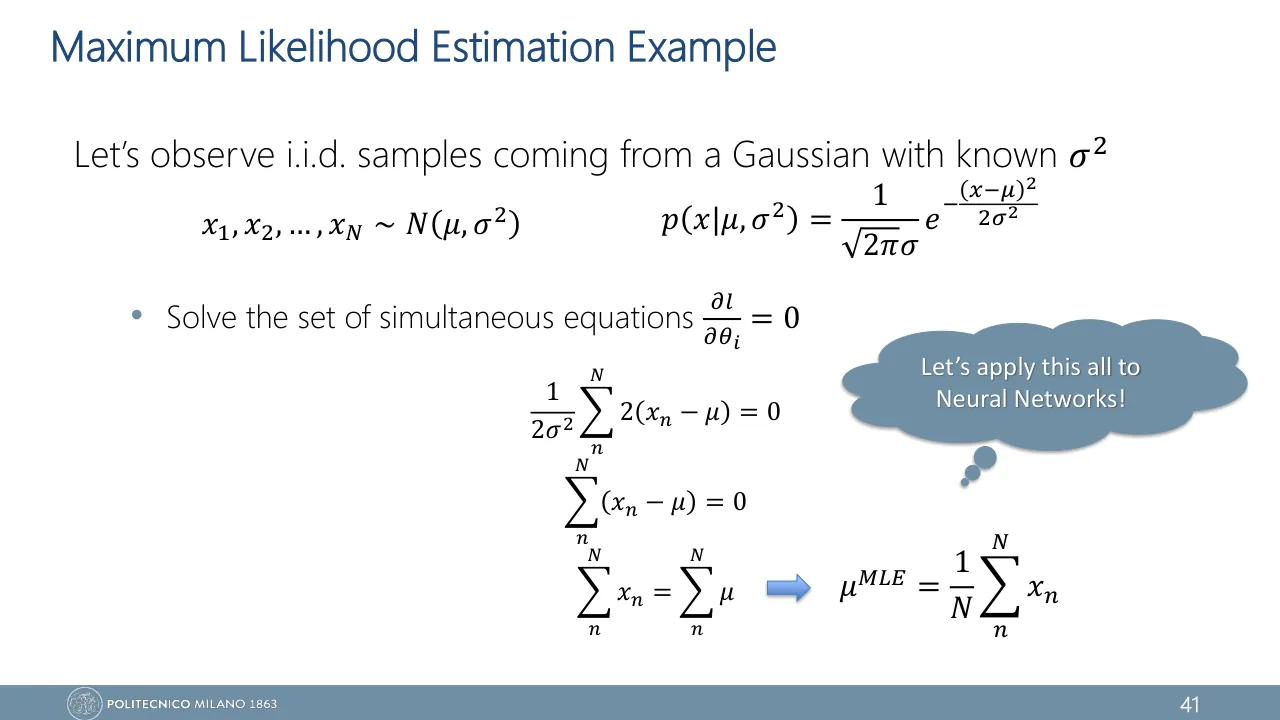
Дальше всё записано как на слайдах. В конспекте те же вещи выглядят так: выход сети \(y(x_n, w)\) вместо \(g(x_n|w)\); оценка \(\hat{w}_{MLE}\) вместо \(w^{MLE}\); log-likelihood \(\ell\) вместо \(l\); классы \(c = 1, \dots, C\) вместо \(k = 1, \dots, K\); слово "loss function" вместо "error function". Target (желаемый ответ) и там, и там — \(t_n\).
И одна опечатка: на стр. 108 истинное среднее названо \(\hat{\mu}\). Шляпка означает оценку по данным; истинное среднее — просто \(\mu\).
Сначала история о том, как появились данные (слайд 42). Target — это ответ сети плюс случайный шум:
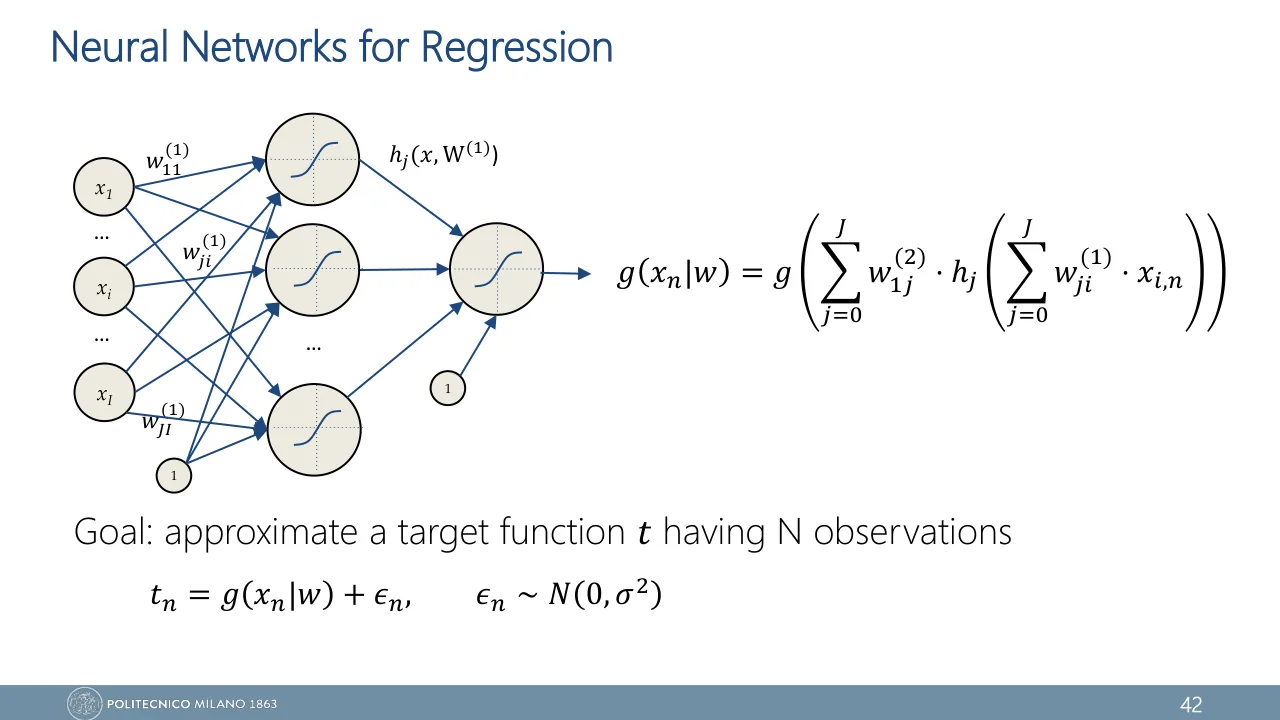
- \(t_n\)
- target примера \(n\)
- \(g(x_n|w)\)
- выход сети на входе \(x_n\) при весах \(w\)
- \(\epsilon_n\)
- шум: ошибки измерения и всё, чего входы не объясняют
- \(\sigma^2\)
- дисперсия шума — известная и одна и та же для всех \(n\)
Если к числу \(g(x_n|w)\) прибавить Gaussian с нулевым средним, получится Gaussian с центром в \(g(x_n|w)\): \(t_n \sim N(g(x_n|w), \sigma^2)\). Колокол из рис. 1 больше не стоит на оси. Он лежит на боку и едет вдоль кривой модели — это рисунок со слайда 43.
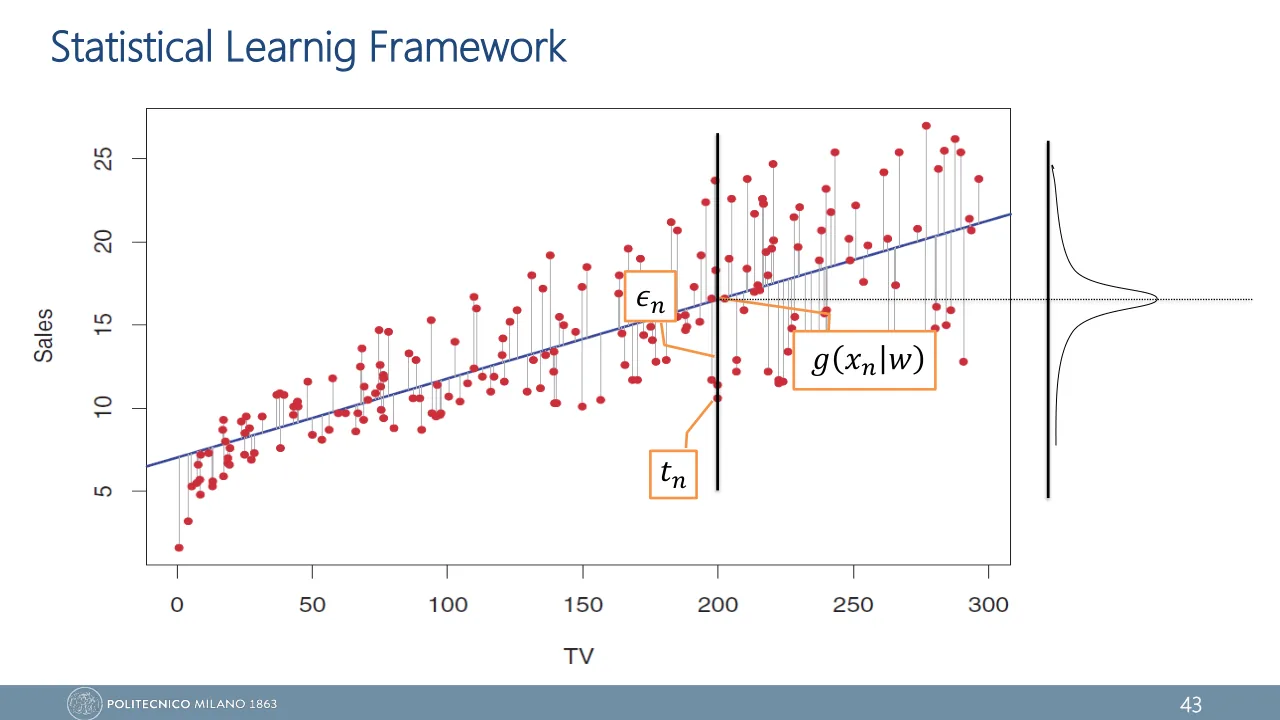
Дальше — тот же рецепт. Неизвестное теперь не \(\mu\), а веса \(w\), но данные по-прежнему зафиксированы, и мы ищем параметры, при которых они наиболее вероятны.
-
Плотность одного target. Из \(t_n = g(x_n|w) + \epsilon_n\) следует, что \(t_n\) — Gaussian с центром в ответе сети:
\[ p(t_n|x_n, w) = \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{\textstyle -\frac{(t_n - g(x_n|w))^2}{2\sigma^2}} \] -
Likelihood. Шум в разных примерах независим, значит плотности перемножаются:
\[ L(w) = \prod_{n=1}^{N} \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{\textstyle -\frac{(t_n - g(x_n|w))^2}{2\sigma^2}} \] -
Логарифм. Ровно как для среднего, только на месте \(\mu\) стоит \(g(x_n|w)\):
\[ \begin{aligned} l(w) = {} & N \log\frac{1}{\sqrt{2\pi}\,\sigma} \\ & - \frac{1}{2\sigma^2}\sum_{n=1}^{N}\bigl(t_n - g(x_n|w)\bigr)^2 \end{aligned} \] -
Убираем то, что не зависит от \(w\). В первом слагаемом только \(N\) и известная \(\sigma\). Это константа: она поднимает или опускает всю функцию целиком и не двигает место максимума. Максимизировать остаётся только второе слагаемое:
\[ -\frac{1}{2\sigma^2}\sum_{n=1}^{N}\bigl(t_n - g(x_n|w)\bigr)^2 \;\to\; \max_w \] -
Убираем множитель и минус. \(\frac{1}{2\sigma^2}\) — положительная константа: растянуть функцию по вертикали не значит сдвинуть её вершину. А максимум «минус суммы» — это минимум суммы:
\[ w^{MLE} = \argmin_w \sum_{n=1}^{N}\bigl(t_n - g(x_n|w)\bigr)^2 \]Справа — Sum of Squared Errors, та самая \(E(w)\) со слайда 33 лекции 2. На слайде 47 этот результат обведён.
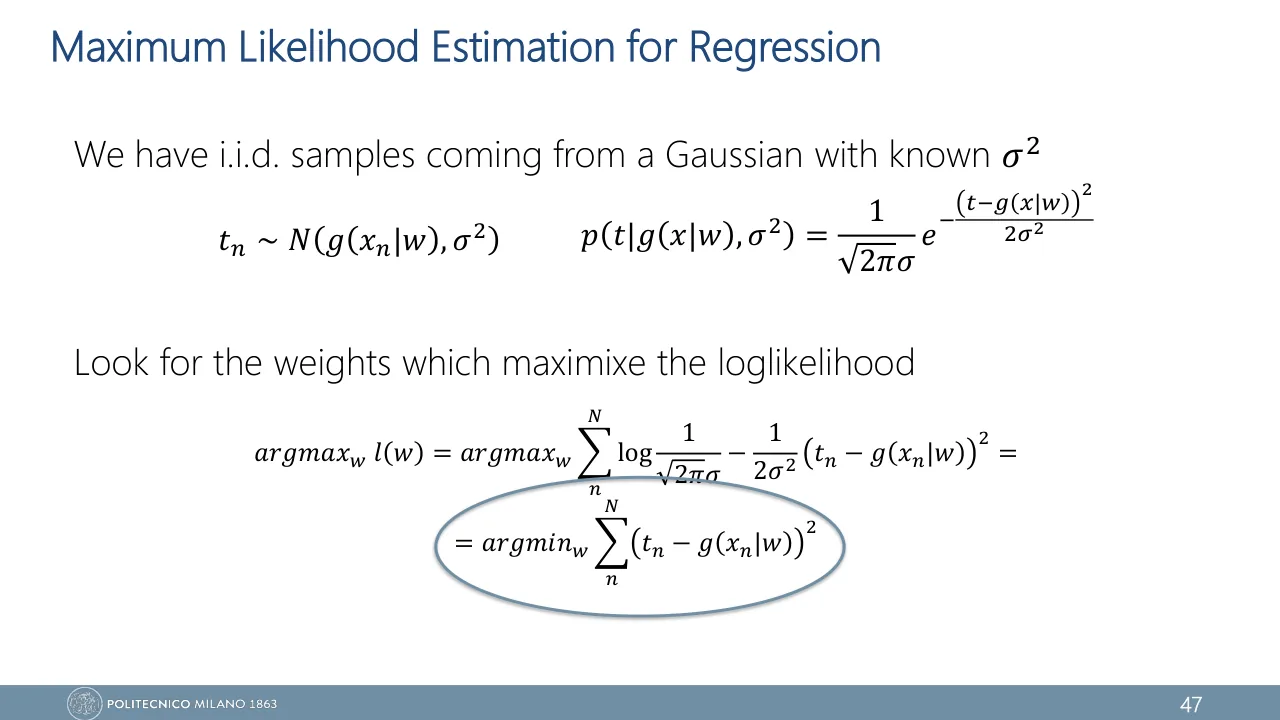
Вот ответ на "Why should I use this?". Сумма квадратов — не дело вкуса, а следствие трёх предположений. На экзаменационный вопрос "Which assumptions did you use?" отвечай ими:
- примеры независимы — отсюда произведение, а после логарифма сумма по \(n\);
- шум гауссов с нулевым средним — отсюда квадрат (он пришёл из показателя экспоненты);
- дисперсия шума \(\sigma^2\) известна и одинакова для всех примеров — поэтому она выносится за сумму и исчезает.
Здесь должно стать уютно: метод наименьших квадратов из Applied Statistics — это maximum likelihood при гауссовых остатках, просто там \(g\) была прямой. Сеть меняет только форму \(g\), вывод остаётся тем же.
«SSE, MSE и половина SSE — разные функции ошибки, у них разные минимумы». Нет. Они отличаются положительным множителем (\(\frac{1}{N}\) или \(\frac{1}{2}\)), и \(\arg\min\) у всех один. Меняется только масштаб градиента, а его поглощает \(\eta\). В конспекте на стр. 111 итог записан как MSE с \(\frac{1}{N}\); у профессора — сумма без коэффициентов. На экзамене пиши как на слайде: \(E(w) = \sum_n (t_n - g(x_n|w))^2\).
На слайде 45 лекции 2 написано "i.i.d. samples coming from a Gaussian". Разве у всех \(t_n\) одно распределение?
Строго говоря, нет: у каждого \(t_n\) свой центр \(g(x_n|w)\). Одинаково распределён шум \(\epsilon_n\), а targets независимы при заданных входах. Выводу это не мешает: для произведения нужна только независимость, а разные центры честно стоят внутри каждого множителя. На экзамене используй формулировку слайда — и держи в голове, что i.i.d. относится к шуму.
Classification: монетка превращается в cross-entropy
В бинарной classification target равен 0 или 1. История «ответ сети плюс гауссов шум» тут не годится: 0.8 плюс случайная добавка не даст ровно 0 или ровно 1. Нужна другая история о том, как появились данные.
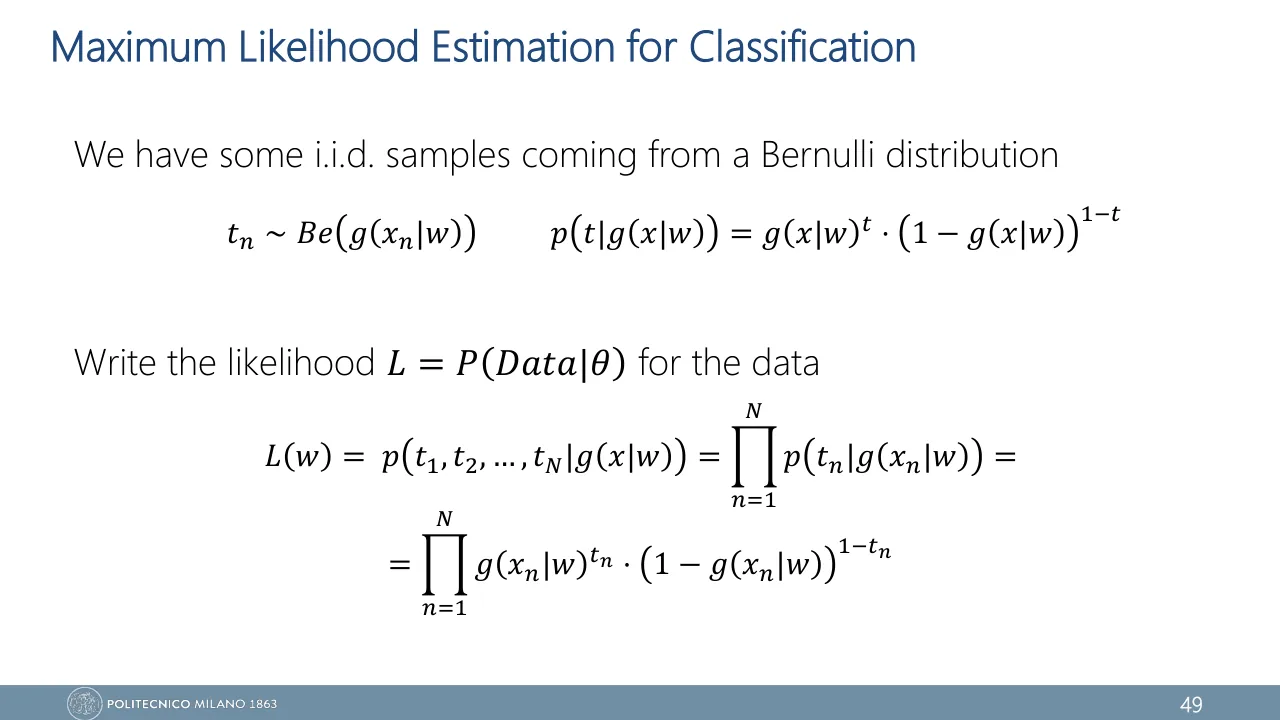
Она на слайде 48 лекции 2, и цель там названа так: "approximate a posterior probability". Сеть выдаёт вероятность единицы при данном входе: \(g(x_n|w) = p(t_n = 1\,|\,x_n)\) (на слайде короче: \(p(t_n|x_n)\)). А сам target — бросок несимметричной монетки с этой вероятностью. Такое распределение называется Bernoulli: \(t_n \sim Be(g(x_n|w))\). Это монетка из начала урока, только у каждого входа \(x_n\) она своя, и вероятность орла у неё назначает сеть.
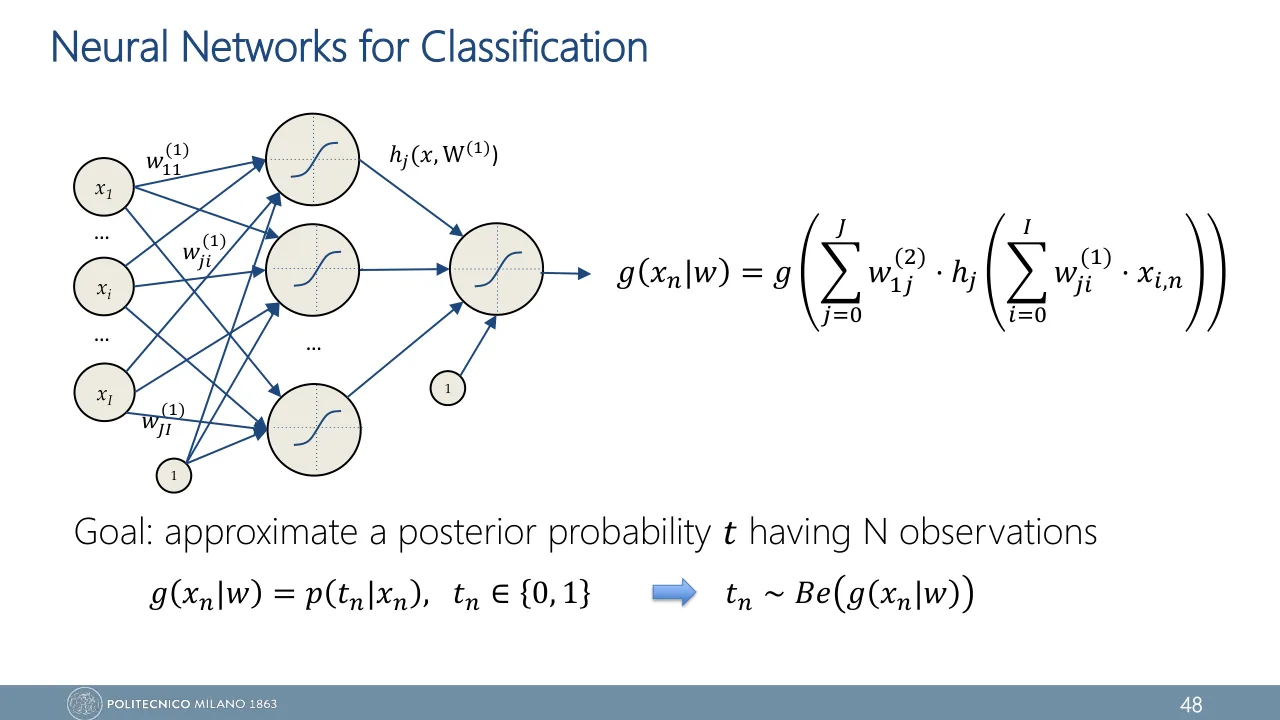
Чтобы \(g\) могла быть вероятностью, выход сети должен лежать между 0 и 1. Вот зачем в уроке 11 на выходе стояла sigmoid.
-
Одна формула на два исхода. Для краткости обозначим \(g_n = g(x_n|w)\). Вероятность единицы равна \(g_n\), вероятность нуля — \(1 - g_n\). Обе строчки собираются в одну:
\[ p(t_n|x_n, w) = g_n^{\,t_n}\,(1-g_n)^{1-t_n} \]Проверь: при \(t_n = 1\) остаётся \(g_n\), при \(t_n = 0\) остаётся \(1 - g_n\). Степень работает как выключатель.
-
Likelihood. Примеры независимы — перемножаем:
\[ L(w) = \prod_{n=1}^{N} g_n^{\,t_n}\,(1-g_n)^{1-t_n} \] -
Логарифм. Произведение становится суммой, показатели степени спускаются вниз множителями:
\[ \begin{aligned} l(w) = {} & \sum_{n=1}^{N} \bigl[\, t_n \log g_n \\ & \quad + (1-t_n)\log(1-g_n) \,\bigr] \end{aligned} \] -
Меняем знак. Здесь нет ни констант, ни множителей, которые надо выбрасывать. Максимум \(l(w)\) — это минимум \(-l(w)\):
\[ \begin{aligned} E(w) = {} & -\sum_{n=1}^{N} \bigl[\, t_n \log g_n \\ & \quad + (1-t_n)\log(1-g_n) \,\bigr] \end{aligned} \]Это binary cross-entropy — обведённая формула слайда 51.
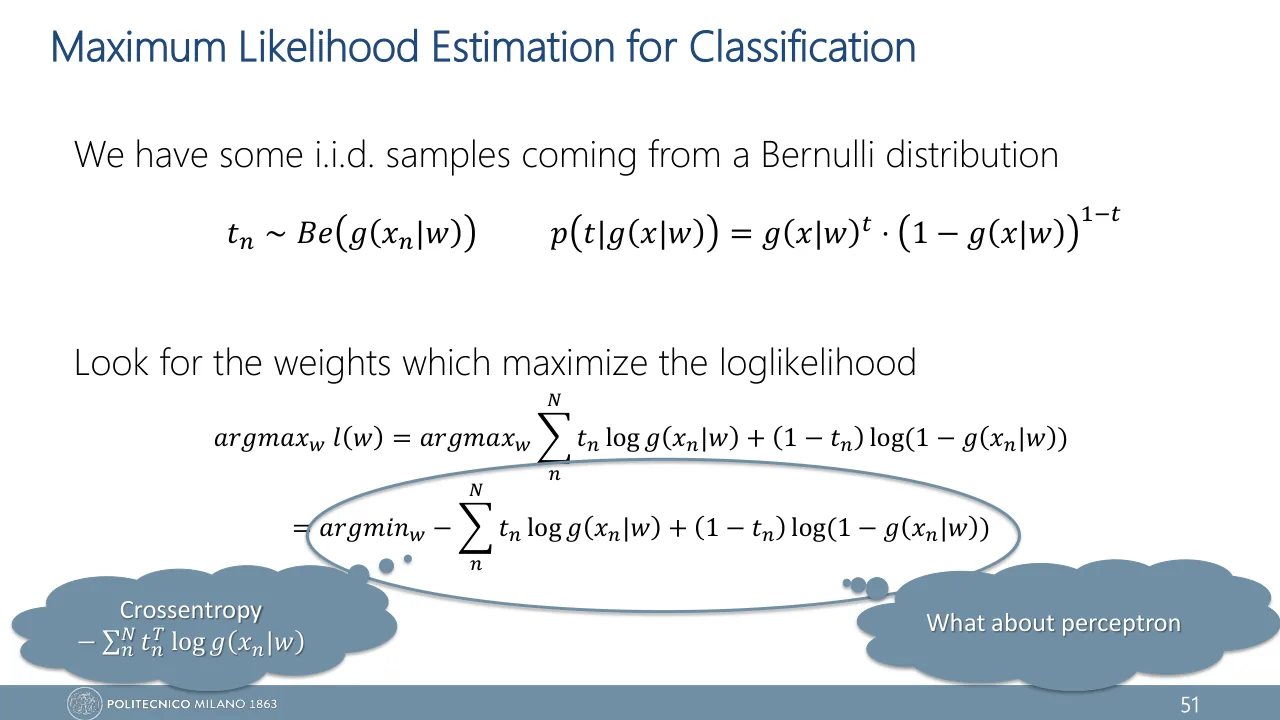
У каждого слагаемого есть простой смысл. Из двух логарифмов в скобках выживает один — тот, что относится к случившемуся исходу. Остаётся \(-\log\) вероятности, которую модель дала тому, что произошло на самом деле. Это мера удивления. Модель сказала \(g = 0.8\), и вышла единица — штраф \(-\ln 0.8 = 0.22\). Сказала \(0.8\), а вышел ноль — штраф \(-\ln 0.2 = 1.61\), в семь раз больше.
Основание логарифма на слайдах не указано. Оно меняет \(E(w)\) только на постоянный множитель, так что минимум от него не зависит. В расчётах принят натуральный логарифм — так делает и конспект (стр. 112). Там же перед суммой стоит ещё \(\frac{1}{N}\): как и в случае SSE и MSE, это положительный множитель, и минимум он не двигает. На слайде 51 его нет.
Теперь обе истории рядом. В виджете восемь точек, модель с двумя весами и выбор, как появились targets.
Больше двух классов
Для \(K\) классов монетку заменяет игральная кость с \(K\) гранями; в конспекте это распределение названо Categorical. Target записан как one-hot вектор \(\vb{t}_n\): единица на месте правильного класса, остальные нули. Сеть через softmax выдаёт \(K\) вероятностей \(g_k(x_n|w)\) с суммой 1. Вероятность наблюдённого ответа пишется тем же приёмом со степенями-выключателями: \(\prod_k g_k^{\,t_{nk}}\). Логарифм и минус дают
Вторая строка — та же сумма в векторной записи, так она стоит на слайде 51 с подписью "Crossentropy" (в конспекте — Categorical Cross-Entropy, CCE). Из внутренней суммы выживает одно слагаемое: при \(\vb{t}_n = (0, 0, 1)\) и выходах \((0.2, 0.3, 0.5)\) штраф равен \(-\ln 0.5 = 0.69\). При \(K = 2\) формула сворачивается в binary cross-entropy.
Как придумать функцию ошибки
Обе выкладки — одна и та же операция. Скажи, каким распределением описывается target при данном входе, запиши likelihood, возьми логарифм, поменяй знак:
Это negative log-likelihood. Сумма по примерам берётся из независимости и логарифма — вот почему и сумма квадратов, и cross-entropy устроены как «сумма по обучающей выборке». А вид слагаемого задаёт выбранное распределение.
| Предположение о \(t_n\) | Error function \(E(w)\) |
|---|---|
| Regression, выход linear \(t_n \sim N(g_n, \sigma^2)\) | \(\sum_n (t_n - g_n)^2\) Sum of Squared Errors |
| Два класса, выход sigmoid \(t_n \sim Be(g_n)\) | \(-\sum_n [\,t_n \log g_n\) \(\quad +\, (1 - t_n) \log(1 - g_n)\,]\) Binary Crossentropy |
| \(K\) классов, выход softmax \(\vb{t}_n\) — бросок кости с вероятностями \(g_{nk}\) (Categorical) | \(-\sum_n \sum_k t_{nk} \log g_{nk}\) Crossentropy |
В уроке 11 эта таблица была рецептом. Теперь у каждой строки есть вывод, и видно, почему выход и функция ошибки ходят парами. Выход сети должен быть законным параметром своего распределения: любое число годится в центры колокола, число от 0 до 1 — в вероятность монетки, набор чисел от 0 до 1 с суммой 1 — в вероятности граней.
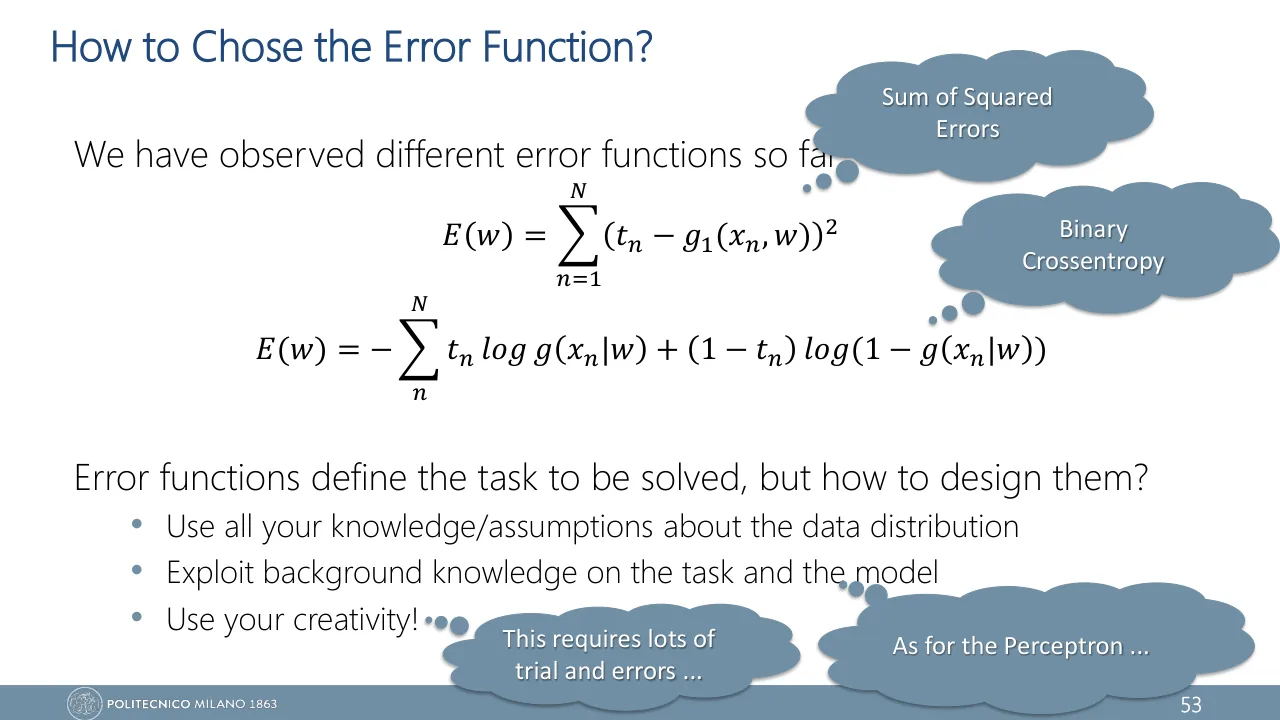
На слайде "How to Chose the Error Function?" лекции 2 (в PDF он 52-й, на самом слайде напечатан номер 53) профессор говорит то же самое шире: "Error functions define the task to be solved". И даёт три совета, как их конструировать: использовать всё, что известно или предполагается о распределении данных; использовать знания о задаче и о модели; проявлять изобретательность. Там же честная приписка: "This requires lots of trial and errors".
Вернёмся к 2, 4 и 9
Среднее 5 — это \(\mu^{MLE}\), если шум гауссов. Оно минимизирует сумму квадратов: 26 при \(\mu = 5\) против 29 при \(\mu = 4\) (выбери в первом виджете «три точки» и проверь).
Теперь другое предположение. Этого примера нет ни на слайдах, ни в конспекте: он показывает совет "use all your knowledge/assumptions about the data distribution" в действии. Пусть известно, что прибор изредка ошибается сильно, и 9 похоже как раз на такой промах. Колокол с его тонкими хвостами для этого не годится. Возьмём распределение с тяжёлыми хвостами — распределение Лапласа, \(p(x|\mu) = \frac{1}{2b}\, e^{-\abs{x-\mu}/b}\).
Рецепт тот же: произведение, логарифм, минус. В показателе теперь стоит модуль, а не квадрат, и минимизировать приходится \(\sum_n \abs{x_n - \mu}\). Минимум этой суммы — в медиане: при \(\mu = 4\) она равна \(2 + 0 + 5 = 7\), при \(\mu = 5\) — \(3 + 1 + 4 = 8\).
Так что и 5, и 4 — правильные ответы, каждый при своём предположении о шуме. Никакого «правильного самого по себе» числа нет. С сетью то же самое, и это ответ на вопрос из урока 11, почему на слайдах квадрат, а не модуль: сумма квадратов — это гауссов шум, записанный другими буквами. Веришь в него — используй её. Не веришь — рецепт у тебя в руках, выводи свою.
MLE отвечает на вопрос, что минимизировать; gradient descent и backpropagation — как.
В формате экзамена
You observe \(N\) i.i.d. samples \(x_1, \dots, x_N\) from a Gaussian distribution \(N(\mu, \sigma^2)\) with known \(\sigma^2\). Derive the maximum likelihood estimator of \(\mu\).
Show model answer
The samples are i.i.d., so the likelihood is the product of the densities:
\[ L(\mu) = \prod_{n=1}^{N} \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{\textstyle -\frac{(x_n-\mu)^2}{2\sigma^2}} \]Log-likelihood:
\[ \begin{aligned} l(\mu) = {} & N \log\frac{1}{\sqrt{2\pi}\,\sigma} \\ & - \frac{1}{2\sigma^2}\sum_{n=1}^{N}(x_n-\mu)^2 \end{aligned} \]Set the derivative to zero:
\[ \pd{l}{\mu} = \frac{1}{\sigma^2}\sum_{n=1}^{N}(x_n-\mu) = 0 \] \[ \mu^{MLE} = \frac{1}{N}\sum_{n=1}^{N} x_n \]It is a maximum because \(\partial^2 l / \partial \mu^2 = -N/\sigma^2 \lt 0\). The estimator is the sample mean.
В ответе должны быть четыре хода: произведение из i.i.d., логарифм, производная равна нулю, проверка максимума. Последний легко забыть — а он есть в рецепте на слайде 36 лекции 2.
A feed forward neural network \(g(x|w)\) is trained for regression on \(N\) observations \(\langle x_n, t_n \rangle\). Assume \(t_n = g(x_n|w) + \epsilon_n\) with \(\epsilon_n \sim N(0, \sigma^2)\). Show that the maximum likelihood estimate of \(w\) minimises the sum of squared errors, and state the assumptions you used.
Show model answer
The noise model implies \(t_n \sim N(g(x_n|w), \sigma^2)\). With independent samples the likelihood is
\[ L(w) = \prod_{n=1}^{N} \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{\textstyle -\frac{(t_n - g(x_n|w))^2}{2\sigma^2}} \]and the log-likelihood is
\[ \begin{aligned} l(w) = {} & N \log\frac{1}{\sqrt{2\pi}\,\sigma} \\ & - \frac{1}{2\sigma^2}\sum_{n=1}^{N}\bigl(t_n - g(x_n|w)\bigr)^2 \end{aligned} \]The first term does not depend on \(w\), and \(1/2\sigma^2\) is a positive constant, so
\[ \begin{aligned} & \argmax_w\, l(w) = \\ & \argmin_w \sum_{n=1}^{N}\bigl(t_n - g(x_n|w)\bigr)^2 \end{aligned} \]Assumptions: independent samples; additive Gaussian noise with zero mean; noise variance known and equal for all samples.
Два места, где ответ легко оставить неполным: объясни, почему пропали константа и \(1/2\sigma^2\) (одна не зависит от \(w\), вторая положительна), и перечисли предположения — вопрос просит об этом прямо. Результат пиши как сумму, без \(\frac{1}{N}\) и \(\frac{1}{2}\) — так на слайде 47 лекции 2.
A network with output \(g(x_n|w)\) approximating \(p(t_n = 1\,|\,x_n)\) is trained for binary classification with targets \(t_n \in \{0, 1\}\). Derive the error function by maximum likelihood. How does it generalise to \(K\) classes with one-hot targets?
Show model answer
Each target is a Bernoulli variable, \(t_n \sim Be(g(x_n|w))\). Writing \(g_n = g(x_n|w)\):
\[ p(t_n|x_n, w) = g_n^{\,t_n}\,(1-g_n)^{1-t_n} \]For independent samples
\[ L(w) = \prod_{n=1}^{N} g_n^{\,t_n}\,(1-g_n)^{1-t_n} \] \[ \begin{aligned} l(w) = {} & \sum_{n=1}^{N} \bigl[\, t_n \log g_n \\ & \quad + (1-t_n)\log(1-g_n) \,\bigr] \end{aligned} \]There is no constant to drop here: maximising \(l(w)\) is equivalent to minimising its negative, the binary cross-entropy
\[ \begin{aligned} E(w) = {} & -\sum_{n=1}^{N} \bigl[\, t_n \log g_n \\ & \quad + (1-t_n)\log(1-g_n) \,\bigr] \end{aligned} \]For \(K\) classes with one-hot targets \(\vb{t}_n\) and softmax outputs \(g_k(x_n|w)\), the probability of one observed target is \(\prod_k g_k(x_n|w)^{t_{nk}}\), and the same steps give the cross-entropy
\[ E(w) = -\sum_{n=1}^{N} \sum_{k=1}^{K} t_{nk} \log g_k(x_n|w) \]Ключевой ход — компактная запись \(g^{t}(1-g)^{1-t}\). Без неё логарифм не разложится в две аккуратные части. Назови распределение словом (Bernoulli) и результат словом (binary cross-entropy): так сразу видно, что и откуда выведено.
A binary classifier outputs \(g(x_n|w) = 0.9,\ 0.6,\ 0.2\) for three samples whose targets are \(t_n = 1,\ 1,\ 0\). Compute the binary cross-entropy \(E(w)\) summed over the three samples (natural logarithm, three decimals).
Show model answer
Each sample contributes minus the log of the probability assigned to its true label: \(0.9\), \(0.6\) and \(1 - 0.2 = 0.8\).
\[ E = -\ln 0.9 - \ln 0.6 - \ln 0.8 \] \[ E = 0.105 + 0.511 + 0.223 = 0.839 \]Ловушка — третий пример: там \(t = 0\), значит под логарифмом \(1 - g = 0.8\), а не \(0.2\). Если взять \(-\ln 0.2\), получится 2.226 — и это типичный неверный ответ.
Three i.i.d. samples \(2,\ 4,\ 9\) are drawn from a Gaussian with unknown mean \(\mu\) and known variance \(\sigma^2 = 4\). Find \(\mu^{MLE}\) and compute how much higher the log-likelihood is at \(\mu^{MLE}\) than at \(\mu = 4\), i.e. \(l(\mu^{MLE}) - l(4)\).
Show model answer
\(\mu^{MLE}\) is the sample mean: \((2 + 4 + 9)/3 = 5\). The constant term of the log-likelihood cancels in the difference, so only the sums of squares matter:
\[ \sum_n (x_n - 5)^2 = 26, \qquad \sum_n (x_n - 4)^2 = 29 \] \[ l(5) - l(4) = \frac{29 - 26}{2\sigma^2} = \frac{3}{8} = 0.375 \]Вся задача в том, чтобы заметить: слагаемое \(N \log \frac{1}{\sqrt{2\pi}\sigma}\) в разности сокращается. Считать его на калькуляторе — потеря времени.
Which of the following statements about maximum likelihood estimation are correct? Select all that apply.
Show model answer
Correct: the first, third and fifth statements. The log is monotonic; Gaussian noise gives the sum of squared errors; Bernoulli targets give the binary cross-entropy. The likelihood is not a distribution over the parameters, \(\sigma^2\) does not move the optimum, and the principle works for any assumed distribution.
Самое коварное утверждение здесь — про \(\sigma^2\): она меняет значение функции, но не место минимума. Второе по коварству — про «распределение по \(\theta\)»: likelihood — функция параметров, а не их распределение.
Проверь себя
Для 15 точек посчитали \(L(\mu)\) при трёх значениях \(\mu\). Что означает число \(L(5.82) \approx 2.8 \cdot 10^{-10}\)?
Зачем в рецепте MLE берут логарифм? Отметь все верные причины.
Первая причина разрешает замену, вторая и третья объясняют, зачем она нужна.
В выводе SSE дисперсию шума считали известной: \(\sigma = 1\). Потом выяснилось, что на самом деле \(\sigma = 2\). Что произойдёт с весами \(w^{MLE}\)?
Targets равны 0 или 1, на выходе сети sigmoid, а обучают её на сумме квадратов. Какое предположение о данных при этом молча сделано?
Два примера с \(t = 1\). Первому модель дала \(g = 0.5\), второму \(g = 0.01\). Во сколько раз слагаемое cross-entropy у второго больше?
Три класса, one-hot target \(\vb{t} = (0, 1, 0)\), выходы softmax \((0.7, 0.2, 0.1)\). Чему равно слагаемое cross-entropy для этого примера?
Какие предположения использованы в выводе «maximum likelihood ⇒ SSE»? Отметь все.
Унести с собой
- Likelihood \(L(\theta)\) — вероятность (плотность) наблюдённых данных как функция параметров. MLE выбирает параметры, при которых данные наиболее вероятны.
- Предположение i.i.d. делает likelihood произведением, логарифм превращает его в сумму, и место максимума при этом не меняется.
- Рецепт: записать \(L\), взять \(\log\), продифференцировать, приравнять к нулю, проверить максимум. Для среднего Gaussian он даёт среднее выборки.
- \(t_n = g(x_n|w) + \epsilon_n\) с гауссовым шумом известной дисперсии приводит к Sum of Squared Errors.
- \(t_n \sim Be(g(x_n|w))\) приводит к binary cross-entropy; one-hot target и softmax — к cross-entropy для \(K\) классов.
- Любая из этих функций ошибки — negative log-likelihood. Выбрать функцию ошибки значит высказать предположение о данных.
- MLE говорит, что минимизировать; gradient descent и backpropagation — как.
Что посмотреть и почитать
-
Maximum Likelihood, clearly explained!!!
StatQuest with Josh Starmer
Тот же разминочный пример, что на слайдах 34–41 лекции 2: колокол двигают над точками и выбирают среднее, при котором данные наиболее вероятны. Картинка до всякой алгебры.
-
Neural Networks Part 6: Cross Entropy
StatQuest with Josh Starmer
Смотри после вывода binary cross-entropy: cross-entropy для выхода softmax на числах и объяснение, почему для classification её предпочитают квадратам остатков.
-
Dive into Deep Learning, 3.1 Linear Regression
Zhang, Lipton, Li, Smola
Раздел 3.1.3 «The Normal Distribution and Squared Loss»: тот же вывод суммы квадратов из гауссова шума другими словами. Полезно прочитать, чтобы убедиться, что на экзамене сможешь воспроизвести его без слайдов.
-
Dive into Deep Learning, 4.1 Softmax Regression
Zhang, Lipton, Li, Smola
Cross-entropy для многих классов, выведенная из log-likelihood, и три абзаца о том, почему \(-\log p\) называют удивлением.
-
Visual Information Theory
Christopher Olah
Если захочется понять, что именно измеряет cross-entropy: энтропия и cross-entropy нарисованы как площади прямоугольников. Для тех, кто думает картинками.