Один двигатель, разные приборные панели
После этого урока ты по описанию задачи назовёшь, сколько нейронов поставить на выход, какую им дать функцию активации, как закодировать правильные ответы и чем мерить ошибку, — и посчитаешь эту ошибку на калькуляторе.
Одну и ту же сеть зовут три заказчика. Агентству недвижимости нужна цена квартиры в евро. Почтовому сервису — ответ «спам или нет». Банку — цифра от 0 до 9, написанная на чеке от руки. Что придётся переделать в сети, переходя от одного заказчика к другому?
Почти ничего: последний слой и формулу, по которой считается ошибка. Но выбрать эту пару наугад нельзя. Вот почтовая сеть смотрит на письмо и говорит: «спам с вероятностью 0.0003». Письмо — спам. Ошибиться увереннее почти невозможно.
Кажется очевидным: чем грубее промах, тем сильнее сеть надо поправить. Если мерить промах привычным квадратом разности, выйдет наоборот: сигнал к исправлению окажется примерно в 1500 раз слабее, чем мог бы быть. Чем увереннее сеть ошибается, тем хуже она учится. Откуда берётся этот множитель и как от него избавиться одной строкой алгебры — в конце урока.
Двигатель общий, панель под задачу
В уроках 9 и 10 сеть собиралась из скрытых слоёв: каждый нейрон считает взвешенную сумму и пропускает её через sigmoid или tanh. Эти слои — двигатель. Они перемалывают вход \(\vb{x}\) в набор чисел \(h_j\): признаки, по которым уже можно отвечать заказчику.
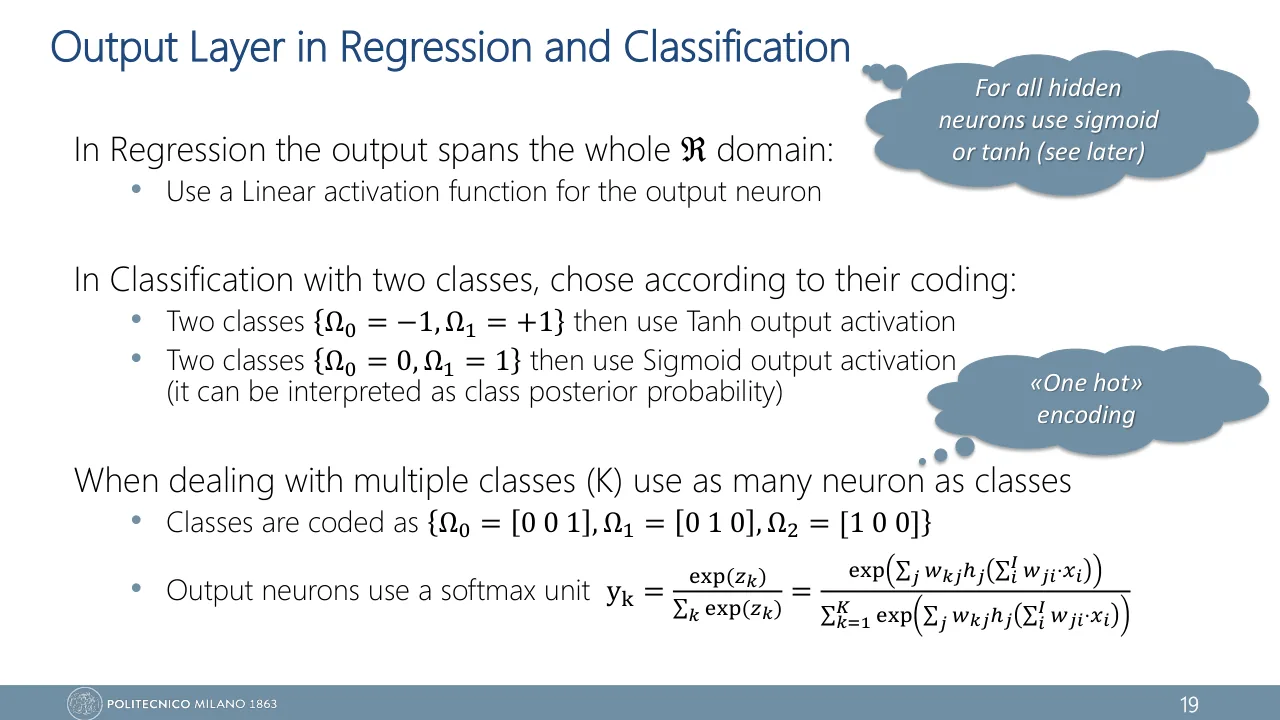
Но двигатель ничего не показывает водителю. Для этого нужна приборная панель — выходной слой (output layer). Он берёт признаки \(h_j\) и переводит их в ответ того вида, который нужен задаче. Видов три, и у каждого свой прибор.
- Regression: ответ — число без границ. Прибор — стрелка на бесконечной шкале, выход linear.
- Classification на два класса: ответ — насколько пример похож на класс 1. Прибор — одна лампа с яркостью от 0 до 1, выход sigmoid.
- Classification на \(K\) классов: ответ — как уверенность делится между классами. Прибор — полоса из \(K\) долей с суммой 1, выход softmax.
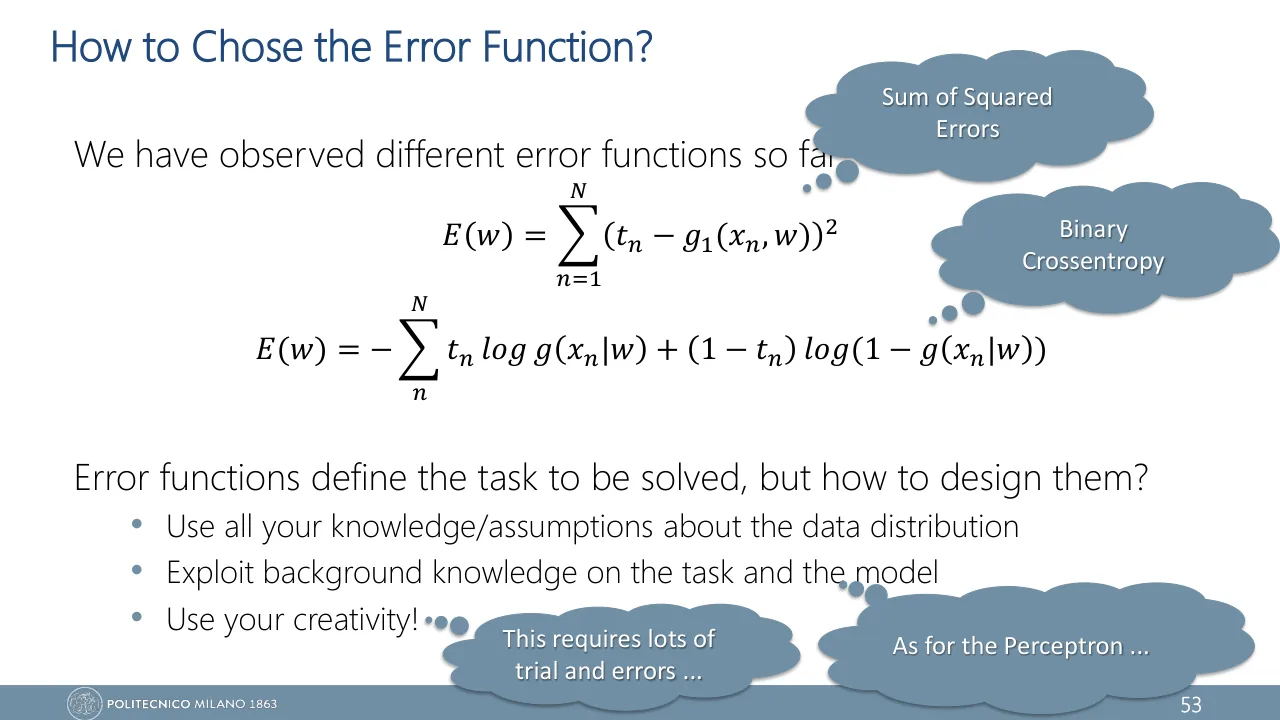
К прибору всегда прилагается второе решение: чем штрафовать за промах. Это функция ошибки — error function \(E(\vb{w})\); в конспекте она же loss function. На слайде 52 лекции 2 (в его углу напечатано 53) профессор говорит это прямо: "Error functions define the task to be solved". А скрытым нейронам слайд 19 оставляет sigmoid или tanh, какой бы ни была задача. Весь урок — про три пары «прибор + штраф» и про то, почему пары нельзя перемешивать.
Как читать слайды и конспект одновременно
Слайды и конспект пишут одно и то же разными буквами. Договоримся один раз.
| Что | Слайды | Конспект |
|---|---|---|
| ответ сети на пример \(n\) | \(g(x_n|\vb{w})\), у softmax \(y_k\) | \(\hat y_i\) или \(y_i\) |
| правильный ответ, target | \(t_n\) | \(t_i\) |
| сумма на входе выходного нейрона | \(a\), у softmax \(z_k\) | \(a\) или \(z\); у softmax logit \(a_i\) |
| ошибка | error function \(E(\vb{w})\), сумма по примерам | loss \(L\), среднее по примерам |
| логарифм | \(\log\) | \(\ln\) и \(\log\) вперемешку |
Дальше \(y\) — короткая запись для \(g(x_n|\vb{w})\), ответа сети на один пример; \(a\) — сумма на входе выходного нейрона; все логарифмы натуральные.
Regression: стрелка без ограничителей
Агентству нужна цена. Цена — число, которое может оказаться любым: 250 000 евро за квартиру, а в соседней задаче −10 °C за окном. В уроке 10 было видно, что sigmoid сжимает любой вход в интервал \((0, 1)\), а tanh — в \((-1, 1)\). Поставь такую функцию на выход, и сеть не сможет произнести «250 000», какими бы ни были веса.
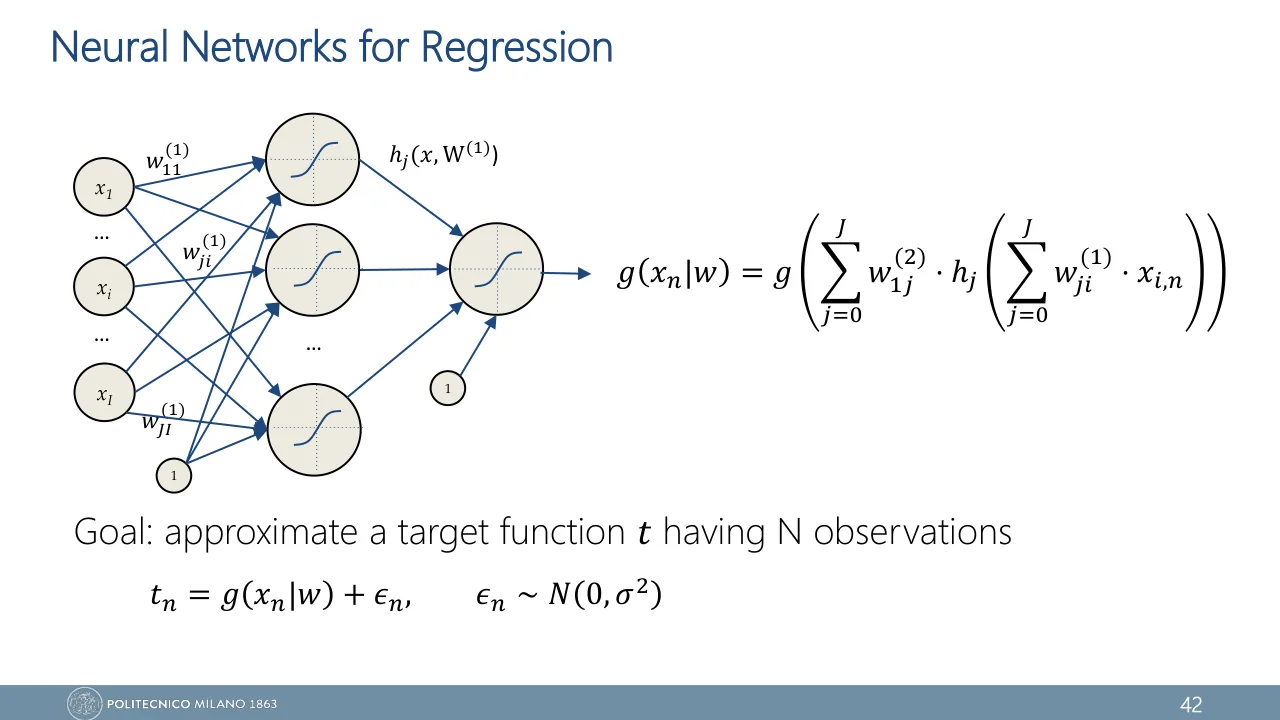
Поэтому в regression на выходе стоит один нейрон с линейной активацией (linear activation): он отдаёт взвешенную сумму как есть. Один — потому что число нужно одно; если сеть должна предсказать несколько чисел сразу, линейных нейронов ставят по одному на каждое.
- \(h_j\)
- выходы последнего скрытого слоя; \(h_0 = 1\) несёт смещение \(w_{10}^{(2)}\)
- \(w_{1j}^{(2)}\)
- вес от скрытого нейрона \(j\) к выходному нейрону 1
- \(a\)
- сумма на входе выходного нейрона; при linear activation она же и ответ
«Линейный выход делает всю сеть линейной». Нет. Скрытые слои остаются нелинейными, и ответ по-прежнему нелинейно зависит от входа \(\vb{x}\). Линейно только последнее действие: сложить готовые признаки с весами.
Чем штрафовать: квадрат промаха
На слайдах ошибка для regression — Sum of Squared Errors: промах на каждом примере возводится в квадрат, квадраты складываются.
- \(t_n\)
- target: правильный ответ для примера \(n\)
- \(g(x_n|\vb{w})\)
- ответ сети на этот пример
- \(N\)
- число примеров
Квадрат делает две вещи. Убирает знак: промахи \(+1\) и \(-1\) не гасят друг друга. И наказывает большие промахи сильнее маленьких: промах 10 стоит в сто раз дороже промаха 1.
Конспект делит ту же сумму на \(N\) и называет результат MSE, а рядом вводит MAE — среднее модулей промахов, которого на слайдах нет.
\[ \text{MSE} = \frac{1}{N} \sum_{n=1}^{N} (y_n - t_n)^2 \] \[ \text{MAE} = \frac{1}{N} \sum_{n=1}^{N} \abs{y_n - t_n} \]Деление на \(N\) не меняет, при каких весах ошибка минимальна. Оно только уменьшает градиент в \(N\) раз, а это то же самое, что взять другой learning rate \(\eta\).
| \(n\) | \(t_n\) | \(y_n\) | \(y_n - t_n\) | квадрат | модуль |
|---|---|---|---|---|---|
| 1 | 2 | 3 | +1 | 1 | 1 |
| 2 | 5 | 4 | −1 | 1 | 1 |
| 3 | 6 | 8 | +2 | 4 | 2 |
| 4 | 3 | 2 | −1 | 1 | 1 |
| сумма | 7 | 5 | |||
Отсюда Sum of Squared Errors равна 7, MSE = 7 / 4 = 1.75, MAE = 5 / 4 = 1.25. Обрати внимание на единицы: если цены в евро, то MAE тоже в евро, а MSE — в евро в квадрате. Чтобы вернуться к евро, из MSE берут корень: \(\sqrt{1.75} \approx 1.32\).
Для обучения важнее другое: с какой силой каждый пример тянет ответ к своей цели. Силу задаёт производная ошибки по ответу \(y_n\).
\[ \pd{\,\text{MSE}}{y_n} = \frac{2}{N}\,(y_n - t_n) \] \[ \pd{\,\text{MAE}}{y_n} = \frac{1}{N}\,\sign(y_n - t_n) \]Знак плюс значит «ответ завышен»: обучение идёт против производной и тянет такой ответ вниз, к цели. В примере у MSE производные равны \((0.5,\ {-}0.5,\ 1.0,\ {-}0.5)\): третий пример ошибся вдвое сильнее и тянет вдвое сильнее. У MAE они равны \((0.25,\ {-}0.25,\ 0.25,\ {-}0.25)\): все тянут одинаково, размер промаха не важен.
У модуля есть две неприятности, и обе названы в конспекте. В точке \(y_n = t_n\) у него нет производной; на практике берут subgradient — любое число от −1 до 1, обычно 0. И его тяга не слабеет рядом с целью: шаги остаются одного размера, поэтому с MAE обучение сходится медленнее. Зато оно устойчивее к выбросам (outliers).
Что это значит, лучше увидеть на данных, в которые закралась ошибка.
Модель в виджете отвечает одним числом, и для неё всё видно сразу: минимум MSE — это среднее цен, минимум MAE — их медиана. Из Applied Statistics ты знаешь, что среднее чувствительно к выбросам, а медиана нет. Здесь то же свойство, только под другим именем. У настоящей сети ответ зависит от входа, и «среднее» с «медианой» становятся условными: при данном \(\vb{x}\).
«MSE минимизирует дисперсию, MAE — среднюю ошибку». Так подытожено в конспекте на стр. 75, и на экзамене такая фраза ничего не объясняет. Точная формулировка: лучший ответ по squared error — среднее значение target при данном входе, лучший по absolute error — медиана. Отсюда и устойчивость MAE к выбросам.
Почему на слайдах всё-таки квадрат, а не модуль? Потому что Sum of Squared Errors получается сама, если считать target ответом сети плюс гауссов шум и искать веса, при которых наблюдённые данные самые вероятные. Вывод — в уроке 15. Здесь достаточно запомнить связку «гауссов шум — квадрат промаха».
Два класса: одна лампа с яркостью
Почтовому сервису нужен ответ «спам или нет». Классов два, но нейрон на выходе нужен один: он показывает, насколько сеть уверена в классе 1, а классу 0 достаётся остаток.
Какую активацию ему дать, на слайде 19 лекции 2 решает кодировка ответов — то, какими числами классы записаны в данных.
На выходе sigmoid: ответ лежит в \((0, 1)\). Его читают как вероятность класса 1.
На выходе tanh: ответ лежит в \((-1, 1)\). Знак показывает класс, модуль — уверенность.
Апостериорная вероятность класса (class posterior probability) — вероятность того, что пример принадлежит классу 1, после того как сеть увидела его вход: \(g(x_n|\vb{w}) = p(t_n = 1 \mid x_n)\). Классу 0 остаётся \(1 - g(x_n|\vb{w})\).
Оговорка: число из \((0, 1)\) само по себе ещё не вероятность. Оценкой вероятности оно становится, когда сеть обучена на ответах 0 и 1 с подходящей функцией ошибки. К ней и переходим, но сначала — место в конспекте, где кодировки перепутаны.
Штраф синоптика
Как штрафовать сеть, которая выдаёт вероятность? Представь синоптика. Вечером он объявляет вероятность дождя, утром идёт дождь. Насколько он неправ? Удобная мера — «удивление»: минус логарифм вероятности, которую он дал тому, что случилось на самом деле.
| Прогноз: дождь | \(p\) | Штраф \(-\ln p\) |
|---|---|---|
| 90 % | 0.9 | 0.105 |
| 40 % | 0.4 | 0.916 |
| 10 % | 0.1 | 2.303 |
| 0.1 % | 0.001 | 6.908 |
Уверенный и правый почти ничего не платит. Уверенный и неправый платит много, и чем увереннее, тем больше: потолка у штрафа нет. Сумма таких штрафов по всем примерам — binary cross-entropy.
- \(y_n\)
- ответ сети \(g(x_n|\vb{w})\): вероятность класса 1
- \(t_n = 1\)
- от скобки остаётся первое слагаемое, штраф \(-\ln y_n\)
- \(t_n = 0\)
- остаётся второе, штраф \(-\ln(1 - y_n)\)
В обоих случаях под логарифмом стоит вероятность, которую сеть дала правильному классу. Посчитаем на примере из конспекта.
| \(n\) | \(t_n\) | \(y_n\) | дано верному классу | штраф |
|---|---|---|---|---|
| 1 | 1 | 0.9 | 0.9 | 0.105 |
| 2 | 0 | 0.2 | 0.8 | 0.223 |
| 3 | 1 | 0.4 | 0.4 | 0.916 |
| 4 | 0 | 0.6 | 0.4 | 0.916 |
| сумма (как на слайдах) | 2.161 | |||
| среднее (как в конспекте) | 0.540 | |||
Много это или мало? Сравни с моделью, которая ничего не знает и на всё отвечает 0.5: её штраф на каждом письме равен \(\ln 2 = 0.693\). Наши 0.540 лишь немного лучше. Простой подсчёт говорит то же: по порогу 0.5 сеть угадала два письма из четырёх.
«Cross-entropy 0.54 — значит, 54 % ошибок». Нет: это средний штраф, а не доля ошибок. Верхней границы у него нет. Осмысленная точка отсчёта — \(\ln 2 \approx 0.693\), штраф модели «всегда 0.5».
Почему этот штраф называется cross-entropy?
Название пришло из теории информации. Там «удивление» от события с вероятностью \(q\) равно \(-\ln q\), а cross-entropy двух распределений — среднее удивление наблюдателя, который верит в распределение \(q\), когда на самом деле события идут по распределению \(p\):
\[ H(p, q) = -\sum_{k} p_k \ln q_k \]У нас \(p\) — правильный ответ: вся вероятность на одном классе. \(q\) — ответ сети. В сумме выживает одно слагаемое: минус логарифм вероятности, которую сеть дала правильному классу. Чем лучше \(q\) совпадает с \(p\), тем меньше \(H\); для ответов 0 и 1 минимум равен нулю.
А что будет, если штрафовать лампу по-старому, квадратом промаха \((t - y)^2\)? Сравним два штрафа на одном примере.
В координатах \(y\) кривая cross-entropy — та самая, что нарисована в конспекте на стр. 79. Подпись под тем рисунком стоит поправить.
Откуда в штрафе именно логарифм, покажет урок 15: binary cross-entropy получается из того же принципа «самые вероятные данные», если считать каждый ответ \(t_n\) броском монеты, у которой орёл выпадает с вероятностью \(g(x_n|\vb{w})\).
Много классов: полоса, разрезанная на доли
Банку нужна цифра на чеке: десять классов. Правило слайда 19 лекции 2 короткое: нейронов на выходе столько же, сколько классов, то есть \(K\). Остаётся решить две вещи: как записать правильный ответ и как превратить \(K\) сумм в \(K\) вероятностей.
One-hot: как записать ответ
Первое, что приходит в голову, — пронумеровать классы: кот — 0, пёс — 1, птица — 2, и учить один нейрон выдавать номер. Но числа приносят с собой порядок и расстояния, которых у классов нет. Выходит, что птица вдвое дальше от кота, чем пёс, а пёс — нечто среднее между котом и птицей.
До: классы как числа 0, 1, 2
После: one-hot encoding
One-hot encoding убирает лишнее: ответ — вектор из \(K\) чисел, единица на месте своего класса, нули на остальных. Какое место «горячее» у какого класса — вопрос договорённости: в конспекте кот получает \([1, 0, 0]\), а на слайде 19 первый класс \(\Omega_0\) записан как \([0\ 0\ 1]\).
Softmax: как получить доли
Каждый из \(K\) выходных нейронов считает свою сумму \(a_k\). Конспект называет эти суммы logits, на слайде 19 они обозначены \(z_k\). Logit может быть любым числом, в том числе отрицательным. Softmax делает из них доли в два шага: экспонента превращает любое число в положительное, деление на общую сумму заставляет доли складываться в 1. Заодно экспонента растягивает различия: отрыв на 1 по logit — это доля в \(e \approx 2.72\) раза больше, отрыв на 3 — уже в 20 раз. Но ни одна доля не становится нулём.
- \(a_k\)
- logit класса \(k\): сумма \(\sum_j w_{kj} h_j\) на входе выходного нейрона \(k\) (на слайде \(z_k\))
- \(y_k\)
- ответ выходного нейрона \(k\): вероятность класса \(k\)
- \(K\)
- число классов и число выходных нейронов
Из формулы сразу следуют два свойства, каждое доказывается в одну строку.
Важны только разности. Прибавь ко всем \(a_k\) одно и то же число \(c\): числитель и знаменатель умножатся на \(e^{c}\), и оно сократится.
\[ \frac{e^{a_k + c}}{\sum_j e^{a_j + c}} = \frac{e^{c}\, e^{a_k}}{e^{c} \sum_j e^{a_j}} = y_k \]Поэтому отношение долей двух классов зависит только от разности их logits: \(y_1 / y_2 = e^{a_1 - a_2}\).
При \(K = 2\) это sigmoid. Раздели числитель и знаменатель на \(e^{a_1}\):
\[ y_1 = \frac{e^{a_1}}{e^{a_1} + e^{a_2}} = \frac{1}{1 + e^{-(a_1 - a_2)}} \]Справа стоит \(\sigma(a_1 - a_2)\). Вот почему для двух классов хватает одного нейрона с sigmoid: второй logit можно считать нулём.
Первое свойство экономит время на калькуляторе: вычти из всех logits наибольший. Вместо \((2.0,\ 1.0,\ 0.1)\) получится \((0,\ {-}1,\ {-}1.9)\), экспоненты \((1,\ 0.368,\ 0.150)\), сумма 1.518 — и первая доля сразу \(1 / 1.518 = 0.659\). Числа меньше, ответ тот же.
Cross-entropy для \(K\) классов
Штраф тот же, что у синоптика: минус логарифм вероятности, данной правильному классу. С ответом one-hot это записывается суммой, в которой выживает одно слагаемое.
- \(t_k\)
- компоненты вектора one-hot: единица у правильного класса, остальные нули
- \(c\)
- номер правильного класса
На слайде 51 та же ошибка для всех примеров сразу названа Crossentropy и записана через скалярное произведение векторов длины \(K\); конспект называет её CCE.
\[ E(\vb{w}) = -\sum_{n=1}^{N} \vb{t}_n\T \ln g(x_n|\vb{w}) \]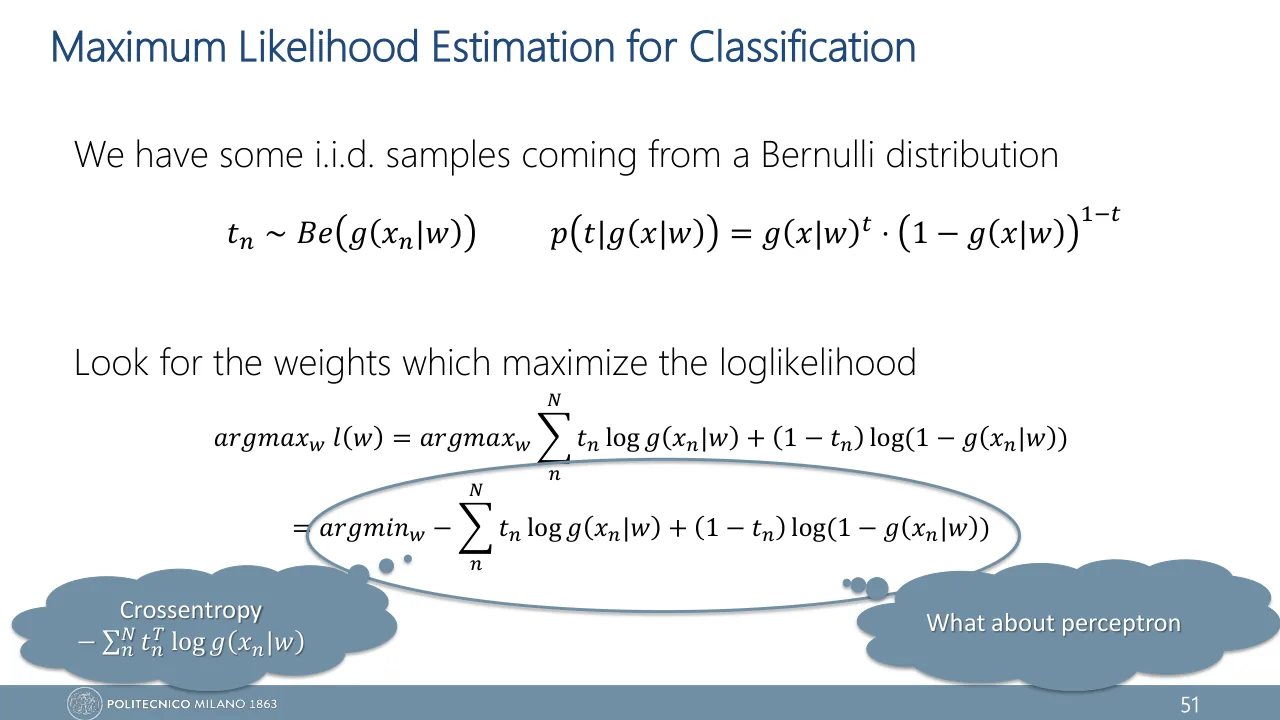
В Example 7: если правильный класс первый, штраф равен \(-\ln 0.659 = 0.417\); если второй — \(-\ln 0.2424 = 1.417\). Во втором случае доля взята с четырьмя знаками: с округлённой 0.242 вышло бы 1.419. Точка отсчёта — модель, которая делит поровну: её штраф \(\ln K\), для трёх классов \(\ln 3 = 1.099\).
«Выходы softmax — это \(K\) независимых вероятностей». Нет: они связаны общей суммой. Подними один logit, и все остальные доли уменьшатся, хотя их logits никто не трогал. Поэтому ошибка, в которую входит только \(y_c\), всё равно зависит от всех \(K\) сумм. Независимые вероятности дали бы \(K\) отдельных sigmoid, но это уже другая задача: в ней у примера может быть несколько классов сразу.
Одна строка на все три панели
Вернёмся к письму из начала урока. Сеть сказала «спам с вероятностью 0.0003», письмо — спам. Чтобы исправиться, сети нужен сигнал: в какую сторону и насколько сильно менять сумму \(a\) на входе выходного нейрона. Этот сигнал — производная \(\partial E / \partial a\); в уроке 14 именно она отправится назад по сети. Посчитаем её для пары «sigmoid + cross-entropy».
-
Один пример. Ошибка и выход нейрона:
\[ E = -\bigl[\, t \ln y + (1 - t) \ln (1 - y) \,\bigr] \] \[ y = \sigma(a) \] -
\(E\) зависит от \(a\) только через \(y\). По правилу цепочки (chain rule) производная распадается на два множителя:
\[ \pd{E}{a} = \pd{E}{y} \cdot \pd{y}{a} \] -
Первый множитель — производные двух логарифмов, приведённые к общему знаменателю:
\[ \pd{E}{y} = -\frac{t}{y} + \frac{1 - t}{1 - y} = \frac{y - t}{y\,(1 - y)} \]В числителе \(-t(1 - y) + (1 - t)\,y = y - t\).
-
Второй множитель — производная sigmoid из урока 10, выраженная через её собственный выход:
\[ \pd{y}{a} = y\,(1 - y) \] -
Перемножим. Выражение \(y(1 - y)\) стоит в знаменателе первого множителя и в числителе второго — оно сокращается целиком:
\[ \pd{E}{a} = y - t \]Это формула (22) конспекта: ответ минус цель.
На четырёх письмах Example 6 это даёт сигналы \(({-}0.1,\ {+}0.2,\ {-}0.6,\ {+}0.6)\). Знак говорит, куда двигать \(a\): минус — увеличивать, плюс — уменьшать. Два письма, на которых сеть ошиблась, тянут в 3–6 раз сильнее двух остальных.
В уроке 10 множитель \(y(1 - y)\) был причиной насыщения: у уверенного нейрона он почти ноль. Здесь он исчез. Теперь тот же расчёт для квадрата промаха \(E = (t - y)^2\). Первый множитель другой, \(2(y - t)\), второй тот же, и сократить его нечем:
\[ \pd{E}{a} = 2\,(y - t)\; y\,(1 - y) \]Подставим письмо: \(a = -8\), значит \(y = \sigma(-8) \approx 0.0003\), а \(t = 1\).
| Пара | \(\partial E / \partial a\) | Значение |
|---|---|---|
| sigmoid + cross-entropy | \(y - t\) | −0.9997 |
| sigmoid + squared error | \(2(y - t)\,y(1 - y)\) | −0.0007 |
Отношение — около 1500: вот откуда число в начале урока. Множитель \(y(1 - y)\) почти равен нулю ровно там, где сеть уверена, и ему всё равно, права она или нет. С cross-entropy его нет: чем грубее промах, тем сильнее сигнал.
До: sigmoid + squared error
После: sigmoid + cross-entropy
Правильно подобранная пара «выход + функция ошибки» даёт на выходном нейроне сигнал \(y - t\): ответ минус цель.
Это верно для всех трёх панелей. У linear-выхода с квадратом промаха \(y = a\), поэтому \(\partial E / \partial a = 2(y - t)\) — тот же промах с постоянным множителем. У softmax с cross-entropy то же получается для каждого выходного нейрона.
-
Один пример, \(K\) выходов. Ошибка и softmax, где \(S\) — сумма всех экспонент:
\[ E = -\sum_{k} t_k \ln y_k, \qquad y_k = \frac{e^{a_k}}{S} \] -
Логарифм доли раскладывается: \(\ln y_k = a_k - \ln S\). Подставим и вспомним, что у вектора one-hot сумма \(t_k\) равна 1:
\[ E = -\sum_{k} t_k\, a_k + \ln S \] -
Берём производную по одному logit \(a_i\). От первой суммы остаётся \(-t_i\). В \(S\) от \(a_i\) зависит одно слагаемое:
\[ \pd{\ln S}{a_i} = \frac{e^{a_i}}{S} = y_i \] -
Складываем обе части — формула (26) конспекта:
\[ \pd{E}{a_i} = y_i - t_i \]
В Example 7 с правильным вторым классом сигнал равен \((0.659,\ {-}0.758,\ 0.099)\). Сумма компонент — ноль: вероятность не создаётся и не исчезает, она перетекает к правильному классу. Те же три числа в виджете выше — длины стрелок под столбиками.
| Задача | Выходов | Активация | Target | Error function | \(\partial E / \partial a\) |
|---|---|---|---|---|---|
| regression | 1 | linear | \(t \in \R\) | Sum of Squared Errors | \(2(y - t)\) |
| 2 класса, 0 / 1 | 1 | sigmoid | \(t \in \{0, 1\}\) | binary cross-entropy | \(y - t\) |
| 2 класса, −1 / +1 | 1 | tanh | \(t \in \{-1, +1\}\) | на слайдах не названа | — |
| \(K\) классов | \(K\) | softmax | one-hot | cross-entropy | \(y_k - t_k\) |
Вопрос «какой выход и какая ошибка для этой задачи» на экзамене закрывается этой таблицей. Легче всего забыть третью строку: при кодировке −1 / +1 слайд 19 лекции 2 ставит на выход tanh, а не sigmoid. Какую error function к нему брать, слайды не говорят. Годится Sum of Squared Errors, но пара выйдет несогласованной: в сигнале \(2(y - t)(1 - y^2)\) останется производная tanh.
Откуда берутся сами пары? Не подбором. Каждая — ответ на один вопрос: какой случайной величиной мы считаем правильные ответы \(t_n\). Дальше работает один и тот же рецепт, maximum likelihood: выбрать веса, при которых наблюдённые ответы самые вероятные. Минус логарифм этой вероятности, из которого выброшено всё, что не зависит от весов, и есть error function.
| Чем считаем ответ \(t_n\) | Получается |
|---|---|
| ответ сети плюс гауссов шум: \(t_n = g(x_n|\vb{w}) + \epsilon_n\), \(\epsilon_n \sim N(0, \sigma^2)\) | Sum of Squared Errors |
| бросок монеты, орёл с вероятностью \(g\): \(t_n \sim Be\bigl(g(x_n|\vb{w})\bigr)\) | binary cross-entropy |
| бросок кубика с \(K\) гранями (на слайде 51 только результат) | cross-entropy |
Урок 15 проходит этот рецепт шаг за шагом. Отсюда и совет на слайде 52 лекции 2: error function строят из того, что известно о данных, а не берут готовой.
В формате экзамена
A feed-forward neural network has to solve (a) a regression task, (b) a two-class classification task, (c) a classification task with \(K\) classes. For each case give the number of output neurons, the output activation function, the coding of the targets and the error function. Justify the choice of the output activation.
Show model answer
(a) Regression. One output neuron with a linear activation, \(g(a) = a\): the output has to span the whole real axis, so it must not be squashed. Targets \(t_n \in \R\). Error function: Sum of Squared Errors,
\[ E(\vb{w}) = \sum_{n=1}^{N} \bigl(t_n - g(x_n|\vb{w})\bigr)^2 . \](b) Two classes. One output neuron. If the classes are coded \(\{0, 1\}\), use a sigmoid: its output lies in \((0, 1)\) and can be interpreted as the class posterior probability \(p(t_n = 1 \mid x_n)\). The error function is the binary cross-entropy,
\[ \begin{aligned} & E(\vb{w}) = -\sum_{n=1}^{N} \bigl[\, t_n \log y_n \\ & \qquad {} + (1 - t_n) \log (1 - y_n) \,\bigr], \end{aligned} \]with \(y_n = g(x_n|\vb{w})\). If the classes are coded \(\{-1, +1\}\), use a tanh output, whose range \((-1, 1)\) matches the coding.
(c) \(K\) classes. \(K\) output neurons, one per class, with a softmax unit \(y_k = \exp(z_k) / \sum_j \exp(z_j)\): the outputs are positive and sum to one. Targets are one-hot vectors. Error function: cross-entropy, \(E(\vb{w}) = -\sum_n \vb{t}_n\T \log g(x_n|\vb{w})\).
Полный ответ — четыре столбца таблицы и одно «почему» на строку. Две вещи легко упустить: случай −1 / +1 с tanh и объяснение, почему на выходе regression не может стоять sigmoid. Термины бери со слайдов: Sum of Squared Errors, class posterior probability, one-hot.
Four samples have targets \(t = (1,\ 0,\ 1,\ 0)\). A network with a sigmoid output returns \((0.9,\ 0.2,\ 0.4,\ 0.6)\). Compute the binary cross-entropy averaged over the four samples (natural logarithm, three decimals).
Show model answer
For each sample the error is minus the logarithm of the probability assigned to the true class:
\[ -\ln 0.9 = 0.105, \qquad -\ln 0.8 = 0.223 \] \[ -\ln 0.4 = 0.916, \qquad -\ln 0.4 = 0.916 \] \[ 0.105 + 0.223 + 0.916 + 0.916 = 2.161 \] \[ E = \frac{2.161}{4} = 0.540 \]A constant predictor \(y = 0.5\) scores \(\ln 2 = 0.693\), so this model is only slightly better than chance.
Ловушка — второй и четвёртый примеры: при \(t = 0\) под логарифмом стоит \(1 - y\), а не \(y\). Если в условии не сказано «averaged», на слайдах ошибка — сумма: 2.161.
The three output neurons of a classifier receive the pre-activations \(z = (2.0,\ 1.0,\ 0.1)\) and use a softmax unit. The target is \(\vb{t} = (0,\ 1,\ 0)\). Compute the cross-entropy error for this sample.
Show model answer
Check without rounding \(y_2\): \(E = \ln S - z_2 = 2.417 - 1.0\). The gradient with respect to the pre-activations is \(\vb{y} - \vb{t} = (0.659,\ {-}0.758,\ 0.099)\); its components sum to zero.
Экспоненты считаются на обычном калькуляторе. Ошибка зависит только от доли правильного класса, но чтобы её получить, нужна сумма всех трёх экспонент. С округлённым 0.242 выходит 1.419 — поле ответа примет и это, но надёжнее держать в промежуточных числах четыре знака.
A network for two-class classification has a sigmoid output \(y = \sigma(a)\) and targets \(t \in \{0, 1\}\). Derive \(\partial E / \partial a\) for the binary cross-entropy of one sample and explain why this error function is preferred to the squared error.
Show model answer
With \(E = -[\, t \ln y + (1 - t) \ln(1 - y) \,]\) the chain rule gives
\[ \pd{E}{y} = \frac{y - t}{y\,(1 - y)}, \qquad \pd{y}{a} = y\,(1 - y) \] \[ \pd{E}{a} = \pd{E}{y} \cdot \pd{y}{a} = y - t . \]The derivative of the sigmoid cancels, so the gradient is proportional to the error even when the output is saturated: a confidently wrong output still receives a large correction. With the squared error \(E = (t - y)^2\) the gradient is \(2(y - t)\,y(1 - y)\); the factor \(y(1 - y)\) goes to zero when the output saturates, so a confidently wrong network learns very slowly. Moreover, the cross-entropy is the maximum-likelihood error function for Bernoulli-distributed targets, \(t_n \sim Be(g(x_n|\vb{w}))\).
Нужны три вещи: вывод в две строки, слово «cancels» про производную sigmoid и сравнение с квадратом промаха через множитель \(y(1 - y)\). Фраза про maximum likelihood — связка с уроком 15, она показывает, что пара выбрана не случайно.
Which of the following statements are correct? Select all that apply.
Show model answer
Correct: the first, the second and the fourth statement. The third is false because the hidden units are still non-linear. The fifth is false because every pre-activation enters the softmax denominator, so \(y_c\) and hence \(-\ln y_c\) depend on all of them.
В вопросах «select all» отмечай только то, что можешь обосновать. Здесь на каждое утверждение хватает одной строки: первое и четвёртое — алгебра softmax, второе — слайд 19 лекции 2, третье и пятое опровергаются одной фразой.
A regression network with a linear output returns \((3,\ 4,\ 8,\ 2)\) for four samples whose targets are \((2,\ 5,\ 6,\ 3)\). Compute the Sum of Squared Errors.
Show model answer
Dividing by \(N = 4\) gives the Mean Squared Error, 1.75; the Mean Absolute Error is \((1 + 1 + 2 + 1)/4 = 1.25\).
Проверяют, читаешь ли ты название: Sum — это 7, Mean — 1.75. Третий пример даёт больше половины суммы: большие промахи квадрат наказывает сильнее.
Проверь себя
Сеть должна предсказывать температуру воздуха в градусах Цельсия. Что поставить на выход?
В обучающих данных два класса записаны как −1 и +1. Какой выход ставит для этого случая слайд 19 лекции 2?
Две сети выдали logits для трёх классов: первая \((5,\ 3,\ 3)\), вторая \((2,\ 0,\ 0)\). У какой после softmax вероятность первого класса больше?
Выход softmax, ошибка cross-entropy, правильный класс \(c\). Что верно?
Картинка для памяти: полоса длиной 1, разрезанная на \(K\) кусков. Нельзя удлинить один кусок, не укоротив другие.
На четырёх письмах средняя binary cross-entropy равна 0.54. Как это понимать?
Выход sigmoid, правильный ответ \(t = 1\), сеть выдала \(y = 0.0003\). Какая функция ошибки даст больший по модулю сигнал \(\partial E / \partial a\)?
В данных о ценах квартир одна запись с опечаткой — лишний ноль в цене. Одну и ту же сеть учат дважды: с squared error и с absolute error. Чем будут отличаться результаты?
Унести с собой
- Скрытые слои устроены одинаково для любой задачи (sigmoid или tanh); под задачу выбирают выходной слой и error function.
- Regression: один нейрон с linear activation и Sum of Squared Errors. Квадрат тянет ответ к среднему и чувствителен к выбросам, модуль — к медиане.
- Два класса: при кодировке 0 / 1 — sigmoid, ответ читается как class posterior probability, ошибка — binary cross-entropy; при кодировке −1 / +1 — tanh.
- \(K\) классов: \(K\) нейронов, ответы one-hot, softmax и cross-entropy \(-\ln y_c\). Softmax видит только разности logits, а при \(K = 2\) совпадает с sigmoid.
- В правильной паре сигнал на выходном нейроне равен \(y - t\): производная активации сокращается, и уверенная ошибка исправляется быстро.
- Cross-entropy сравнивают не с нулём, а со штрафом модели «ничего не знаю»: \(\ln 2\) для двух классов, \(\ln K\) для \(K\).
Что посмотреть и почитать
-
Neural Networks Part 5: ArgMax and SoftMax
StatQuest with Josh Starmer
Если softmax встречается впервые: на маленькой сети с числами показано, зачем он нужен и почему с жёстким arg max сеть обучить нельзя.
-
Neural Networks Part 6: Cross Entropy
StatQuest with Josh Starmer
Тот же сюжет, что во втором виджете: cross-entropy против квадрата промаха и более крутой склон там, где ответ сильно неверен. Смотреть после раздела про два класса.
-
Dive into Deep Learning, 4.1 Softmax Regression
Zhang, Lipton, Li, Smola
Все три факта урока в одном месте и с выводами: softmax как вектор вероятностей, cross-entropy как минус логарифм правдоподобия и градиент «ответ минус цель».
-
Visual Information Theory
Christopher Olah
Что именно измеряет cross-entropy: энтропия и «удивление» нарисованы как площади прямоугольников. Для тех, кому штрафа синоптика мало.
-
Deep Learning, глава 6, раздел 6.2
Goodfellow, Bengio, Courville
Строгий учебник по всей этой теме: выходные нейроны linear, sigmoid и softmax вместе с их функциями ошибки, выведенными из maximum likelihood. Читать перед уроком 15.