От нейрона к сети
После этого урока ты по схеме сети запишешь её формулу в обозначениях слайдов, посчитаешь параметры и прямой проход на калькуляторе и в три строчки докажешь, почему без нелинейной активации любая глубина схлопывается в один слой.
Вот сеть, которая читает рукописные цифры: 784 входа (по одному на пиксель картинки 28 × 28), два скрытых слоя на 128 и 64 нейрона, 10 выходов. В ней 109 386 настраиваемых чисел.
Вынь из неё одну деталь, в которой нет ни одного настраиваемого числа: функцию активации в скрытых слоях. Все нейроны и все связи остались на месте. Но теперь эту сеть можно заменить одной таблицей из 7 850 чисел, и на любой картинке ответы совпадут. Остальные 101 536 параметров ничего не добавляют.
Куда делись сто тысяч параметров? И что такого в детали без единого числа, что на ней держится вся сила сети? К концу урока это доказывается в три строчки.
Нейроны встают в слои
В уроке 8 один нейрон не справился с XOR, а три справились: два провели по прямой, третий объединил их ответы. Ту сеть собрали руками под одну задачу. Теперь нужен общий чертёж, по которому собирается сеть любого размера.
Представь микшерный пульт. На каждый входящий кабель у него свой ползунок громкости, ещё есть одна ручка общего сдвига, а на выходе стоит педаль эффекта. Это один нейрон: ползунки — веса, ручка сдвига — bias (смещение), педаль — функция активации. Стойка из нескольких пультов, которые слушают одни и те же кабели, — это слой. Стойки, включённые друг за другом, — сеть. Звук идёт только вперёд, от микрофонов к колонкам.
Feed Forward Neural Network (FFNN, сеть прямого распространения; на слайдах её же называют Multi Layer Perceptron, а конспект сокращает до FNN) — нейросеть, в которой сигнал идёт в одну сторону: от входного слоя через скрытые к выходному. Циклов и петель нет, поэтому выход нейрона зависит только от предыдущих слоёв.
Feed-forward: все стрелки слева направо
Не feed-forward: выход вернулся назад
«Feed-forward — значит один скрытый слой». Нет. Слоёв может быть сколько угодно, лишь бы ни одна связь не шла назад. И наоборот: много слоёв не делают сеть рекуррентной.
Три вида слоёв
Input layer (входной слой) — по одному «нейрону» на признак: пиксель, показание датчика, столбец таблицы. Он ничего не считает и только раздаёт значения дальше. Параметров у него нет. На слайдах в нём \(I\) нейронов.
Hidden layers (скрытые слои) — нейроны, которые считают взвешенную сумму и пропускают её через функцию активации. Снаружи их выходы не видны, отсюда название. Каждый скрытый нейрон отвечает на свой промежуточный вопрос, как два нейрона-«прямые» в XOR. В слое \(l\) их \(J_l\).
Output layer (выходной слой) — \(K\) нейронов, которые выдают ответ сети. Какая у них активация, решает задача, а не архитектура: об этом урок 11.
Соседние слои соединены полностью: каждый нейрон слоя \(l\) получает выходы всех нейронов слоя \(l - 1\). Такой слой называют fully connected (полносвязным), или dense. У каждой связи свой вес, у каждого нейрона свой bias. Рисуют такую сеть как граф: узлы — нейроны, рёбра — связи с весами.
Слайд 17 лекции 2 описывает всю конструкцию одной фразой: «Non-linear model characterized by the number of neurons, activation functions, and the values of weights». Первые два пункта выбирает человек до обучения (это гиперпараметры, hyperparameters, — урок 21). Третий подбирает обучение.
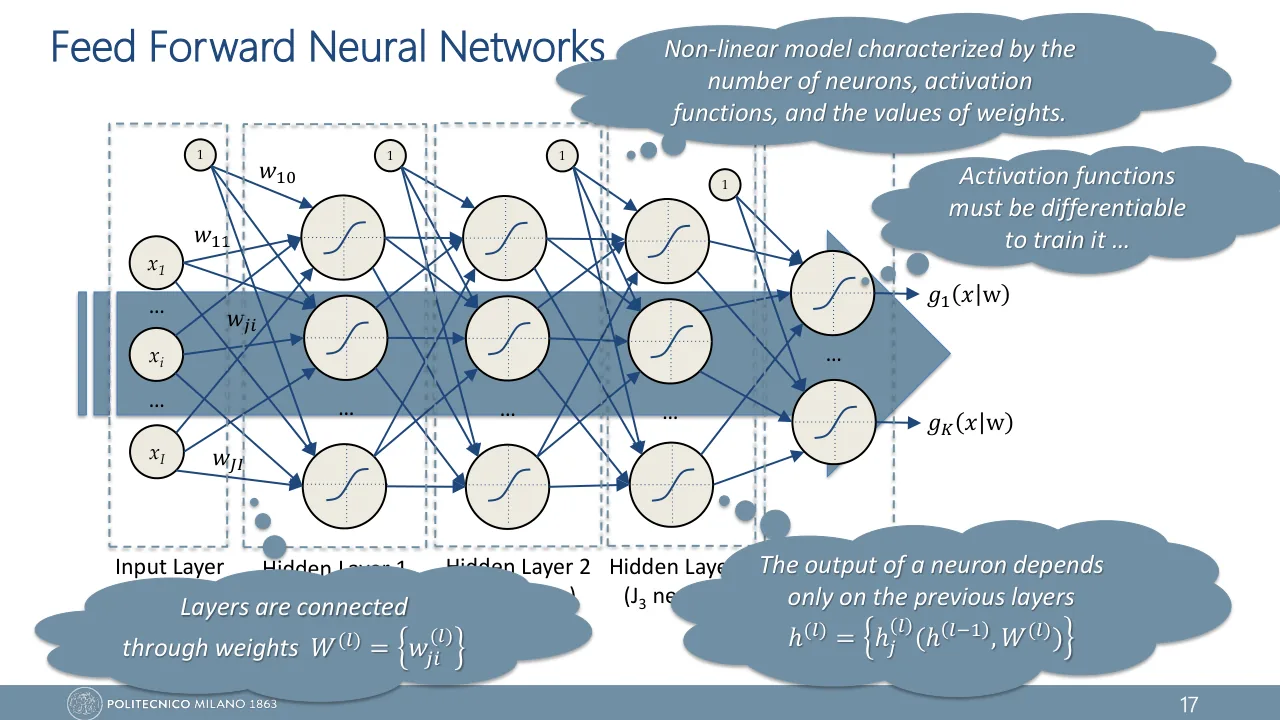
Зачем скрытых слоёв несколько? Конспект (стр. 59) отвечает так: первые слои ловят простые узоры, например края на картинке, а следующие собирают из них сложные — формы и целые предметы. Это те самые learned features, выученные признаки из урока 3, только выстроенные лесенкой. Держи это в голове как наблюдение за обученными на картинках сетями, а не как теорему: для произвольной FFNN такой гарантии никто не давал.
У каждого веса есть адрес
В сети на рис. 2 двадцать шесть чисел. Чтобы формулы читались, каждому нужен адрес. На слайдах адрес веса состоит из трёх номеров. Посмотри на один скрытый нейрон крупным планом.
- \(w_{ji}^{(l)}\)
- вес связи в нейрон \(j\) слоя \(l\) из нейрона \(i\) слоя \(l - 1\): сначала «куда», потом «откуда»
- \(h_i^{(l-1)}\)
- выход нейрона \(i\) предыдущего слоя; для первого слоя это входы, \(h^{(0)} = \vb{x}\)
- \(w_{j0}^{(l)}\)
- bias нейрона \(j\): вес связи от единицы, \(h_0 = 1\)
- \(a_j^{(l)}\)
- взвешенная сумма; в конспекте net input, или activation potential
- \(h_j(\cdot)\)
- функция активации скрытого нейрона; у выходного нейрона её пишут \(g(\cdot)\)
- \(J_l\)
- число нейронов в слое \(l\); входов \(J_0 = I\), выходов \(K\)
В \(w_{ji}^{(l)}\) первый индекс — куда, второй — откуда, верхний — номер слоя, в котором стоит нейрон-получатель.
Все веса одного слоя складывают в матрицу \(W^{(l)} = \{w_{ji}^{(l)}\}\). Строка \(j\) — это всё, что принадлежит нейрону \(j\). Для первого слоя сети 3–4–2:
\[ W^{(1)} = \begin{pmatrix} w_{10} & w_{11} & w_{12} & w_{13} \\ w_{20} & w_{21} & w_{22} & w_{23} \\ w_{30} & w_{31} & w_{32} & w_{33} \\ w_{40} & w_{41} & w_{42} & w_{43} \end{pmatrix} \]Четыре строки — четыре скрытых нейрона. Четыре столбца — bias и три входа. Вторая строка — это ровно рис. 3. На слайде 17 лекции 2 та же мысль записана для слоя целиком: \(h^{(l)} = \{h_j^{(l)}(h^{(l-1)}, W^{(l)})\}\) — выходы слоя зависят только от предыдущего слоя и своей матрицы весов.
Теперь можно записать сеть с одним скрытым слоем и одним выходом одной формулой. Именно в таком виде она стоит на слайде 25, и с неё начинается вывод градиента в уроке 14:
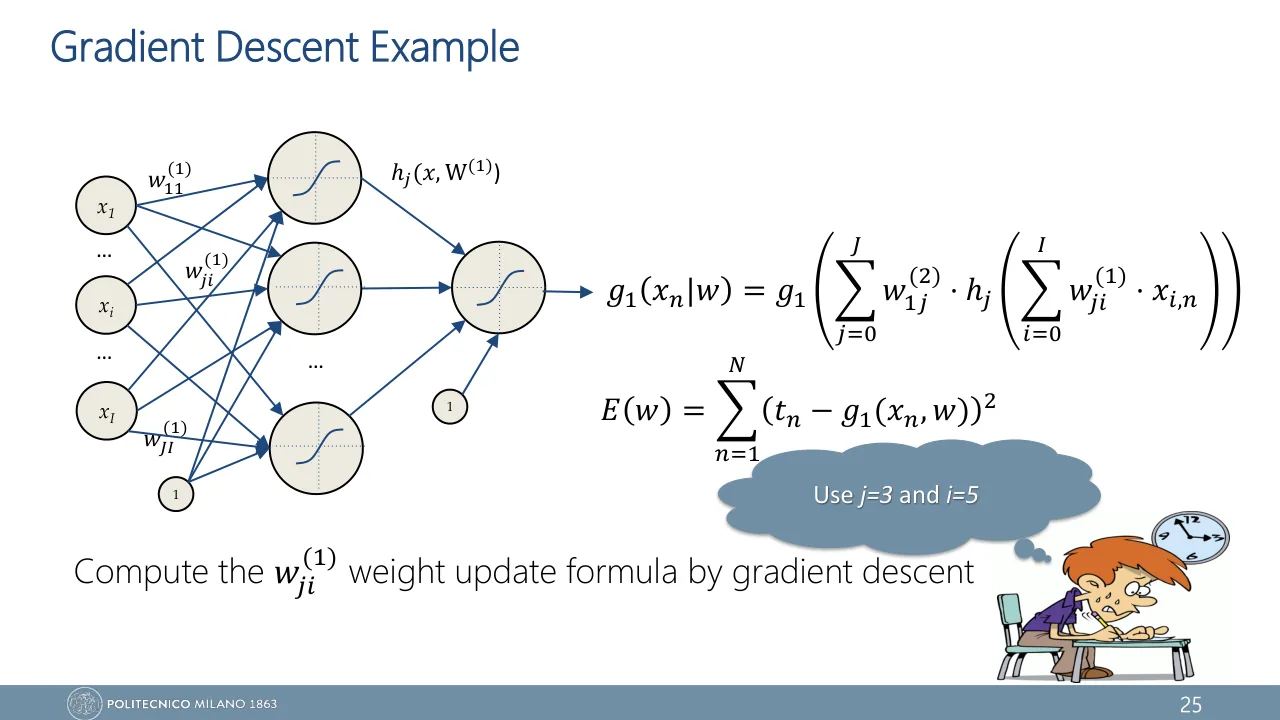
- \(g(\vb{x}_n | \vb{w})\)
- ответ сети на пример \(\vb{x}_n\) при весах \(\vb{w}\); его сравнивают с правильным ответом \(t_n\). На слайде 25 единственный выход пронумерован: \(g_1\)
- \(w_{1j}^{(2)}\)
- вес второго слоя: в выходной нейрон 1 из скрытого нейрона \(j\); \(w_{10}^{(2)}\) — bias выхода, \(h_0 = 1\)
- \(x_{i,n}\)
- признак \(i\) примера \(n\); \(x_{0,n} = 1\)
- \(g(\cdot)\) справа
- активация выходного нейрона: буква та же, что у всей сети, не перепутай
| Что это | Слайды | Конспект, стр. 57–62 |
|---|---|---|
| взвешенная сумма | \(a\) | \(a = \vb{w}\T\vb{x} + b\) на стр. 60; но на стр. 57–58 буквой \(a\) назван уже выход нейрона |
| bias | \(w_{j0}\), вес от \(x_0 = 1\) | отдельное число \(b_j\) |
| функция активации | \(h_j(\cdot)\) в скрытом слое, \(g(\cdot)\) на выходе | \(f(\cdot)\) для любого слоя; на стр. 60 местами \(g(\cdot)\) |
| выход скрытого нейрона | \(h_j\) | \(a_j\) на стр. 57, \(y\) на стр. 60 |
| выход сети | \(g(\vb{x}_n | \vb{w})\) | \(x^{(l)}\) на стр. 58 |
| правильный ответ | \(t_n\) | target |
Сколько в сети параметров
Параметры — это всё, что подбирает обучение: веса и biases. Считать их просто, если помнить рис. 3: параметры живут на стрелках, которые входят в нейрон. У нейрона с \(n\) входами \(n\) весов и один bias. В слое \(J_l\) нейронов, у каждого \(J_{l-1}\) входов:
\[ \underbrace{(J_{l-1} + 1)}_{\text{входы и bias}} \cdot \underbrace{J_l}_{\text{нейроны слоя}} \]Это просто размер матрицы \(W^{(l)}\): число строк на число столбцов. Для всей сети такие произведения складывают по слоям. Сеть 3–4–2 с рис. 2:
\[ \underbrace{(3 + 1)\cdot 4}_{16} + \underbrace{(4 + 1)\cdot 2}_{10} = 26 . \]Из них 20 весов и 6 biases. А вот сеть из задачки для разгона, 784–128–64–10:
\[ \underbrace{785 \cdot 128}_{100\,480} + \underbrace{129 \cdot 64}_{8\,256} + \underbrace{65 \cdot 10}_{650} \] \[ = 109\,386 . \]Быстрая самопроверка на экзамене. Весов без biases столько, сколько даёт сумма произведений соседних размеров: \(3 \cdot 4 + 4 \cdot 2 = 20\). Biases столько, сколько нейронов во всех слоях, кроме входного: \(4 + 2 = 6\). Если в условии не сказано обратное, biases считай.
Forward pass: слева направо, слой за слоем
Посчитать ответ сети для данного входа — значит пройти по ней слева направо. Это называется forward pass (прямой проход). Хитрости нет никакой: чтобы посчитать нейрон, нужны выходы предыдущего слоя, и только они. Поэтому порядок один: сначала весь первый слой, потом весь второй, и так до выхода.
Возьмём самую маленькую настоящую сеть, 2–2–1. Скрытые нейроны с активацией \(\tanh\) (её устройство — в уроке 10, сейчас это просто кнопка на калькуляторе), выходной нейрон линейный: \(g(a) = a\). Веса запишем матрицами, bias в первом столбце:
\[ W^{(1)} = \begin{pmatrix} 0.5 & 1 & -0.5 \\ -1 & 0.5 & 1 \end{pmatrix} \] \[ W^{(2)} = \begin{pmatrix} 0.1 & 2 & -1 \end{pmatrix} \]На вход подан \(\vb{x} = (1, 2)\). Считаем по строкам матриц:
| Нейрон | Взвешенная сумма \(a\) | Выход |
|---|---|---|
| \(h_1\) | \(0.5 + 1 \cdot 1 + (-0.5) \cdot 2 = 0.5\) | \(\tanh(0.5) = 0.4621\) |
| \(h_2\) | \(-1 + 0.5 \cdot 1 + 1 \cdot 2 = 1.5\) | \(\tanh(1.5) = 0.9051\) |
| \(g\) | \(0.1 + 2 \cdot 0.4621 - 0.9051\) | \(0.1191\) |
В последней строке вместо \(x_1, x_2\) стоят уже \(h_1, h_2\): выходной нейрон не видит входов сети, он видит только скрытый слой. Проверь себя на других числах.
Этот расчёт перекликается с тем, что ты знаешь из Applied Statistics. Нейрон с линейной активацией считает \(w_0 + \sum_i w_i x_i\) — ровно формулу линейной регрессии. Нейрон с сигмоидой — логистическую регрессию. Сеть делает ту же регрессию, только подаёт в неё не исходные признаки, а признаки \(h_j\), которые построил предыдущий слой. PCA тоже строит новые признаки из старых, но только линейно. Чем это ограничение плохо, видно в следующем разделе.
На экзамене калькулятор непрограммируемый, так что оформляй расчёт той же таблицей: нейрон, сумма, выход. Промежуточные числа держи с четырьмя знаками, округляй только ответ. Если на калькуляторе нет \(\tanh\), считай через экспоненту: \(\tanh a = \dfrac{e^{2a} - 1}{e^{2a} + 1}\).
Сто слоёв — одна прямая
Вернёмся к пультам. Поставь два пульта подряд и убери педали эффектов. Первый пульт смешал каналы. Второй смешал то, что получилось. Но смесь смесей — это снова смесь исходных каналов, просто с другими коэффициентами. Значит, пару пультов можно заменить одним, выставив на нём ползунки как надо. Второй пульт был лишним.
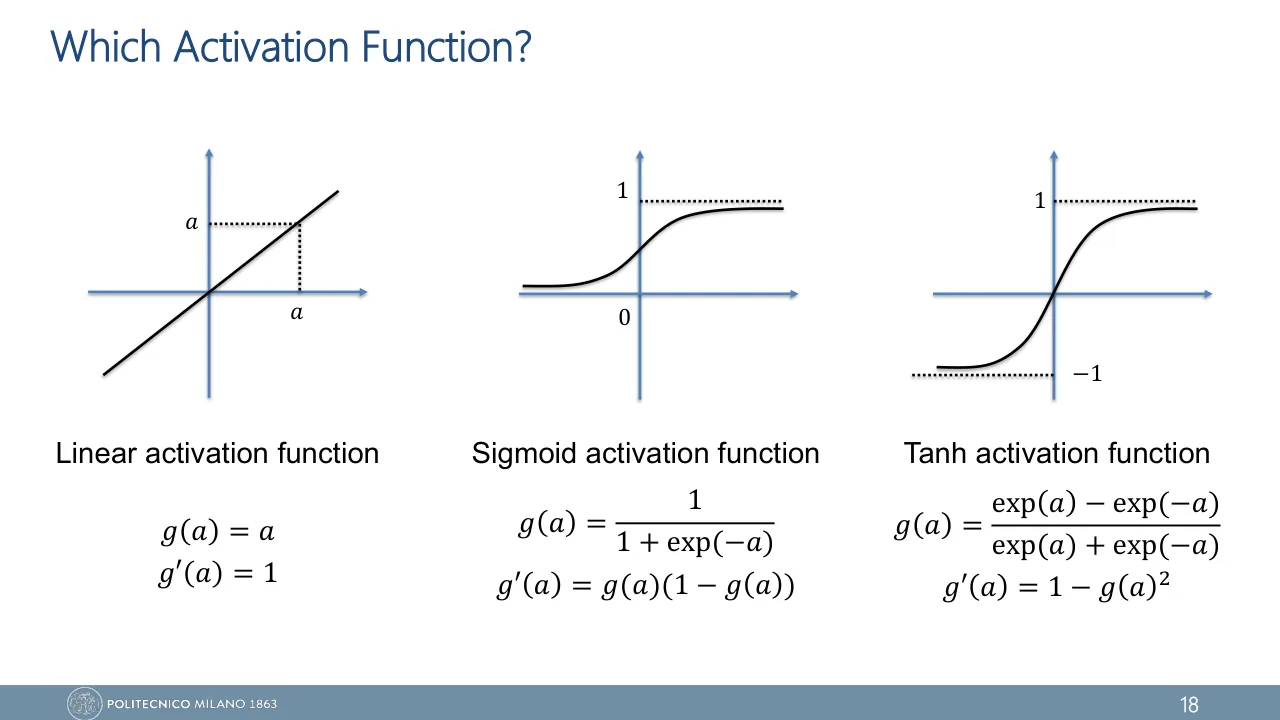
В сети «убрать педаль» — значит взять linear activation function, линейную функцию активации \(g(a) = a\) (слайд 18 лекции 2; в конспекте формула (12) на стр. 62). Нейрон с ней выдаёт взвешенную сумму как есть. Производная у неё \(g'(a) = 1\), диапазон — вся числовая прямая. Проверим на формулах, что останется от сети.
-
Возьмём сеть с одним скрытым слоем. Вынесем biases \(w_{j0}\) из матриц в отдельные векторы \(\vb{b}\): так короче, и так же пишет конспект. Скрытый слой считает суммы и применяет активацию:
\[ \vb{a}^{(1)} = W^{(1)}\vb{x} + \vb{b}^{(1)} \] \[ \vb{h} = h\big(\vb{a}^{(1)}\big) \] -
Выходной слой берёт \(\vb{h}\) и считает свои суммы \(\vb{a}^{(2)}\). Ответ сети — это \(g\big(\vb{a}^{(2)}\big)\), но выходная активация \(g\) сейчас ни при чём: смотрим на то, что в неё попадает.
\[ \vb{a}^{(2)} = W^{(2)}\vb{h} + \vb{b}^{(2)} \] -
Теперь условие: активация скрытого слоя линейная, \(h(a) = a\). Тогда \(\vb{h} = \vb{a}^{(1)}\), и первую строку можно подставить во вторую:
\[ \vb{a}^{(2)} = W^{(2)}\big(W^{(1)}\vb{x} + \vb{b}^{(1)}\big) + \vb{b}^{(2)} \] -
Раскроем скобки. Всё, что умножается на \(\vb{x}\), собирается в одно слагаемое, остальное — в другое:
\[ \begin{aligned} \vb{a}^{(2)} &= \underbrace{W^{(2)}W^{(1)}}_{W}\,\vb{x} \\ &\quad {} + \underbrace{W^{(2)}\vb{b}^{(1)} + \vb{b}^{(2)}}_{\vb{b}} \end{aligned} \] -
Произведение двух матриц — снова матрица, размером \(K \times I\). Сумма векторов — снова вектор. Получился один слой:
\[ \vb{a}^{(2)} = W\vb{x} + \vb{b} \]Ответ сети равен \(g(W\vb{x} + \vb{b})\). Скрытый слой исчез: ту же функцию считает сеть вообще без него.
-
Третий линейный слой добавит ещё один множитель слева, четвёртый — ещё один. Для \(n\) слоёв по индукции:
\[ W = W^{(n)}\, W^{(n-1)} \cdots W^{(1)} . \]Сколько бы слоёв ни стояло, остаются одна матрица и один вектор.
До: скрытый слой с linear-активацией
После: тот же ответ без скрытого слоя
Проверим на числах из калькулятора. Там \(W^{(1)}\) без столбца biases — это строки \((1, -0.5)\) и \((0.5, 1)\), вектор \(\vb{b}^{(1)} = (0.5, -1)\); во втором слое веса \((2, -1)\) и \(b^{(2)} = 0.1\). Перемножаем:
\[ w_1 = 2 \cdot 1 - 1 \cdot 0.5 = 1.5 \] \[ w_2 = 2 \cdot (-0.5) - 1 \cdot 1 = -2 \] \[ b = 2 \cdot 0.5 - 1 \cdot (-1) + 0.1 = 2.1 \]Здесь \(W = (w_1, w_2)\) — матрица из одной строки. Выходной нейрон в калькуляторе линейный, поэтому ответ сети совпадает с суммой \(a^{(2)}\). Значит, вся сеть с linear-активацией — это один нейрон \(g = 2.1 + 1.5\,x_1 - 2\,x_2\). При \(\vb{x} = (1, 2)\) он даёт \(-0.4\), как и калькулятор в задании 3.
Если у всех скрытых нейронов линейная активация, то при любых весах и любом числе слоёв сеть равносильна одному слою: её выход равен \(g(W\vb{x} + \vb{b})\). Граница решений такой сети — гиперплоскость, как у одного нейрона из урока 6.
Куда делись сто тысяч параметров
Теперь задачка из начала урока решается сама. В сети 784–128–64–10 без активаций три матрицы перемножаются в одну размером \(10 \times 784\), а три вектора biases сливаются в один из 10 чисел. Итого \(785 \cdot 10 = 7\,850\). Остальные 101 536 параметров — это разные способы записать одно и то же произведение. Нового они выразить не могут.
А деталь без единого числа, функция активации, — это то, что мешает матрицам перемножиться. Пока между слоями стоит нелинейность, каждый слой делает то, чего предыдущие не могли. Сила сети не в количестве слоёв и не в количестве весов, а в том, что между линейными шагами стоят нелинейные.
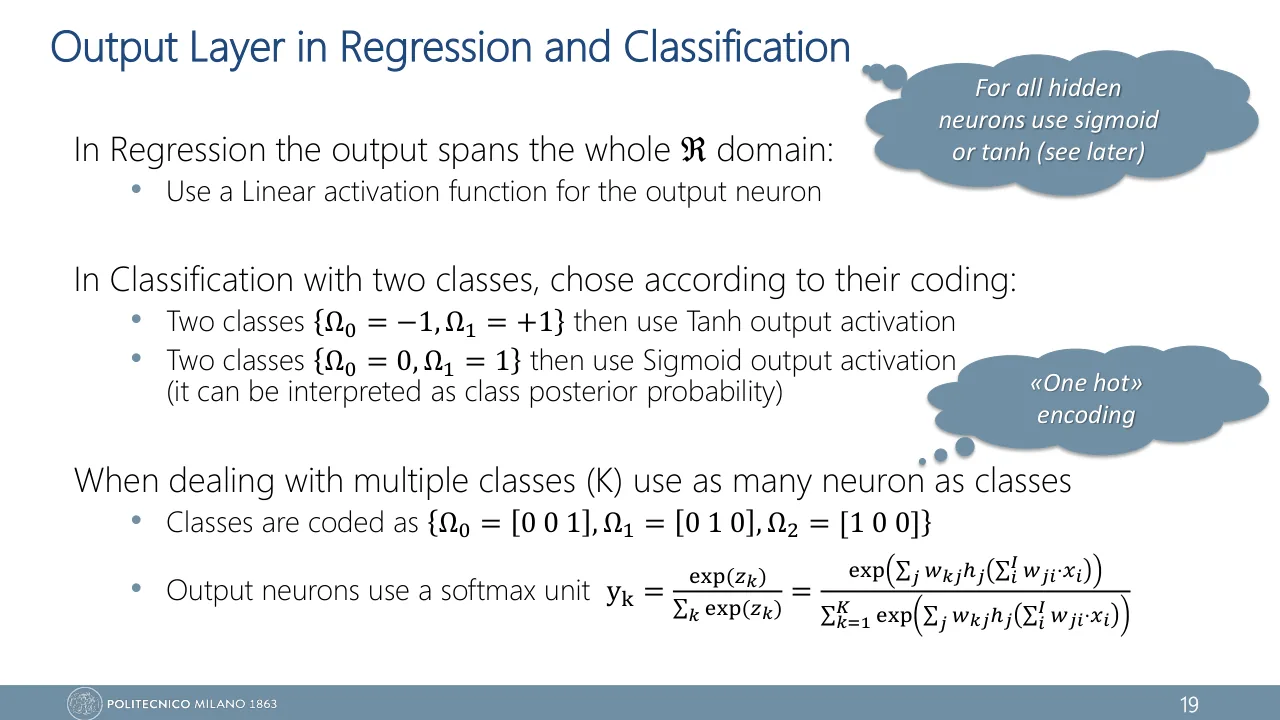
«Значит, линейная активация бесполезна». Бесполезна она в скрытых слоях. На выходе она нужна: в регрессии ответ должен уметь принимать любое вещественное значение (слайд 19 лекции 2, урок 11). И линейный выход не делает сеть линейной: скрытые слои остаются нелинейными, как в калькуляторе выше.
Что получится, если всё-таки обучить сеть из одних линейных слоёв?
Знакомые модели. Линейная сеть, обученная минимизировать сумму квадратов ошибок, — это линейная регрессия, записанная длинным способом (пока ни один скрытый слой не уже выходного: узкий слой ограничивает ранг матрицы \(W\)). А линейная сеть-«песочные часы», которая сжимает вход в узкий скрытый слой и восстанавливает его обратно, находит то же подпространство, что и PCA. Такая сеть называется autoencoder; конспект (стр. 62) лишь называет её среди мест, где встречается линейная активация.
Два требования к активации
Итак, между слоями нужна нелинейная функция. Конспект (стр. 60–61) называет три причины ставить активацию:
- To break linearity — иначе сеть схлопывается, это только что доказано.
- To allow complex decision boundaries — линейный нейрон проводит одну гиперплоскость, а нелинейные скрытые нейроны позволяют собрать из нескольких прямых изогнутую границу или несколько областей, как в XOR.
- To control the output range — «сжать» выход нейрона в ограниченный диапазон (squashing), например в \((0, 1)\). От диапазона зависит, что получит следующий слой, а ограниченные значения не разрастаются от слоя к слою.
Но одной нелинейности мало, и здесь конспект ошибается в важном месте.
Вторую половину требования даёт слайд 17 лекции 2: «Activation functions must be differentiable to train it …». Обучение (уроки 13 и 14) двигает каждый вес туда, где ошибка \(E\) меньше, а для этого нужна производная ошибки по весу. По цепному правилу она распадается на три множителя:
- \(\pd{y}{a}\)
- производная активации \(g'(a)\): насколько выход нейрона откликается на изменение суммы
- \(\pd{a}{w_i}\)
- равна входу \(x_i\), потому что \(a = \sum_i w_i x_i\)
- \(\pd{E}{y}\)
- насколько ошибка зависит от выхода нейрона; в конспекте ошибка обозначена \(L\)
У ступеньки средний множитель равен нулю всюду, кроме точки скачка, а в ней производной нет вовсе. Произведение обнуляется, и вес не получает никакой подсказки, куда ему двигаться. Это те самые плоские полки из задания 4 виджета «Схлопывание слоёв».
Конспект (стр. 61) делает отсюда общий вывод: если производная активации близка к нулю, градиент затухает и обучение останавливается; если множители слишком велики, обучение становится неустойчивым. Поэтому каждую функцию активации изучают вместе с её производной, как на слайде 18. В глубокой сети таких множителей много, по одному на слой, и к этому вернётся урок 24.
| Активация | Нелинейная? | Производная | Что выйдет в скрытом слое |
|---|---|---|---|
| linear, \(g(a) = a\) | нет | \(g'(a) = 1\) | учится, но сеть схлопывается в один слой |
| step | да | 0 почти всюду | может представить XOR, но градиентом не обучается |
| sigmoid, tanh | да | есть в каждой точке | и выразительность, и обучение |
Активация скрытых нейронов должна быть нелинейной, чтобы слои не схлопнулись, и дифференцируемой, чтобы сеть можно было обучать градиентом.
«У linear производная равна 1, градиент течёт идеально — ставим её везде». Подпись к рис. 6 конспекта (стр. 63) действительно хвалит «perfect gradient flow». Градиент течёт, но учить нечего: модель остаётся линейной регрессией при любой глубине.
В формате экзамена
Define a Feed Forward Neural Network. Write the output \(g(\vb{x}|\vb{w})\) of a network with \(I\) inputs, one hidden layer of \(J\) neurons and a single output, and say what characterises this model.
Show model answer
A Feed Forward Neural Network is a network of neurons organised in layers (input, one or more hidden, output) in which information flows in one direction only, from the input to the output. There are no cycles: the output of a neuron depends only on the previous layers. Each hidden or output neuron computes a weighted sum of the outputs of the previous layer plus a bias and applies an activation function.
\[ g(\vb{x}|\vb{w}) = g\Big( \sum_{j=0}^{J} w_{1j}^{(2)}\, h_j \Big) \] \[ h_j = h_j\Big( \sum_{i=0}^{I} w_{ji}^{(1)}\, x_i \Big) \]with \(x_0 = h_0 = 1\), so that \(w_{j0}^{(1)}\) and \(w_{10}^{(2)}\) are the biases. It is a non-linear model characterised by the number of neurons, the activation functions and the values of the weights: the first two are chosen by the designer, the weights are learned from data.
Проверяют три вещи. Слова no cycles или depends only on the previous layers. Формулу с правильным порядком индексов и суммой от нуля, то есть с bias. И фразу со слайда 17 лекции 2 про три характеристики модели. Ответ «a network with one hidden layer» определением не является: число слоёв в определение не входит.
A fully connected feed-forward network has 10 inputs, two hidden layers with 8 and 4 neurons, and 3 output neurons. Every hidden and output neuron has a bias. How many parameters does the network have?
Show model answer
Each layer contributes (inputs of the layer + 1 bias) × (neurons of the layer). The input layer has no parameters.
Два типичных неверных ответа: 124 (забыты 15 biases) и 149 (десяти входам приписаны свои biases). Выписывай слагаемые по слоям: так ошибку видно сразу.
A network has one hidden layer whose neurons use the linear activation \(h(a) = a\). Show, including the biases, that it is equivalent to a model with no hidden layer. Which two properties must the activation function of hidden neurons have, and why is the step function of the perceptron not suitable?
Show model answer
With a linear hidden activation \(\vb{h} = W^{(1)}\vb{x} + \vb{b}^{(1)}\), so the input of the output layer is
\[ W^{(2)}\big(W^{(1)}\vb{x} + \vb{b}^{(1)}\big) + \vb{b}^{(2)} \] \[ = \big(W^{(2)}W^{(1)}\big)\vb{x} + \big(W^{(2)}\vb{b}^{(1)} + \vb{b}^{(2)}\big) \] \[ = W\vb{x} + \vb{b} . \]This is a single affine map of the input, exactly what a network without hidden layers computes. By induction the same holds for any number of linear layers, so depth adds no expressive power and the decision boundary stays a hyperplane (XOR remains impossible).
The hidden activation must be (1) non-linear, otherwise the layers collapse as shown, and (2) differentiable, because the weights are trained with gradient-based methods and, by the chain rule, the gradient contains the derivative of the activation \(h'(a)\) as a factor. The step function is non-linear (a network of step units with one hidden layer can represent XOR), but its derivative is zero everywhere except at the jump, where it does not exist: the gradient carries no information.
В ответе должны быть выкладка с biases и слово affine или linear в выводе. Самая частая ошибка — написать, что ступенька «линейная» или что перцептрон не решал XOR «из-за отсутствия нелинейности». Раздели два требования явно: одно про то, что сеть может представить, второе про то, можно ли её обучить.
Consider a 2–2–1 feed-forward network. The hidden neurons use \(\tanh\), the output neuron is linear. The weight matrices, with the bias in the first column (index 0), are
\[ W^{(1)} = \begin{pmatrix} 0.2 & 0.8 & -0.5 \\ -0.3 & -0.4 & 0.3 \end{pmatrix} \] \[ W^{(2)} = \begin{pmatrix} 0.5 & 1 & 2 \end{pmatrix} \]Compute the output \(g(\vb{x}|\vb{w})\) for \(\vb{x} = (1, -1)\). Give three decimals.
Show model answer
Здесь проверяют чтение матрицы: строка — нейрон, нулевой столбец — bias. Типичные потери: минус на минус в \(a_1\), лишний \(\tanh\) на выходе (выход линейный) и раннее округление \(h\) до двух знаков, которое сдвигает ответ.
In the network of the previous question the hidden activation is replaced by the linear activation \(h(a) = a\). The network is then equivalent to a single linear neuron \(g = b + w_1 x_1 + w_2 x_2\). Compute \(w_2\).
Show model answer
Multiply the output weights by the columns of the hidden weights:
\[ w_2 = 1 \cdot (-0.5) + 2 \cdot 0.3 = 0.1 \]In the same way \(w_1 = 1 \cdot 0.8 + 2 \cdot (-0.4) = 0\) and \(b = 0.5 + 1 \cdot 0.2 + 2 \cdot (-0.3) = 0.1\), so \(g = 0.1 + 0.1\,x_2\).
Это \(W = W^{(2)}W^{(1)}\) на числах. Заметь побочный результат: \(w_1 = 0\), линейная сеть вообще перестала замечать первый вход. Сверка: при \(\vb{x} = (1, -1)\) получается \(g = 0\), и прямой проход с \(h = a\) даёт то же: \(0.5 + 1.5 - 2 = 0\).
Which of the following statements about feed-forward neural networks are true? Select all that apply.
Show model answer
True: the first, the third and the fifth. "Feed-forward" only means that there are no cycles. Linear hidden layers collapse into one affine map. A linear output neuron is the standard choice for regression and leaves the hidden layers non-linear.
В вопросах «select all» каждое утверждение проверяй отдельно. Ловят на почти верных формулировках: второе и шестое утверждения звучат правдоподобно, пока не вспомнишь определение и доказательство схлопывания.
Проверь себя
Сеть 5–3–1, у каждого вычисляющего нейрона есть bias. Сколько в ней параметров?
Что означает \(w_{23}^{(1)}\) в обозначениях слайдов?
Какие утверждения о полносвязной feed-forward сети со слайда 17 лекции 2 верны?
Проверка на рис. 2: закрой пальцем всё правее какого-нибудь слоя — левая часть сети по-прежнему считается.
В сети 2–50–50–1 все активации линейные. В ней 2 751 параметр. Сколькими числами можно записать ту же функцию?
В скрытом слое стоит ступенька перцептрона (step). Что верно?
В сети 2–2–1 два скрытых нейрона поменяли местами вместе со всеми их входящими и исходящими весами. Что станет с выходом сети?
Где нелинейная активация обязательна, чтобы сеть не была линейной моделью?
Унести с собой
- Feed Forward Neural Network: слои input → hidden → output, сигнал идёт только вперёд, циклов нет; нейрон видит только предыдущий слой.
- Адрес веса \(w_{ji}^{(l)}\): в нейрон \(j\) слоя \(l\) из нейрона \(i\) слоя \(l - 1\). Bias — это \(w_{j0}\), вес связи от постоянной единицы.
- Модель задают число нейронов, функции активации и значения весов. Первые два выбирает человек, веса подбирает обучение.
- В слое \((J_{l-1} + 1) \cdot J_l\) параметров; у входного слоя их нет. Сеть 3–4–2 — это 26 чисел.
- Forward pass считают слой за слоем: взвешенная сумма \(a\), затем активация.
- Слои с линейной активацией схлопываются в \(W\vb{x} + \vb{b}\). Глубина без нелинейности ничего не даёт.
- Активация скрытых нейронов должна быть нелинейной и дифференцируемой. Step нелинейна, но не обучается градиентом; linear годится только на выход.
Что посмотреть и почитать
-
But what is a neural network?
3Blue1Brown≈ 18 мин
Слои, веса и biases на той самой сети для цифр с 784 входами. После него матричная запись слоя из этого урока читается как подпись к уже знакомой картинке.
-
Neural networks: Interactive exercises
Google Machine Learning Crash Course
Нажимаешь на узел — видишь его веса и bias, меняешь один вес — прямой проход пересчитывается. Хорошая вторая площадка после калькулятора из раздела 3.
-
A Neural Network Playground
Daniel Smilkov, Shan Carter
Схлопывание на двумерных данных. Выбери набор «Exclusive or», оставь скрытые слои и поставь активацию Linear: сеть не справляется при любой глубине. Верни Tanh — справляется.
-
Neural Networks Part 1: Setting up the Architecture
Stanford CS231n
Раздел про архитектуру: как считают слои (входной не в счёт), как записать прямой проход матричными произведениями и как посчитать параметры. Обозначения там свои, сверяйся с таблицей из раздела 2.
-
Using neural nets to recognize handwritten digits
Michael Nielsen, глава 1
Разделы «Sigmoid neurons» и «The architecture of neural networks»: тот же путь от перцептрона к сети обычными словами, включая объяснение, зачем ступеньку заменили гладкой функцией.