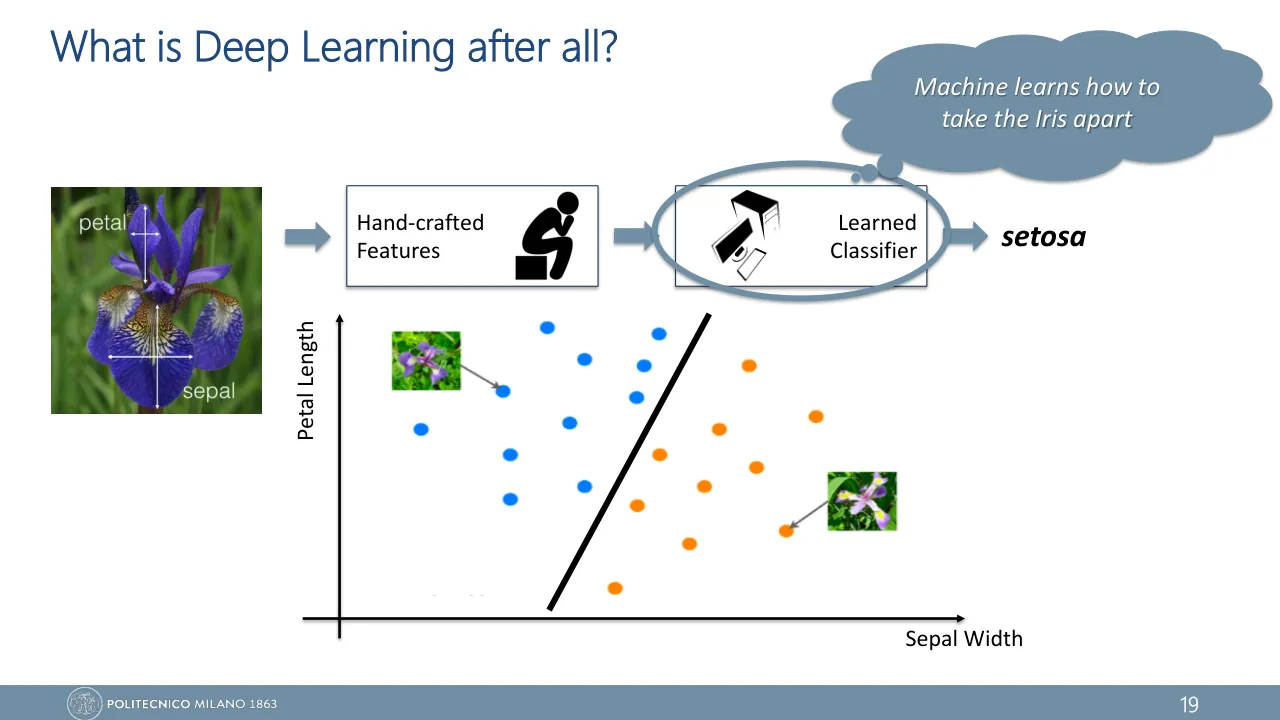
Ирисы измерял ботаник Эдгар Андерсон, а знаменитой таблицу сделал статистик Рональд Фишер. В статье 1936 года он показал на этих цветках linear discriminant analysis — тот самый LDA из Applied Statistics. На слайде профессора написано короче: "Collected by Ronald Fisher in 1936".
Всё дело в признаках
После этого урока ты по одной картинке с точками скажешь, что надо менять — классификатор или признаки, — и одной фразой объяснишь, чем deep learning отличается от всего, что было до него.
В самой знаменитой таблице машинного обучения 150 ирисов трёх видов. Каждый цветок описан четырьмя числами: длина и ширина чашелистика (sepal), длина и ширина лепестка (petal), всё в сантиметрах.
Возьмём из неё строки 57 и 101. Цветок № 57 — Iris versicolor, цветок № 101 — Iris virginica. У обоих sepal length 6.3 и sepal width 3.3. Если показать классификатору только эти два числа, он получит одно и то же дважды и обязан дважды ответить одинаково. Значит, на одном из двух цветков ошибётся любой алгоритм: и линейка школьника, и нейросеть в сто слоёв.
Теперь остальные два числа. Лепесток у № 57 — 4.7 × 1.6 см, у № 101 — 6.0 × 2.5 см. Такие не перепутать. Цветки те же, алгоритм тот же. Что поменялось — и почему до 2012 года распознавание речи и картинок держалось на людях, которые придумывали «правильные числа» вручную?
Классификатор видит только анкету
В уроке 1 классический конвейер supervised learning состоял из двух блоков. Первый превращает объект в несколько чисел. Второй по этим числам принимает решение. Сегодня разбираемся, какой из двух блоков на самом деле решает исход.
Признаки (features) — числа, которыми описан объект и в которых схвачено что-то существенное для задачи. Сам объект до всякой обработки — это raw data (сырые данные), например пиксели фотографии, отсчёты звуковой волны или буквы текста.
| Данные | Raw data | Примеры features |
|---|---|---|
| Изображение | pixels (RGB values) | edges, corners, textures |
| Звук | waveform (amplitude over time) | pitch, frequency spectrum, MFCCs |
| Текст | words or sentences | word counts, syntactic structure |
Признаки, которые придумал и запрограммировал человек, называют hand-crafted features («сделанные вручную»). У самого занятия тоже есть имя.
Feature engineering — использование знаний о предметной области, чтобы извлечь из raw data признаки, на которых алгоритмы машинного обучения начинают работать. Что измерять и как это вычислять, решает эксперт, а не данные.
Удобно думать об этом как об анкете. Инженер заранее решил, какие в ней графы. Классификатор — чиновник, который самого посетителя не видит никогда: только заполненную анкету. Он может быть сколь угодно умным, но если нужного вопроса в анкете нет, ответ взять неоткуда.
Классификатор не видит объект. Он видит только то, что записано в признаках.
\[ \vb{x}_n \;\longrightarrow\; \psi(\vb{x}_n) \;\longrightarrow\; g\big(\psi(\vb{x}_n) \mid \vb{w}\big) \]
- \(\vb{x}_n\)
- raw data: \(n\)-й объект как он есть
- \(\psi\)
- признаки: фиксированная функция, придуманная человеком
- \(g(\cdot \mid \vb{w})\)
- classifier с весами \(\vb{w}\); только их подбирает обучение
- \(t_n\)
- target: правильный ответ, с которым сравнивают выход
В таблице Iris анкета из четырёх граф: sepal length, sepal width, petal length, petal width. Цветков 150, по 50 каждого вида: Iris setosa, Iris versicolor, Iris virginica.
«Четыре числа в таблице Iris — это raw data». Нет: это уже hand-crafted features. Raw data здесь — сам цветок или его фотография, а что именно мерить линейкой, решил ботаник. Поэтому на слайдах профессора оба конвейера, и классический, и deep learning, начинаются с фотографии ириса, а не с таблицы.
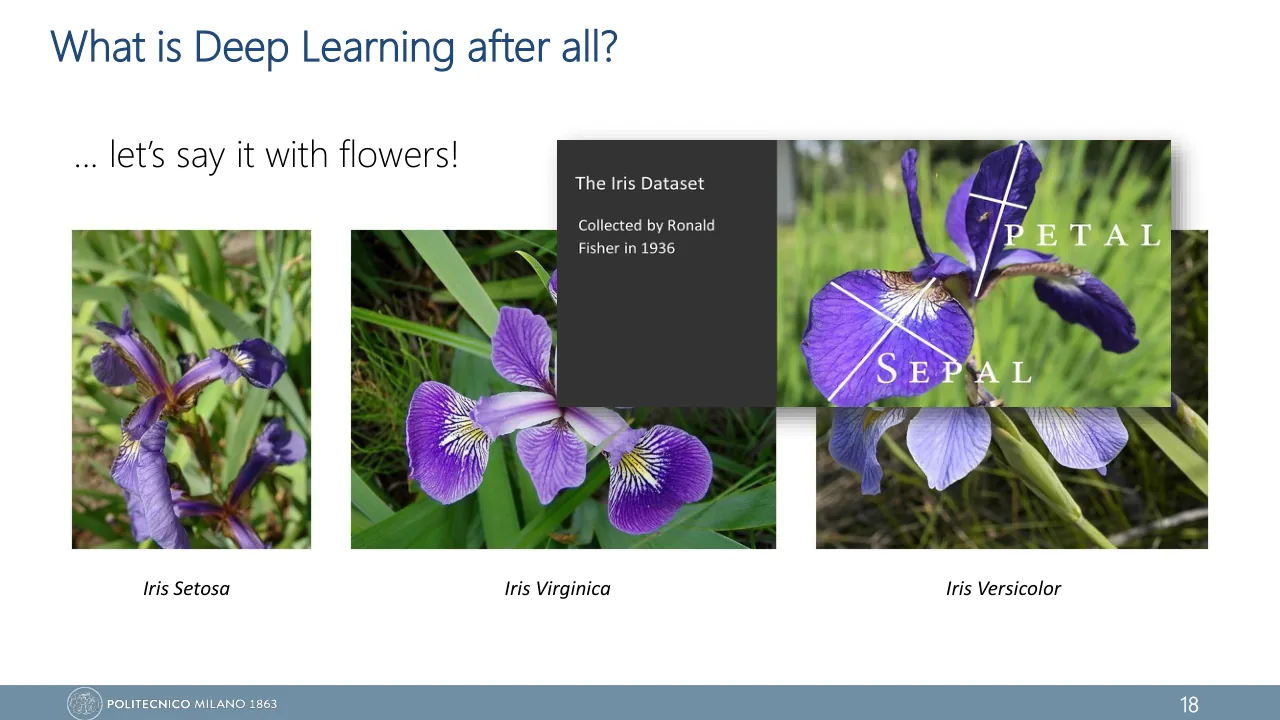
Три сцены с ирисами
Профессор объясняет deep learning «на цветах» (слайды 18–23 лекции 1). Конвейер всё время один и тот же: hand-crafted features, за ними learned classifier. Меняется только картинка под ним: как выбранные признаки разложили цветки на плоскости. Получаются три сцены.
Сцена 1: хватает прямой
На осях sepal width и petal length два класса лежат по разные стороны одной прямой. Подпись на слайде: "Machine learns how to take the Iris apart". Классификатору остаётся выучить, где эта прямая проходит.
Сцена 2: граница есть, но она кривая
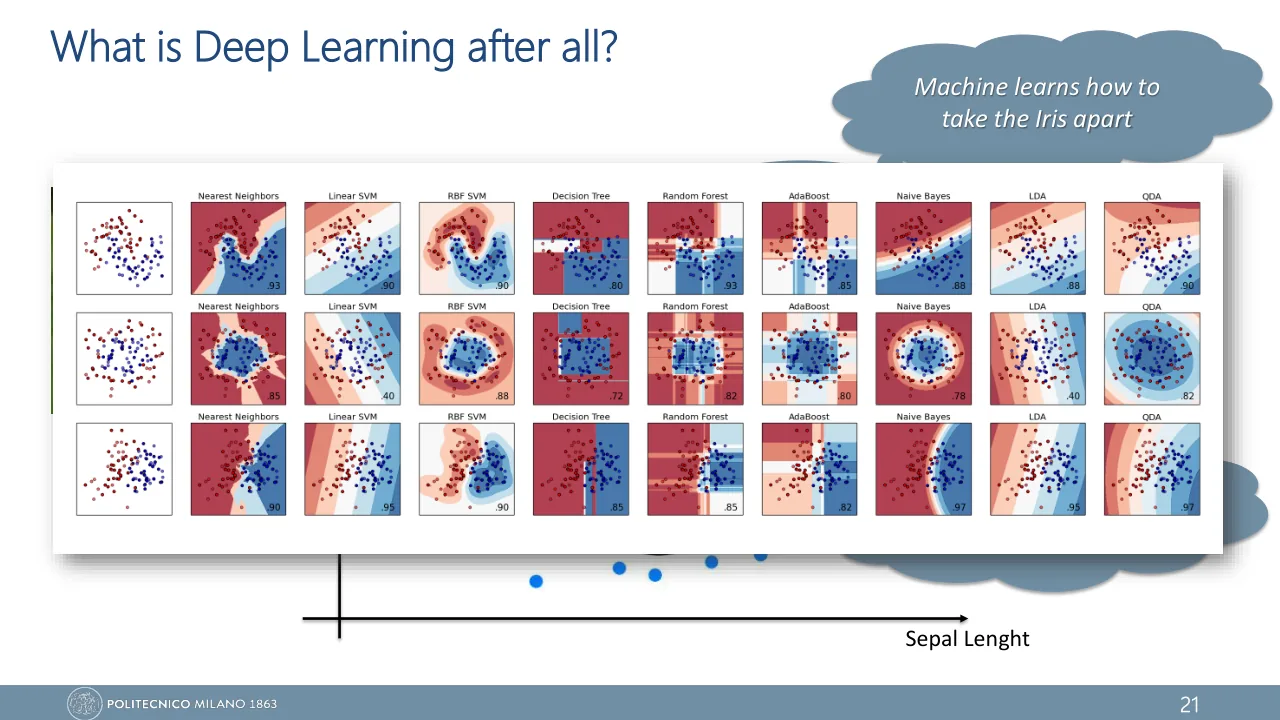
С другой парой признаков (sepal length и petal length) оранжевые точки оказались в середине, синие — вокруг. Подпись: "Sometimes the decision might be more complex". Прямая тут бессильна, но граница существует: это окружность. Значит, нужен классификатор погибче. На слайде 21 профессор показывает целый зоопарк таких: Nearest Neighbors, RBF SVM, Decision Tree, Random Forest и другие. Каждый рисует границы своей формы.
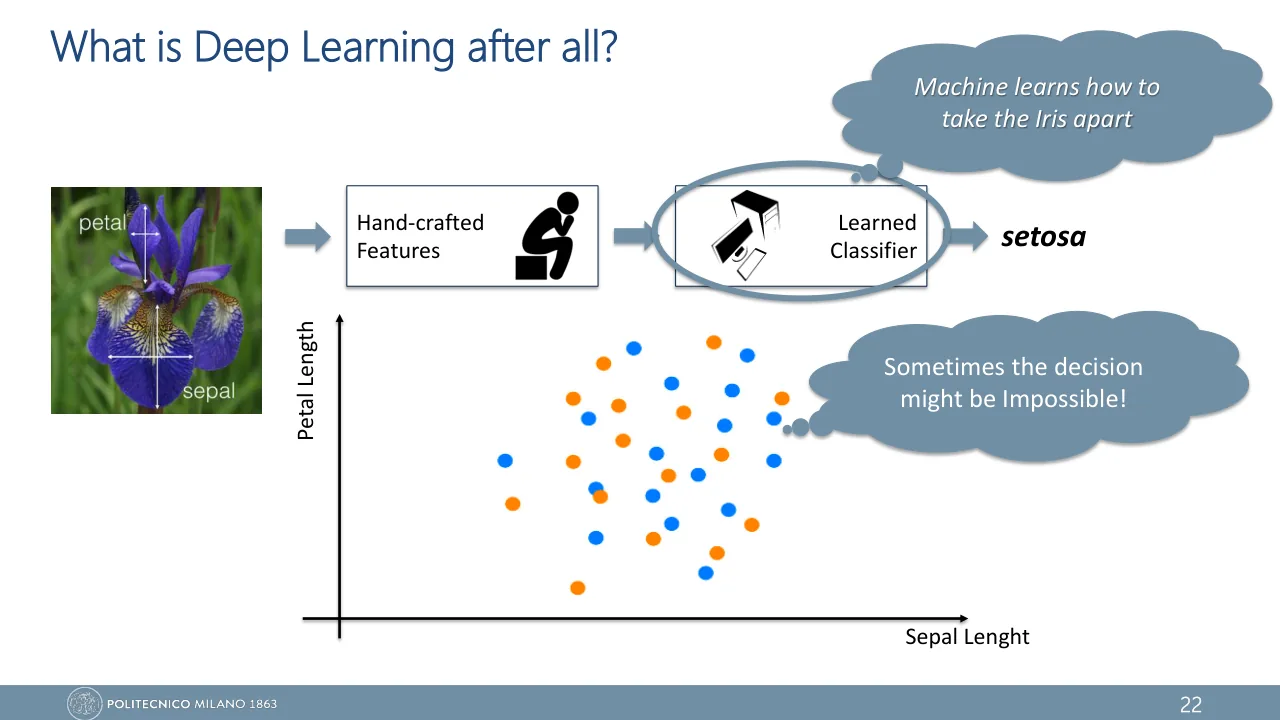
Сцена 3: границы нет
На третьей картинке классы перемешаны. Подпись: "Sometimes the decision might be Impossible!" И тут же вторая, с обведённым блоком Hand-crafted Features: "This happens if you do not know which features to extract!!!"
Кривую границу лечит классификатор. Отсутствие границы лечат только признаки.
Точки на слайдах нарисованы от руки. Ниже настоящие цветки: все три сцены можно получить из одной таблицы, меняя только то, какие два числа видит классификатор.
Почему против двойников бессилен любой классификатор
В третьей задаче виджет показывает «предел: не меньше 11». Откуда берётся число, которое не зависит от классификатора? Из загадки про цветки № 57 и № 101.
-
Запишем, что делает конвейер. Признаки считает фиксированная функция \(\psi\), решение принимает классификатор \(g\) с весами \(\vb{w}\). Ответ конвейера на объект \(\vb{x}\):
\[ g\big(\psi(\vb{x}) \mid \vb{w}\big) . \]Классификатор получает \(\psi(\vb{x})\), а не \(\vb{x}\). Больше ни к чему у него доступа нет.
-
Возьмём цветки № 57 и № 101 и признаки «sepal length, sepal width»:
\[ \psi(\vb{x}_{57}) = \psi(\vb{x}_{101}) = (6.3,\ 3.3) \] \[ t_{57} \ne t_{101} \]Признаки совпали, а правильные ответы разные.
-
Функция от одинаковых аргументов даёт одинаковые значения. Какими бы ни были \(g\) и \(\vb{w}\):
\[ g\big(\psi(\vb{x}_{57}) \mid \vb{w}\big) = g\big(\psi(\vb{x}_{101}) \mid \vb{w}\big) . \]Один ответ на двоих при разных targets: минимум одна ошибка. Обучение весов этого не изменит, потому что \(\psi\) от весов не зависит.
-
Обобщим. Пусть в точке \(\vb{z}\) пространства признаков стоят \(n_A(\vb{z})\) цветков класса A и \(n_B(\vb{z})\) цветков класса B. Лучшее, что можно сделать, — ответить за большинство. Тогда ошибок в этой точке \(\min(n_A, n_B)\), а по всей выборке не меньше, чем
\[ E_{\min} = \sum_{\vb{z}} \min\big(n_A(\vb{z}),\ n_B(\vb{z})\big) . \] -
Посчитаем для versicolor и virginica в координатах sepal length × sepal width. Общих точек десять: в (5.8, 2.7) стоят 2 и 2 цветка, в (6.7, 3.1) — 2 и 1, в (6.9, 3.1) — 1 и 2, в остальных семи — по одному.
\[ E_{\min} = 2 + 1 + 1 + 7 \cdot 1 = 11 . \]Одиннадцать ошибок из ста гарантированы ещё до того, как выбран классификатор.
-
Теперь добавим в \(\psi\) третий признак, petal width: у № 57 он равен 1.6, у № 101 — 2.5. Признаки перестали совпадать. Уже с этими тремя признаками (а с четырьмя тем более) в Iris не остаётся ни одной пары двойников разных видов: \(E_{\min} = 0\), ограничение исчезло.
Вывод: то, что потеряно в признаках, классификатор вернуть не может. Это можно только не терять.
А если двойников нет, но классы всё равно перемешаны?
Тогда гибкий классификатор может запомнить каждую точку обучающей выборки и не ошибиться на ней ни разу. Но это память, а не правило: новый цветок попадёт между чужими точками, и ответ окажется почти случайным. Общий факт звучит так: признаки \(\psi(\vb{x})\) не могут содержать больше информации о target, чем сами данные \(\vb{x}\). В теории информации это data processing inequality. Если по выбранным признакам классы распределены одинаково, никакой классификатор не превзойдёт стратегию «всегда называть более частый класс». Как честно измерять ошибку на новых объектах — тема урока 18.
Те же точки в других координатах
Вернёмся к сцене 2. Гибкий классификатор — не единственный выход. Можно оставить самый простой классификатор, прямую, и поменять то, что он видит.
Точки внутри круга и точки снаружи отличаются одним: расстоянием до центра. Запишем в анкету вместо \((x_1, x_2)\) расстояние \(\rho\) и угол \(\varphi\). Окружность превратится в вертикальную прямую \(\rho = r\).
До: координаты \((x_1, x_2)\)
После: координаты \((\rho, \varphi)\)
Представление (representation) — способ записать объект числами, то есть выбранный набор признаков. Сменить представление значит сменить \(\psi\). Одни и те же объекты в разных представлениях дают задачи разной трудности.
Того же можно добиться без углов. Уравнение окружности нелинейно по \(x_1, x_2\), но линейно по их квадратам:
\[ x_1^2 + x_2^2 = r^2 \]
\[ w_0 + w_1 u + w_2 v = 0 \]
- \(u,\ v\)
- новые признаки: \(u = x_1^2\), \(v = x_2^2\)
- \(w_1,\ w_2\)
- веса прямой в новых координатах, здесь оба равны 1
- \(w_0\)
- bias (так его обозначает профессор), здесь \(w_0 = -r^2\)
Вторая строка — уравнение прямой на плоскости \((u, v)\). Окружность никуда не делась, просто в новых координатах она выглядит как прямая. Посмотри, как это происходит.
Из Applied Statistics ты знаешь PCA. Это тоже смена представления, но линейная: сдвиг, поворот осей и масштаб. Виджет показывает, почему здесь её мало: при повороте прямые остаются прямыми, а кольцо кольцом. Квадраты сработали потому, что они нелинейны.
Кто догадался взять именно квадраты? Человек, который посмотрел на картинку. С двумя числами это несложно. А когда объект — фотография в миллион пикселей, смотреть некуда, и начинаются проблемы, которые конспект перечисляет на стр. 24: нужен эксперт в предметной области, это долго, признаки могут упустить важное, они хрупкие и плохо переносятся на другую задачу.
«Зато learned features переносятся на новые задачи». В конспекте (стр. 24) среди их преимуществ так и стоит: "transferable to new tasks or domains", без условий. На экзамене пиши осторожнее: выученные признаки оптимизированы под свою задачу. Перенос на другую работает, когда задачи родственные и данных достаточно, а не всегда.
Как распознавали до 2012 года
Слайд 24 лекции 1 называется "Modern Pattern Recognition". На нём две системы, лучшие в мире до прихода deep learning: speech recognition (early 90's – 2011) и object recognition (2006 – 2012). Обе — конвейеры из нескольких блоков, и под каждым блоком подписано, откуда взялись его параметры. Подписей три.
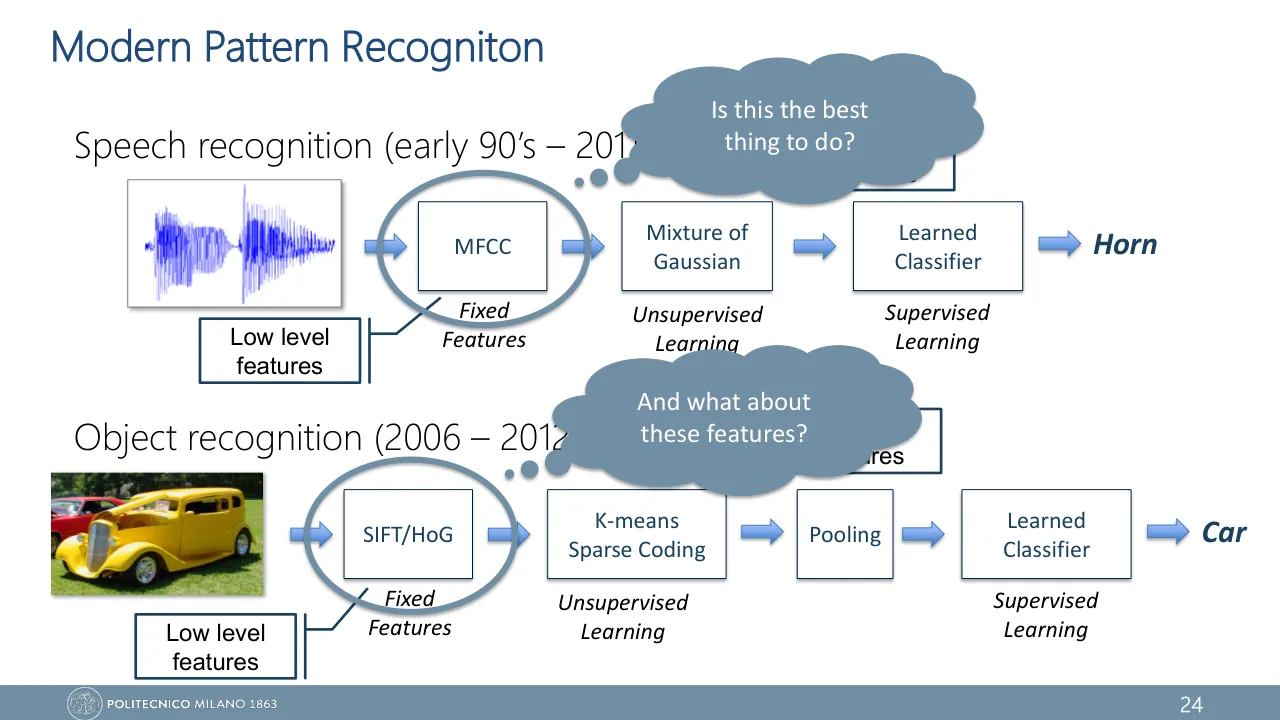
- Fixed features (low-level features): формула, написанная человеком. В ней ничего не учится.
- Unsupervised learning (mid-level features): параметры подобраны по данным, но без меток. Блок не знает, для какой задачи старается.
- Supervised learning (learned classifier): единственный блок, который видит target \(t_n\) и учится на ошибках.
Звук → MFCC → Mixture of Gaussian → Learned Classifier → «Horn».
MFCC — фиксированный рецепт: звук режут на короткие кадры, для каждого считают спектр, пропускают его через набор фильтров, расставленных так, как слышит ухо, берут логарифм и ещё одно преобразование. На выходе около 13 чисел на кадр. Каждый шаг — знание человека о речи и слухе, а не результат обучения.
Mixture of Gaussian — смесь гауссиан (GMM), подогнанная к этим векторам без меток: она описывает, какими «облаками» ложатся кадры в пространстве MFCC. И только классификатор в конце учится с метками и выдаёт слово.
Конспект (стр. 25) называет, что стояло на месте классификатора: Hidden Markov Model (HMM). Слово — это последовательность звуков. За их порядок во времени отвечала HMM, а смесь гауссиан оценивала, насколько один короткий кадр подходит каждому состоянию этой модели (грубо говоря, кусочку звука). Отсюда название таких систем: GMM-HMM.
Фото → SIFT / HoG → K-means / Sparse Coding → Pooling → Learned Classifier → «Car».
SIFT и HoG — фиксированные формулы: маленький кусочек картинки описывается гистограммой направлений, в которых меняется яркость. SIFT даёт 128 чисел на кусочек; HoG для фрагмента 64 × 128 пикселей — вектор из 3780 чисел.
Дальше знакомый по уроку 2 K-means. Дескрипторы со всех обучающих картинок кластеризуют, центры кластеров называют visual words. Картинка превращается в гистограмму: сколько раз в ней встретилось каждое «слово» — это шаг Pooling, тоже фиксированная операция. Метки классов до этого места не использовались ни разу. Их видит только последний блок, обычно SVM.
Представь завод из трёх цехов, которые друг с другом не разговаривают. Первый работает по инструкции, написанной раз и навсегда. Второй раскладывает детали по похожести, не зная, что из них соберут. Жалобы покупателей слышит только третий. Что бы ни пошло не так, первые два цеха об этом не узнают.
К первому блоку обоих конвейеров профессор задаёт два вопроса: "Is this the best thing to do?" и "And what about these features?" Конспект (стр. 26) разворачивает их в четыре ограничения:
- Domain expertise required: чтобы придумать MFCC или SIFT, нужны годы работы специалистов по речи и зрению.
- Task specific: признаки, сделанные для звука, бесполезны для картинок. Точнее было бы сказать, что они фиксированы и потому не подстроены ни под одну конкретную задачу.
- Brittleness: шум, освещение, масштаб, акцент диктора ломают то, что человек не предусмотрел.
- Limited expressiveness: данных становится больше, а точность упирается в потолок. Выучить из новых данных лучшие признаки конвейер не может.
«До deep learning признаки не учились». Учились: mid-level features подбирались по данным. Но без меток и без сигнала от задачи. Новым в deep learning стало не само обучение признаков, а то, что их учит ошибка на выходе.
Deep learning: анкету составляет машина
Слайд 25 лекции 1 меняет в конвейере одну табличку: вместо Hand-crafted Features стоит Machine Learned Features. Оси графика теперь подписаны "Learned feature", и классы снова разделяет прямая. Две подписи: у блока признаков — "Optimized for the task!", у классификатора — "Easier to learn!".
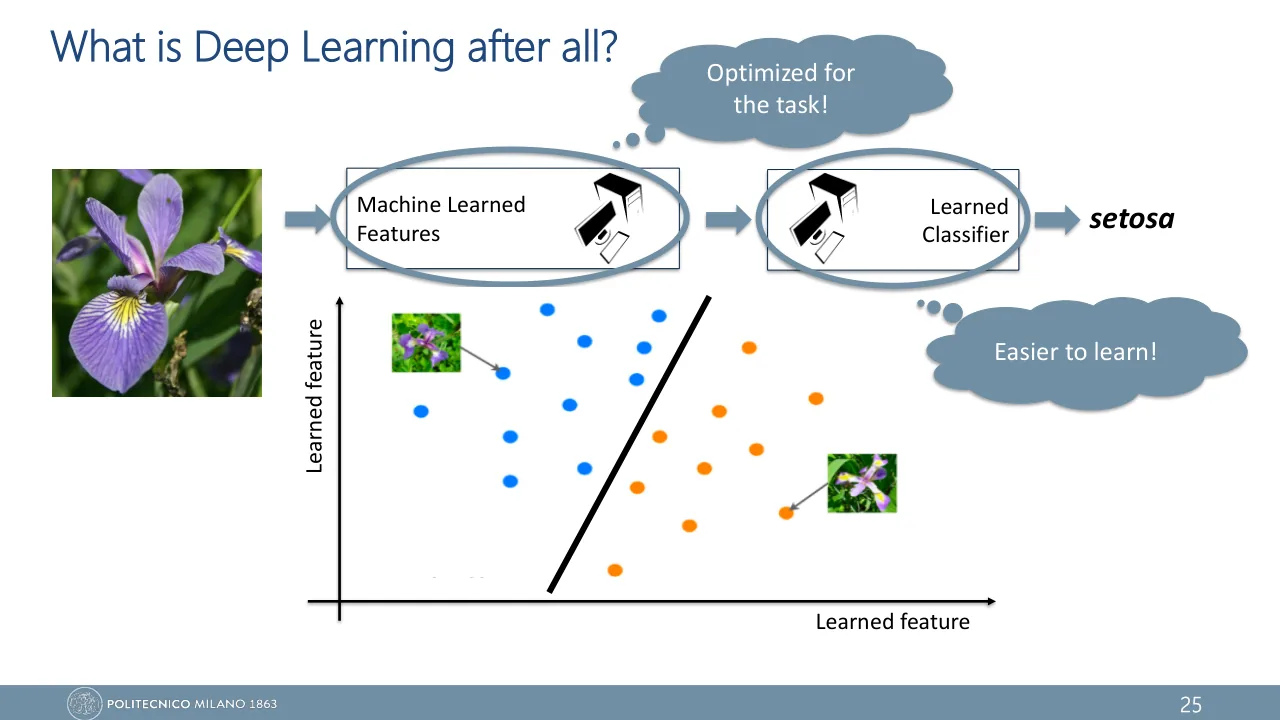
Learned features — признаки, которые модель сама выучивает из raw data во время обучения (конспект, стр. 24). Что измерять, заранее не решал никто: это подбирается по данным так же, как веса классификатора.
\(g\big(\psi(\vb{x}_n) \mid \vb{w}\big)\)
Функцию \(\psi\) написал человек. Обучение подбирает только веса классификатора. Ошибка на выходе до \(\psi\) не доходит.
\(g(\vb{x}_n \mid \vb{w})\)
На входе raw data. И признаки, и классификатор — слои одной модели. Обучение подбирает все веса сразу.
Внутри модели стоит цепочка слоёв. Каждый берёт то, что выдал предыдущий, и строит из этого новое представление:
\[ \vb{h}^{(1)} = h^{(1)}\big(\vb{x},\ W^{(1)}\big) \]
\[ \vb{h}^{(l)} = h^{(l)}\big(\vb{h}^{(l-1)},\ W^{(l)}\big) \]
\[ \vb{w} = \big\{ W^{(1)}, \dots, W^{(L)} \big\} \]
- \(\vb{x}\)
- raw data на входе
- \(\vb{h}^{(l)}\)
- выход слоя \(l\): представление, построенное из предыдущего
- \(W^{(l)}\)
- веса слоя \(l\); их находит обучение
- \(\vb{w}\)
- все веса сети разом
- \(g(\vb{x} \mid \vb{w})\)
- выход последнего слоя, то есть всей сети
Последние слои играют роль классификатора, все предыдущие — роль признаков. Но границы между ними никто не проводит: у сети одна error function \(E(\vb{w})\), которая сравнивает выход с target. Например, Sum of Squared Errors, о которой будет урок 13:
\[ E(\vb{w}) = \sum_{n=1}^{N} \big( t_n - g(\vb{x}_n \mid \vb{w}) \big)^2 \]Обучение уменьшает \(E\), меняя все \(W^{(l)}\) одновременно. Как сигнал ошибки добирается от выхода до первого слоя, объясняет алгоритм backpropagation — это урок 14. В конспекте (стр. 28) сказано так: "both parts, the feature extractor and the decision function, are learned jointly through backpropagation".
Каждый слой — ещё одна смена координат, как квадраты в виджете с кольцом. Разница в том, что параметры этой смены не угаданы человеком, а выучены. Слайды 26 и 36 показывают, что получается в сети для картинок. Слайд 36 подводит итог лекции: он называется "It's all about features ...", а цепочка из трёх блоков Learned Features и одного Learned Classifier подписана "Deep Learning (2012 – ...)".
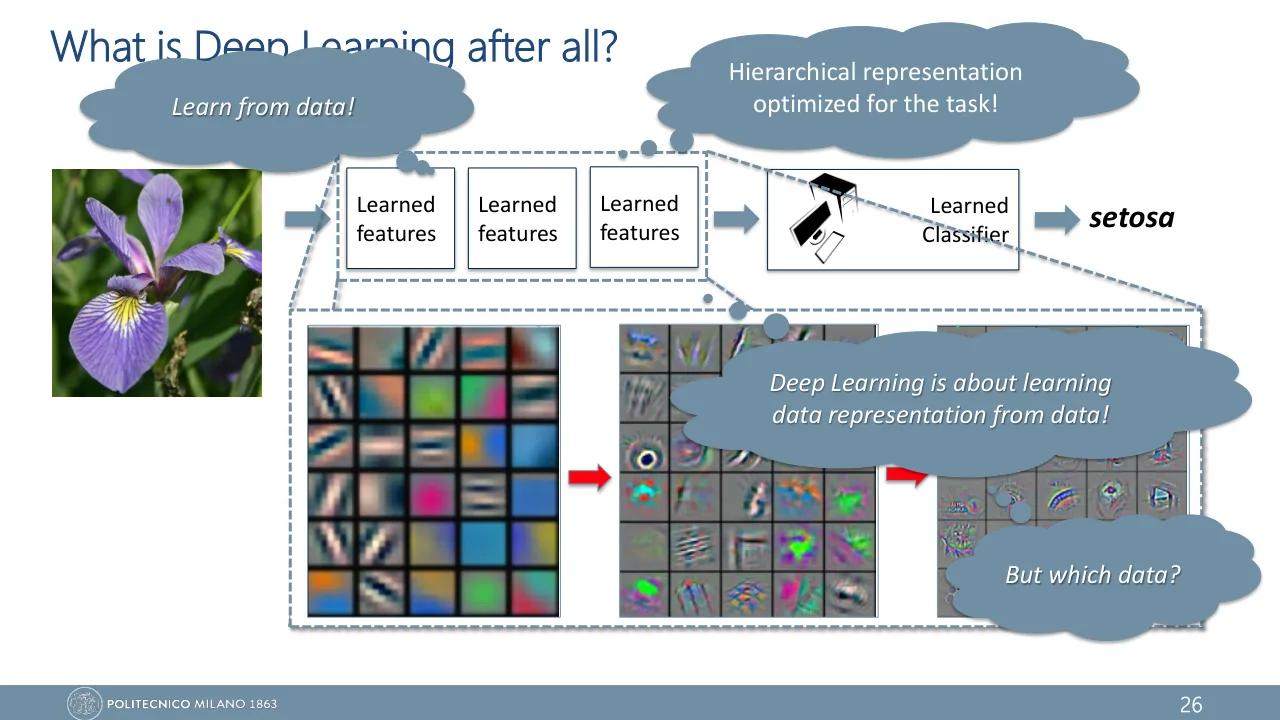
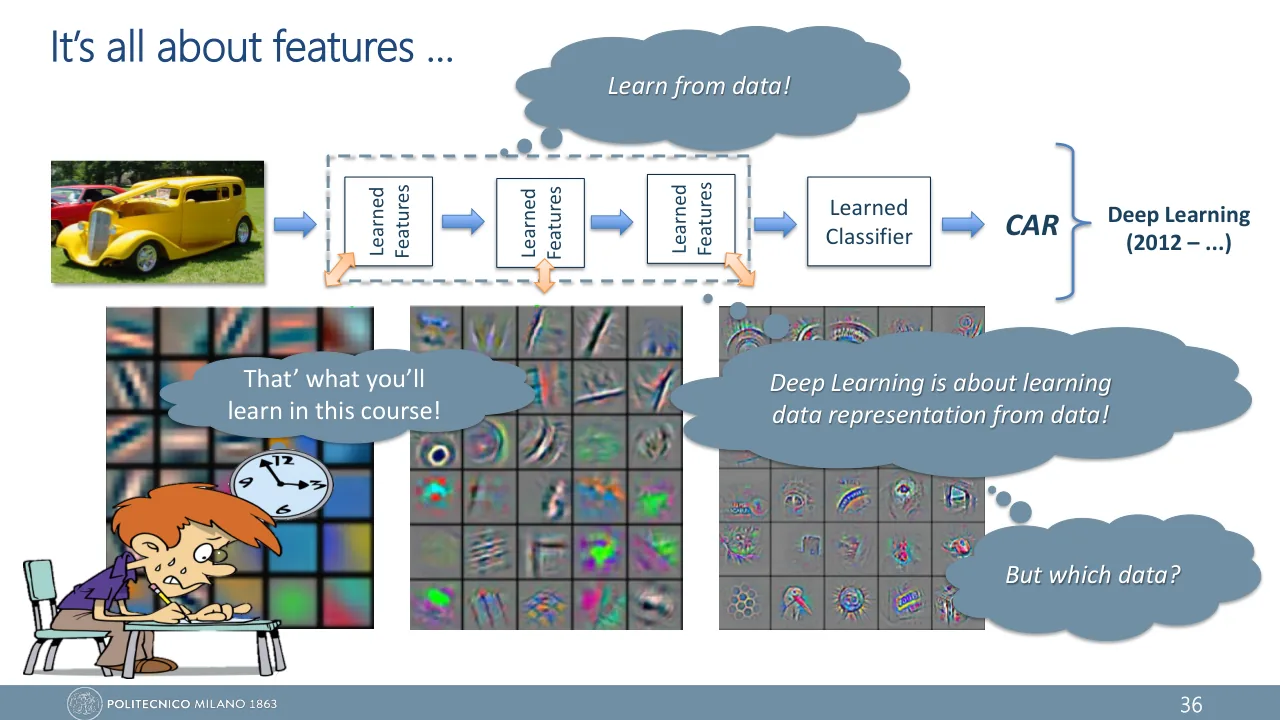
Deep learning — формулировка конспекта (стр. 28): "the automatic learning of hierarchical data representations and decision functions directly from raw data". Формулировка профессора (слайды 26 и 36 лекции 1): "Deep Learning is about learning data representation from data!"
За определением стоят три идеи, и каждую надо уметь расшифровать.
- Hierarchical: представление слоя \(l\) строится из представления слоя \(l - 1\). Одни и те же края служат деталями для многих частей, одни и те же части — для многих объектов.
- From raw data: на входе пиксели или звуковая волна, а не числа, выбранные экспертом.
- Jointly, или end-to-end: признаки и классификатор учатся вместе, одним сигналом ошибки. Отсюда "optimized for the task".
«Deep learning — это более мощный классификатор». Наоборот: последний блок глубокой сети обычно очень простой, часто линейный. Весь выигрыш в представлении, которое он получает на вход: в нём классы уже лежат по разные стороны прямой, как на слайде 25 лекции 1.
И ещё два похожих заблуждения. «Глубокая» не значит «с большим числом параметров»: deep — это много последовательных выученных преобразований. И человек из процесса не исчез: он по-прежнему выбирает архитектуру, error function и данные. Исчезло только ручное проектирование признаков.
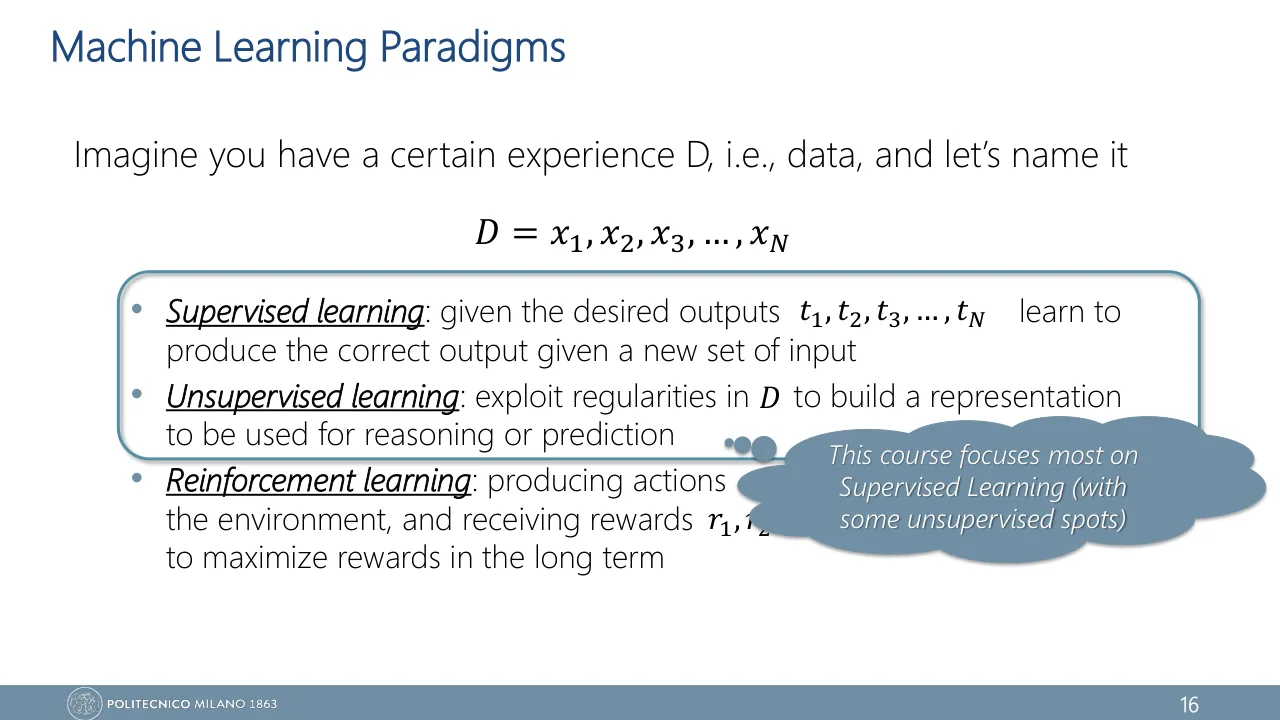
Последнее уточнение про слова. Deep learning — не четвёртая парадигма рядом с supervised, unsupervised и reinforcement learning. Это способ строить модель, и он работает внутри любой из трёх. В этом курсе, как сказано на слайде 16, почти всё время внутри supervised learning.
Вернёмся к двум цветкам
Цветки № 57 и № 101 были неразличимы не потому, что классификатор слаб, а потому, что в анкете не оказалось нужной графы. Никакое обучение классификатора не добавит в анкету вопрос, которого в ней нет.
До 2012 года анкету составляли люди. Удачная превращала задачу в сцену 1, неудачная — в сцену 3, и узнать об этом можно было только после того, как система построена. Deep learning отдаёт составление анкеты той же процедуре, которая учит классификатор. Если двум разным цветкам достались одинаковые признаки и из-за этого случилась ошибка, сигнал ошибки дойдёт до слоёв, которые эти признаки считают, и изменит их.
Deep learning учит не только решать по признакам, но и сами признаки — из данных и под задачу.
В формате экзамена
In the traditional pipeline "hand-crafted features + learned classifier", the chosen features can make a classification task easy, complex or impossible. Describe the three cases and say, for each, which part of the pipeline has to change.
Show model answer
Easy: in the chosen feature space the classes are linearly separable, so a simple (linear) classifier is enough; nothing has to change.
Complex: the classes do not overlap, but the boundary between them is non-linear (e.g. one class surrounded by the other). The features are still informative; a more flexible classifier is needed (nearest neighbours, RBF SVM, trees), or equivalently a non-linear change of representation.
Impossible: the classes overlap in feature space, in the extreme case different-class samples have identical feature vectors. The classifier only sees the features, so no classifier can separate them; the features must be changed. This happens when we do not know which features to extract, and it is what motivates learning the features from data.
Проверяют, что ты различаешь две поломки: кривую границу (лечит классификатор) и отсутствие границы (лечат признаки). Ответ в духе конспекта («простые признаки, сложные признаки») расходится со слайдами 19–23 лекции 1: там сложным названо решение, а не признаки. Хорошо звучит фраза профессора: "this happens if you do not know which features to extract".
Sketch the object-recognition pipeline used between 2006 and 2012. For each stage say whether it is fixed, learned without labels or learned with labels. What does deep learning change, and why can a better classifier not compensate for bad features?
Show model answer
Image → SIFT / HoG (low-level features, fixed, hand-designed) → K-means or sparse coding (mid-level features, unsupervised learning) → pooling (fixed) → classifier, e.g. an SVM (supervised learning) → label.
Only the last stage is trained with the labels; the error made at the output never reaches the first stages, so the features are not optimised for the task.
Deep learning replaces the fixed and unsupervised stages with layers of learned features that are trained jointly with the classifier by backpropagation, directly from raw data. The result is a hierarchical representation optimised for the task, which also makes the final classifier easier to learn.
A classifier receives only the feature vector. Information about the class that the features discarded cannot be recovered: if samples of different classes are mapped to the same features, every classifier gives them the same answer.
В ответе должны быть три подписи под блоками (fixed / unsupervised / supervised) и слово jointly: это то, чем слайд 24 лекции 1 отличается от слайда 36 лекции 1. Блок Pooling часто забывают; на слайде под ним подписи нет, но обучаемых параметров в нём тоже нет, так что fixed — честный ответ. Для речи ответ устроен так же: MFCC → Mixture of Gaussian → classifier.
Two classes, A and B, are described by two features. In the training set exactly four feature vectors are shared by samples of both classes: \(\vb{z}_1\) by 2 samples of A and 2 of B, \(\vb{z}_2\) by 2 of A and 1 of B, \(\vb{z}_3\) by 1 of A and 2 of B, \(\vb{z}_4\) by 1 of A and 1 of B. What is the minimum number of training errors that any classifier using only these two features must make?
Show model answer
Samples with the same feature vector receive the same prediction, so at each shared vector at least the minority is misclassified:
\[ E_{\min} = 2 + 1 + 1 + 1 = 5 \]This bound does not depend on the classifier; it can only be lowered by changing the features.
Числа взяты из настоящего Iris (versicolor и virginica, sepal length × sepal width). Ловушка — сложить всех «двойников» (их 12) или посчитать число точек (4). Считается меньшинство в каждой точке.
A linear classifier works on the engineered features \(u = x_1^2\) and \(v = x_2^2\). It outputs class A if \(w_0 + w_1 u + w_2 v \gt 0\), with \(w_1 = w_2 = 1\) and bias \(w_0 = -1.21\). Compute the value of \(w_0 + w_1 u + w_2 v\) for the input \(\vb{x} = (0.9,\ -0.7)\).
Show model answer
\[ u = 0.81, \quad v = 0.49 \]
\[ -1.21 + 0.81 + 0.49 = 0.09 \]
The value is positive, so the point is assigned to class A: it lies just outside the circle \(x_1^2 + x_2^2 = 1.21\) of radius 1.1. The boundary is a circle in \((x_1, x_2)\) and a straight line in \((u, v)\).
Проверяют две вещи: что признак считается до классификатора (минус при возведении в квадрат исчезает) и что bias \(w_0\) входит в сумму со своим знаком.
Which of the following statements about deep learning are correct? Select all that apply.
Show model answer
Correct: the first and the third. Deep learning learns a hierarchy of representations and the decision function together, from raw data, with one error signal.
Четвёртый вариант — самая частая путаница: «учится по данным» ещё не значит «учится по ошибке задачи».
Give a one-sentence definition of deep learning and explain what "hierarchical" and "optimized for the task" mean in it.
Show model answer
Deep learning is about learning data representations from data: a hierarchy of features and the final decision function are learned automatically and jointly, directly from raw data.
Hierarchical: the model is a sequence of layers, and each layer builds its representation from the previous one (edges → parts → objects in vision).
Optimized for the task: the features are not designed by a human or learned separately without labels; their weights are adjusted by the same error signal that trains the classifier, so they keep exactly the information the task needs.
Первое предложение можно почти дословно взять у профессора. Дальше важны слова representation, jointly, raw data. Не пиши «это нейросети с большим числом параметров»: это не определение.
Проверь себя
На графике класс B лежит плотным пятном, класс A окружает его со всех сторон, между ними пустой зазор. Линейный классификатор ошибается на трети точек. Что достаточно поменять?
В обучающей выборке нашлось 8 пар цветков: в каждой паре виды разные, а значения двух выбранных признаков совпадают. Других совпадений нет. Что из этого следует?
Что верно про конвейер SIFT / HoG → K-means → Pooling → Learned Classifier?
Три подписи под блоками — fixed, unsupervised, supervised — главное, что надо унести со слайда 24 лекции 1.
К кольцу из виджета применили PCA и оставили обе главные компоненты. Сколько ошибок теперь у лучшей прямой?
Сеть состоит из трёх слоёв learned features и слоя learned classifier. Что означает, что они учатся jointly?
Что из перечисленного — raw data, а не hand-crafted features?
Что делает сеть «глубокой» в смысле этого урока?
Унести с собой
- Классификатор видит не объект, а его признаки. Два объекта с одинаковыми признаками получат одинаковый ответ при любом классификаторе.
- Три сцены профессора: классы делит прямая — хватает простого классификатора; граница кривая — нужен классификатор погибче; классы перемешаны — помогут только другие признаки.
- Нелинейная смена представления может превратить кривую границу в прямую: окружность \(x_1^2 + x_2^2 = r^2\) линейна по \((x_1^2, x_2^2)\). Поворот осей и PCA так не умеют.
- До 2012 года: fixed features → unsupervised learning → supervised classifier. Сигнал ошибки доходил только до последнего блока.
- Deep learning: признаки и классификатор — слои одной модели. Они учатся jointly одним сигналом ошибки из raw data, поэтому признаки образуют иерархию и оптимизированы под задачу.
- Фраза профессора для экзамена: "Deep Learning is about learning data representation from data".
Что посмотреть и почитать
-
A Visual Introduction to Machine Learning, Part 1
R2D3: Stephanie Yee, Tony Chu10 мин
Одна задача (дом в Сан-Франциско или в Нью-Йорке?) в движущихся точках: видно, как один выбранный человеком признак не справляется и как помогают другие. Репетиция трёх сцен с ирисами. Модель там — дерево решений, не нейросеть.
-
A Neural Network Playground
TensorFlow10–15 мин
Весь урок в трёх щелчках. Датасет Circle, ноль скрытых слоёв, входы X1 и X2: не разделяется. Включи входы X1² и X2²: разделилось, это feature engineering. Выключи их и добавь один скрытый слой из 3–4 нейронов: снова разделилось, это learned features.
-
Bag of Visual Words — 5 Minutes with Cyrill
Cyrill Stachniss≈ 5 мин
Средний блок конвейера 2006–2012 изнутри: как K-means превращает дескрипторы в visual words, а картинку — в гистограмму. Смотри сразу после виджета с конвейерами.
-
Feature Visualization
Olah, Mordvintsev, Schubert · Distill, 2017первый рисунок и два раздела
Настоящие картинки вместо схемы с рис. 4: что «видят» нейроны настоящей сети от первых слоёв к последним — края, текстуры, узоры, части, объекты.
-
Deep Learning, глава 1: Introduction
Goodfellow, Bengio, Courvilleпервые 11 страниц
Рекомендованный учебник курса. Там есть рисунок с одними данными в двух системах координат (наш рис. 3) и схема, сравнивающая классическое машинное обучение, representation learning и deep learning. Отсюда же удобно брать английские формулировки для экзамена.