Честный экзамен для модели
После этого урока ты разрежешь данные на training, validation и test set, скажешь, какое решение можно принимать по каждой части, прикинешь на калькуляторе, насколько шумит оценка на отложенных данных, и распознаешь data leakage.
В 2017 году на конференции ICLR вышла работа Zhang, Bengio, Hardt, Recht и Vinyals с неудобным экспериментом. Авторы взяли обычные свёрточные сети для распознавания картинок, а правильные метки картинок заменили случайными. Связь между картинкой и ответом исчезла: учить там больше нечего. Сети всё равно подогнались под обучающие примеры идеально.
Получается, ошибку на обучающих данных можно довести до нуля даже там, где знанию взяться неоткуда. Что же тогда она измеряет? И какое число честно скажет, как сеть поведёт себя на новых данных?
Короткий ответ — «проверяй на том, чего модель не видела». Но у такого экзамена есть три способа оказаться нечестным. К концу урока ты назовёшь все три.
Почему нельзя верить ошибке на обучающих данных
Представь подготовку к экзамену по «temi d'esame» прошлых лет. Ты решаешь одни и те же задачи, пока не перестаёшь в них ошибаться, а потом проверяешь себя — на них же. Десять из десяти. Это оценка памяти. О том, решится ли новая задача, она почти ничего не говорит.
С сетью всё ещё жёстче. Она не просто «видела» обучающие примеры: её веса подобраны так, чтобы ошибка именно на этих примерах стала как можно меньше. Ошибка на данных, по которым подбирали веса, называется training error (ошибка обучения).
Конспект показывает это на полиномах, знакомых по прошлому уроку: чем выше степень, тем гибче модель. Прежде чем смотреть на рисунок, реши. Модель степени 14 даёт training error 0.043, модель степени 3 — 0.069. Какую из двух стоит взять?
По training error побеждает степень 14. Но на новых точках она ошибается на 0.26, а степень 3 — на 0.18. Гибкая модель потратила свою гибкость на то, чтобы пройти через шум в обучающих точках, и за их пределами это только мешает.
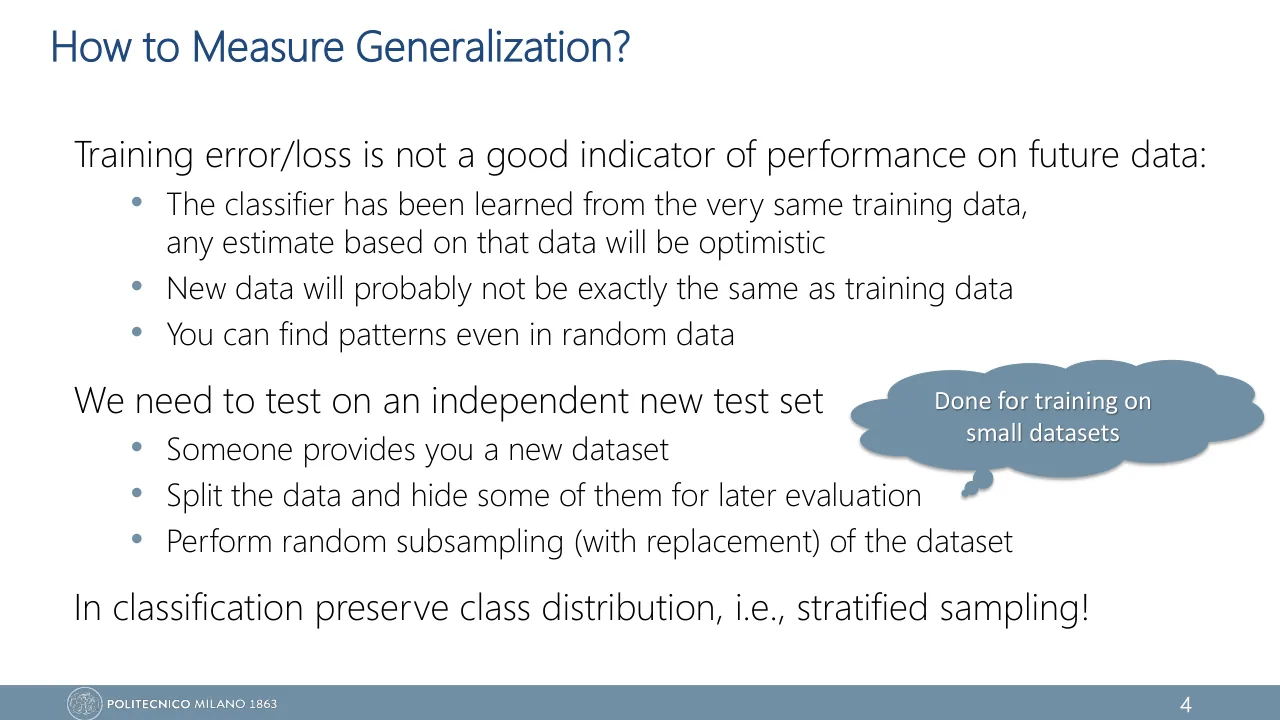
На слайде "How to Measure Generalization?" (лекция 3, слайд 4) этот вывод записан так: "Training error/loss is not a good indicator of performance on future data". Причин на слайде три. Первую конспект на стр. 132 делит на две, поэтому в списке ниже пунктов четыре.
- Модель видела эти данные. Веса оптимизировали ровно ту ошибку, которой теперь хотят измерить качество.
- Optimism bias. Оценка на данных, по которым подгоняли модель, смещена в приятную сторону — тем сильнее, чем модель гибче. На слайде эти два пункта — одна фраза: "The classifier has been learned from the very same training data, any estimate based on that data will be optimistic".
- Новые данные не повторят обучающие. На слайде: "New data will probably not be exactly the same as training data". После запуска придут другие точки из того же источника. Как модель ведёт себя между обучающими точками, training error не измеряет вовсе.
- Закономерности находятся даже в шуме. На слайде: "You can find patterns even in random data". Сети из загадки выучили случайные метки. Нулевая training error не доказывает, что в данных вообще было что учить.
То же самое строго
Нужны два числа. Первое мы умеем считать, второе — нет: ради его оценки и написан весь урок.
- \(t_n\)
- target: правильный ответ для примера \(n\)
- \(g(\vb{x}_n|\vb{w})\)
- выход сети с весами \(\vb{w}\); в конспекте он записан как \(f(x_i; w)\)
- \(N\)
- число примеров, по которым подбирали веса
- \(\E[\,\cdot\,]\)
- среднее по всем парам \((\vb{x}, t)\), которые вообще могут прийти из того же источника, включая те, которых в наборе нет
\(E_{\text{gen}}\) — это generalization error (ошибка обобщения); в конспекте она названа true risk, а \(E_{\text{train}}\) — empirical risk. Посчитать \(E_{\text{gen}}\) нельзя: всех возможных данных ни у кого нет. В уроке 17 те же две ошибки записаны как \(\hat E_{\text{train}}\) и \(E\); здесь у второй появился индекс, потому что ошибок скоро станет четыре.
Пусть \(D\) — случайный набор обучающих примеров: сегодня достались одни \(N\) штук, в другой раз достались бы другие. \(\hat{\vb{w}}\) — веса, которые обучение нашло на \(D\) (будем считать, что оно дошло до минимума \(E_{\text{train}}\)). \(\vb{w}^{*}\) — лучшие возможные веса, с наименьшей \(E_{\text{gen}}\). Их никто не знает, но они существуют.
-
Для любых весов, выбранных не глядя на \(D\), training error — честная оценка. Это среднее по \(N\) случайным примерам, и в среднем по всем возможным \(D\) оно попадает в цель:
\[ \E_D\bigl[E_{\text{train}}(\vb{w})\bigr] = E_{\text{gen}}(\vb{w}) \] -
Обучение выбирает веса как раз глядя на \(D\): берёт те, у которых training error наименьшая. Значит, она не больше, чем у любых других весов — в том числе у \(\vb{w}^{*}\):
\[ E_{\text{train}}(\hat{\vb{w}}) \le E_{\text{train}}(\vb{w}^{*}) \] -
Усредним обе части по всем \(D\). Веса \(\vb{w}^{*}\) от \(D\) не зависят, поэтому к правой части применим шаг 1:
\[ \E_D\bigl[E_{\text{train}}(\hat{\vb{w}})\bigr] \le E_{\text{gen}}(\vb{w}^{*}) \] -
С другой стороны, \(\vb{w}^{*}\) — лучшие веса по \(E_{\text{gen}}\). Никакие обученные веса их не превзойдут:
\[ E_{\text{gen}}(\vb{w}^{*}) \le E_{\text{gen}}(\hat{\vb{w}}) \] -
Склеим шаги 3 и 4 (шаг 4 тоже усредним по \(D\)):
\[ \E_D\bigl[E_{\text{train}}(\hat{\vb{w}})\bigr] \le \E_D\bigl[E_{\text{gen}}(\hat{\vb{w}})\bigr] \]Словами: среднее от минимума не больше минимума от среднего. Чем гибче модель, тем глубже она проваливается в минимум на шаге 2 и тем шире разрыв.
В среднем training error обученной модели не больше её настоящей ошибки — но только в среднем.
Три части данных — три разные работы
Раз проверять на обучающих примерах нельзя, нужны другие. На том же слайде (лекция 3, слайд 4) это следующая строка: "We need to test on an independent new test set". Способов получить такой набор там три.
- "Someone provides you a new dataset". Новые данные приносит кто-то другой. Так устроены соревнования: итог считают на примерах, которых участники не видели.
- "Split the data and hide some of them for later evaluation". Свои данные режут и часть прячут до проверки. Это hold-out, главный способ этого урока.
- "Perform random subsampling (with replacement) of the dataset". Примеры набирают случайно и с возвращением: вытянутый пример кладут обратно, и он может попасться ещё раз. На такой выборке модель учат, а проверяют на примерах, которые в неё не попали. В статистике это bootstrap; слайд его по имени не называет. Облачко рядом с этим пунктом: "Done for training on small datasets" — так делают, когда данных мало и прятать часть насовсем слишком дорого.
Последняя строка слайда — про классификацию: при любом разрезе нужно сохранять доли классов (stratified sampling). До неё дойдём в разделе про hold-out.
Дальше речь о втором способе: часть данных прячут от обучения. Спрятанное и оставшееся надо как-то называть. На слайде "Clearing the terms …" (лекция 3, слайды 5 и 10) терминов шесть, и многие отличаются одним словом. Перепутать их на экзамене легче всего. В кавычках ниже — формулировки слайда слово в слово.
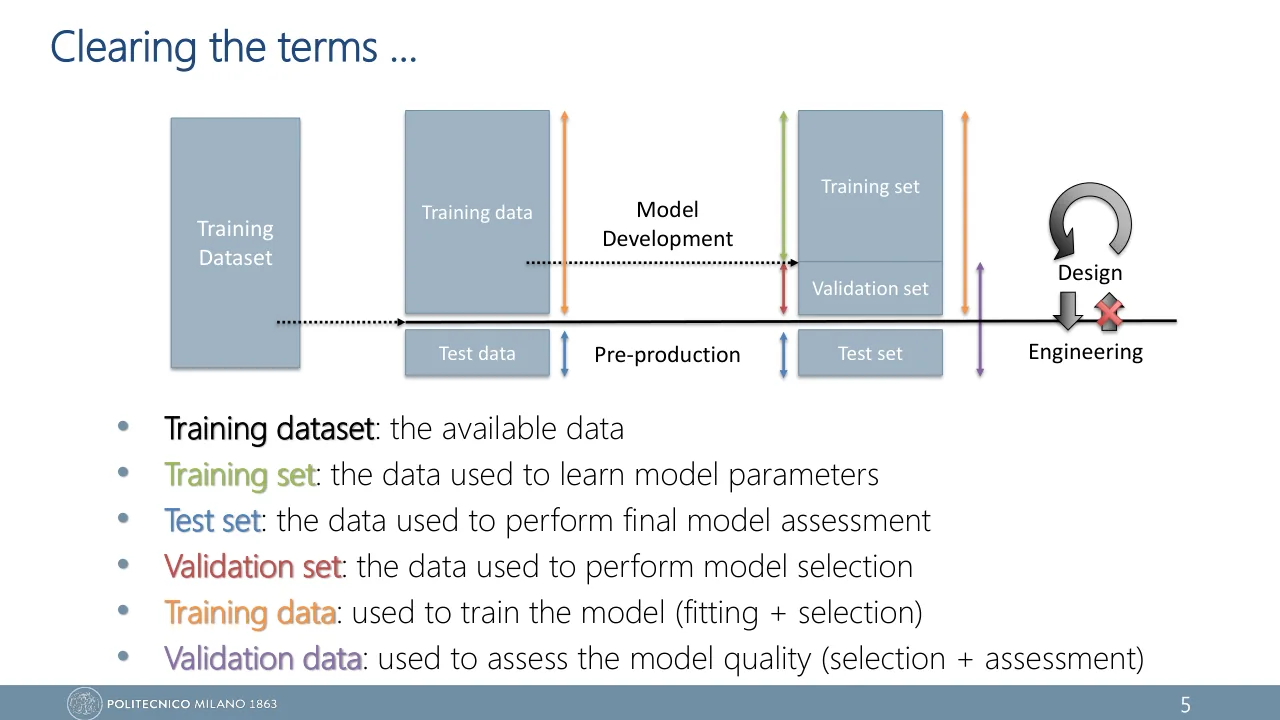
Training dataset — "the available data": весь набор размеченных примеров, который у нас есть, \(D = \{(\vb{x}_n, t_n)\}_{n=1}^{N}\). Конспект называет его ещё available dataset. Его разрезают на непересекающиеся части.
Training set — "the data used to learn model parameters": часть, по которой подбирают параметры модели, то есть веса и bias. Только её ошибка даёт градиент, только она двигает веса в gradient descent.
Validation set — "the data used to perform model selection": часть, по которой принимают решения о модели, не подставляя её в градиент. По ней выбирают гиперпараметры, сравнивают архитектуры, решают, когда остановить обучение.
Test set — "the data used to perform final model assessment": часть, по которой один раз, в самом конце, измеряют ошибку готовой модели. Ни одно решение от неё не зависит.
Training data — "used to train the model (fitting + selection)": всё, чем модель строят, то есть training set вместе с validation set.
Validation data — "used to assess the model quality (selection + assessment)": всё, чем проверяют качество, то есть validation set вместе с test set.
В метафоре с экзаменом: training set — решённые «temi d'esame», по которым учишься. Validation set — пробный экзамен: по нему решаешь, как готовиться дальше и когда остановиться. Test set — настоящий экзамен, и сдают его один раз.
У каждой части своя работа, и у каждой работы своё английское название: parameter fitting, model selection и model assessment. На слайде 5 они сокращены до fitting, selection и assessment; в конспекте на стр. 133 первая работа названа model fitting. Для набора из 1000 примеров и разреза 70 % / 15 % / 15 % получается так.
| Часть | Что по ней решают | Когда |
|---|---|---|
| training set | веса и bias | на каждом шаге обучения |
| validation set | гиперпараметры, архитектуру, момент остановки | много раз, пока идёт разработка |
| test set | ничего: по нему только измеряют | один раз, в конце |
На слайде "Clearing the terms …" те же части нарисованы в два приёма. Сначала training dataset делят на training data и test data. Потом training data делят на training set и validation set. Test data больше не режут: это и есть test set.
Подписи на схеме говорят, что и когда разрешено. Всё, что на рис. 3 левее пунктира (на слайде — выше черты), названо "Model Development" и "Design". Над словом "Design" нарисована круговая стрелка: модель здесь можно менять и перепроверять сколько угодно раз. Правее пунктира — "Pre-production" и "Engineering": готовую модель один раз проверяют на test data перед запуском. Стрелка из "Design" в "Engineering" на слайде есть, обратная перечёркнута красным крестом. После проверки на test set к подбору модели не возвращаются.
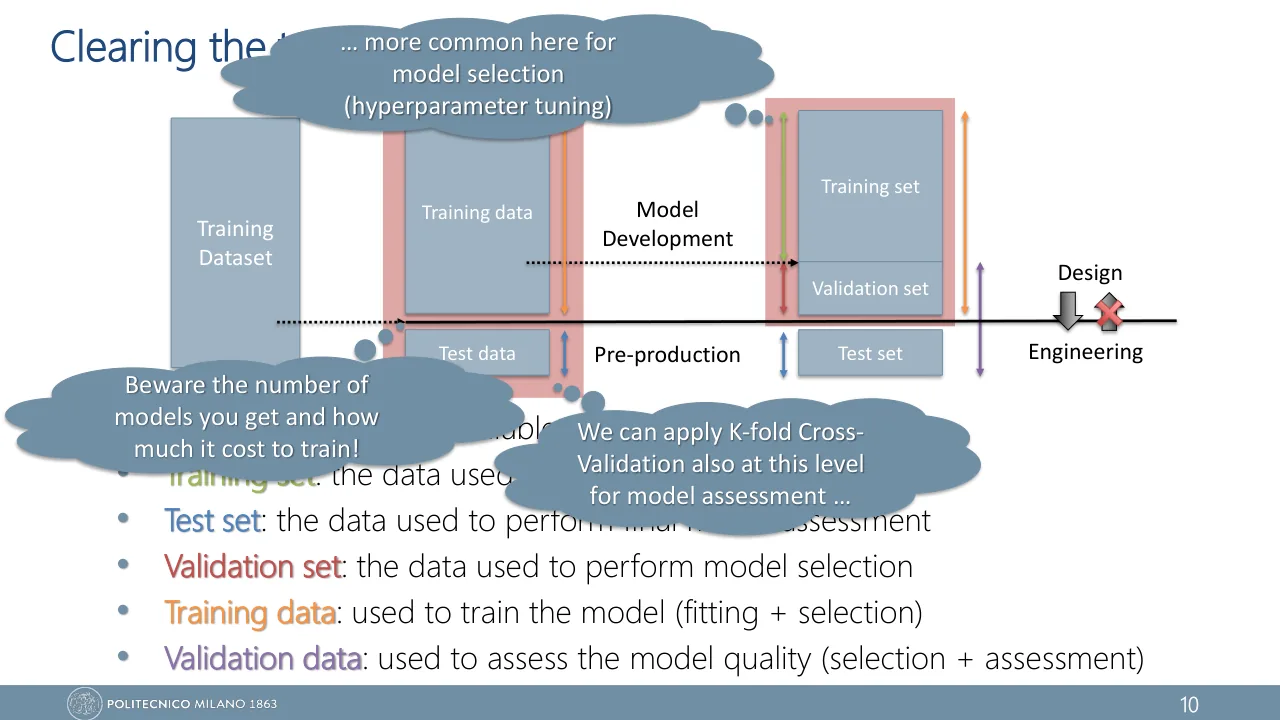
Слайд 10 повторяет эту схему и добавляет три облачка про K-fold cross-validation, которую разбирает урок 19. На первом разрезе, training data / test data, её можно применять "for model assessment". Чаще её применяют на втором, training set / validation set: "more common here for model selection (hyperparameter tuning)". Третье облачко предупреждает: "Beware the number of models you get and how much it cost to train!"
А что про training data и validation data написано в конспекте?
Определений этих двух слов в словаре конспекта на стр. 134–135 нет: там только четыре термина. А на стр. 133 написано «Training data → Model fitting, Validation data → Model selection, Test data → Model assessment», то есть «data» стоит там, где по словарю слайда 5 лекции 3 должно быть «set». По слайду у training data две работы, fitting + selection, и у validation data тоже две, selection + assessment.
Чтобы тебя поняли однозначно, в ответе называй части словом set, а работы — fitting, selection, assessment. Слова training data и validation data оставь для двух пар со слайда. Test data на схеме — то же самое, что test set: отдельной строки среди определений слайда у этой подписи нет.
Все три ошибки считаются по одной формуле и с одними и теми же весами. Меняется только то, по каким примерам идёт сумма.
- \(n \in \text{val}\)
- сумма только по примерам validation set; для \(E_{\text{train}}\) и \(E_{\text{test}}\) — по примерам своих частей
- \(N_{\text{val}}\)
- число примеров в этой части; у \(E_{\text{train}}\) на его месте \(N_{\text{train}}\) — то, что до разреза было просто \(N\)
На слайдах эти ошибки выглядят чуть иначе (лекция 3, слайд 16): \(E_\gamma^{\mathit{TRAIN}}\) и \(E_\gamma^{\mathit{VAL}}\). Название части стоит сверху, суммы идут до \(N_{\mathit{TRAIN}}\) и \(N_{\mathit{VAL}}\), а на число примеров не делят. Нижний \(\gamma\) и добавка к \(E_\gamma^{\mathit{TRAIN}}\) — регуляризация из урока 22.
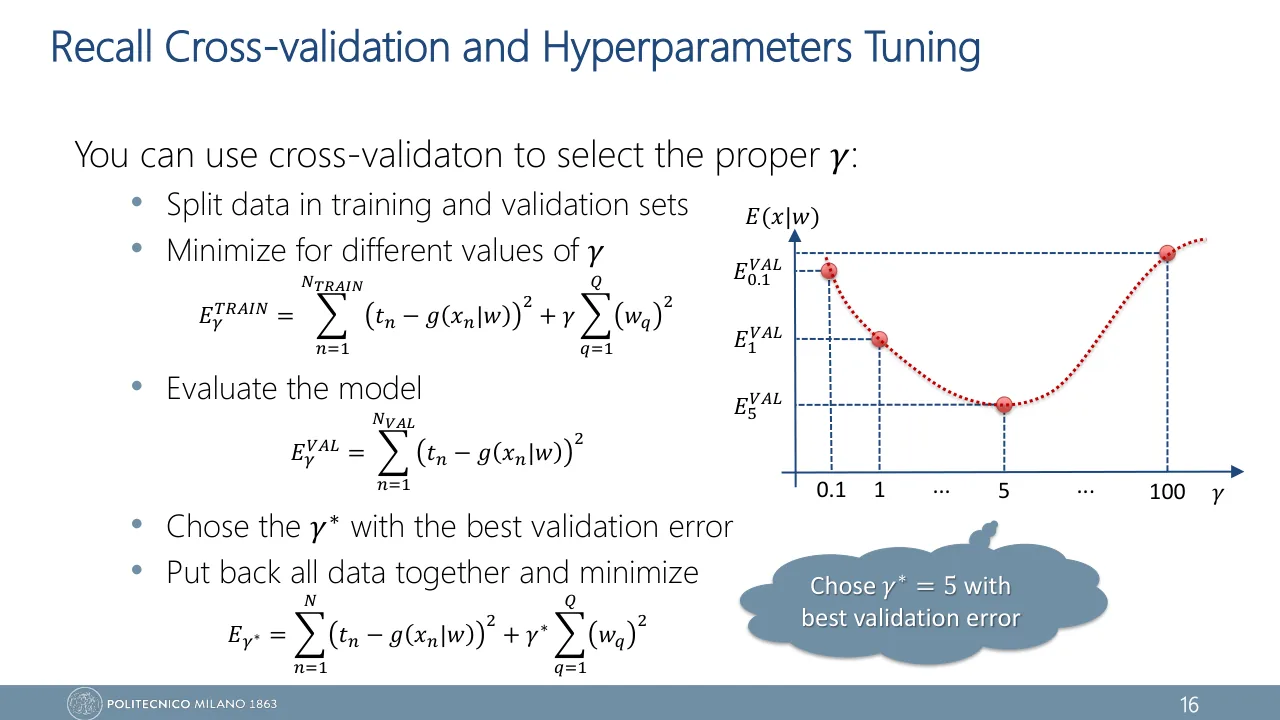
Конспект пишет все три суммы «от \(i = 1\)», и из-за этого не видно главного: наборы индексов разные и не пересекаются. Градиент берут только от \(E_{\text{train}}\). Две другие ошибки только вычисляют.
Отсюда и разница между параметрами и гиперпараметрами (hyperparameters). Параметры — веса — подбирает gradient descent по training set. Гиперпараметры — learning rate \(\eta\), число скрытых нейронов, силу регуляризации, dropout rate, число эпох — выбираешь ты, сравнивая validation error разных вариантов. Подробно о них — в уроке 21.
Обычно \(E_{\text{val}}\) считают после каждой эпохи и рисуют рядом с \(E_{\text{train}}\). Если первая начала расти, пока вторая продолжает падать, сеть переобучается: на этом наблюдении построен early stopping из урока 20.
Зачем test set, если уже есть validation set
Кажется, что validation set тоже «невиданный»: в градиент он не попадал. Но посмотри, что с ним делают. Ты обучаешь двадцать вариантов сети, у каждого своя validation error, и берёшь вариант с наименьшей. Каждое из двадцати чисел — оценка с шумом. Наименьшее оказалось наименьшим отчасти потому, что модель хороша, а отчасти потому, что ей повезло именно с этими 150 примерами.
Это тот же механизм, что в выводе выше: минимум из шумных оценок в среднем занижен. Выбор — тоже подгонка, только подгоняют не веса, а гиперпараметры. Поэтому validation error выбранной модели оптимистична, и для итоговой оценки нужна третья часть, которая не участвовала вообще ни в чём. Только для неё \(E_{\text{test}}\) — несмещённая оценка \(E_{\text{gen}}\): шумная, но без систематического сдвига.
Training set учит веса, validation set выбирает модель, test set только измеряет — один раз.
«Validation set не влияет на веса». Напрямую — нет. Косвенно — да: от него зависят выбранная архитектура, learning rate и эпоха, на которой обучение остановили (урок 20), а от них зависят итоговые веса. Именно поэтому validation error — не чистая оценка того, как модель обобщает.
Hold-out: один разрез и его цена
Самый простой способ получить две или три части — отложить (hold out) куски данных один раз и больше разрез не менять. И слайды, и конспект открывают этим методом тему cross-validation: так называют любое использование training dataset сразу для двух дел — обучить модель (fitting и selection) и оценить её ошибку на новых данных. На слайде (лекция 3, слайд 6) это одна фраза: "Cross-validation is the use of the training dataset to both train the model (parameter fitting + model selection) and estimate its error on new data". В одном разрезе части ролями не меняются, так что слово cross здесь взято на вырост: ротация начнётся в уроке 19.
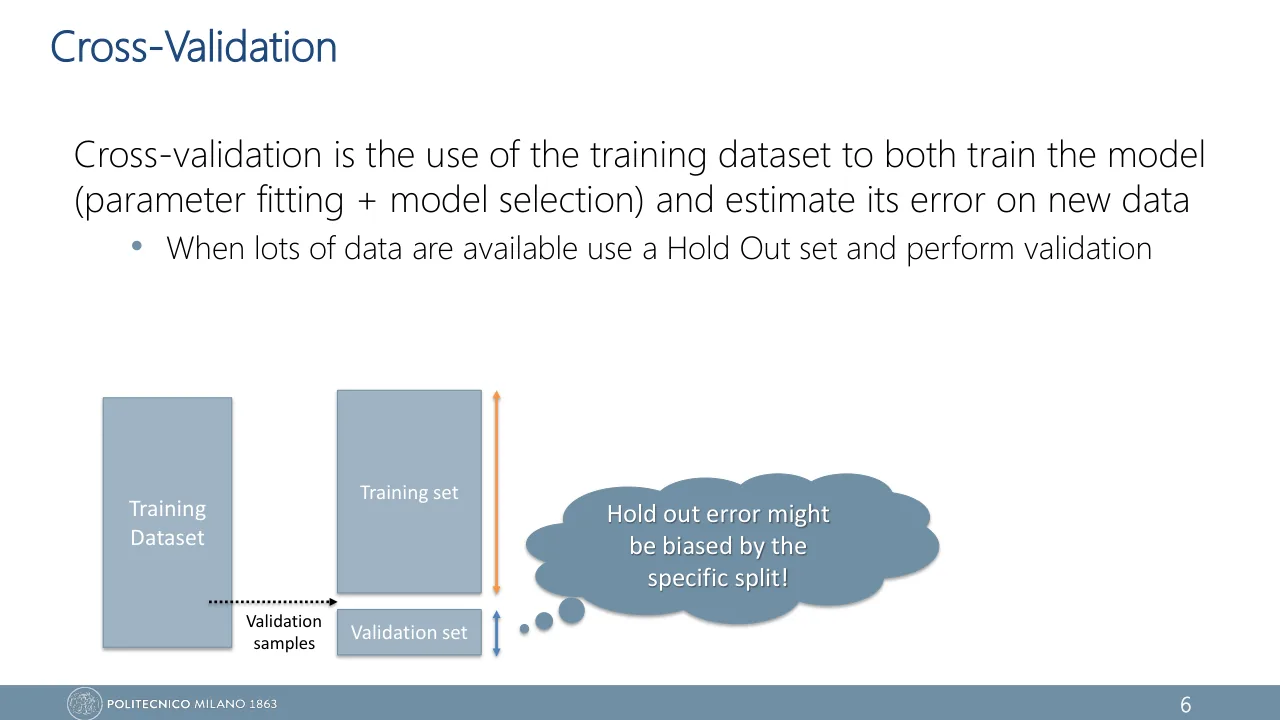
Первый пункт под определением на слайде — про наш метод: "When lots of data are available use a Hold Out set and perform validation". Рецепт hold-out из конспекта:
- перемешать training dataset;
- разрезать, например 70 % / 15 % / 15 %;
- обучать на training set;
- настраивать по validation set: гиперпараметры, early stopping;
- один раз измерить ошибку на test set.
Конспект называет это «miniature deployment test»: репетиция запуска на данных, которые играют роль будущих. На схеме слайда 5 (рис. 3) та же мысль записана одним словом: у test data стоит подпись "Pre-production". Заодно это первая практическая проверка inductive hypothesis из прошлого урока — и здесь в конспекте оговорка.
Какую часть считать «отложенной»? На слайде 6 это validation set: на рисунке training dataset разрезан на training set и validation set, а стрелка разреза подписана "Validation samples". Конспект на стр. 137 подписывает словом hold-out именно test set, а на стр. 138 разбирает риски для validation set. В этом уроке отложенная часть — любая, которую не показали обучению: всё сказанное ниже про шум и смещение верно для обеих.
Сколько шума в одном числе
Оценка на отложенной части — среднее по конечному числу примеров, поэтому она шумит. Для классификатора шум легко посчитать. Каждый отложенный пример — бросок монеты «ошибся / не ошибся» с вероятностью ошибки \(p\). Доля ошибок на \(n\) примерах колеблется вокруг \(p\) со стандартной ошибкой, знакомой по Applied Statistics:
- \(p\)
- настоящая доля ошибок модели, её generalization error
- \(n\)
- число отложенных примеров, по которым считают оценку
Пусть модель ошибается в 10 % случаев. На 150 отложенных примерах \(\text{SE} = \sqrt{0.1 \cdot 0.9 / 150} \approx 0.024\), то есть 2.4 процентного пункта. Примерно в 95 % случаев измеренная ошибка лежит в пределах \(\pm 2\,\text{SE}\): где-то между 5 и 15 %. На 1000 примерах SE падает до 0.95 пункта, на 10 000 — до 0.3.
Следствие для выбора модели: две сети, которые различаются на 2 пункта, на 150 примерах надёжно не различить. Разница меньше одной стандартной ошибки.
Чтобы уменьшить шум вдвое, отложенных примеров нужно вчетверо больше: \(n\) стоит под корнем. На экзамене это считается в одну строку.
Две ошибки самой оценки
У оценки, как у любой статистики, есть разброс и смещение. Variance: число зависит от того, какие именно примеры попали в отложенную часть, и разброс растёт, когда эта часть мала. Bias: модель обучена не на всех данных, а только на их части, и поэтому обычно чуть хуже той, которую в итоге обучат на всём. Оценка смещена в пессимистичную сторону.
Про первую из этих ошибок на слайде есть облачко (лекция 3, слайд 6): "Hold out error might be biased by the specific split!" Запомни фразу как она есть: так на слайде назван недостаток hold-out. Слово biased в ней бытовое: число перекошено тем, какие примеры случайно попали в отложенную часть. Другой разрез перекосит его в другую сторону, поэтому на языке статистики это variance, а bias — только систематический сдвиг. В развёрнутом ответе приведи фразу слайда и сразу расшифруй её этими двумя словами.
Конспект собирает это в четыре риска (стр. 138): отложенная часть случайно оказалась непохожей на все данные, и оценка завышена или занижена; данных мало; классы несбалансированы; результат зависит от одного-единственного разреза. Второй риск — это дилемма.
Модель учится почти на всех данных: оценка почти не смещена.
Но отложенных примеров мало, и число прыгает от разреза к разрезу.
Оценка устойчива: примеров для неё хватает.
Но модели не на чем учиться. Она хуже итоговой, и оценка пессимистична.
Обе стороны дилеммы видны в следующем опыте.
Stratified sampling: чтобы редкий класс не пропал
В задаче классификации у случайного разреза есть ещё одна беда — её было видно в третьем опыте. Пример конспекта: 90 % данных — класс A, 10 % — класс B. Отложенная часть мала, и редкий класс может в неё почти не попасть. Тогда ошибка на ней ничего не скажет о том, как модель справляется с классом B.
Насколько это вероятно? Пусть в наборе 50 примеров, пять из них — класс B, а в test set откладывают 10. Чтобы среди отложенных не было ни одного B, каждый из пяти должен попасть в 40 мест training set:
\[ \frac{40}{50}\cdot\frac{39}{49}\cdot\frac{38}{48}\cdot\frac{37}{47}\cdot\frac{36}{46} \approx 0.31 \]Почти каждый третий разрез.
До: обычный случайный разрез
После: stratified sampling
Лекарство на слайде записано одной строкой, с восклицательным знаком (лекция 3, слайд 4): "In classification preserve class distribution, i.e., stratified sampling!"
Stratified sampling (стратифицированный разрез) — разрез, который делают отдельно внутри каждого класса, так что каждая часть — training, validation и test set — сохраняет доли классов всего набора.
Когда одного разреза хватает
На слайде условие одно (лекция 3, слайд 6): "When lots of data are available". В конспекте условий три. Данных много: «at least a few thousand samples» — это ориентир, а не закон. Обучение дорогое, и на каждую конфигурацию сил хватает только на один запуск. Колебания между разрезами меньше, чем разница между моделями, которые ты сравниваешь.
В deep learning все три условия обычно выполнены, поэтому hold-out там стандарт. При миллионе примеров хорош даже разрез 98 % / 1 % / 1 %: 10 000 отложенных примеров дают SE около 0.3 пункта. Когда данных мало, одного разреза недостаточно — об этом следующий урок.
Утечка: когда билеты известны заранее
Экзамен честен, пока билеты лежат в сейфе. Для модели сейф — это правило, которое конспект называет golden rule.
Test set не участвует ни в одном решении о модели: ни в шаге градиента, ни в выборе гиперпараметров, ни в предобработке. Его открывают один раз, в самом конце.
Допустим, ты смотришь на test error, огорчаешься, меняешь что-нибудь в сети и измеряешь снова. С этого момента test set работает вторым validation set: по нему уже сделан выбор, и его оценка станет оптимистичной. Честное число после этого дадут только новые данные. На рис. 3 это перечёркнутая стрелка: из Engineering обратно в Design дороги нет.
Data leakage (утечка данных) — при построении модели использована информация, которой у неё быть не должно: из примеров, на которых потом ставят оценку, или такая, которой не будет в момент предсказания. Результат — завышенная оценка качества.
Конспект перечисляет три случая: test set попал в обучение или настройку; среди признаков есть такие, которых в реальной работе не будет; одни и те же примеры оказались и в training, и в test set. На практике к ним добавляется четвёртый, и выглядит он невинно.
Перед обучением признаки принято стандартизовать — это та же z-стандартизация, что в Applied Statistics: \(z = (x - \mu)/\sigma\). Числа \(\mu\) и \(\sigma\) тоже вычисляются по данным. Значит, это такие же выученные параметры, как веса, и к ним относится тот же вопрос: по каким примерам их считали?
До: стандартизация, потом разрез
После: разрез, потом стандартизация
«Validation set никогда нельзя пускать в обучение» — так можно понять golden rule конспекта: «never use validation/test data to update model weights». Для test set запрет абсолютный. Для validation set он действует, пока по нему принимают решения. Когда выбор сделан, модель с выбранными гиперпараметрами обычно обучают заново на training + validation, то есть на всех training data, и один раз оценивают на test set. У профессора это последний шаг подбора гиперпараметра (лекция 3, слайд 16): "Put back all data together and minimize". Конспект сам так поступает в nested cross-validation (урок 19).
В курсе есть homework challenge с рейтингом. В соревнованиях такого рода итоговое место обычно считают на данных, которых участники не видят: это test set в чистом виде. У профессора это первый способ в списке (лекция 3, слайд 4): "Someone provides you a new dataset". Свой validation set придётся отложить самостоятельно — и не подсматривать.
Ответ на загадку
Теперь можно вернуться к сетям, выучившим случайные метки. Их training error равна нулю, потому что это число измеряет одно: насколько хорошо веса подогнаны под свои же примеры. Гибкая сеть подгонится под что угодно. Отложи авторы часть картинок в validation set, ошибка на них осталась бы на уровне угадывания: метка от картинки не зависит, и запоминание на новые примеры не переносится. Одно число на отложенных данных сразу показало бы, что сеть ничего не знает.
А вот три обещанных способа сделать экзамен нечестным.
- Спрашивать по тем же задачам, на которых учились. Это training error: в среднем она занижена, и тем сильнее, чем гибче модель.
- Задать слишком мало вопросов. Маленькая отложенная часть даёт лотерейный билет вместо оценки: разброс \(\sqrt{p(1-p)/n}\), а редкий класс может в неё вовсе не попасть.
- Дать подсмотреть билеты. Это data leakage — от стандартизации по всем данным до «я только разок посмотрю на test error и поправлю сеть».
В формате экзамена
Why is the training error not a good indicator of the performance of a model on future data? How can an independent test set be obtained?
Show model answer
Training error (loss) is not a good indicator of performance on future data for three reasons. (1) The model has been learned from the very same training data, so any estimate based on those data is optimistic. (2) New data will probably not be exactly the same as the training data. (3) Patterns can be found even in random data: a flexible model can fit pure noise and still reach a low training error.
Hence the model must be tested on an independent new test set. There are three ways to get one: someone provides a new dataset; the available data are split and some of them are hidden for later evaluation (hold-out); or the dataset is randomly subsampled with replacement, which is done when the dataset is small. In classification the class distribution must be preserved in every subset, i.e. stratified sampling.
Ответ идёт по слайду "How to Measure Generalization?" (лекция 3, слайд 4) почти слово в слово: три причины, вывод "We need to test on an independent new test set", три способа и строка про stratified sampling. Хороший пример к третьей причине — сети из загадки, которые подогнались под случайные метки.
Define training dataset, training set, validation set and test set. Then explain why the validation error of the selected model is not a valid final estimate of its generalization error.
Show model answer
The training dataset is the available data: all the labelled samples we have. It is split into disjoint parts. The training set is the data used to learn the model parameters (weights and biases): parameter fitting. The validation set is the data used to perform model selection: choosing hyperparameters, comparing architectures and deciding when to stop training, without entering the gradient. The test set is the data used to perform the final model assessment: it is used only once, at the very end, to estimate the generalization error of the final model.
The validation error of the selected model is optimistically biased: the model was selected precisely because its validation error was the lowest among several noisy estimates, and the minimum of noisy estimates is biased downward. An unbiased estimate requires data that influenced no decision at all, i.e. the test set.
Проверяют три вещи: не перепутаны ли training dataset и training set; названа ли пара selection / assessment; и правильная причина оптимизма. Причина не в том, что «модель видела validation set» (в градиент он не входил), а в том, что по нему выбирали. Сами определения взяты со слайда "Clearing the terms …" (лекция 3, слайды 5 и 10).
According to the terminology of the course, which of the following statements are correct? Select all that apply.
Show model answer
The first, third and fourth. The training dataset is the available data. It is first split into training data (model development) and test data (pre-production). The training data are used to train the model (fitting + selection) and are split again into the training set, the data used to learn the model parameters, and the validation set, the data used to perform model selection. The validation data are the data used to assess the model quality (selection + assessment): the validation set together with the test set. The test set is used only for the final model assessment, so it never belongs to the training data.
Здесь проверяются шесть определений слайда "Clearing the terms …" (лекция 3, слайды 5 и 10): термины, которые отличаются одним словом. Вспомни схему с рис. 3 и читай ответы по ней.
Is \(E_{\text{train}} \le E_{\text{test}}\) always true? Justify your answer.
Show model answer
No. It holds on average for a model obtained by minimising the training error. If \(\hat{\vb{w}}\) minimises \(E_{\text{train}}\) on the training set \(D\) and \(\vb{w}^{*}\) minimises the generalization error, then
\[ \begin{aligned} \E_D\bigl[E_{\text{train}}(\hat{\vb{w}})\bigr] &\le E_{\text{gen}}(\vb{w}^{*}) \\ &\le \E_D\bigl[E_{\text{gen}}(\hat{\vb{w}})\bigr] \end{aligned} \]In a single run it can fail. The test set is finite, so its error is itself a noisy estimate and can be lower by chance, especially for a small test set. Moreover, with regularisers that act only at training time (dropout, data augmentation) the training error is often higher than the validation or test error.
Слово «always» в вопросе — приманка. Полный балл: «нет», затем «верно в среднем» с причиной (веса подобраны под эти примеры) и хотя бы один контрпример. Фраза слайда "any estimate based on that data will be optimistic" (лекция 3, слайд 4) этому не противоречит: она про смещение оценки, то есть про среднее, а не про каждый отдельный запуск.
A classifier is evaluated on a hold-out validation set of 150 samples and reaches 90% accuracy. Compute the standard error of this estimate, in percentage points.
Show model answer
That is about 2.45 percentage points: a 95% interval is roughly \(90\% \pm 4.9\%\). Two models whose accuracies differ by 2 points cannot be reliably told apart with this validation set.
Типичные потери: подставить в формулу 90 и 10 вместо долей 0.9 и 0.1 или забыть корень. Вывод про «две модели не различить» стоит дописать и в открытом вопросе: он показывает, что число понято, а не только посчитано.
A binary dataset has 50 samples, 5 of which are positive. A test set of 10 samples is drawn at random, without stratification. What is the probability that the test set contains no positive sample?
Show model answer
Each of the 5 positives must fall into one of the 40 training positions:
\[ \frac{40}{50}\cdot\frac{39}{49}\cdot\frac{38}{48}\cdot\frac{37}{47}\cdot\frac{36}{46} \approx 0.31 \]In almost one split out of three the test set says nothing about the positive class. Stratified sampling keeps the class proportions in every subset: here exactly 1 positive out of 10.
Пять дробей считаются на обычном калькуляторе. Экзаменатор ждёт не только число, но и вывод: зачем нужен stratified sampling.
Which of the following practices leak information and make the reported performance optimistic? Select all that apply.
Show model answer
The first, second and fourth. In each of them data that are later used for evaluation have influenced the model: through the preprocessing statistics, through a hyperparameter, or directly through the weights (duplicates). Early stopping on the validation set and retraining on the whole training data (training set + validation set) after selection are legitimate, provided the final number is measured once on an untouched test set.
Правило для любого варианта: спроси, откуда пришла информация для решения. Если из данных, на которых потом ставят оценку, это утечка.
Describe hold-out validation. What are the two sources of error of the hold-out estimate, and when is hold-out an appropriate choice?
Show model answer
The available data are shuffled and split once into disjoint training, validation and test sets (e.g. 70/15/15). The model is trained on the training set, tuned on the validation set (hyperparameters, early stopping) and assessed once on the test set. In classification the split is stratified, i.e. it preserves the class distribution.
The estimate has (i) a pessimistic bias, because the model is trained on only a fraction of the data, and (ii) a variance, because it is computed on a finite held-out set and depends on which samples fell into it: in the words of the slides, the hold-out error "might be biased by the specific split". For an error rate \(p\) measured on \(n\) samples the standard error is about \(\sqrt{p(1-p)/n}\). Holding out more samples reduces the variance but increases the bias, and vice versa.
Hold-out is appropriate when lots of data are available (thousands of samples or more) and training is expensive, so that one training per configuration is all one can afford: the usual situation in deep learning. With few data, cross-validation (leave-one-out or K-fold) is preferable.
На слайде зависимость от разреза названа словом "biased" (лекция 3, слайд 6), и конспект на стр. 138 это повторяет. Поэтому в ответе стоят обе вещи: фраза слайда и точные термины — variance для зависимости от разреза, bias для систематического пессимизма. Последняя фраза про cross-validation показывает, что ты видишь границу метода.
Проверь себя
Модель A: training error 0.043. Модель B: training error 0.069. Что можно сказать о том, какая из них лучше на новых данных?
Для чего по правилам этого урока можно использовать validation set?
Validation set отвечает на вопрос «какую модель взять?», но не на вопрос «насколько она хороша?».
Validation set увеличили со 100 до 400 примеров, модель та же. Как изменится разброс validation error от разреза к разрезу?
В наборе 10 % примеров класса B. После случайного разреза без стратификации в validation set не оказалось ни одного B, а validation error вышла 2 %. Что это число говорит о модели?
На слайде "Clearing the terms …" training dataset — это…
Команда измерила test error: 12 %. Потом поменяла dropout rate, обучила сеть заново и измерила на том же test set: 10 %. Как правильно назвать эти 10 %?
Hold-out оценку получили, обучив модель на 70 % данных. Итоговую модель обучат на всех данных. Какая систематическая ошибка есть у оценки по отношению к итоговой модели?
Унести с собой
- Training error в среднем занижена: веса подобраны под эти самые примеры. Нулевую training error можно получить даже на случайных метках.
- Нужен независимый test set. Способов три: новые данные со стороны, спрятанная часть своих (hold-out) или случайные выборки с возвращением, когда данных мало.
- Training dataset — все данные. Его режут на training set (веса, fitting), validation set (гиперпараметры, selection) и test set (одно измерение в конце, assessment). Training data — это training set + validation set, validation data — validation set + test set.
- Выбор — тоже подгонка: validation error выбранной модели оптимистична, поэтому нужен test set.
- Hold-out — один разрез. Его оценка шумит как \(\sqrt{p(1-p)/n}\) и смещена в пессимистичную сторону, потому что модель учится не на всех данных.
- При несбалансированных классах разрез делают стратифицированным: доли классов в каждой части те же, что во всём наборе.
- Data leakage — любая информация из отложенных данных или из будущего, попавшая в построение модели, включая предобработку. Test set лежит в сейфе до конца.
Что посмотреть и почитать
-
Train, Test, and Validation Sets
Jared Wilber, MLU-Explain
Интерактивная статья с кошками и собаками: три части данных и зачем test set держать нетронутым. Хороший первый контакт с темой, если хочется сначала потрогать.
-
TensorFlow Playground
Daniel Smilkov, Shan Carter
После раздела про три части: уменьши «Ratio of training to test data», добавь шум и следи за двумя числами — training loss и test loss. Разрыв между ними и есть то, что этот урок учит измерять.
-
Model Evaluation, Model Selection, and Algorithm Selection in Machine Learning
Sebastian Raschka, arXiv:1811.12808
Лучший связный текст о том, какую схему проверки когда брать. К этому уроку — части про hold-out; остальное пригодится в уроке 19. Даёт словарь для письменного ответа на английском.
-
Understanding deep learning requires rethinking generalization
Zhang, Bengio, Hardt, Recht, Vinyals, ICLR 2017
Работа из загадки в начале урока. Достаточно аннотации и описания опыта со случайными метками: после него фраза «training error ничего не доказывает» перестаёт быть абстракцией.
-
Deep Learning, chapter 5: Machine Learning Basics
Goodfellow, Bengio, Courville
Справочник на случай, если нужна строгая версия: разделы про capacity, validation sets и оценки. Читать выборочно.