Экзамен по кругу
После этого урока ты руками посчитаешь leave-one-out на трёх числах, по одному \(K\) назовёшь цену и смещение K-fold cross-validation, объяснишь, почему лучший результат на validation всегда слишком хорош, и сосчитаешь обучения в nested cross-validation.
У тебя 150 размеченных примеров и десять архитектур сети на выбор. Ты делаешь всё по правилам: для каждой архитектуры 5-fold cross-validation, ни один вес не учится на тех примерах, на которых его потом проверяют. Берёшь архитектуру с наименьшей ошибкой и пишешь это число в отчёт.
Теперь то, чего в жизни никто не знает. Пусть все десять архитектур на самом деле одинаково хороши: каждая ошибается ровно на 20% новых примеров, причём каждая на своих, независимо от остальных. Какое число попадёт в отчёт? В среднем 15.1%. А 20% или больше — примерно в двух случаях из тысячи.
Никто не жульничал, утечки нет, а почти четверть ошибки исчезла. Куда она делась, станет видно в конце урока. Начнём с самого экзамена по кругу: зачем он нужен, как устроен и сколько стоит.
Один пробник — одна лотерея
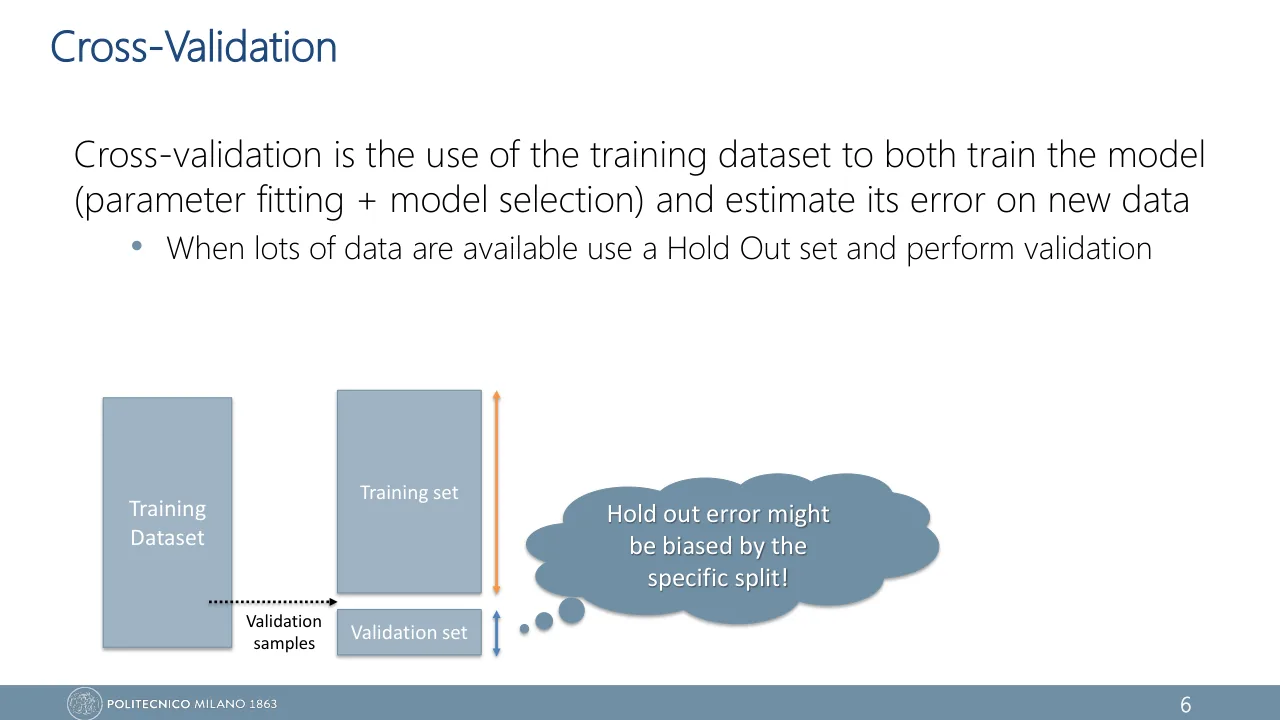
В прошлом уроке данные резали один раз: бо́льшая часть учит сеть (training set), меньшая проверяет (validation set). Это hold-out, один пробный экзамен перед настоящим. У одного разреза две слабости, и обе растут, когда данных мало.
Первая: результат зависит от того, какие именно примеры случайно попали в пробник. Другой разрез даст другое число. Это разброс оценки, её variance.
Вторая: примеры, отложенные на проверку, сеть не учат. Сеть, обученная на трёх четвертях данных, обычно немного хуже той, которую в конце обучат на всех. Значит, пробник в среднем показывает ошибку чуть больше настоящей. Это систематический сдвиг оценки, её bias, и он пессимистичный.
На слайде профессора про hold-out две фразы (лекция 3, слайд 6). Правило: "When lots of data are available use a Hold Out set and perform validation". Когда данных много, обе слабости малы; отсюда и условие. И облачко возле validation set: "Hold out error might be biased by the specific split!". Это первая слабость. Слово biased здесь бытовое: «перекошена тем, как лёг разрез». В какую сторону перекосит, заранее неизвестно, поэтому в точных терминах это variance, а не bias.
Первую слабость лечит простая идея: не выбирать один разрез, а пройти по всем. Раздели стопку из 12 задач на четыре части. В первом раунде первая часть лежит в конверте как пробник, по трём остальным идёт подготовка. Во втором раунде в конверте вторая часть, и подготовка начинается с нуля. После четырёх раундов каждая задача ровно один раз была пробником и три раза учебным материалом.
Cross-validation (перекрёстная проверка) — "the use of the training dataset to both train the model (parameter fitting + model selection) and estimate its error on new data". Так, слово в слово, написано на слайдах 6–9 лекции 3. Training dataset здесь, как и в уроке 18, означает все доступные данные: они и учат модель, и оценивают её ошибку.
Под это определение подходит и hold-out: на слайдах он первый из трёх способов. В двух других, LOOCV и K-fold, роли примеров меняются по кругу. О них этот урок.
В каждом раунде делается одно и то же: обучить новую сеть на учебной части, посчитать её ошибку на отложенной части, записать число. В конце числа усредняют. На рисунке ниже настоящие числа: это те 12 примеров и та модель, с которыми ты будешь работать в виджете.
До: hold-out, один разрез
После: разрез идёт по кругу
А вторая слабость? Сам по себе круг её не лечит: на рис. 1 и слева, и справа каждая сеть учится на 9 примерах из 12. Это проверяется симуляцией. Возьмём миллион таких наборов по 12 примеров; модель — прямая, как в виджете ниже. Итоговая прямая, обученная на всех 12, на новых данных ошибается в среднем на 1.19. И один hold-out, и круг из четырёх раундов в среднем показывают 1.28: пессимизм одинаковый. Зато от набора к набору hold-out гуляет со стандартным отклонением 1.11, а круг — 0.64.
Bias лечится следующим ходом. Раз проверят в итоге всё равно все примеры, отложенную часть можно сделать маленькой: не четыре части по три задачи, а двенадцать по одной. Тогда каждая сеть учится на 11 примерах из 12. Сколько частей брать, решает ручка \(K\) из раздела 3, а начнём с её крайнего положения.
В cross-validation каждый пример один раз проверяет и много раз учит, а оценка — среднее по раундам.
Leave-one-out: по одному за дверь
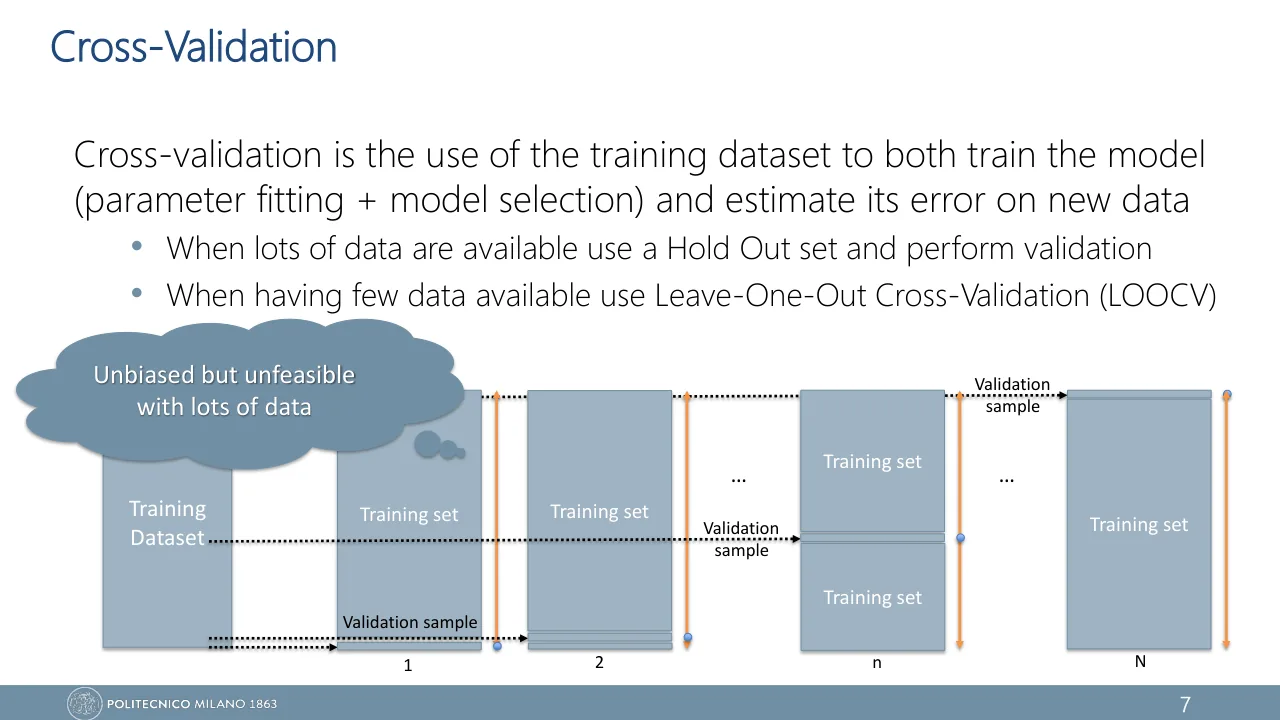
Доведём идею до предела: в конверте лежит одна задача. Представь группу из \(N\) студентов. Каждого по очереди просят выйти за дверь, остальные вместе готовятся, а потом вышедшему задают его вопрос. Проверят каждого, и каждый раз готовилась почти вся группа. Это Leave-One-Out Cross-Validation, сокращённо LOOCV: \(N\) раундов, в каждом сеть учится на \(N - 1\) примерах и проверяется на одном оставшемся.
На слайде 7 лекции 3 раунды нарисованы столбцами с номерами 1, 2, …, \(n\), …, \(N\). В каждом столбце одна тонкая полоска подписана validation sample, всё остальное — training set. От столбца к столбцу полоска поднимается на один пример.
Считаем руками
Возьмём самую маленькую сеть на свете: входов нет, есть только bias \(w_0\), и ответ всегда один, \(g(x \mid w) = w_0\). Если учить её по Sum of Squared Errors, лучший \(w_0\) равен среднему арифметическому targets. Данные: три примера с \(t = 1,\ 2,\ 6\).
Раунд 1: прячем \(t = 1\). Среднее оставшихся \((2 + 6)/2 = 4\), ошибка на спрятанном \((1 - 4)^2 = 9\). Раунд 2: прячем 2, прогноз 3.5, ошибка 2.25. Раунд 3: прячем 6, прогноз 1.5, ошибка 20.25.
\[ \hat E_{\text{LOOCV}} = \frac{9 + 2.25 + 20.25}{3} = 10.5 \]Справа на рисунке то же самое без пряток: учим на всех трёх, \(w_0 = 3\), ошибки 4, 1 и 9, в среднем 4.67. Модель та же, данные те же, а числа отличаются в 2.25 раза. Число 4.67 отвечает на вопрос «насколько хорошо сеть помнит то, что учила». Число 10.5 отвечает на вопрос «что будет на новом примере».
- \(\vb{w}^{(i)}\)
- веса сети, обученной на всех примерах, кроме \(i\)-го: на \(D \setminus \{(x_i, t_i)\}\), где \(D\) — все \(N\) примеров, весь training dataset
- \(E(x_i \mid \vb{w})\)
- ошибка на одном примере, например \((t_i - g(x_i \mid \vb{w}))^2\)
- \(\hat e_i\)
- ошибка \(i\)-го раунда: на примере, которого сеть не видела
Отдельной формулы для LOOCV на слайдах нет. Это частный случай формулы со слайда 9, до которой дойдём в разделе 3: при \(K = N\) каждый fold состоит из одного примера, и \(\hat e_i\) — ошибка такого fold. Буква \(i\) для спрятанного примера взята из конспекта; на слайде 7 раунды нумерует \(n\).
Откуда взялось ровно 2.25? Для сети из одного bias это можно вывести, и вывод показывает, как именно training error обманывает.
-
Сеть \(g(x \mid w) = w_0\), обученная на всех \(N\) примерах. Производная суммы квадратов по \(w_0\) обращается в ноль, когда \(w_0\) равен среднему targets:
\[ w_0 = \bar t = \frac{1}{N}\sum_{n=1}^{N} t_n \] -
Без \(i\)-го примера среднее считается по остальным \(N - 1\): из полной суммы \(N\bar t\) убираем \(t_i\).
\[ w_0^{(i)} = \frac{N\bar t - t_i}{N - 1} \] -
Насколько сеть промахнулась по спрятанному примеру. Приводим к общему знаменателю:
\[ t_i - w_0^{(i)} = \frac{N}{N-1}\,(t_i - \bar t) \]Промах в раунде равен промаху «на своих», растянутому в \(N/(N-1)\) раз.
-
Возводим в квадрат и усредняем по всем \(i\). Справа появляется обычная средняя ошибка на training set:
\[ \hat E_{\text{LOOCV}} = \Big(\frac{N}{N-1}\Big)^{2} E_{\text{train}} \] -
Проверка: при \(N = 3\) множитель равен \((3/2)^2 = 2.25\), и \(2.25 \cdot 4.67 = 10.5\). При \(N = 10\) множитель 1.23, при \(N = 100\) уже 1.02.
У этой крошечной сети обман быстро исчезает с ростом \(N\). У гибкой сети с тысячами весов он держится намного дольше.
Три свойства LOOCV
Почти нет bias. Каждая из \(N\) сетей училась на \(N - 1\) примере из \(N\), то есть почти на всех данных. Поэтому LOOCV оценивает ошибку почти той самой сети, которую ты в конце обучишь на всех данных. Остаётся едва заметный пессимизм: \(N - 1\) всё-таки меньше \(N\).
На слайде профессора слова almost нет. Облачко над схемой говорит: "Unbiased but unfeasible with lots of data" (лекция 3, слайд 7). Точный смысл этого unbiased такой. В среднем по всем возможным наборам данных оценка LOOCV в точности равна средней ошибке сети, обученной на \(N - 1\) примерах: для такой сети она несмещённая без оговорок. А в работу пойдёт сеть, обученная на всех \(N\) примерах, и она в среднем чуть лучше. Отсюда «почти». На экзамене пиши слово слайда и тут же причину: unbiased, because each model is trained on \(N - 1\) of the \(N\) samples.
Очень дорого. Одна оценка стоит \(N\) обучений. А оценивать обычно нужно не одну конфигурацию. Это вторая половина того же облачка: "unfeasible with lots of data".
Сначала прикинь: 200 примеров и 10 конфигураций — сколько обучений?
\(200 \cdot 10 = 2000\). Hold-out обошёлся бы в 10 обучений, 5-fold — в 50. Для сети, которая учится час, это 10 часов, двое суток и почти три месяца.
Высокая variance. Каждое \(\hat e_i\) стоит на одном-единственном примере, поэтому оно очень шумное. Усреднение помогает меньше, чем кажется: любые два training set совпадают в \(N - 2\) примерах, сети получаются почти одинаковыми, и их ошибки сильно связаны между собой. Среднее связанных чисел гасит шум хуже, чем среднее независимых.
Правда ли, что у LOOCV всегда самая высокая variance?
Не всегда, и в литературе об этом спорят. Для устойчивых моделей, например линейной регрессии, оценка LOOCV может оказаться даже стабильнее, чем у K-fold с малым \(K\). Так обстоит дело и с прямой из виджета ниже: на миллионе наборов по 12 примеров стандартное отклонение оценки получается около 1.2 при \(K = 2\), 0.64 при \(K = 4\) и 0.56 при \(K = 12\).
Линия конспекта проще: LOOCV — low bias, high variance, very expensive. Слайды о variance у LOOCV молчат; есть только скобка на слайде 8 лекции 3, где K-fold назван "sometime better than LOOCV", и с линией конспекта она согласуется. На экзамене стоит держаться этой линии. Аргумент за неё — тот, что выше: слагаемые \(\hat e_i\) стоят на одном примере каждое и сильно связаны между собой.
Мостик к Applied Statistics: для линейной регрессии LOOCV считается вообще без переобучения, через leverage \(h_{ii}\): промах раунда (до возведения в квадрат) равен обычному остатку, делённому на \(1 - h_{ii}\). Для модели-среднего \(h_{ii} = 1/N\), и получается тот же множитель \(N/(N-1)\).
Итог: LOOCV берут, когда примеров мало (сотни и меньше), а модель учится быстро. На слайде 7 то же правило записано строкой "When having few data available use Leave-One-Out Cross-Validation (LOOCV)". Для глубоких сетей это почти всегда теоретическая точка отсчёта, а не рабочий инструмент.
K-fold: ручка между «дёшево» и «точно»
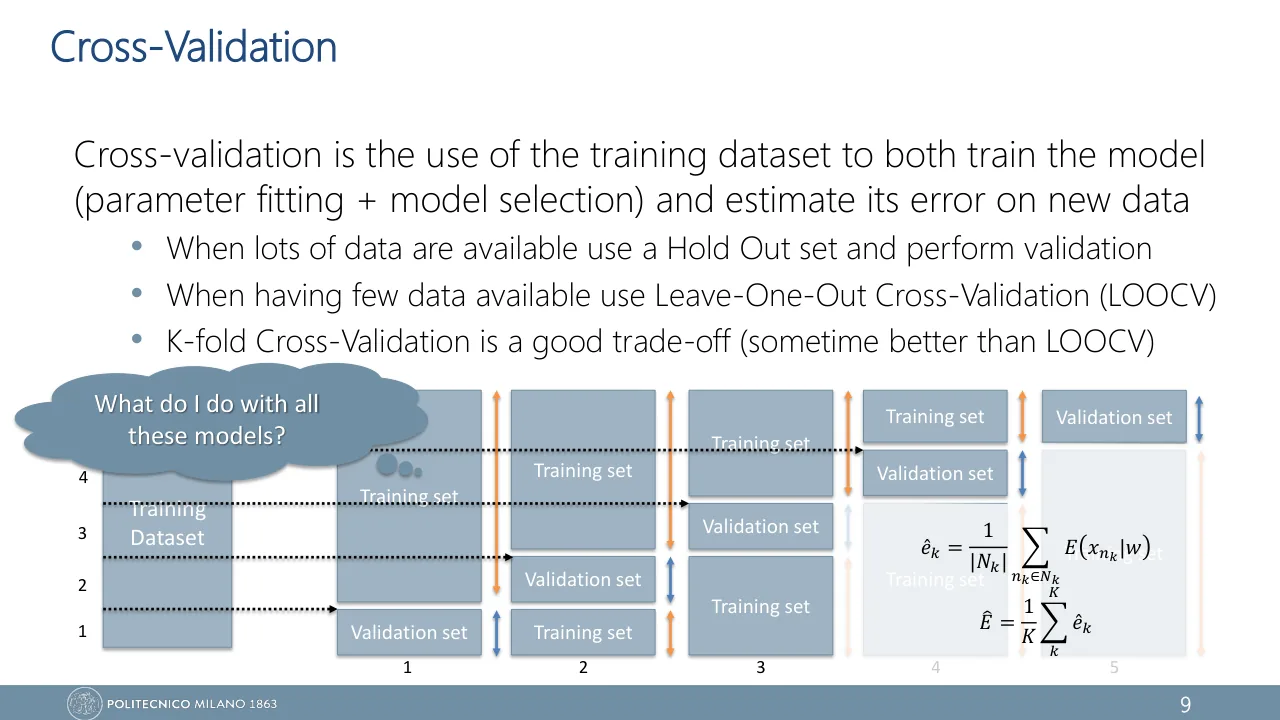
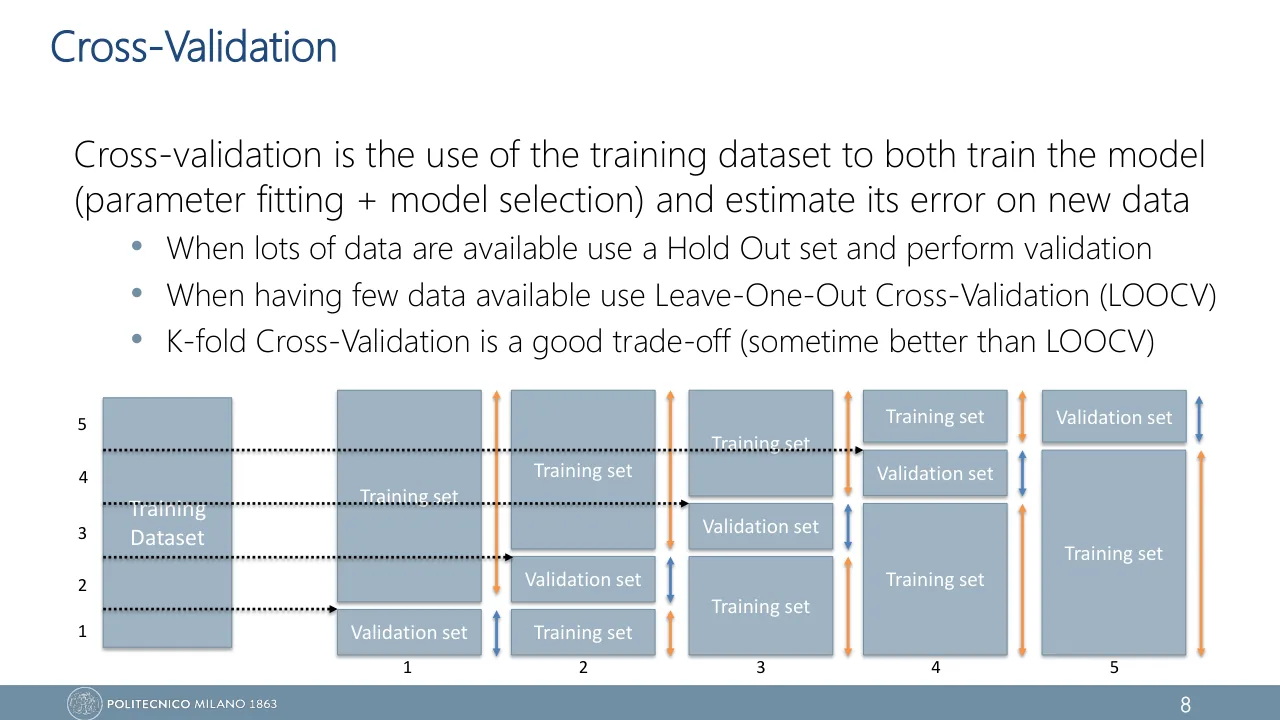
LOOCV — крайний случай общей схемы. В K-fold cross-validation весь training dataset делят на \(K\) непересекающихся частей (folds) примерно по \(N/K\) примеров. В раунде \(k\) сеть учится на \(K - 1\) частях и проверяется на \(k\)-й. Потом \(K\) ошибок усредняют.
На слайде 8 лекции 3 это нарисовано для \(K = 5\). Training dataset разрезан на пять кусков с номерами от 1 до 5. В столбце \(k\) кусок \(k\) подписан validation set, остальные четыре — training set. Слайд 9 добавляет к этой картинке две формулы.
- \(N_k\)
- множество примеров \(k\)-го fold: в этом раунде он validation set. \(|N_k|\) — сколько в нём примеров. В конспекте это \(\mathcal{D}_k\)
- \(E(x_n \mid \vb{w})\)
- ошибка на одном примере, например \((t_n - g(x_n \mid \vb{w}))^2\)
- \(\vb{w}^{(k)}\)
- веса сети, обученной на всех folds, кроме \(k\)-го
- \(\hat e_k\)
- средняя ошибка на fold \(k\). В конспекте она же записана то как \(\hat e_k\), то как \(E_k\)
- \(\hat E\)
- оценка ошибки на новых данных; в конспекте \(\hat E_{K\text{-Fold}}\). Когда схем несколько, урок тоже ставит подпись: \(\hat E_{\text{LOOCV}}\), \(\hat E_{\text{nested}}\)
На самом слайде первая формула записана короче:
\[ \hat e_k = \frac{1}{|N_k|}\sum_{n_k \in N_k} E(x_{n_k} \mid w) \]Индекс \(n_k\) значит «пример из fold \(k\)»: это то же, что \(n \in N_k\). А веса там записаны просто \(w\), без пометки, и их легко принять за одни и те же во всех раундах. Это не так: в раунде \(k\) берут веса той сети, которая fold \(k\) не видела. Поэтому в уроке написано \(\vb{w}^{(k)}\). Вторая сумма на слайде подписана просто \(k\) снизу и \(K\) сверху.
Пример на числах: \(N = 100\), \(K = 5\). В каждом fold 20 примеров, то есть \(|N_k| = 20\), и каждая сеть учится на 80. Ошибки раундов 0.21, 0.18, 0.25, 0.20 и 0.16 дают оценку \(1.00 / 5 = 0.20\).
Обрати внимание на \(1/|N_k|\). Обычно на слайдах ошибка — Sum of Squared Errors, сумма без деления на число примеров; так записана и validation error на слайде 16 лекции 3. Для обучения это неважно, а для сравнения нужно среднее на один пример: в training-части 80 примеров, в validation 20, и суммы по ним сравнивать бессмысленно. В формуле слайда 9 лекции 3 деление стоит явно.
Как выбрать K
Чем меньше \(K\), тем меньше данных достаётся каждой сети и тем пессимистичнее оценка. Чем больше \(K\), тем ближе training set к полному набору, но тем больше обучений и тем сильнее шумит оценка. В конспекте это выделено маркером, и эту фразу стоит уметь написать по-английски: "Small K (e.g., 2 or 3) leads to higher bias but lower variance, while large K (e.g., LOOCV) leads to lower bias but higher variance and computational cost."
На слайде 8 лекции 3 об этом одна строка: "K-fold Cross-Validation is a good trade-off (sometime better than LOOCV)". Слово sometime напечатано там именно так, без s на конце. Trade-off здесь — между двумя крайностями с тех же слайдов: hold-out стоит одно обучение, но зависит от разреза, а LOOCV — unbiased, но стоит \(N\) обучений. Скобку слайд не расшифровывает. Обычное объяснение — два выигрыша сразу: \(K\) обучений вместо \(N\) и оценка, которая шумит меньше, чем среднее \(N\) сильно связанных слагаемых. Слово sometime честное: так выходит не всегда, оговорка в разделе 2.
| \(K\) | Доля в обучении | Обучений | Bias оценки | Variance оценки |
|---|---|---|---|---|
| 2–3 | 50–67% | 20–30 | заметный, пессимистичный | ниже |
| 5 | 80% | 50 | небольшой | умеренная |
| 10 | 90% | 100 | ещё меньше | чуть выше |
| \(N = 200\) | 99.5% | 2000 | почти нет | высокая |
Самый частый выбор — \(K = 5\); \(K = 10\) берут, когда данных меньше и жалко отдавать пятую часть; \(K = 2\) или 3 — когда данных очень много и считать дорого.
Что остаётся после cross-validation
Раунды пройдены. У тебя \(K\) обученных сетей и одно число. Слайд 9 лекции 3 на этом месте спрашивает: "What do I do with all these models?". Какую из сетей нести дальше? Ни одну.
Cross-validation оценивает не сеть, а рецепт: архитектуру, hyperparameters и способ обучения. Число \(\hat E\) говорит, какую ошибку даёт этот рецепт на новых данных. Сами \(K\) сетей — строительные леса: каждая видела только часть данных.
Порядок действий такой. Прогнать K-fold для каждой конфигурации. Выбрать ту, у которой \(\hat E\) меньше. Обучить её заново на всех \(N\) примерах: больше данных — лучше сеть. Число \(\hat E\) для этой сети слегка пессимистично, потому что в раундах данных было меньше. Но если конфигураций было несколько, сам выбор сдвигает число победителя в обратную сторону, вниз. Об этом следующий раздел.
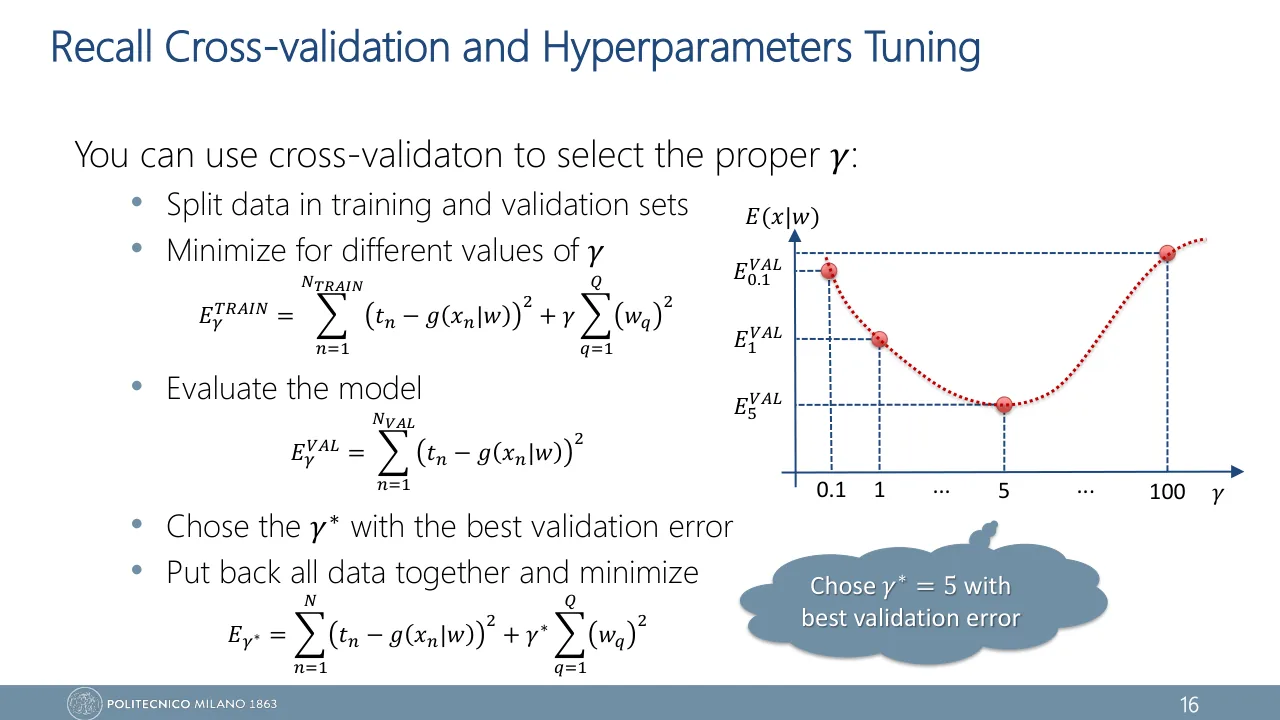
Это и есть ответ на вопрос слайда 9, и оба его шага записаны на слайдах той же лекции. Выбор: на слайде 10 возле разреза на training set и validation set стоит облачко "… more common here for model selection (hyperparameter tuning)", то есть чаще всего K-fold крутят именно ради выбора. Обучение заново: рецепт выбора на слайде 16 кончается строкой "Put back all data together and minimize". Есть и второй законный ответ, которого на слайдах нет: не выбрасывать \(K\) сетей, а усреднять их ответы как ensemble. Только число \(\hat E\) тогда описывает одну такую сеть, а не их ансамбль.
«После 5-fold у меня пять сетей, возьму ту, у которой ошибка на её fold меньше всех». Нет. Маленькая ошибка в одном раунде чаще значит, что fold попался лёгкий, а не что сеть лучше: на рис. 1 одна и та же модель получила 0.08 и 3.06. И каждая из пяти сетей видела только 80% данных.
Две меры предосторожности, без которых число \(\hat E\) врёт.
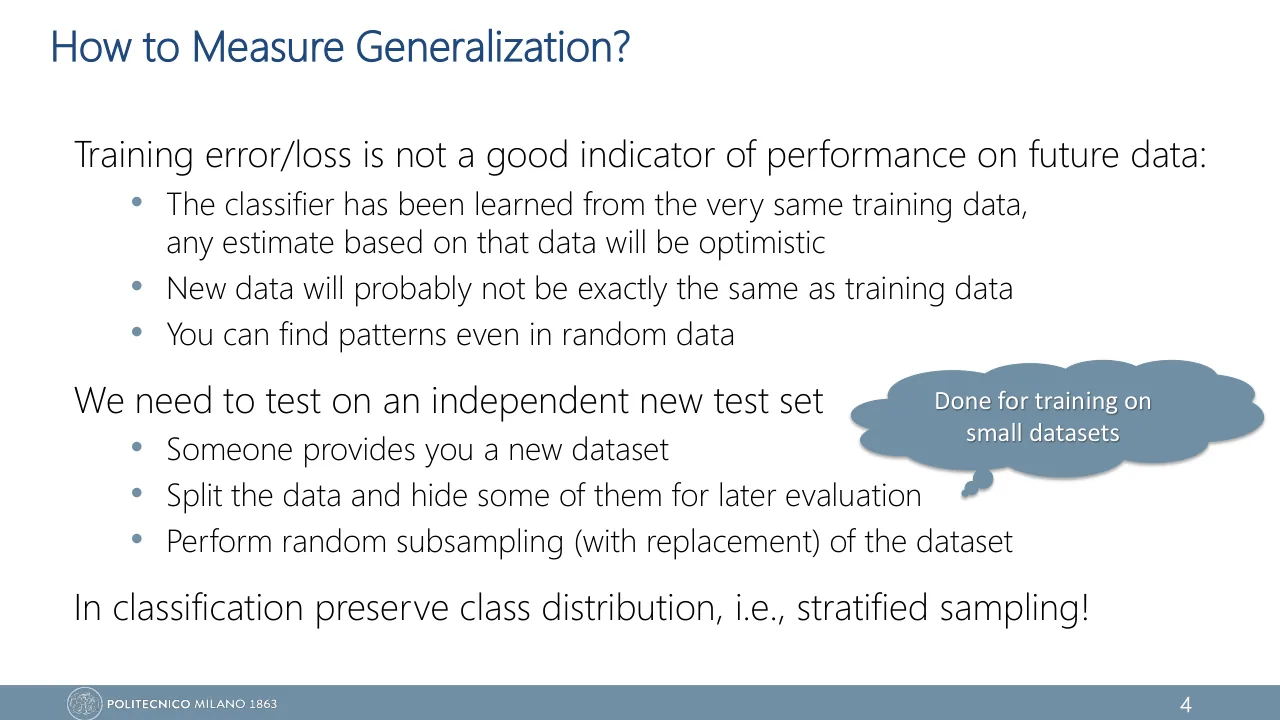
Перемешай перед разбиением. Если примеры лежат по порядку (сначала один класс, потом другой, или по времени), соседние folds будут из разных миров. Для классификации лучше ещё и stratified разбиение: в каждом fold те же доли классов, что во всём наборе. На слайде 4 лекции 3 это отдельная строка: "In classification preserve class distribution, i.e., stratified sampling!".
Preprocessing считай внутри каждого раунда. z-стандартизация из Applied Statistics — хороший пример: среднее и стандартное отклонение берут только по \(K - 1\) учебным folds и применяют к отложенному. Если посчитать их один раз по всем данным, validation fold уже повлиял на обучение. Это утечка из урока 18, только спрятанная внутри цикла.
Лучший из десяти одинаковых
Вернёмся к загадке. В ней одно и то же число сделало две разные работы.
Выбрать лучшую конфигурацию по результату на validation. Нужен ответ на вопрос «кто лучше».
Оценить, как выбранная модель поведёт себя на данных, которых не видела. Нужен ответ на вопрос «насколько хорошо».
Вот десять оценок из загадки на одном конкретном наборе данных. У всех десяти конфигураций настоящая ошибка 0.20.
Каждая точка по отдельности честная: в среднем она равна 0.20 и колеблется вокруг со стандартным отклонением \(\sqrt{0.2 \cdot 0.8 / 150} \approx 0.033\). Среднее десяти точек 0.201. Но мы берём не случайную точку и не среднее, а минимальную. А минимум из нескольких шумных чисел в среднем лежит ниже каждого из них.
-
Оценка каждой конфигурации \(\theta\) — её настоящая ошибка плюс шум с нулевым средним. Значит, каждая оценка несмещённая:
\[ \hat E_\theta = E_\theta + \varepsilon_\theta, \quad \E[\hat E_\theta] = E_\theta \] -
Минимум не больше любого из чисел. Возьмём любую конфигурацию \(\theta'\):
\[ \min_\theta \hat E_\theta \;\le\; \hat E_{\theta'} \] -
Усредняем обе части по всем возможным наборам данных. Справа получается настоящая ошибка \(\theta'\):
\[ \E\big[\min_\theta \hat E_\theta\big] \;\le\; E_{\theta'} \] -
Это верно для каждой \(\theta'\), в том числе для действительно лучшей:
\[ \E\big[\min_\theta \hat E_\theta\big] \;\le\; \min_\theta E_\theta \]Среднее от минимума не больше минимума от средних. Равенство получается, только если на любом наборе данных побеждает один и тот же, действительно лучший кандидат: например, шума нет или кандидат один.
-
Насколько ниже? Если кандидаты одинаково хороши, а шум у каждого свой (независимый и примерно нормальный), минимум из десяти в среднем лежит на 1.54 стандартного отклонения ниже, из ста — на 2.51:
\[ 0.20 - 1.54 \cdot 0.033 \approx 0.15 \]Точный счёт по биномиальному распределению даёт 15.1%, число из загадки.
Выбирать лучшего по validation — тоже обучение: число, по которому выбирали, больше не годится как оценка.
Это тот же механизм, что в уроке 18 делал training error оптимистичной: там веса подгоняли под training set, здесь выбор конфигурации подгоняют под validation folds. Эффект называют winner's curse, проклятие победителя. И он не исчезает, когда кандидаты на самом деле разные: победитель, скорее всего, действительно хорош, но его число всё равно сдвинуто вниз. Выбор может быть верным, а число при этом неверным.
Размер сдвига в загадке — почти худший случай. Там каждая архитектура ошибается на своих примерах. В жизни сети спотыкаются на одних и тех же трудных примерах, их оценки поднимаются и опускаются вместе, и минимум уходит от остальных не так далеко. Сдвиг получается меньше, но направление у него всегда одно: вниз.
Nested cross-validation: экзамен, который не участвовал в выборе
Лекарство то же, что в прошлом уроке: test set, то есть данные, которые не участвовали ни в одном решении. Но при малом \(N\) один test set — снова лотерея. Значит, его тоже надо пустить по кругу. Получается круг в круге.
Слайды доходят ровно до этой мысли. На слайде 10 лекции 3 повторена схема терминов из прошлого урока (слайд 5, "Clearing the terms …"): training dataset режут на training data и test data, а training data — на training set и validation set.
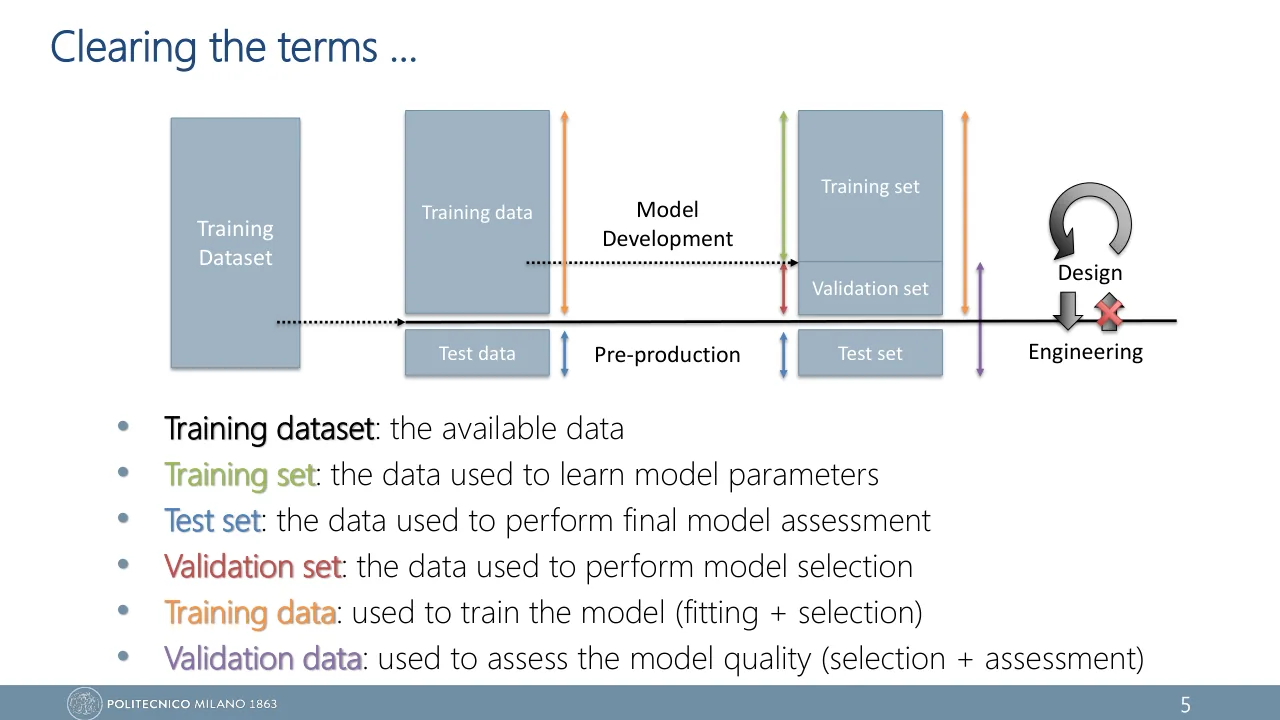
Новое на слайде 10 — три облачка. У первого разреза, где откладывают test data (на схеме это уровень "Pre-production"): "We can apply K-fold Cross-Validation also at this level for model assessment …". У второго, где откладывают validation set (на схеме — "Model Development"): "… more common here for model selection (hyperparameter tuning)". И третье, про цену: "Beware the number of models you get and how much it cost to train!".
То есть по слайду K-fold можно поставить на любой из двух разрезов. Поставить на оба сразу — это и есть nested cross-validation: внешний круг крутит первый разрез, внутренний — второй. Но ни этого названия, ни схемы из двух циклов, ни формул ниже на слайдах нет: всё это из конспекта (стр. 145–149). Считай остаток раздела материалом сверх слайдов. Он показывает, что получается, когда оба облачка работают вместе, и сколько это стоит.
- Outer loop, assessment. Раздели данные на \(K\) outer folds. В раунде \(k\) один fold запирается как test, остальные \(K - 1\) образуют outer training set. В словах слайда 10 это test data и training data.
- Inner loop, selection. Внутри outer training set сделай обычный \(M\)-fold для каждой конфигурации \(\theta\) из набора \(\Theta\): он по очереди назначает куски на роли training set и validation set. Выбери \(\theta^*_k\) с наименьшей средней ошибкой.
- Проверка. Обучи \(\theta^*_k\) заново на всём outer training set и один раз проверь на запертом fold. Получится \(\hat e_k\).
- Среднее. После \(K\) раундов усредни \(\hat e_k\).
- \(\hat e^{\,\text{inner}}_{m}(\theta)\)
- ошибка конфигурации \(\theta\) на \(m\)-м inner fold
- \(\theta^*_k\)
- победитель inner loop в outer раунде \(k\)
- \(\hat e_k\)
- ошибка победителя на запертом outer fold \(k\). Считается по формуле слайда 9, только \(N_k\) теперь test, а не validation
Главная фраза раздела в конспекте (стр. 148): "the inner loop chooses the best hyperparameters, while the outer loop evaluates the whole selection procedure on unseen data". Outer loop оценивает не конфигурацию, а всю процедуру выбора целиком.
Сколько это стоит и что на выходе
Третье облачко слайда 10 предупреждает: "Beware the number of models you get and how much it cost to train!". Считаем обучения. В каждом из \(K\) outer раундов inner loop обучает \(M\) сетей на каждую из \(|\Theta|\) конфигураций, плюс одно обучение победителя на всём outer training set.
\[ K \cdot \big(M \cdot |\Theta| + 1\big) \]Для \(K = 5\), \(M = 3\) и 10 конфигураций это \(5 \cdot 31 = 155\). Для \(K = 10\), \(M = 5\) уже 510. Именно эти две пары называет конспект (стр. 149): \(K = 5\), \(M = 3\) как типичный выбор, \(K = 10\), \(M = 5\) для более точной оценки и для малых наборов данных. Размеры блоков при \(N = 150\), \(K = 5\), \(M = 3\): outer test 30, outer training 120, inner validation 40, inner training 80.
Чего nested CV не даёт: ни модели, ни «лучших hyperparameters». Победители \(\theta^*_k\) в разных outer раундах могут быть разными, это видно в виджете. На выходе одно число: ожидаемая ошибка процедуры «выбрать через inner CV, потом обучить». Итоговую модель получают отдельно: один раз запустить выбор на всех данных, обучить победителя на всех данных, а число \(\hat E_{\text{nested}}\) приложить как честную оценку.
И одна оговорка к заголовку конспекта «There is no more optimism»: nested CV убирает оптимизм от выбора. Остаётся обычный лёгкий пессимизм K-fold, потому что outer training set меньше полного набора.
Загадка решена
15.1% в отчёте — это минимум из десяти честных чисел. Каждое в среднем равно 20%, но минимум из десяти в среднем на полтора стандартных отклонения ниже. Fold, который в выборе не участвовал, возвращает 20%. В примере из документации scikit-learn то же проделано на настоящих данных, 150 цветках Iris: за 30 повторов non-nested score был систематически выше nested, в среднем на 0.007581. Score там — это accuracy, так что «выше» значит «оптимистичнее». Сдвиг меньше одного процентного пункта, намного скромнее, чем в загадке, но в ту же сторону.
| Схема | Обучений | Bias оценки | Variance оценки | Когда брать |
|---|---|---|---|---|
| Hold-out | 1 на конфигурацию | пессимистичный | высокая при малом validation set | данных много, обучение дорогое |
| K-fold, \(K = 5\)–10 | \(K\) на конфигурацию | небольшой, пессимистичный | умеренная | данных средне |
| LOOCV | \(N\) на конфигурацию | почти нет | высокая | данных очень мало, модель быстрая |
| Nested \(K \times M\) | \(K(M|\Theta| + 1)\) всего | небольшой, пессимистичный; без оптимизма от выбора | умеренная | данных мало, а нужно и выбрать, и отчитаться |
В глубоком обучении чаще всего остаётся hold-out с отдельным test set: одно обучение стоит слишком дорого, чтобы повторять его десятки раз. Но логика та же самая: число, по которому что-то выбирали, в отчёт не идёт.
В формате экзамена
Compare hold-out validation, K-fold cross-validation and leave-one-out cross-validation. For each, state the number of trainings per configuration, the bias and the variance of the error estimate, and when you would use it.
Show model answer
Hold-out: 1 training. The model is trained on a fraction of the data (e.g. 70–80%), so the estimate is pessimistically biased. The hold-out error also "might be biased by the specific split": another split gives another number, so the variance of the estimate is high when the validation set is small. Use it when lots of data are available or training is expensive (the usual case in deep learning).
K-fold (K = 5 or 10): K trainings. Each model sees \((K-1)/K\) of the data: small pessimistic bias. All \(N\) samples are used for validation once and K errors are averaged: moderate variance. A good trade-off between the other two, sometimes even better than LOOCV: far fewer trainings and a less noisy estimate.
LOOCV (K = N): N trainings. Each model is trained on \(N-1\) of the \(N\) samples, so the estimate is unbiased (strictly, almost unbiased: the final model is trained on all \(N\)). But it has high variance (each term rests on a single sample and the terms are highly correlated) and it is unfeasible with lots of data. Use it only when few data are available and the model is cheap to train.
In all cases the selected configuration is finally retrained on all the available data.
Проверяют три оси сразу: цена, bias, variance. Обязательно назови направление bias (пессимистичный, потому что меньше данных) и причину, по которой LOOCV почти несмещённая: \(N - 1\) примеров в обучении, а не «каждый пример проверяет один раз».
Каркас ответа — три строки слайдов 6–8 лекции 3 и два облачка: много данных — hold-out, "Hold out error might be biased by the specific split!"; мало данных — LOOCV, "Unbiased but unfeasible with lots of data"; K-fold — "a good trade-off (sometime better than LOOCV)". Слова со слайдов в ответе узнают сразу; уточнения к ним показывают, что ты понимаешь, откуда они.
A model with no inputs predicts a constant, \(g(x \mid w) = w_0\). It is fitted by minimising the sum of squared errors, so \(w_0\) is the mean of the training targets. The dataset has three samples with targets \(t = 2,\ 4,\ 9\). Compute the leave-one-out cross-validation estimate of the mean squared error.
Show model answer
Leave out 2: \(w_0 = 6.5\), error \((2 - 6.5)^2 = 20.25\). Leave out 4: \(w_0 = 5.5\), error \(2.25\). Leave out 9: \(w_0 = 3\), error \(36\).
\[ \hat E_{\text{LOOCV}} = \frac{20.25 + 2.25 + 36}{3} = 19.5 \]Check: the training MSE on all three samples is \(26/3 = 8.67\), and \(8.67 \cdot (3/2)^2 = 19.5\).
Типичная ошибка — посчитать среднее по всем трём (5) и получить training MSE 8.67. В каждом раунде среднее берётся только по двум оставшимся примерам.
You run K-fold cross-validation on a training dataset of \(N\) samples. (a) Write the error \(\hat e_k\) of fold \(k\) and the cross-validation estimate \(\hat E\), and define every symbol. (b) At the end you have \(K\) trained models. What do you do with all these models?
Show model answer
(a) The training dataset is split into \(K\) disjoint folds; \(N_k\) is the set of samples of fold \(k\). In round \(k\) the model is trained on the other \(K-1\) folds and validated on fold \(k\):
\[ \hat e_k = \frac{1}{|N_k|}\sum_{n \in N_k} E\big(x_n \mid w^{(k)}\big) \] \[ \hat E = \frac{1}{K}\sum_{k=1}^{K} \hat e_k \]\(E(x_n \mid w)\) is the error on sample \(n\), e.g. \((t_n - g(x_n \mid w))^2\); \(w^{(k)}\) (simply \(w\) on the slide) are the weights learned in round \(k\), without fold \(k\); \(\hat E\) estimates the error on new data.
(b) None of them is the final model: they are by-products of the estimate. Each has seen only \((K-1)/K\) of the data, and a low error on one fold mostly means an easy fold. Cross-validation assesses the recipe (architecture, hyperparameters, training procedure), not a single network. I keep \(\hat E\), use it to select the hyperparameters, then put all the data back together and train one final model on the whole training dataset. An alternative is to keep all \(K\) models and average their outputs as an ensemble; \(\hat E\) then describes a single member, not the ensemble.
Обе формулы — со слайда 9 лекции 3, вопрос (b) задан там же, в облачке. В ответе нужны три вещи: деление на \(|N_k|\) (среднее по fold, а не сумма), пояснение, что веса в каждом раунде свои, и фраза про обучение заново на всех данных — на слайде 16 лекции 3 это "Put back all data together and minimize". Последнее предложение про ensemble — сверх слайдов, его можно опустить.
You run nested cross-validation with \(K = 10\) outer folds, \(M = 5\) inner folds and 8 candidate configurations. How many networks are trained to obtain the nested estimate, including the retraining of the selected configuration on each outer training set?
Show model answer
Producing the final deployable model costs \(M|\Theta| + 1 = 41\) more trainings: one selection on all the data and one final training.
Формула конспекта \(K \times M \times |\Theta|\) дала бы 400: она теряет по одному переобучению на каждый outer fold.
Which statements about K-fold cross-validation are correct? Select all that apply.
Show model answer
Correct: the first, the second and the fourth statements. The K models are by-products of the estimate, and any preprocessing must be re-fitted inside each fold on the training folds only.
Две неверные опции — самые частые ошибки на практике: «взять лучшую из K сетей» и «нормализовать до разбиения».
You evaluate 10 architectures with 5-fold cross-validation, select the one with the lowest average validation error (0.15) and report 0.15 as the expected error on new data. (a) Why is this estimate optimistic, although no weight was ever trained on the fold it was validated on? (b) How does nested cross-validation fix it? (c) Which model do you finally deploy?
Show model answer
(a) The validation folds were used for model selection. Each CV score is a noisy estimate of the true error, and we report the minimum of 10 noisy estimates: \(\E[\min_\theta \hat E_\theta] \le \min_\theta E_\theta\). The choice is tuned to those particular folds, so the score no longer represents unseen data.
(b) Nested CV separates selection from assessment. The outer loop holds out a test fold; the inner loop runs M-fold CV on the remaining data only and selects the configuration; the selected configuration is retrained on the whole outer training set and evaluated on the outer test fold, which played no part in the choice. The average of the K outer test errors estimates the error of the whole selection procedure.
(c) Nested CV returns an estimate, not a model. For deployment, run the selection once on all the data, retrain the selected configuration on all the data, and report the nested estimate as its expected error.
Ключевые слова: model selection против model assessment, «minimum of noisy estimates», «inner loop selects, outer loop assesses». Пункт (c) чаще всего забывают. Слов nested cross-validation на слайдах нет: слайд 10 лекции 3 говорит только, что K-fold применяют и для model assessment, и, чаще, для model selection. Вопрос могут задать в этих словах, без слова nested.
You standardise all the features using the mean and the standard deviation computed on the whole dataset, and then run 5-fold cross-validation. What is wrong, and how do you fix it?
Show model answer
This is data leakage: the statistics used for preprocessing were computed also on the samples that later act as validation folds, so the validation data influenced the training pipeline and the estimate becomes optimistic. Fix: inside each round, compute the mean and the standard deviation on the \(K-1\) training folds only and apply them to the held-out fold (and, at the very end, to the test set).
Достаточно двух предложений: назвать утечку и сказать «fit inside each fold on the training folds only».
Проверь себя
Почему оценка LOOCV почти несмещённая?
Конфигурация всего одна, выбирать не из чего. 5-fold CV на 100 примерах дал для неё оценку 0.20. Потом её обучили на всех 100. Чего ждать от настоящей ошибки итоговой сети?
В LOOCV на 12 примерах ошибки раундов оказались от 0.00 до 5.85. Что это говорит о двенадцати обученных моделях?
По flat CV перебрали 100 конфигураций вместо 10 и взяли лучшую. Что стало с разрывом между её score и настоящей ошибкой?
Что верно про nested cross-validation?
Nested CV — это training, validation и test из прошлого урока, где test пущен по кругу \(K\) раз, а validation — по кругу \(M\) раз внутри.
Миллион картинок, одно обучение сети занимает двое суток. Какую схему оценки выбрать?
Унести с собой
- Cross-validation использует одни и те же данные и для обучения, и для оценки: каждый пример один раз проверяет и \(K - 1\) раз учит, оценка равна среднему ошибок раундов.
- Правило слайдов 6–8 лекции 3: данных много — hold-out, но его ошибка "might be biased by the specific split"; данных мало — LOOCV; K-fold — "a good trade-off".
- LOOCV — это K-fold с \(K = N\): почти несмещённая, потому что сети учатся на \(N - 1\) примере, но стоит \(N\) обучений и даёт шумную оценку. На слайде 7 лекции 3 коротко: "Unbiased but unfeasible with lots of data".
- \(K\) — ручка: малый \(K\) дёшев, но оценка пессимистична; большой \(K\) точнее в среднем, но дороже и шумнее. Обычно берут 5 или 10.
- Ответ на "What do I do with all these models?": ни одну из \(K\) сетей не берут. Cross-validation оценивает рецепт, а не сеть: итоговую модель обучают заново на всех данных, а preprocessing считают внутри каждого раунда.
- Лучший из многих validation scores оптимистичен: \(\E[\min] \le \min \E\). Чем больше кандидатов, тем сильнее.
- Nested CV: inner loop выбирает, outer loop оценивает всю процедуру выбора на данных, которые в выборе не участвовали. На выходе число, а не модель. Слайд 10 лекции 3 говорит только, что K-fold ставят на любой из двух уровней; сама схема — сверх слайдов.
Что посмотреть и почитать
-
Machine Learning Fundamentals: Cross Validation
StatQuest
Самое мягкое первое знакомство с идеей «разрез по кругу». Хорошо зайдёт перед уроком, если K-fold раньше не встречался.
-
Cross-Validation
MLU-Explain (Amazon)
Анимированные folds: от одного validation set к K-fold. Открой рядом с виджетом «Вращатель folds» как вторую картинку того же самого.
-
Nested versus non-nested cross-validation
scikit-learn, example gallery
Около 30 строк кода: inner loop —
GridSearchCV, outer loop —cross_val_score. Тот самый пример на Iris с разницей 0.007581. Запусти и увеличь сетку параметров: оптимизм вырастет. -
Model Evaluation, Model Selection, and Algorithm Selection in Machine Learning
Sebastian Raschka, arXiv:1811.12808
Лучший связный текст о том, какую схему когда брать: hold-out, LOOCV, выбор K, nested CV. Читай выборочно, когда понадобится словарь для развёрнутого ответа.
-
On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation
Cawley, Talbot, JMLR 11 (2010)
Статья, на которой стоит nested CV: переобучиться можно не только весами, но и выбором модели. Достаточно abstract и введения.