Бритва Оккама
После этого урока ты по двум числам — ошибке на обучающих точках и ошибке на новых — отличишь underfitting от overfitting и разложишь ошибку модели на bias, variance и шум.
1953 год. У теории физика Фримена Дайсона четыре свободных параметра. Энрико Ферми её отвергает и цитирует своего друга Джона фон Неймана: "With four parameters I can fit an elephant" — с четырьмя параметрами я подгоню слона, а с пятью заставлю его махать хоботом.
Это не просто острота. В 2010 году трое физиков в самом деле нарисовали слона четырьмя комплексными параметрами и напечатали его в American Journal of Physics.
Теперь загадка. Урок 12 закончился теоремой, которой мы радовались: сеть с достаточным числом нейронов приблизит любую непрерывную функцию. Параметров у неё не четыре, а тысячи. Почему то, что для теоремы достоинство, для Ферми — приговор? И как отличить модель, которая поняла закономерность, от модели, которая подогнала слона?
Сеть, которая может всё, выучит и шум
Урок 12 выдал сети лицензию на всё: Feed Forward Neural Network с одним скрытым слоем — universal approximator. Третья лекция открывается слайдом с тем же заголовком, "Neural Networks are Universal Approximators", и той же цитатой (лекция 3, слайд 2): Universal approximation theorem (Kurt Hornik, 1991) повторена слово в слово, а оговорки под ней переписаны. Сначала "Regardless of what function we are learning; a single layer can do it …", затем три продолжения:
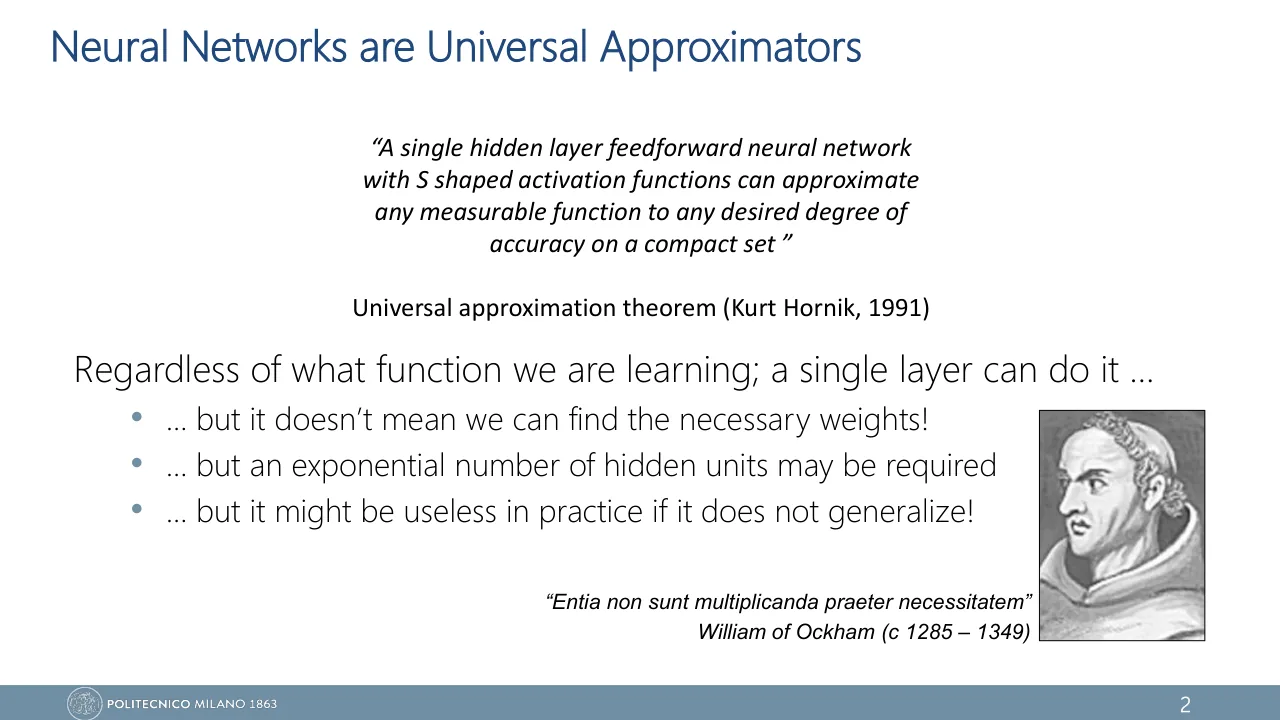
- "… but it doesn't mean we can find the necessary weights!" — веса существуют, но их ещё надо найти;
- "… but an exponential number of hidden units may be required" — нейронов может понадобиться экспоненциально много;
- "… but it might be useless in practice if it does not generalize!" — сеть бесполезна, если не умеет обобщать.
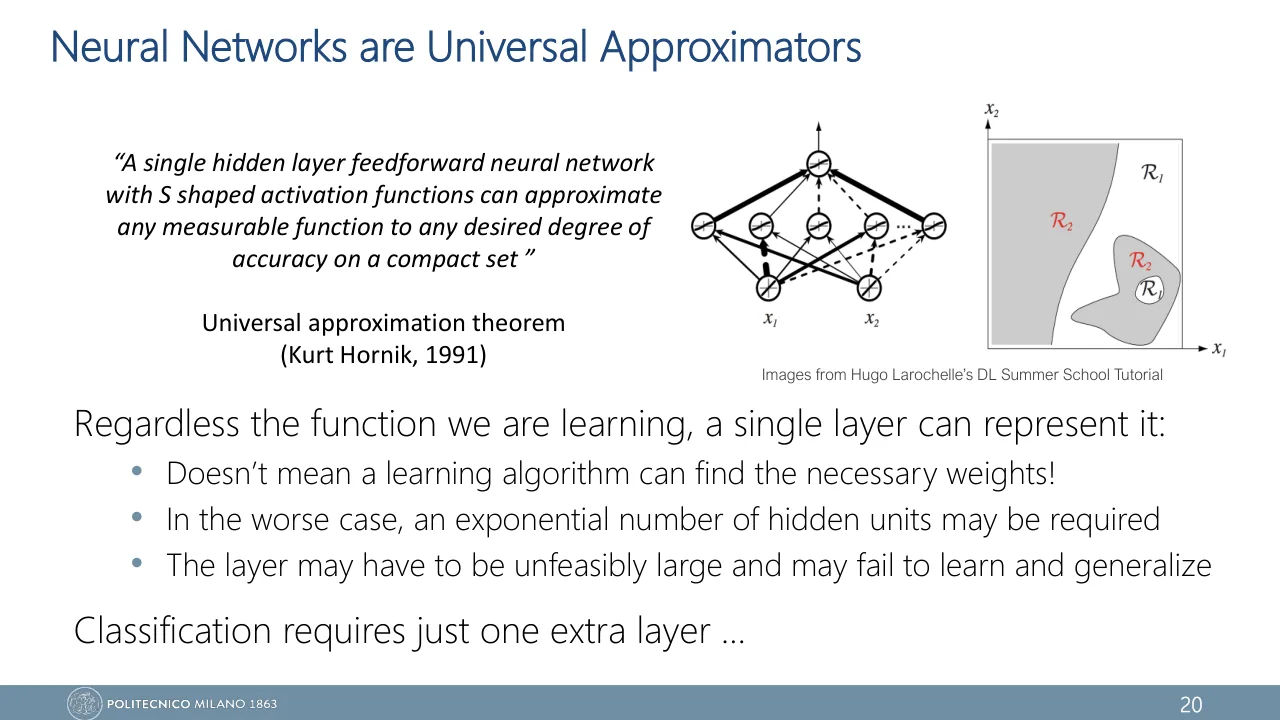
Первые два «but» разобраны в уроке 12. Третье в лекции 2 звучало иначе: "The layer may have to be unfeasibly large and may fail to learn and generalize" (лекция 2, слайд 20). Теперь от него осталось главное слово — generalize: хорошо работать на точках, которых при обучении не было. Вся третья глава — про это одно слово.
Начнём с того, из чего сделаны данные. Обучающие точки — не сама закономерность. Это закономерность плюс случайные отклонения:
- \(t_n\)
- target: то, что измерили
- \(f\)
- истинная функция — закономерность, которую хочется выучить и которую никто не видит. У профессора это target function (лекция 3, слайд 3), в конспекте — true function
- \(\epsilon_n\)
- шум (noise): случайная добавка со средним 0 и дисперсией \(\sigma^2\)
Сеть получает только числа \(t_n\). Где в каждом из них закономерность, а где случайность, не подписано. Жёсткая модель шум пропустит: ей нечем под него изогнуться. Гибкая модель умеет изобразить что угодно — значит, изобразит и шум.
У двух крайних случаев есть имена. На экзамене они нужны по-английски.
Underfitting (недообучение) — модель слишком проста для структуры данных. Ошибка велика уже на обучающих точках и поэтому велика на новых.
Overfitting (переобучение) — модель выучила не только закономерность, но и шум обучающих точек. На них ошибка очень мала, на новых данных — велика.
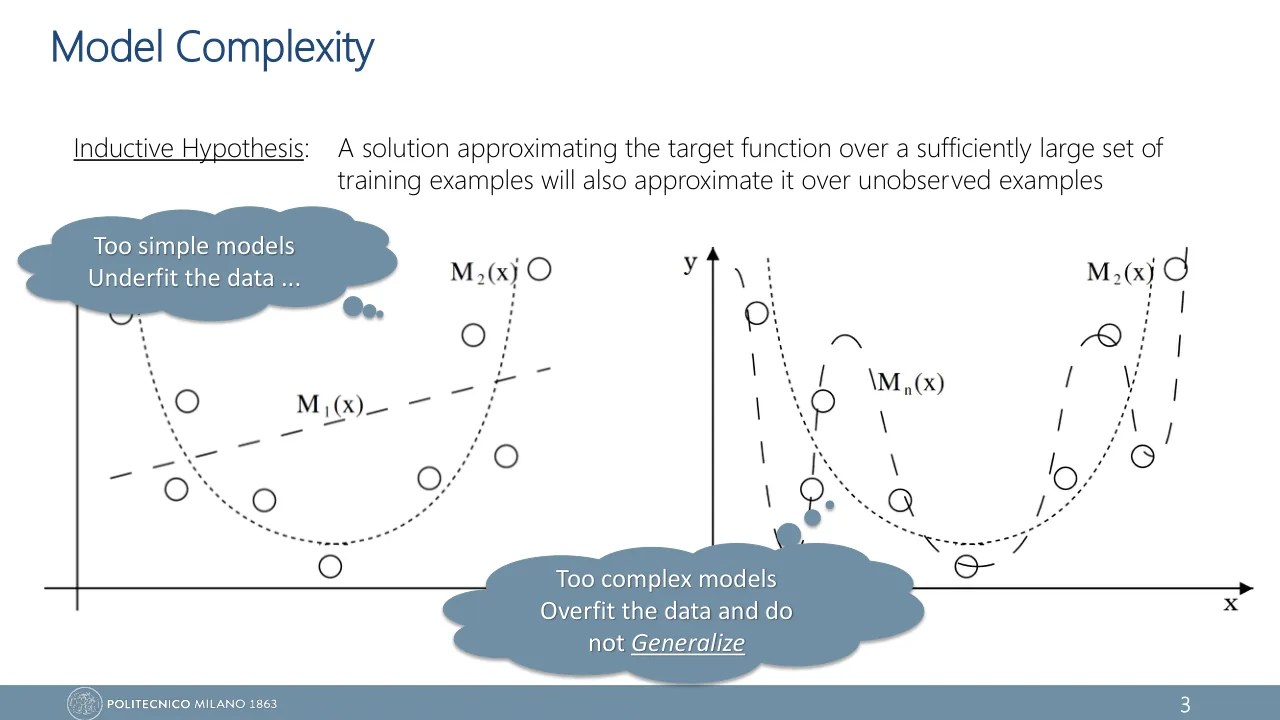
У профессора оба определения сжаты до двух подписей к картинке (лекция 3, слайд 3): "Too simple models Underfit the data ..." и "Too complex models Overfit the data and do not Generalize". Во второй подписи два утверждения сразу: модель подогнала обучающие данные и при этом не обобщает. Сама картинка со слайда — на рис. 2 в следующем разделе.
| Режим | Training error | На новых данных |
|---|---|---|
| underfitting | высокая | высокая |
| good fit | низкая | чуть выше |
| overfitting | очень низкая | высокая |
Конспект сравнивает overfitting с зубрёжкой: кто заучил ответы к прошлогодним задачам, решит их блестяще и провалится на новых. Underfitting — другая беда: тема не понята вовсе, плохо и на старых задачах, и на новых.
Что именно срезает бритва
Из рис. 1 напрашивается правило, которое связывают с именем Уильяма Оккама. У профессора оно стоит сразу под тремя «but», на латыни и рядом с портретом автора (лекция 3, слайд 2): "Entia non sunt multiplicanda praeter necessitatem", подпись — William of Ockham (c 1285 – 1349). Перевод: «не следует умножать сущности без необходимости». Больше про Оккама на слайде ничего нет: что фраза значит для моделей, договаривает конспект (стр. 124 и 126).
Бритва Оккама (Ockham's razor) в машинном обучении: из моделей, которые объясняют обучающие данные, выбирай наименее сложную, которая всё ещё хорошо работает на новых данных.
«Бритва Оккама велит брать модель попроще». Нет: самую простую из тех, что объясняют данные. Прямая на рис. 1 проще всех и не объясняет ничего. Бритва срезает лишнюю сложность, а не нужную.
Underfitting — не всегда маленькая сеть
У сети причин для underfitting больше, чем у полинома. Конспект перечисляет пять:
- слишком мало нейронов или слоёв;
- обучение остановили слишком рано;
- learning rate слишком велик, и gradient descent не сходится;
- слишком сильная регуляризация: большой weight decay, много dropout;
- неинформативные признаки или забытая нормализация входов.
«Training error высокая — значит, сети не хватает нейронов». Только первая причина из пяти — про размер. Вторая и третья — про оптимизацию: сеть могла бы выучить данные, но gradient descent до этого не дошёл. Прежде чем добавлять слои, посмотри, падает ли ещё ошибка.
Две ошибки: на своих точках и на новых
У каждой модели на рис. 1 есть две разные ошибки. Одну мы умеем считать. Другая нам на самом деле нужна.
- \(\hat E_{\text{train}}\)
- training error: средний квадрат ошибки на \(N\) обучающих точках. Это число у нас есть
- \(E\)
- generalization error, она же true error: ожидаемая ошибка на новой точке \((x, t)\) из того же источника данных. Это число нам нужно
- \(g(x|\vb{w})\)
- выход сети с весами \(\vb{w}\); в конспекте он записан как \(f(x; w)\)
Посчитать \(E\) нельзя: для этого нужны все возможные точки. Её можно только оценить по точкам, которых модель не видела. Такую оценку называют test error, и ей посвящён следующий урок. Пока вопрос проще: когда маленькая \(\hat E_{\text{train}}\) обещает маленькую \(E\)?
Inductive hypothesis (индуктивная гипотеза), слово в слово со слайда (лекция 3, слайд 3): "A solution approximating the target function over a sufficiently large set of training examples will also approximate it over unobserved examples".
По-русски: решение, которое приближает целевую функцию на достаточно большом наборе обучающих примеров, будет приближать её и на примерах, которых оно не видело. В символах урока: при достаточно большом \(N\) маленькая \(\hat E_{\text{train}}\) обещает маленькую \(E\). Конспект (стр. 128) пишет ещё короче: \(\hat E_{\text{train}} \approx E\).
Три слова слайда в обозначениях урока. Solution — найденная модель \(g(x|\vb{w})\): сеть с весами, которые выдало обучение. Target function — истинная функция \(f\); не путай её с target \(t_n\), одним измеренным значением. Unobserved examples — новые точки, которых не было среди обучающих; их же называют unseen data.
Под гипотезой на том же слайде две картинки. Это не украшение: они показывают два способа не выполнить её условие.
"Too simple models Underfit the data ..."
"Too complex models Overfit the data and do not Generalize"
Обозначения \(M_1\), \(M_2\), \(M_n\) слайд не расшифровывает. По форме кривых индекс читается как степень полинома — та же ручка сложности, что на рис. 1. \(M_1\) — наша степень 1. \(M_2\) — модель подходящей сложности; на рис. 1 это степень 3, потому что там закономерность — синус, а не парабола. \(M_n\) — степень настолько высокая, что кривая проходит через каждую точку: на рис. 2 для девяти точек это степень 8, в лаборатории ниже для пятнадцати — степень 14. Истинной функции на слайде нет вовсе: её никто не видит, видны только кружки.
Теперь приложи к рис. 2 гипотезу. Прямая \(M_1\) не приближает даже обучающие примеры: посылка не выполнена, и обещать про новые точки нечего. Это underfitting. У \(M_n\) ошибка на обучающих примерах нулевая, но девять точек для модели с девятью коэффициентами — не "sufficiently large set". Посылка снова не выполнена, и вывод не сбывается: между точками кривая уходит от закономерности. Это overfitting. Параболе \(M_2\) с тремя коэффициентами тех же девяти точек хватает.
Отсюда и заголовок слайда — "Model Complexity": хватит ли примеров, зависит от сложности модели, которую по ним подгоняют.
Без этой гипотезы учиться на примерах бессмысленно. На слайде её условие умещается в два слова — "sufficiently large". Конспект (стр. 128) называет три условия, и каждое может сломаться:
- обучающие и новые точки i.i.d. — независимы и взяты из одного распределения. Ломается при distribution shift;
- точек много по сравнению с гибкостью модели. Ломается на маленьком датасете;
- модель ловит закономерность, а не шум. Ломается при слишком высокой сложности.
Откуда третье условие? Если бы веса выбрали заранее, не глядя на данные, \(\hat E_{\text{train}}\) была бы честной оценкой \(E\): среднее по выборке сходится к ожиданию. Но веса выбраны как раз так, чтобы \(\hat E_{\text{train}}\) стала как можно меньше — на этих самых точках. Число, по которому оптимизировали, перестаёт быть честным измерением. Насколько оно занижено, зависит от того, сколько у модели свободы.
Из Applied Statistics это знакомо: \(R^2\) на обучающих данных не убывает, сколько регрессоров ни добавляй, — потому и придумали adjusted \(R^2\). Теперь посмотри на то же самое вживую.
Почему training error не может вырасти? Полином степени \(d + 1\) умеет всё, что умеет полином степени \(d\): достаточно обнулить старший коэффициент. Значит, лучшая подгонка в большем семействе не хуже. С сетью так же: добавь скрытый нейрон с нулевым выходным весом — получится прежняя функция. Поэтому training error годится, чтобы подбирать веса, и не годится, чтобы выбирать сложность.
Training error с ростом сложности только падает; ошибка на новых данных сначала падает, потом растёт.
«Обучающие и тестовые данные из одного распределения — значит, \(E_{\text{test}} \approx E_{\text{train}}\)». Так выглядит формула (53) конспекта на стр. 130, и в таком виде она обещает лишнее. В лаборатории обе ошибки считаются по данным из одного источника — та же функция, тот же отрезок, тот же шум — при любой степени, но при степени 14 одна равна нулю, другая больше 120. Одно распределение — условие необходимое, а не достаточное: ещё нужно, чтобы точек было много по сравнению с гибкостью модели.
Что считается сложностью у сети
В лаборатории ручка сложности одна — степень. У сети их несколько, и конспект называет их общий результат словом capacity (ёмкость): способность модели подстроиться под данные.
- Число параметров — весов \(w_{ji}^{(l)}\) вместе со смещениями: больше нейронов, больше свободы.
- Глубина: больше слоёв — более сложные функции.
- Нелинейности: без них сеть остаётся линейной моделью, сколько слоёв ни ставь.
- Регуляризация — единственный пункт списка, который сложность уменьшает.
К списку стоит добавить две ручки, которые не меняют архитектуру, но меняют эффективную гибкость: величину весов (её ограничивает weight decay, урок 22) и время обучения (early stopping, урок 20). Большая сеть, остановленная рано, ведёт себя как более простая.
Из чего состоит ошибка на новых данных
Третий опыт в лаборатории показал странную вещь: гибкая модель на другой выборке — уже другая модель. Сделаем из этого наблюдения формулу. Мысленный эксперимент такой: одну и ту же модель обучают много раз, каждый раз на новой обучающей выборке \(D\) из того же источника.
Жёсткая модель: степень 1
Гибкая модель: степень 12
Теперь зафиксируем одну точку \(x\) и спросим у каждой обученной модели её ответ в этой точке. Ответы разные, потому что выборки разные. У этого облака ответов есть центр и есть разброс — больше нам ничего не понадобится.
- \(g_D(x)\)
- ответ модели, обученной на выборке \(D\), то есть \(g(x|\vb{w}_D)\); в конспекте \(\hat f(x)\)
- \(\E_D\)
- среднее по всем возможным обучающим выборкам — не по точкам \(x\) и не по эпохам
- \(\bar g(x)\)
- средний ответ, «средняя модель»
- \(f(x)\)
- истинная функция
Bias — систематическая ошибка: насколько средняя модель промахивается мимо истины. Он велик, когда модели не хватает гибкости, и новыми данными не лечится.
Variance — чувствительность к выборке: насколько ответ прыгает, когда обучающие точки заменяют другими из того же источника. Она велика, когда модель подстраивается под шум.
Noise \(\sigma^2\) — разброс самих измерений вокруг \(f(x)\). От модели он не зависит, поэтому его называют irreducible error.
Bias — куда модель целится в среднем; variance — насколько дрожит её рука.
«Bias — это тот самый \(w_0\)». Слово то же, вещь другая. В главе 2 bias был весом \(w_0\), смещением одного нейрона. Здесь bias — свойство всей модели: систематический промах её среднего ответа.
Три выстрела в одну точку
Посчитаем на числах. В точке \(x_0\) истинное значение \(f(x_0) = 2.0\), шум измерений \(\sigma^2 = 0.25\). Есть три модели разной гибкости. Каждую обучили на трёх выборках и записали её ответ в \(x_0\): жёсткая ответила 1.0, 1.4 и 1.2; средняя — 1.7, 2.2 и 1.8; гибкая — 1.0, 3.2 и 1.8.
Для средней модели, шаг за шагом:
\[ \bar g = \frac{1.7 + 2.2 + 1.8}{3} = 1.9 \] \[ \text{Bias}^2 = (1.9 - 2.0)^2 = 0.01 \] \[ \text{Var} = \frac{0.2^2 + 0.3^2 + 0.1^2}{3} = 0.047 \]| Модель | \(\bar g\) | \(\text{Bias}^2\) | \(\text{Var}\) | Сумма |
|---|---|---|---|---|
| жёсткая | 1.2 | 0.640 | 0.027 | 0.917 |
| средняя | 1.9 | 0.010 | 0.047 | 0.307 |
| гибкая | 2.0 | 0.000 | 0.827 | 1.077 |
В variance делят на число выборок, а не на «число минус один»: это среднее по определению, а не несмещённая оценка из Applied Statistics. Проверка для средней модели: средний квадрат отклонения ответов от истины \((0.3^2 + 0.2^2 + 0.2^2)/3 = 0.057\) — ровно \(0.010 + 0.047\).
Выигрывает средняя модель, хотя у неё нет рекорда ни по одному слагаемому. Последний столбец получен простым сложением, и это не приём для примера, а точное равенство.
- слева
- ожидаемая квадратичная ошибка в точке \(x\) на новом измерении \(t = f(x) + \epsilon\); усреднение по обучающим выборкам \(D\) и по шуму \(\epsilon\)
- в конспекте
- та же формула записана с \(y\) вместо \(t\) и \(\hat f(x)\) вместо \(g_D(x)\) и не говорит, по чему берётся ожидание
Конспект даёт формулу без вывода. Вывод короткий, и в нём всего два приёма: «добавить и вычесть» и «среднее от отклонения равно нулю».
-
Новое измерение — это закон плюс шум. Чтобы не тащить аргумент, пишем \(f\), \(g_D\), \(\bar g\) вместо значений в точке \(x\). Ошибка модели на новой точке:
\[ t - g_D = (f - g_D) + \epsilon \] -
Возводим в квадрат и берём ожидание. Получаются три слагаемых:
\[ \begin{aligned} \E\bigl[(t - g_D)^2\bigr] = {} & \E\bigl[(f - g_D)^2\bigr] \\ & + 2\,\E\bigl[\epsilon\,(f - g_D)\bigr] \\ & + \E\bigl[\epsilon^2\bigr] \end{aligned} \] -
Шум нового измерения не зависит от обучающей выборки и в среднем равен нулю. Поэтому среднее произведения распадается на произведение средних и исчезает, а \(\E[\epsilon^2]\) — это дисперсия шума:
\[ \E\bigl[\epsilon\,(f - g_D)\bigr] = \E[\epsilon]\cdot\E[f - g_D] = 0 \] \[ \E\bigl[\epsilon^2\bigr] = \sigma^2 \] -
Осталось первое слагаемое. Добавим и вычтем средний ответ \(\bar g\):
\[ f - g_D = (f - \bar g) + (\bar g - g_D) \]Первая скобка — число: от выборки она не зависит. Вторая — отклонение модели от собственного среднего.
-
Снова квадрат и ожидание по \(D\). Перекрёстный член исчезает, потому что \(\E_D[\bar g - g_D] = \bar g - \bar g = 0\) по определению \(\bar g\):
\[ \begin{aligned} \E_D\bigl[(f - g_D)^2\bigr] = {} & (f - \bar g)^2 \\ & + \E_D\bigl[(g_D - \bar g)^2\bigr] \end{aligned} \] -
Собираем всё вместе и узнаём определения:
\[ \begin{gathered} \E\bigl[(t - g_D)^2\bigr] = \underbrace{(\bar g - f)^2}_{\text{Bias}^2} \\ {} + \underbrace{\E_D\bigl[(g_D - \bar g)^2\bigr]}_{\text{Var}} + \underbrace{\sigma^2}_{\text{noise}} \end{gathered} \]Ни одно слагаемое не отрицательно, и ни одно не превращается в другое: это три независимых источника ошибки.
«Variance — это шум в данных». Шум \(\sigma^2\) — свойство данных, от модели он не зависит. Variance — свойство модели: насколько сильно она этот шум усиливает. Во второй лаборатории (она в следующем разделе) при одном и том же \(\sigma^2 = 0.09\) у прямой variance равна 0.012, а у полинома степени 12 — 1.02.
Trade-off: что двигает оптимум
В таблице про три выстрела bias и variance двигались в противоположные стороны. Это не совпадение, а типичная картина, и у неё есть имя: bias–variance trade-off. Посмотри на него в той же задаче с полиномами.
Итог двух лабораторий помещается в таблицу. В конспекте это Table 1; здесь в ней заменено одно слово.
| Сложность | Bias | Variance |
|---|---|---|
| низкая (underfitting) | высокий | низкая |
| оптимальная | умеренный | умеренная |
| высокая (overfitting) | низкий | высокая |
«Оптимум — там, где bias и variance сравнялись». Так легко прочитать подпись к Table 1 на стр. 130 конспекта: "The optimal model complexity is where bias and variance are balanced", и в самой таблице в строке оптимума дважды стоит Balanced. Равенства в оптимуме нет: оптимум — это минимум суммы \(\text{Bias}^2 + \text{Var}\). Во второй лаборатории при оптимальной степени 3 слагаемые равны 0.005 и 0.022: разница почти в пять раз. Уравновешены в минимуме не сами слагаемые, а их изменения: следующий шаг сложности убавляет \(\text{Bias}^2\) меньше, чем прибавляет variance. Поэтому в таблице выше вместо Balanced стоит «умеренный».
Три ручки помимо сложности
Третий и четвёртый опыты показали, что сложность — не единственное, от чего зависит overfitting. Вот полный список с направлениями.
| Что растёт | \(\text{Bias}^2\) | \(\text{Var}\) | Overfitting |
|---|---|---|---|
| параметры | падает | растёт | сильнее |
| данные \(N\) | — | падает | слабее |
| шум \(\sigma^2\) | — | растёт | сильнее |
| регуляризация | растёт | падает | слабее |
Вторая строка — главная практическая новость: variance убывает примерно как \(1/N\). Поэтому одна и та же сеть на маленьком датасете переобучается, а на большом нет. Последняя строка — план следующих уроков: early stopping (урок 20), weight decay (урок 22) и dropout (урок 23) в умеренной дозе покупают большое снижение variance ценой небольшого bias. Перестараться тоже можно: слишком сильная регуляризация — четвёртая причина underfitting из списка в первом разделе.
«Оптимум — там, где кривые пересекаются». На рис. 16 конспекта (стр. 131) training error сначала нарисована выше test error, кривые пересекаются, и отметка оптимума стоит рядом с пересечением. Это случайность нарисованных шумных кривых. Оптимум — минимум test-кривой, как и сказано в подписи к тому рисунку; на рис. 5 кривые не пересекаются вовсе.
У сети есть ещё одна ось сложности — время обучения: чем дольше идёт gradient descent, тем точнее подогнаны обучающие точки. Поэтому рис. 5 повторяется с эпохами по горизонтали. Такой график есть на стр. 126 конспекта, и на нём основан early stopping из урока 20.
Всегда ли больше параметров — больше overfitting?
Нет. Во-первых, эффективную сложность задаёт не только число параметров: регуляризация и ранняя остановка удерживают и большую сеть. Во-вторых, у очень больших сетей наблюдают double descent: за пиком ошибка на новых данных снова снижается. Это за пределами конспекта и на экзамен не выносится. Знать и уметь объяснить нужно классическую U-образную кривую.
Вернёмся к слону
Теперь слова фон Неймана читаются как утверждение о training error. Четыре параметра проходят через четыре точки. Пятнадцать — через пятнадцать: в первой лаборатории это степень 14. Сеть из урока 12 — через сколько угодно. Согласие с точками, под которые модель подгоняли, — не довод: при достаточном числе параметров оно гарантировано заранее.
Universal approximation theorem и бритва Оккама отвечают на разные вопросы. Теорема — про то, что сеть может представить. Бритва — про то, что сеть выучит из \(N\) шумных точек. Гибкость снижает bias, но платят за неё variance, и тем дороже, чем меньше данных и чем больше в них шума. Отсюда и приговор Ферми: достоинство теоремы становится недостатком ровно тогда, когда свободы у модели больше, чем могут удержать данные.
А довод — это ошибка на точках, которые в подгонке не участвовали. Весь остаток главы 3 — инструменты: как такую ошибку честно измерить (уроки 18–19) и как удержать variance, не вернув bias (уроки 20–23).
Слона, кстати, можно посмотреть: рисунок 2010 года и вся история собраны в статье Von Neumann's elephant.
В формате экзамена
Define underfitting and overfitting. How do you recognize each of them from the training error and the error on unseen data?
Show model answer
Underfitting: the model is too simple (or not trained enough) to capture the structure of the data. Both the training error and the error on unseen data are high.
Overfitting: the model is too complex for the available data: it fits the random noise of the training set in addition to the underlying pattern, so it does not generalize. The training error is very low, while the error on unseen data is much higher.
As model complexity grows, the training error keeps decreasing, whereas the error on unseen data first decreases and then increases. The best complexity is at the minimum of the error on unseen (validation) data.
Проверяют три вещи: в каждом определении названы обе ошибки; в определении overfitting есть слово noise; сказано, что диагноз требует данных, не участвовавших в обучении. Ответ «overfitting — когда ошибка на тесте большая» — половина балла: то же верно для underfitting. Формулировки профессора (лекция 3, слайд 3) стоит помнить дословно: "Too simple models Underfit the data ..." и "Too complex models Overfit the data and do not Generalize".
State the inductive hypothesis on which learning from examples relies. Under which conditions can it be trusted, and what makes it fail?
Show model answer
A solution approximating the target function over a sufficiently large set of training examples will also approximate it over unobserved examples. In terms of errors: with enough training examples, a small training error implies a small expected (true) error, \(\hat E_{\text{train}} \approx E\).
It can be trusted when (i) training examples and unobserved examples are i.i.d. samples from the same distribution, (ii) the training set is sufficiently large compared with the complexity of the model, and (iii) the model captures the underlying structure rather than the noise.
It fails under distribution shift, with a small dataset, and with a model that is too complex for the data. The weights are chosen to minimize the error on those very training points, so the training error is an optimistic estimate of the true error, and the gap grows with model complexity: overfitting.
Баллы — за само утверждение и за условия. Первая фраза ответа — дословно со слайда (лекция 3, слайд 3); её опорные слова — target function, sufficiently large set, unobserved examples. Не называй это inductive bias: так делает конспект (стр. 128 и 130), а на слайде стоит только Inductive Hypothesis. Inductive bias — другое понятие: предпочтения самого алгоритма, например бритва Оккама.
A feed-forward neural network with one hidden layer is a universal approximator. Explain why this does not guarantee good generalization, and what Ockham's razor suggests.
Show model answer
The theorem is an existence statement about what the network can represent: with enough hidden units it can approximate any continuous (more generally, measurable) function on a compact set to any desired degree of accuracy (Hornik, 1991). A single layer can do it, but it doesn't mean we can find the necessary weights, an exponential number of hidden units may be required, and it might be useless in practice if it does not generalize. The theorem says nothing about what is learned from a finite, noisy training set.
A model that can represent anything can also represent the noise in the training targets, so a very low training error can be reached without learning the underlying function: overfitting.
Ockham's razor, "Entia non sunt multiplicanda praeter necessitatem" (entities must not be multiplied beyond necessity): among the models that explain the training data, prefer the least complex one that still generalizes. In practice: select the model on held-out data, limit the number of units, or regularize (weight decay, early stopping, dropout).
Экзаменатор ждёт противопоставления «represent — learn» и слова noise. Частая ошибка — пересказать теорему и остановиться: вопрос не о ней, а о том, чего она не обещает. У профессора теорема, три «but» и латинская фраза Оккама стоят на одном слайде (лекция 3, слайд 2); первая половина вопроса — это третье «but»: "… but it might be useless in practice if it does not generalize!"
At a query point \(x_0\) the true function value is \(f(x_0) = 2.0\) and the noise variance is \(0.25\). The same model is trained on three different training sets and predicts \(1.7\), \(2.2\) and \(1.8\) at \(x_0\). Treating these three runs as the expectation over training sets, compute the expected squared error on a new noisy target at \(x_0\).
Show model answer
Mean prediction, squared bias and variance over the three training sets:
\[ \bar g = \frac{1.7 + 2.2 + 1.8}{3} = 1.9 \] \[ \text{Bias}^2 = (1.9 - 2.0)^2 = 0.01 \] \[ \text{Var} = \frac{0.04 + 0.09 + 0.01}{3} = 0.0467 \]Expected squared error = bias² + variance + noise:
\[ 0.01 + 0.0467 + 0.25 = 0.307 \]Две ловушки: забыть прибавить шум (получится 0.057) и поделить в variance на 2 вместо 3 (получится 0.33). Обе дают ответ вне допуска.
Write the bias–variance decomposition of the expected squared error at a point \(x\). Define each term, state what the expectations are taken over, and say how the terms change with model complexity.
Show model answer
Let \(t = f(x) + \epsilon\), where the noise \(\epsilon\) has zero mean and variance \(\sigma^2\) and is independent of the training set. Let \(g_D\) be the model trained on training set \(D\), and \(\bar g(x) = \E_D[g_D(x)]\) its average prediction. Then
\[ \begin{gathered} \E\bigl[(t - g_D(x))^2\bigr] = \bigl(\bar g(x) - f(x)\bigr)^2 \\ {} + \E_D\bigl[(g_D(x) - \bar g(x))^2\bigr] + \sigma^2 . \end{gathered} \]The expectations are taken over training sets \(D\) (and over the noise of the new target).
Bias²: systematic error of the average model; high for models that are too simple. Variance: sensitivity of the prediction to the particular training set; high for models that are too flexible. Noise \(\sigma^2\): irreducible, independent of the model.
Increasing complexity lowers the bias and raises the variance, so the expected error is U-shaped; the best complexity minimizes bias² + variance. More training data reduces the variance only.
Полный балл — за квадрат у bias, за третье слагаемое и за фразу «over training sets». Если на экзамене просят вывод, хватит двух шагов из степпера: отделить шум и добавить-вычесть \(\bar g\).
A network clearly overfits: its training error is 0.01 and its validation error is 0.30. Which of the following are expected to reduce the variance term? Select all that apply.
Show model answer
More data, fewer hidden neurons and weight decay. The other two options increase the effective complexity of the model and therefore its variance.
Вопрос проверяет, что ты связываешь overfitting именно с variance и помнишь четыре строки таблицы из раздела про trade-off.
Four networks with \(J\) hidden neurons are trained on the same data. The noise variance of the targets is about 0.09. Which one do you select?
| \(J\) | Training MSE | Validation MSE |
|---|---|---|
| 2 | 0.28 | 0.30 |
| 5 | 0.10 | 0.11 |
| 20 | 0.04 | 0.15 |
| 100 | 0.00 | 0.58 |
Show model answer
\(J = 5\): it has the lowest validation error, and both of its errors are close to the noise level. \(J = 2\) underfits (both errors high), \(J = 20\) and \(J = 100\) overfit (training error well below the noise level, growing gap).
Выбирают по validation, а не по training error. Уровень шума в условии — подсказка: training MSE заметно ниже него означает подгонку под шум.
Проверь себя
Сеть обучена. Training error 0.25, ошибка на отложенных данных 0.27, шум в данных оценивают в 0.05. Что это?
Что такое variance в bias–variance decomposition?
Модель переобучается. Что из перечисленного ослабит overfitting?
Четыре верных ответа — это четыре строки таблицы из раздела про trade-off, прочитанные в сторону уменьшения variance.
Где находится оптимальная сложность модели?
Обучающих точек стало в четыре раза больше, модель та же. Что произойдёт со слагаемыми ошибки?
Следствие: с ростом \(N\) оптимум сдвигается к более сложным моделям — во второй лаборатории со степени 3 на степень 5.
Полином степени 14 прошёл через все 15 обучающих точек, training error равна нулю. Что это говорит о модели?
Унести с собой
- Данные — это закономерность плюс шум. Модель, способная представить что угодно, подгонит и то и другое.
- Underfitting: обе ошибки высокие. Overfitting: training error очень мала, ошибка на новых данных велика.
- Inductive hypothesis: решение, которое приближает target function на достаточно большом наборе обучающих примеров, приближает её и на новых. Хватит ли примеров, зависит от сложности модели.
- Training error с ростом сложности только падает, ошибка на новых данных имеет минимум. Выбирать сложность по training error нельзя.
- Ожидаемая ошибка в точке равна \(\text{Bias}^2 + \text{Var} + \sigma^2\); ожидание берётся по обучающим выборкам.
- Сложность снижает bias и поднимает variance. Данные снижают variance. Шум поднимает variance и неустранимый пол. Регуляризация меняет немного bias на много variance.
- Бритва Оккама: из моделей, объясняющих данные, бери самую простую, которая ещё обобщает.
Что посмотреть и почитать
-
Machine Learning Fundamentals: Bias and Variance
StatQuest
Самое мягкое введение: прямая против извилистой кривой на одном наборе точек. Хорошо посмотреть до формул, чтобы слова bias и variance уже что-то значили.
-
The Bias Variance Tradeoff
MLU-Explain, Jared Wilber и Brent Werness
То же разложение на знакомых из Applied Statistics моделях: регрессия и k-NN. Два ползунка ведут вдоль U-образной кривой — полезно увидеть её не на полиномах.
-
TensorFlow Playground
Daniel Smilkov и Shan Carter
Overfitting на настоящей сети. Возьми сложный датасет, подними noise, уменьши долю обучающих данных, поставь самую большую сеть и следи за двумя числами: training loss и test loss.
-
Understanding the Bias-Variance Tradeoff
Scott Fortmann-Roe
Классическая картинка с четырьмя мишенями и то же разложение ошибки на английском — формулировки пригодятся для открытого вопроса на экзамене.
-
What the Books Get Wrong about AI [Double Descent]
Welch Labs
Почему у очень больших сетей U-образная кривая — не вся история. За пределами конспекта и экзамена; смотреть, когда классическая картина уже уложилась.