Когда нажать «стоп»
После этого урока ты по таблице validation error скажешь, после какой эпохи остановится обучение при заданном patience и чьи веса вернутся, — и объяснишь, почему простая остановка работает как регуляризация.
На слайде профессора правило остановки в early stopping занимает одну строку: "Stop train when validation error increases" (лекция 3, слайд 12). Конспект формулирует чуть иначе: обучение останавливают «right before the validation error starts to rise» — прямо перед тем, как ошибка на отложенных данных пойдёт вверх. Попробуй выполнить обе инструкции буквально.
На рисунке 18 того же конспекта validation loss уже в первые десять эпох делает скачок вверх: примерно с 0.45 до значения выше 0.55. Минимум кривой — на 57-й эпохе, и там она ниже 0.05. Остановка «при первом росте» вернула бы сеть, которая почти ничему не научилась.
Хорошо, первый рост пропустим. А как опознать тот самый? Что ошибка «начала расти», видно только после того, как она выросла. Чтобы остановиться «прямо перед» этим, надо знать будущее. К концу урока у тебя будет процедура, которая обходится без машины времени, — и станет ясно, почему единственный числовой пример конспекта на эту тему даёт неверный ответ.
Три способа не дать сети зубрить
В уроках 18 и 19 мы учились замечать переобучение: откладывать часть данных и смотреть, как модель ведёт себя на них. Это градусник. Теперь нужно лекарство.
Откуда берётся болезнь, известно с урока 12: Feed Forward Neural Network с достаточным числом скрытых нейронов приближает любую непрерывную функцию. Значит, ей по силам приблизить и шум в обучающей выборке. Когда весов много, а данных мало или они шумные, сеть не выучивает закономерность, а запоминает примеры — в конспекте это названо memorize rather than learn.
Представь подготовку к экзамену по сборнику прошлых вариантов. Помешать себе вызубрить ответы вместо предмета можно тремя способами:
- вовремя закончить подготовку — пока в голове ещё методы, а не «в варианте 7 ответ B»;
- штрафовать себя за длинные вычурные решения там, где хватает короткого;
- готовиться командой, из которой на каждую встречу случайно не приходит половина: никто не может полагаться на одного отличника.
У нейросетей эти три идеи называются early stopping, weight decay и dropout. Конспект (стр. 150) даёт им родовые имена: training control, model complexity control и randomization / model averaging.
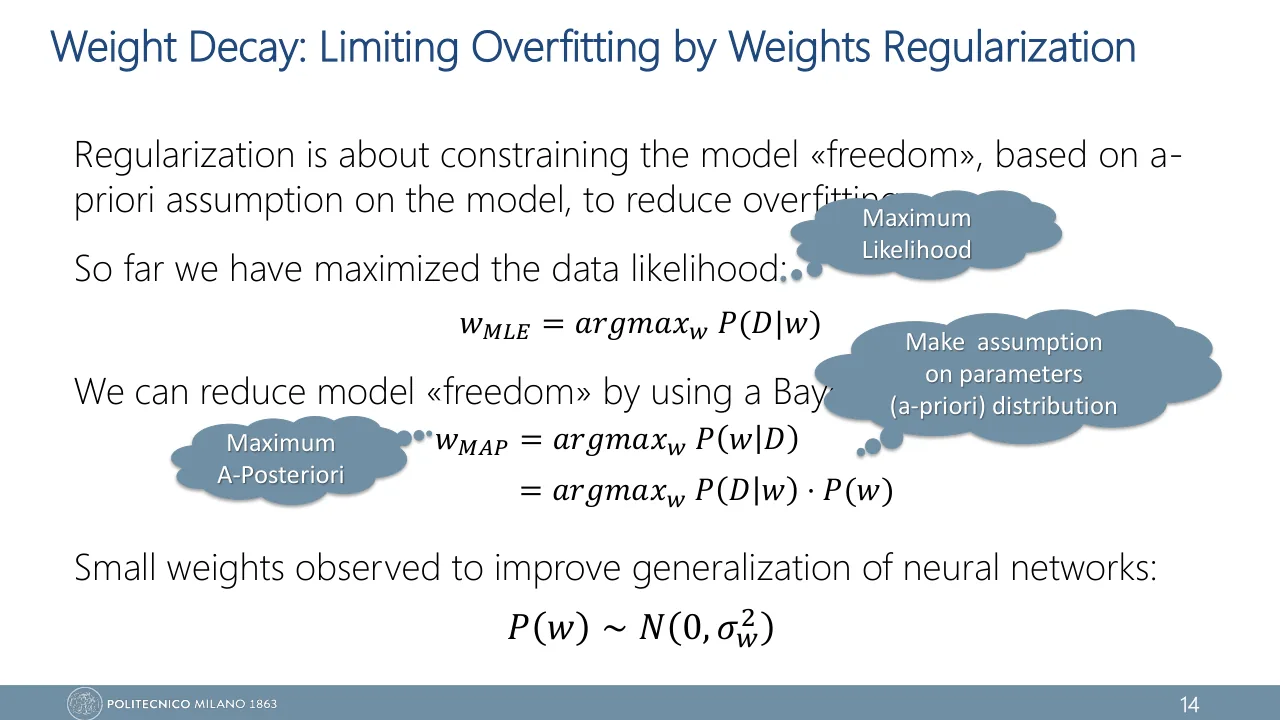
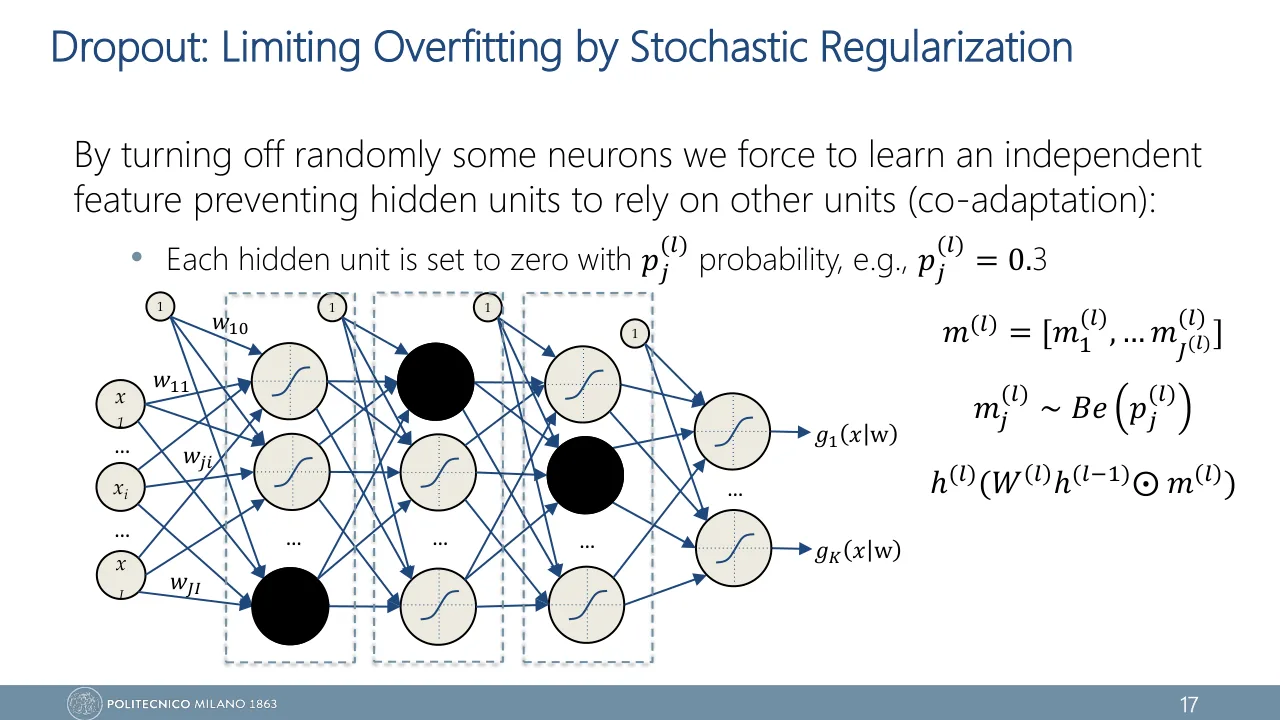
У профессора этот блок открывается титульным слайдом "Preventing Neural Networks Overfitting" (лекция 3, слайд 11), а родовое имя каждого метода стоит прямо в заголовке его слайдов. Early stopping — "Limiting Overfitting by Cross-validation" (слайд 12), weight decay — "… by Weights Regularization" (слайды 14–15), dropout — "… by Stochastic Regularization" (слайды 17–22). Эти три подзаголовка стоит помнить дословно: так методы могут быть названы в экзаменационном вопросе.
Общее у всех трёх — то, чего они не делают: ни один вес не удаляется. Параметров столько же, сколько было. Уменьшается другое.
Effective capacity (эффективная ёмкость) — множество функций, до которых обучение может добраться на деле. Номинальная ёмкость — все функции, которые архитектура способна представить при каких-нибудь весах; она от регуляризации не меняется.
Early stopping ограничивает, как долго сеть учится. Weight decay — насколько большими вырастают веса. Dropout — насколько нейроны опираются друг на друга. Все три — способы применить бритву Оккама из урока 17: из моделей, объясняющих данные, предпочесть самую простую.
Термин effective capacity взят из конспекта, на слайдах его нет. Там та же мысль сказана проще: регуляризация ограничивает «freedom» модели, чтобы уменьшить overfitting (лекция 3, слайд 14).
«Регуляризация — это когда у сети меньше параметров». Нет. Число весов \(w_{ji}^{(l)}\) до и после одно и то же; меньше становится область, в которой эти веса оказываются после обучения.
Почему бы просто не взять сеть поменьше?
Потому что нужный размер заранее неизвестен. Слишком маленькая сеть недообучится, и этого уже ничем не исправить. Большую сеть можно придержать, и на практике большая сеть с регуляризацией обычно обобщает лучше, чем маленькая без неё.
Четвёртого лекарства в списке нет. Подбор гиперпараметров (урок 21) — не лекарство, а способ выбрать дозу каждого из трёх: patience, коэффициент \(\gamma\), долю выключаемых нейронов. Сегодня — первое и самое дешёвое средство.
Две кривые: как переобучение выглядит во времени
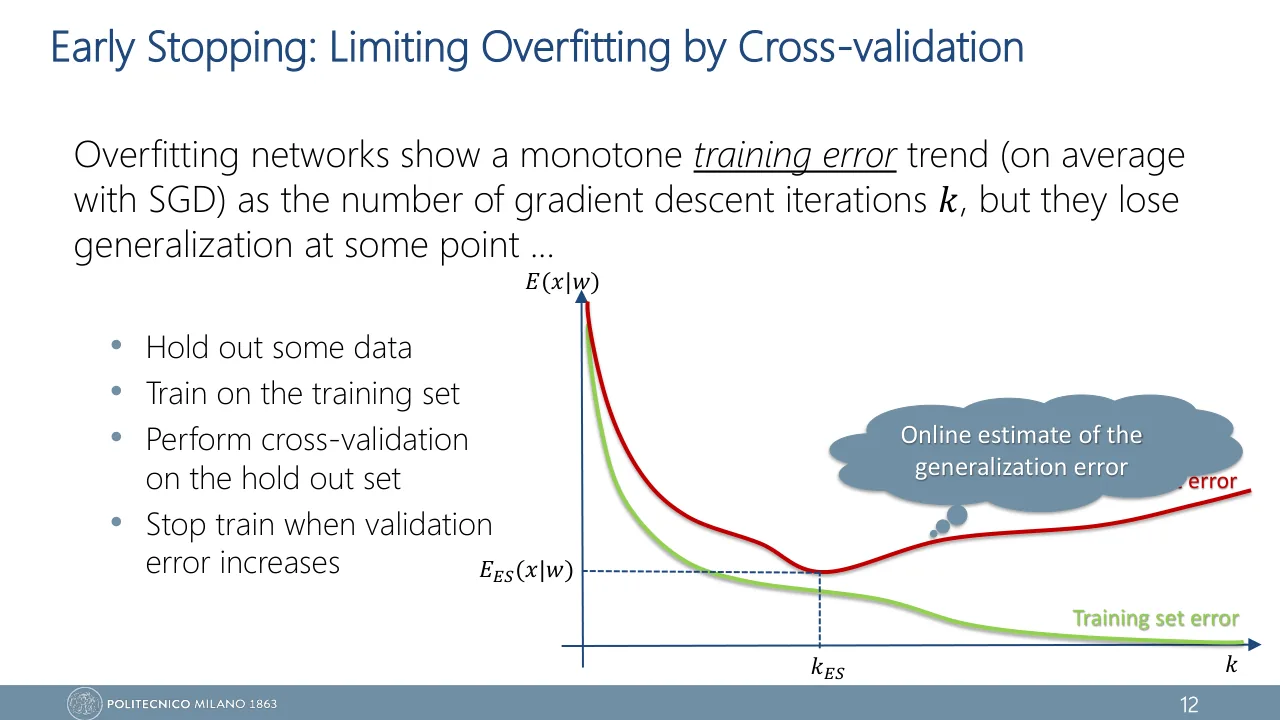
Чтобы вовремя остановиться, нужен прибор. У профессора он умещается на одном слайде — "Early Stopping: Limiting Overfitting by Cross-validation" (лекция 3, слайд 12). Вся процедура там — четыре строки:
- "Hold out some data" — отложить часть данных: это validation set из урока 18;
- "Train on the training set" — вести спуск только по оставшимся данным;
- "Perform cross-validation on the hold out set" — по ходу обучения считать ошибку на отложенных данных;
- "Stop train when validation error increases" — остановить обучение, когда эта ошибка пошла вверх.
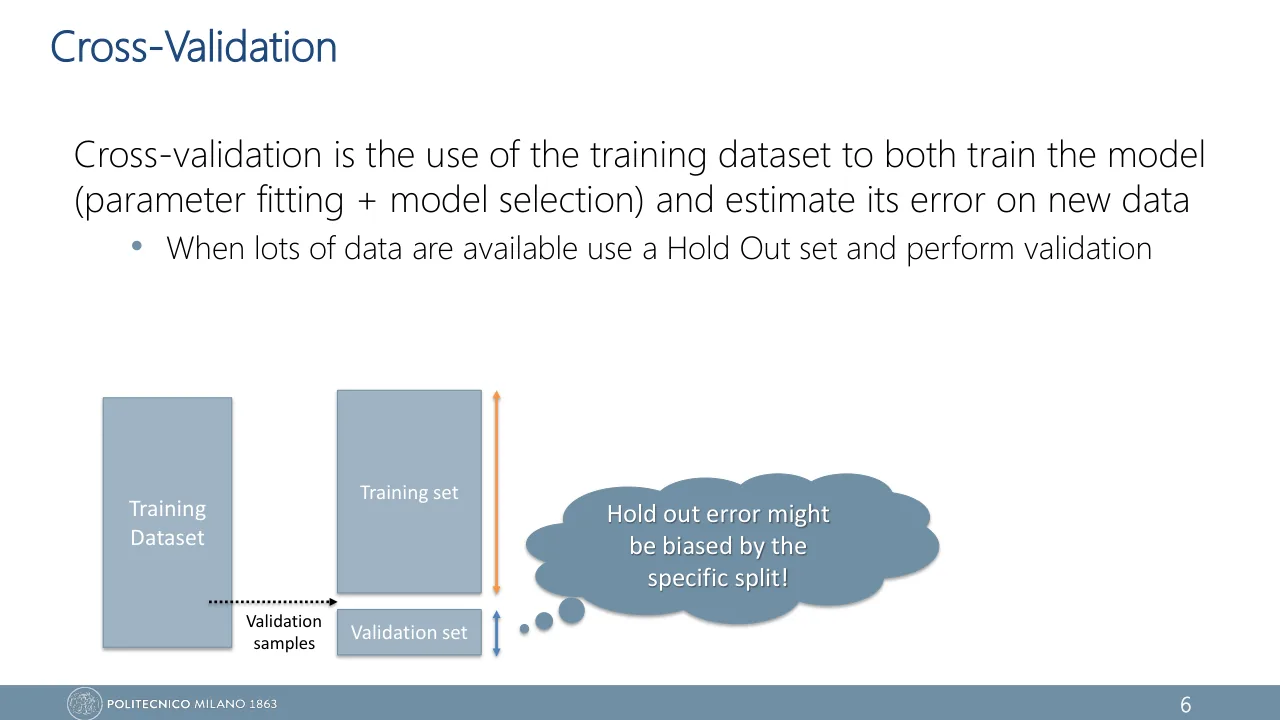
Слово cross-validation здесь не означает K-fold из урока 19. Профессор называет так любое использование training dataset и для обучения, и для оценки ошибки на новых данных, а первым вариантом у него идёт hold-out (лекция 3, слайд 6). Здесь именно он: одно разбиение, одно обучение.
Первые три строки и есть прибор. После каждой эпохи \(k\) error function считают дважды — на данных, по которым идёт спуск, и на отложенном validation set, который в вычислении градиента не участвует. Четвёртой строкой займётся следующий раздел.
- \(k\)
- номер эпохи
- \(\vb{w}^{k}\)
- веса после эпохи \(k\); верхний индекс — номер шага, не степень
- \(t_n\)
- target примера \(n\)
- \(g(x_n \mid \vb{w})\)
- выход сети на входе \(x_n\)
Здесь записана Sum of Squared Errors; для классификации на её месте стояла бы cross-entropy, остальное не меняется. В выборках разное число примеров, поэтому перед сравнением каждую сумму делят на размер своей выборки. На то, при каком \(k\) кривая достигает минимума, это не влияет.
На слайде у кривых нет отдельных букв. Обе отложены по одной оси \(E(x \mid w)\) — ошибка на данных \(x\) при весах \(w\) — и подписаны словами: "Training set error" и "Validation set error". Индексы train и val пришли из конспекта: с ними кривые удобнее различать в формулах. Буква \(k\) на слайде — "the number of gradient descent iterations". Ошибку на отложенных данных считают раз в эпоху, поэтому в этом уроке \(k\) нумерует эпохи; в batch gradient descent эпоха и есть одна итерация. Нарисуем обе величины против \(k\).
Training error убывает всё время. (С mini-batch — только «в среднем»: отдельные эпохи могут подпрыгивать, об этом урок 27.) Validation error сначала падает вместе с ней, а потом разворачивается. На слайде это одна фраза: у переобучающихся сетей — "a monotone training error trend (on average with SGD)", но в какой-то момент они "lose generalization" (лекция 3, слайд 12). Конспект называет такое расхождение the signature of overfitting.
Почему кривые расходятся? Пока сеть вытаскивает из данных закономерности, общие для обеих выборок, падают обе ошибки. Когда общее исчерпано, спуск не останавливается: он продолжает уменьшать \(E_{\mathrm{train}}\) за счёт особенностей конкретных обучающих примеров — их шума. У отложенных примеров шум свой, с обучающим никак не связанный. Подгонка под чужой шум им только вредит.
Эпоха \(k_{ES}\): модель близка к обеим выборкам
Последняя эпоха: модель выучила обучающие точки
Отсюда определение. Лучшая модель — не последняя, а та, что стоит на дне кривой validation.
Early stopping (ранняя остановка) — приём регуляризации: во время обучения следят за validation error и в качестве итоговой модели берут веса той эпохи \(k_{ES}\), на которой эта ошибка минимальна.
Первая строка — формула (54) конспекта. Третья — обозначение слайда: высота минимума подписана там на вертикальной оси как \(E_{ES}(x \mid w)\). В конспекте у этого числа своей буквы нет. Дальше оно встретится не раз, и писать его будем коротко: \(E_{ES}\).
Кривая \(E_{\mathrm{val}}(k)\) даёт оценку ошибки на новых данных прямо по ходу обучения, без единого повторного запуска. На слайде к ней приколото облачко "Online estimate of the generalization error" (лекция 3, слайд 12); конспект повторяет его, добавив слово true. «Online» — потому что оценка появляется во время обучения, а не после него. Облачко относится к кривой целиком, а не к одному числу \(E_{ES}\). Насколько можно верить кривой и насколько её минимуму, разберём в последнем разделе.
Признак переобучения — не маленькая training error, а расходящиеся кривые: training error падает, validation error растёт.
Patience и checkpoint: остановка с откатом
Формула (54) задаёт цель, а не алгоритм. Четвёртая строка слайда 12 лекции 3 — "Stop train when validation error increases" — уже алгоритм, но для гладкой кривой, какая на слайде и нарисована. Между ней и работающей процедурой стоят две трудности — те самые, что в задачке из начала урока.
Шум. Настоящая кривая validation не гладкая, а зубчатая: каждая эпоха заканчивается в слегка случайной точке, а отложенных примеров конечное число. Первый подъём почти наверняка зубец, а не разворот.
Причинность. Даже без шума минимум опознаётся только задним числом. Чтобы убедиться, что \(E_{\mathrm{val}}(57)\) — дно, нужно увидеть \(E_{\mathrm{val}}(58)\). К этому моменту веса уже другие.
Обе трудности снимает то, что знакомо по играм, — сохранение. Вернёмся к подготовке. Каждый вечер после занятий ты пишешь один и тот же пробный вариант, по которому не готовишься. Побит личный рекорд — «сохраняешься». Рекорд не побит \(P\) вечеров подряд — заканчиваешь и загружаешь последнее сохранение.
| В истории | В обучении |
|---|---|
| вечер занятий | эпоха \(k\) |
| сборник прошлых вариантов | training set |
| пробный вариант | validation set |
| сохранение при рекорде | checkpoint — копия весов |
| сколько вечеров ждать нового рекорда | patience \(P\) |
| настоящий экзамен | test set |
Patience (patience window, окно терпения) \(P\) — число эпох подряд без нового рекорда validation error, после которого обучение останавливают. Checkpoint — сохранённая копия весов эпохи, на которой был поставлен рекорд.
Теперь то же самое формулами. Рекорд к эпохе \(k\) — наименьшая validation error за всё прошедшее время:
\[ E_{\mathrm{best}}(k) = \min_{j \le k} E_{\mathrm{val}}(j) \]Эпоха \(k\) считается улучшением, если \(E_{\mathrm{val}}(k) \lt E_{\mathrm{best}}(k-1)\); первая эпоха — улучшение всегда. Пусть \(k_{\mathrm{best}}\) — эпоха последнего улучшения. Обучение останавливается на первой эпохе, для которой \(k - k_{\mathrm{best}} \ge P\), и возвращает веса \(\vb{w}^{k_{\mathrm{best}}}\). Целиком процедура выглядит так:
best = +inf;  wait = 0
for k = 1, 2, ...:
    train one epoch
    e = E_val(w)
    if e < best:
        best = e;  wait = 0
        save checkpoint
    else:
        wait = wait + 1
    if wait >= P:  stop
restore checkpoint
«Улучшение — это когда ошибка стала меньше, чем на прошлой эпохе». Нет: меньше, чем лучшая за всё время. Ошибка может три эпохи подряд понемногу снижаться после всплеска и так и не побить рекорд — счётчик wait всё это время растёт.
В Keras вся процедура — один объект, который передают в обучение:
EarlyStopping(monitor='val_loss',
              patience=10,
              restore_best_weights=True)
Последний аргумент и есть откат к checkpoint. По умолчанию он выключен, и тогда модель остаётся с весами последней эпохи.
Почему patience, а не сглаживание кривой?
Сгладить кривую скользящим средним и искать минимум уже у гладкой — тоже законный способ. Но у сглаживания свой гиперпараметр, ширина окна, и оно так же запаздывает на несколько эпох. Patience проще и встроен в библиотеки, поэтому обычно берут его.
«Обучение останавливают прямо перед подъёмом validation error». Так идею формулирует конспект (стр. 152), и про итоговую модель это верно: она взята с эпохи перед подъёмом. Про остановку — нет: о подъёме узнают, когда он уже случился. Строка слайда 12 лекции 3 аккуратнее: "Stop train when validation error increases" — это остановка уже после подъёма, а \(k_{ES}\) на рисунке слайда отмечен левее, в минимуме. Обучение идёт дальше минимума — в виджете линия «стоп» стоит правее checkpoint ровно на \(P\) эпох, — а потом веса возвращают к сохранённой копии. В экзаменационном ответе пиши строку слайда и расшифровывай её: «in practice, when it has not improved on its best value for \(P\) epochs; then the weights with the lowest validation error are restored».
Пример из конспекта — с исправлением
На стр. 153 конспекта дана validation loss для эпох 10–17 и задан вопрос: когда остановится обучение с patience 2? Пройдём таблицу по правилу из предыдущего раздела. Эпоха 10 в конспекте отмечена как улучшение, так что рекорд перед ней был хуже 0.40.
| Эпоха | \(E_{\mathrm{val}}\) | Рекорд побит? | \(E_{\mathrm{best}}\) | wait |
|---|---|---|---|---|
| 10 | 0.40 | да | 0.40 | 0 |
| 11 | 0.38 | да | 0.38 | 0 |
| 12 | 0.37 | да | 0.37 | 0 |
| 13 | 0.375 | нет | 0.37 | 1 |
| 14 | 0.373 | нет | 0.37 | 2 |
| 15 | 0.376 | нет | 0.37 | 3 |
| 16 | 0.379 | нет | 0.37 | 4 |
| 17 | 0.382 | нет | 0.37 | 5 |
-
Эпохи 10, 11, 12: каждая лучше всех предыдущих. Рекорд обновляется трижды, после эпохи 12 он равен 0.37. Веса эпохи 12 сохранены, счётчик обнулён.
\[ E_{\mathrm{best}}(12) = 0.37, \quad k_{\mathrm{best}} = 12 \] -
Эпоха 13: 0.375 больше рекорда. Сохранять нечего, счётчик растёт.
\[ 0.375 \gt 0.37 \;\Rightarrow\; \texttt{wait} = 1 \] -
Эпоха 14 — место, где легко ошибиться. Ошибка 0.373 меньше вчерашней 0.375, но сравнивать надо с рекордом, а он по-прежнему 0.37.
\[ 0.373 \gt 0.37 \;\Rightarrow\; \texttt{wait} = 2 \]При \(P = 2\) условие \(\texttt{wait} \ge P\) выполнено: обучение останавливается после эпохи 14.
-
При \(P = 4\) обучение продолжается. Эпохи 15 и 16 рекорд не бьют, счётчик доходит до 4: стоп после эпохи 16.
\[ k - k_{\mathrm{best}} = 16 - 12 = 4 \ge P \] -
В обоих случаях веса откатываются к checkpoint эпохи 12. Это согласуется с формулой (54): наименьшее число в таблице — 0.37.
\[ k_{ES} = 12, \quad E_{ES} = 0.37 \]
wait доходит до 2 на эпохе 14 — там и останавливается обучение с \(P = 2\).| \(P\) | Стоп после эпохи | Веса эпохи |
|---|---|---|
| 1 | 13 | 12 |
| 2 | 14 | 12 |
| 3 | 15 | 12 |
| 4 | 16 | 12 |
| 5 | 17 | 12 |
Закономерность та же, что в виджете: стоп приходится на эпоху рекорда плюс \(P\). Больший patience стоит здесь только лишних эпох вычислений: возвращается всё равно эпоха 12.
Почему это регуляризация, если error function не тронута
В заголовках слайдов слово regularization стоит у weight decay и dropout, а early stopping подан как "Limiting Overfitting by Cross-validation" (лекция 3, слайд 12). Заголовок говорит, чем метод пользуется, а не что он делает с моделью. Конспект называет early stopping «built-in regularizer»: error function та же, архитектура та же. Что же тогда ограничено? Путь, который веса успевают пройти.
Обучение начинается с малых весов (почему — урок 25). При малых весах sigmoid и tanh работают на почти прямом участке возле нуля (урок 10), и вся сеть близка к линейной функции — простой. Извилистым функциям нужны большие веса, а до них надо дойти.
Один шаг спуска сдвигает веса на расстояние \(\eta\,\norm{\nabla E}\). Значит, за \(\tau\) шагов они не уйдут от старта дальше, чем на \(\eta\,\tau \cdot \max \norm{\nabla E}\). Мало шагов — малый радиус — в досягаемости только простые функции. Это и есть уменьшение effective capacity.
Поэтому рис. 2 так похож на U-образную кривую «сложность модели — ошибка» из урока 17: число эпох работает как ручка сложности. Конспект (стр. 151) проводит ту же параллель.
Рассуждение доводится до формулы. Возьмём одно направление в пространстве весов и посмотрим, какую долю пути к минимуму спуск проходит по нему за \(\tau\) шагов. Этот вывод выходит за рамки конспекта, но именно он отвечает на экзаменационное «why».
-
Возле минимума \(w^{*}\) ошибка вдоль одного направления — парабола с кривизной \(\lambda \gt 0\). Чем больше \(\lambda\), тем круче стенки: данные жёстко диктуют значение веса.
\[ E(w) = E(w^{*}) + \tfrac{\lambda}{2}\,(w - w^{*})^2 \] -
Шаг gradient descent из урока 13: градиент равен \(\lambda (w - w^{*})\), поэтому расстояние до минимума каждый раз умножается на одно и то же число.
\[ w^{k+1} - w^{*} = (1 - \eta\lambda)\,(w^{k} - w^{*}) \] -
Стартуем с нуля, \(w^{0} = 0\), и делаем \(\tau\) шагов. Множитель возводится в степень \(\tau\):
\[ w^{\tau} = \bigl[\,1 - (1 - \eta\lambda)^{\tau}\,\bigr]\, w^{*} \]В квадратных скобках — пройденная доля пути. При большой \(\lambda\) она почти сразу равна 1, при малой растёт медленно.
-
Теперь другой способ. Weight decay (урок 22) не обрывает спуск, а добавляет к ошибке штраф \(\tfrac{\gamma}{2} w^2\) — с множителем \(\tfrac{1}{2}\), как в конспекте, — и спускается до конца. Приравняв производную суммы к нулю, получаем:
\[ \lambda\,(\tilde{w} - w^{*}) + \gamma\,\tilde{w} = 0 \] \[ \tilde{w} = \frac{\lambda}{\lambda + \gamma}\, w^{*} \]Снова доля пути, зависящая от \(\lambda\).
-
Когда доли совпадают? Когда \((1 - \eta\lambda)^{\tau} = \gamma / (\lambda + \gamma)\). Возьмём логарифм обеих частей:
\[ \tau \ln(1 - \eta\lambda) = -\ln\Bigl(1 + \frac{\lambda}{\gamma}\Bigr) \]Для пологих направлений \(\eta\lambda\) и \(\lambda / \gamma\) малы, а при малом \(x\) верно \(\ln(1 + x) \approx x\):
\[ \tau\,\eta\lambda \approx \frac{\lambda}{\gamma} \;\Rightarrow\; \tau \approx \frac{1}{\eta\,\gamma} \]Кривизна \(\lambda\) сократилась: один и тот же \(\gamma\) подходит для всех пологих направлений сразу. Если штраф записан без \(\tfrac{1}{2}\), как \(\gamma \sum_q w_q^2\) на слайде профессора (лекция 3, слайд 15) и в уроке 22, в ответе появится двойка: \(\tau \approx 1 / (2\eta\gamma)\).
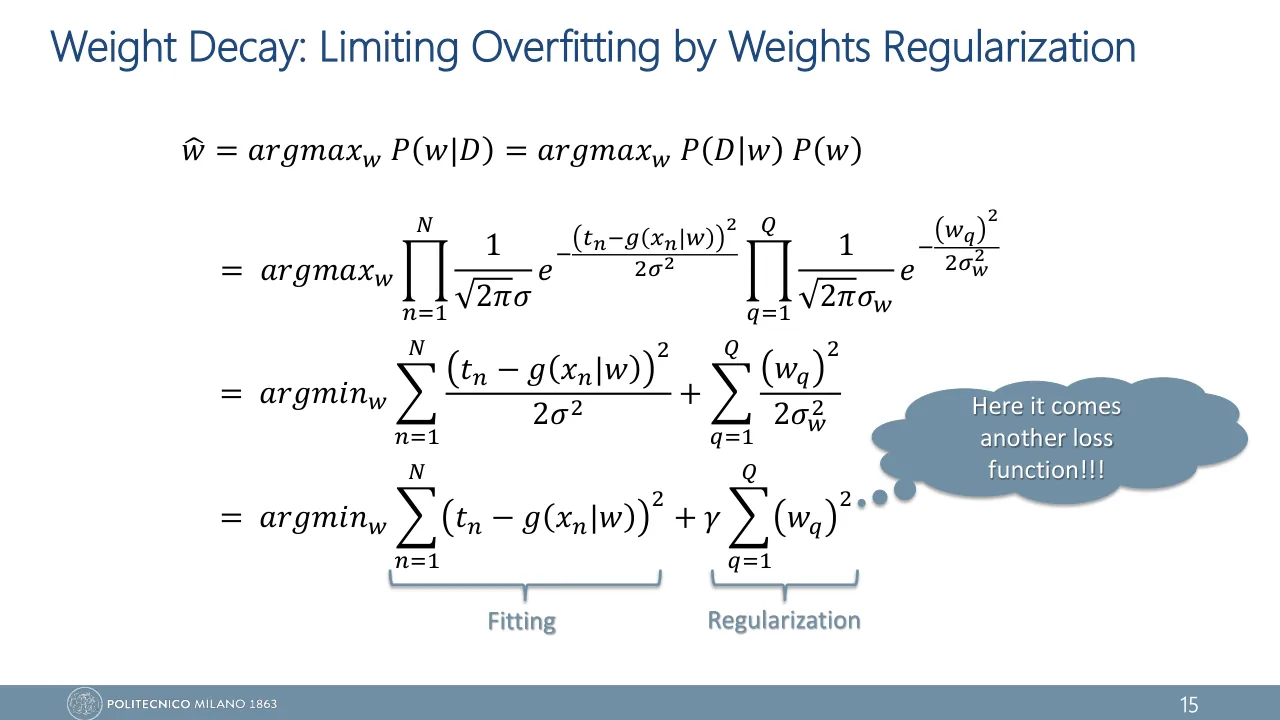
Мало шагов — сильная регуляризация, много шагов — слабая: \(\gamma \approx 1 / (\eta\,\tau)\).
| Способ | \(\lambda = 10\) | \(\lambda = 0.1\) |
|---|---|---|
| стоп, \(\tau = 20\) | 1.000 | 0.095 |
| штраф, \(\gamma = 1\) | 0.909 | 0.091 |
| стоп, \(\tau = 100\) | 1.000 | 0.394 |
| штраф, \(\gamma = 0.2\) | 0.980 | 0.333 |
Картина у обоих способов одна: то, что данные диктуют уверенно, проходит почти без потерь; то, о чём данные молчат, остаётся возле нуля. Именно в пологих направлениях сеть и подгоняется под шум. Если на курсе Applied Statistics тебе встречалась ridge regression, это тот же механизм: сжатие сильнее всего вдоль направлений с малой дисперсией данных.
Цена и мелкий шрифт
Стр. 154 конспекта подводит баланс метода. Вот он, с уточнением в каждой строке минусов.
Просто и дёшево: ни error function, ни архитектура не меняются, новых параметров у сети не появляется.
Автоматически: библиотеки сами следят за кривой и останавливают обучение.
Сверх конспекта: число эпох подбирается за один запуск. Каждая эпоха — готовый кандидат, перебирать их отдельно не нужно.
Нужен validation set: часть данных не участвует в обучении. Плюс проход по нему после каждой эпохи и место под копию весов.
Шумная кривая мешает: чем сильнее зубцы, тем больше нужен patience.
Patience и отслеживаемую метрику выбираешь ты — это гиперпараметры.
Данные, отданные на validation, можно вернуть: когда \(k_{ES}\) найден, сеть обучают заново на объединении training и validation ровно \(k_{ES}\) эпох. Следить при этом уже не за чем — останавливаются по счётчику. Это тоже эвристика: данных стало больше, и лучшее число эпох могло сдвинуться.
И главное предупреждение конспекта: «Be careful: it's a heuristic!» Гарантии, что найден настоящий минимум, нет. Алгоритм видит только шумную кривую и может остановиться и раньше, и позже — смотря как легли шум, начальные веса и learning rate. Найденная эпоха — приближение к минимуму кривой обобщения, и на практике этого хватает.
Проверь в симуляторе: бывает ли «слишком терпеливо»?
Поставь в виджете прогон № 2 и шум 0.03. При \(P = 10\) checkpoint — эпоха 46: \(E_{\mathrm{val}} = 0.121\), истинная ошибка 0.148. При \(P = 15\) checkpoint переезжает на эпоху 83: \(E_{\mathrm{val}}\) упала до 0.093, а истинная ошибка выросла до 0.171. Алгоритм честно выбрал минимум того, что видит, — глубокий шумовой провал там, где сеть уже переобучается.
Чему нельзя верить в числе \(E_{ES}\)
В последнем опыте обнаружилась странность: validation error в checkpoint стала ниже, а модель — хуже. Это не случайность одного прогона. Эпоху выбрали потому, что на ней число оказалось самым маленьким. А самым маленьким оно оказывается чаще всего там, где шум измерения отклонился вниз.
Теперь облачко слайда 12 лекции 3 — "Online estimate of the generalization error" — читается точно. Оно приколото к кривой, и про кривую это правда: при \(k\), назначенном заранее, \(E_{\mathrm{val}}(k)\) шумит, но не льстит. Это первый режим виджета. Льстит одно-единственное число — минимум \(E_{ES}\), потому что его выбирали по тем же данным. Слова unbiased на слайде нет, так что слайд и гистограмма друг другу не противоречат.
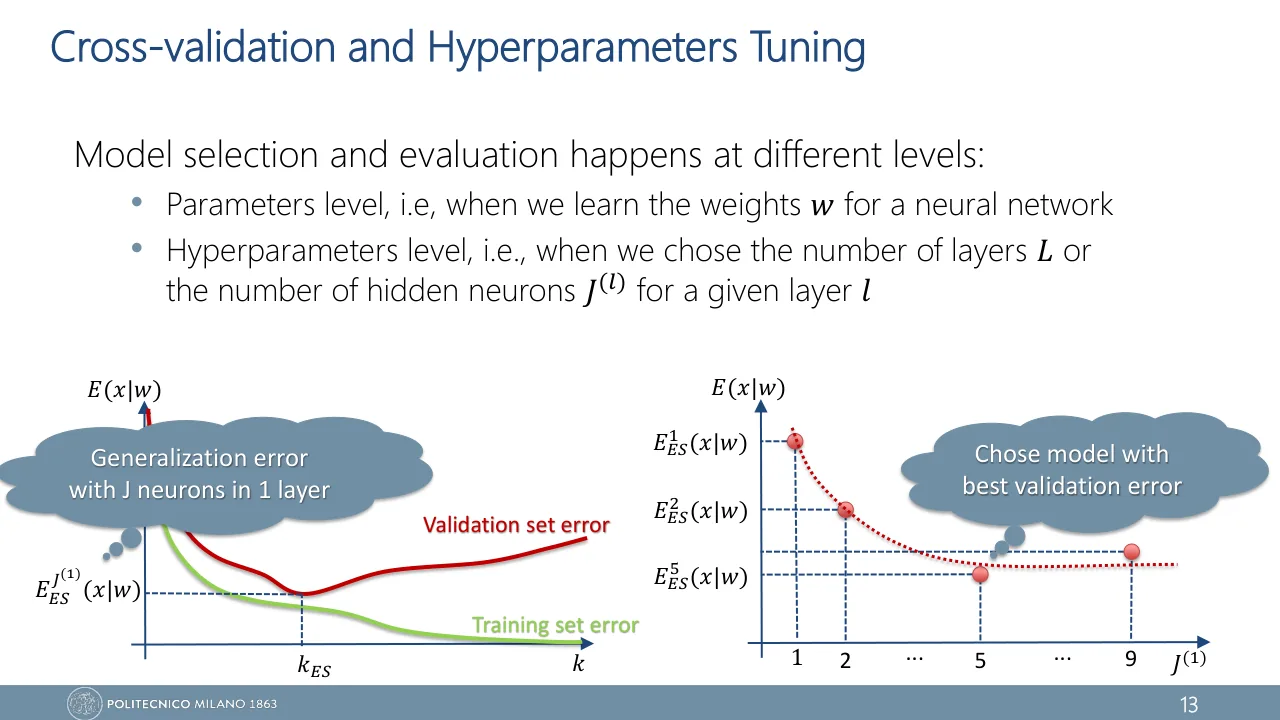
На следующем слайде профессор пользуется именно этим числом (лекция 3, слайд 13). У сети с \(J^{(1)}\) нейронами в скрытом слое оно записано как \(E_{ES}^{J^{(1)}}(x \mid w)\) и подписано "Generalization error with J neurons in 1 layer", а размер слоя выбирают по таким числам: "Chose model with best validation error". Одно и то же число названо там и generalization error, и validation error: вторая служит оценкой первой. Для сравнения моделей между собой \(E_{ES}\) годится: validation set и определён на слайдах как данные для model selection (лекция 3, слайд 5). Как устроен такой выбор, расскажет урок 21.
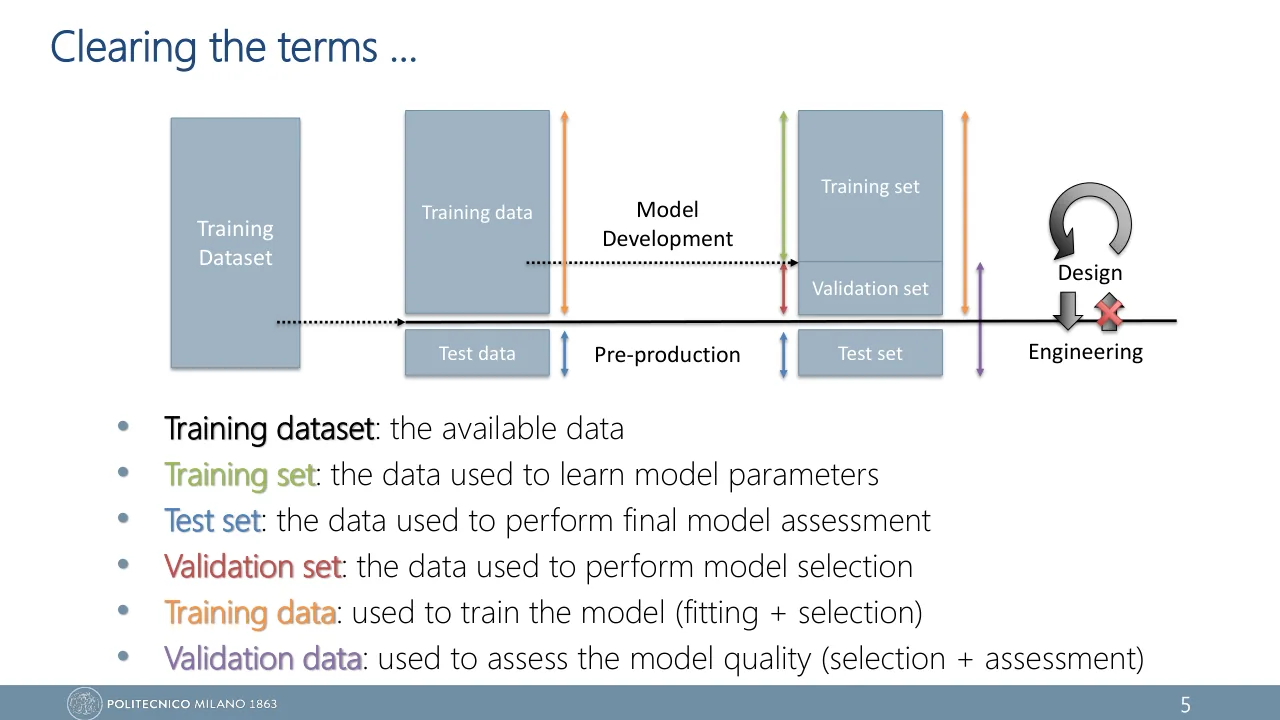
Вывод практический. Для выбора момента остановки test set не нужен — хватает validation. Но итоговое число для отчёта берут с test set, который не участвовал ни в спуске, ни в выборе эпохи (урок 18): на том же слайде 5 это названо final model assessment. Это тот же эффект, что с лучшим результатом cross-validation в уроке 19.
«\(E_{ES}\) — это и есть ошибка на новых данных, test set не нужен». Конспект (стр. 153) пишет, что модель можно оценивать «without needing a separate test set at this stage». Для слежения за обучением и выбора \(k_{ES}\) это верно, для итогового числа — нет. \(k_{ES}\) выбран как минимум шумной кривой на том же validation set, поэтому \(E_{ES}\) — не несмещённая оценка, а заниженная: на гистограмме выше при выборе по минимуму все запуски лежат левее нуля.
«Если данных мало, останавливаться можно по test set». Нельзя: тогда test set участвует в выборе модели, и его ошибка становится такой же заниженной. Честного числа после этого взять неоткуда.
Вернёмся к задачке
Инструкцию конспекта «остановиться прямо перед ростом» выполнить нельзя, и не нужно. Строку слайда "Stop train when validation error increases" выполнить можно, но буквально она работает только на гладкой кривой, какая на слайде и нарисована. На настоящей, шумной кривой её читают с двумя поправками. Первая: не реагировать на первый рост, а ждать \(P\) эпох без нового рекорда — так переживаются зубцы вроде скачка на рисунке 18. Вторая: не пытаться угадать минимум заранее, а пройти мимо него и вернуться — к копии весов, сохранённой в момент рекорда, то есть к весам эпохи \(k_{ES}\).
А пример конспекта спотыкается на слове «улучшение»: им названа эпоха 14, которая лучше вчерашней, но хуже рекорда. Отсюда ответ 17 вместо 14.
В формате экзамена
Describe early stopping as seen in class. List the steps of the procedure, describe the plot of the training set error and of the validation set error against the number of gradient descent iterations \(k\), say what \(k_{ES}\) and \(E_{ES}(x \mid w)\) are on that plot, and explain what the validation set error is an online estimate of.
Show model answer
Early stopping limits overfitting by cross-validation. Four steps: hold out some data; train on the training set; perform cross-validation on the hold-out set, i.e. compute the error on it while training; stop training when the validation error increases.
The plot has the number of gradient descent iterations \(k\) on the horizontal axis and the error \(E(x \mid w)\) on the vertical axis. The training set error has a monotone decreasing trend (on average with SGD). The validation set error decreases with it at first, reaches a minimum and then increases: from that point on the network loses generalization, i.e. it overfits. \(k_{ES}\) is the iteration at which the validation set error is minimal, and \(E_{ES}(x \mid w)\) is the validation set error at that iteration. The weights to keep are those of \(k_{ES}\).
The hold-out data are not used to compute the gradient, so the validation set error estimates the generalization error. The estimate is online: it is obtained while training, without any additional training run.
Это слайд 12 лекции 3, пересказанный словами: четыре шага, две кривые, \(k_{ES}\), \(E_{ES}\) и облачко про online estimate. Слово cross-validation здесь значит hold-out, а не K-fold. Как четвёртый шаг выполняют на шумной кривой — patience и возврат к лучшим весам — спрашивает следующий вопрос.
Define early stopping. What is \(k_{ES}\), what is the patience, which weights are returned at the end, and why is early stopping considered a regulariser although the error function is not modified?
Show model answer
Some data are held out and the network is trained on the training set only. While training, the error on the hold-out (validation) set, \(E_{\mathrm{val}}(k)\), is computed after every epoch \(k\) together with the training error. The training error keeps decreasing (on average with SGD); the validation error decreases and then increases, when the network starts fitting the noise of the training set and loses generalization. Training is stopped when the validation error increases, and early stopping returns the weights of the epoch
\[ k_{ES} = \argmin_{k}\; E_{\mathrm{val}}(k) , \]where the validation error takes its lowest value, \(E_{ES} = E_{\mathrm{val}}(k_{ES})\).
Because the validation curve is noisy, training is not stopped at the first increase: it is stopped when \(E_{\mathrm{val}}\) has not improved on its best value for \(P\) consecutive epochs (the patience). A checkpoint of the weights is saved at every new best value and restored at the end, so the model returned is the best one, not the last one.
It is a regulariser because limiting the number of gradient descent steps limits how far the weights can move from their small initial values: the effective capacity is reduced although no weight is removed. For a quadratic error it is approximately equivalent to weight decay with a coefficient \(\gamma\) proportional to \(1/(\eta\tau)\): the fewer the steps, the stronger the regularisation. It requires a validation set, never the test set.
Вопрос проверяет четыре вещи: кривые и \(\argmin\), слова «best value so far» в определении patience, возврат к checkpoint и ответ на «why» через effective capacity. Одной строки слайда 12 лекции 3 "Stop train when validation error increases" здесь мало: вопрос прямо спрашивает про patience и возвращаемые веса, а их на слайде нет — они из конспекта и из практики.
The validation error at epochs 10 to 17 is 0.40, 0.38, 0.37, 0.375, 0.373, 0.376, 0.379, 0.382; epoch 10 improves on all earlier epochs. Early stopping is used with patience 2: training stops as soon as the validation error has not improved on its best value for 2 consecutive epochs. After which epoch does training stop?
Show model answer
The best value is 0.37 at epoch 12. Epoch 13 (0.375) does not improve on it: wait = 1. Epoch 14 (0.373) is lower than epoch 13 but still higher than the best value: wait = 2. Training stops after epoch 14 and the weights of epoch 12 are restored.
With patience 4 it would stop after epoch 16, restoring the same weights.
Ловушка — эпоха 14: она лучше предыдущей, но не лучше рекорда. Если в условии patience определён иначе, считай по условию и одной фразой запиши, какое правило используешь. Если patience в условии нет совсем, а правило дано строкой слайда 12 лекции 3, это остановка на первом росте: здесь — после эпохи 13, с весами эпохи 12.
The validation error at epochs 1 to 10 is 0.90, 0.70, 0.55, 0.57, 0.50, 0.52, 0.51, 0.53, 0.54, 0.56. Early stopping with patience 3 and checkpoint restore is used. The weights of which epoch are returned?
Show model answer
Epochs 1, 2, 3 are improvements (best 0.55). Epoch 4: wait = 1. Epoch 5 (0.50) is a new best: checkpoint saved, wait = 0. Epochs 6, 7, 8 (0.52, 0.51, 0.53) do not improve on 0.50: wait = 3, so training stops after epoch 8. The weights of epoch 5 are returned.
With patience 1, i.e. stopping at the first increase of the validation error, training would stop after epoch 4 and return epoch 3, with \(E_{ES} = 0.55\) instead of 0.50.
Два неверных ответа выдают две разные ошибки: 3 — остановка на первом росте, 8 — «возвращается последняя эпоха».
Which statements about early stopping are correct? Select all that apply.
Show model answer
Correct: the first, the fourth and the sixth statements. Early stopping needs held-out data; the best checkpoint, not the last epoch, is returned; no weight is removed; the selected validation error is optimistically biased; monitoring the error on a hold-out set is cross-validation in the sense used in the course.
Четвёртое утверждение говорит про validation error, а не про ошибку на новых данных: вторая при большем patience может и вырасти, как в прогоне № 2 симулятора.
A network is trained with early stopping and the value \(E_{ES} = E_{\mathrm{val}}(k_{ES})\), the validation error at the stopping point, is reported as its generalisation error. Explain why this number is optimistically biased and how an unbiased estimate is obtained.
Show model answer
For an epoch fixed in advance the validation error is an unbiased estimate of the generalisation error, because the hold-out data are not used to compute the gradient: this is the online estimate given by the validation curve. But \(k_{ES}\) is chosen as the minimum of that curve, so the validation set has been used to make a choice: it is part of model selection. Each \(E_{\mathrm{val}}(k)\) is the true error plus noise due to the finite validation set; the minimum over many epochs tends to be attained where the noise is negative, hence on average
\[ \E\Bigl[\min_k E_{\mathrm{val}}(k)\Bigr] \le \min_k \E\bigl[E_{\mathrm{val}}(k)\bigr] . \]An unbiased estimate requires data used neither for training nor for any selection: a separate test set, the data reserved for the final model assessment, evaluated once on the final model.
Ключевые слова: «used for selection», «minimum of noisy estimates», «separate test set». Ответ «потому что сеть обучалась на validation set» неверен: градиент по нему не считали. С облачком слайда 12 лекции 3 противоречия нет: online estimate там сказано про кривую, а слова unbiased на слайде нет.
Early stopping, weight decay and dropout all reduce the effective capacity of a neural network. Say what each of them constrains, name one hyperparameter of each, and explain the difference between nominal and effective capacity.
Show model answer
Early stopping (training control; in the slides, limiting overfitting by cross-validation) limits the number of training iterations, i.e. how far the weights can move from their initial values; hyperparameter: the patience. Weight decay (model complexity control; by weights regularization) adds a penalty on the squared weights to the error function and limits how large the weights grow; hyperparameter: the coefficient \(\gamma\). Dropout (randomisation, model averaging; by stochastic regularization) switches off random neurons at every training step, so that units cannot rely on specific other units; hyperparameter: the dropout probability.
The nominal capacity is the set of functions the architecture can represent with some weights; it is not changed, since no weight is removed. The effective capacity is the set of functions that training can actually reach; this is what the three techniques reduce. Their hyperparameters are chosen on validation data.
Обзорный вопрос ко всему блоку про overfitting (лекция 3, слайды 11–22). Главная ловушка — фраза «regularisation reduces the number of parameters»: число весов не меняется. В скобках у каждого метода два имени: первое из конспекта, второе из заголовков слайдов 12, 14 и 17 лекции 3. Effective capacity — тоже слово конспекта; на слайде 14 лекции 3 то же названо «freedom» модели.
Проверь себя
Training error падает, а validation error последние двадцать эпох устойчиво растёт. Что происходит?
Validation error по эпохам 1–7: 0.9, 0.6, 0.62, 0.5, 0.52, 0.51, 0.53. Patience равен 2, откат к checkpoint включён. Веса какой эпохи вернутся?
Patience увеличили с 5 до 20, откат к checkpoint включён, обучение то же самое. Что может произойти?
Большой patience безопасен для числа, по которому идёт выбор, и не обязательно безопасен для того, что нас интересует на самом деле.
Почему \(E_{ES}\), то есть validation error в точке остановки, в среднем меньше ошибки модели на новых данных?
Сеть с 10 000 весов обучали с early stopping и остановили на 40-й эпохе; без остановки ушло бы 500. Что изменилось у итоговой модели?
Чем приходится платить за early stopping?
Унести с собой
- Early stopping, weight decay и dropout не убирают ни одного веса: каждый по-своему уменьшает effective capacity.
- Процедура профессора (лекция 3, слайд 12) — четыре шага: отложить данные, учить на training set, по ходу считать ошибку на отложенных данных (у профессора это cross-validation), остановиться, когда validation error растёт.
- Признак переобучения — расхождение кривых: \(E_{\mathrm{train}}\) падает, \(E_{\mathrm{val}}\) растёт. Цель остановки — эпоха \(k_{ES}\) с наименьшей \(E_{\mathrm{val}}\); само наименьшее значение на слайде обозначено \(E_{ES}\).
- На первом росте останавливаться нельзя: кривая шумит. Ждут \(P\) эпох без нового рекорда; улучшение — это «лучше лучшего», а не «лучше вчерашнего».
- Минимум опознаётся задним числом, поэтому при каждом рекорде сохраняют checkpoint, а в конце откатываются к нему. Patience стоит \(P\) эпох вычислений; validation error возвращённой модели от большего \(P\) не растёт, а ошибка на новых данных — может.
- Это регуляризация: за малое число шагов веса не успевают уйти далеко от малых начальных значений. Для параболы остановка после \(\tau\) шагов примерно равносильна weight decay с \(\gamma \approx 1/(\eta\tau)\).
- Кривая \(E_{\mathrm{val}}(k)\) — "online estimate of the generalization error", как и сказано на слайде 12 лекции 3. Её минимум \(E_{ES}\) — заниженная оценка: по нему делали выбор. Итоговое число берут с test set.
Что посмотреть и почитать
-
MIT Introduction to Deep Learning (2025) | 6.S191, Lecture 1
Alexander Amini69 мин
Финальная часть лекции — про переобучение: dropout и early stopping читаются прямо с кривых train и validation, на языке экзамена. Начало повторяет главу 2; листай к разделу про обучение на практике.
-
TensorFlow Playground
Daniel Smilkov, Shan Carter
Сделай early stopping руками: трудный набор данных, шум побольше, регуляризация выключена. Следи за test loss и поставь на паузу там, где она покажется тебе минимальной; потом дай обучению идти дальше и сравни.
-
Improving the way neural networks learn
Michael Nielsen, глава 3
Раздел «Overfitting and regularization»: настоящие кривые на MNIST, по которым момент остановки читается с графика. Сайт открывается только по http — браузер покажет «не защищено».
-
Overfitting: Interpreting loss curves
Google Machine Learning Crash Course
Упражнения на «больные» кривые ошибки: по картинке нужно сказать, что пошло не так. Хорошая тренировка глаза после симулятора.
-
Deep Learning, глава 7 «Regularization for Deep Learning»
Goodfellow, Bengio, Courville
Раздел про early stopping: алгоритм с patience целиком, повторное обучение на всех данных и полный вывод связи с L2 — то, что в конспекте пропущено.