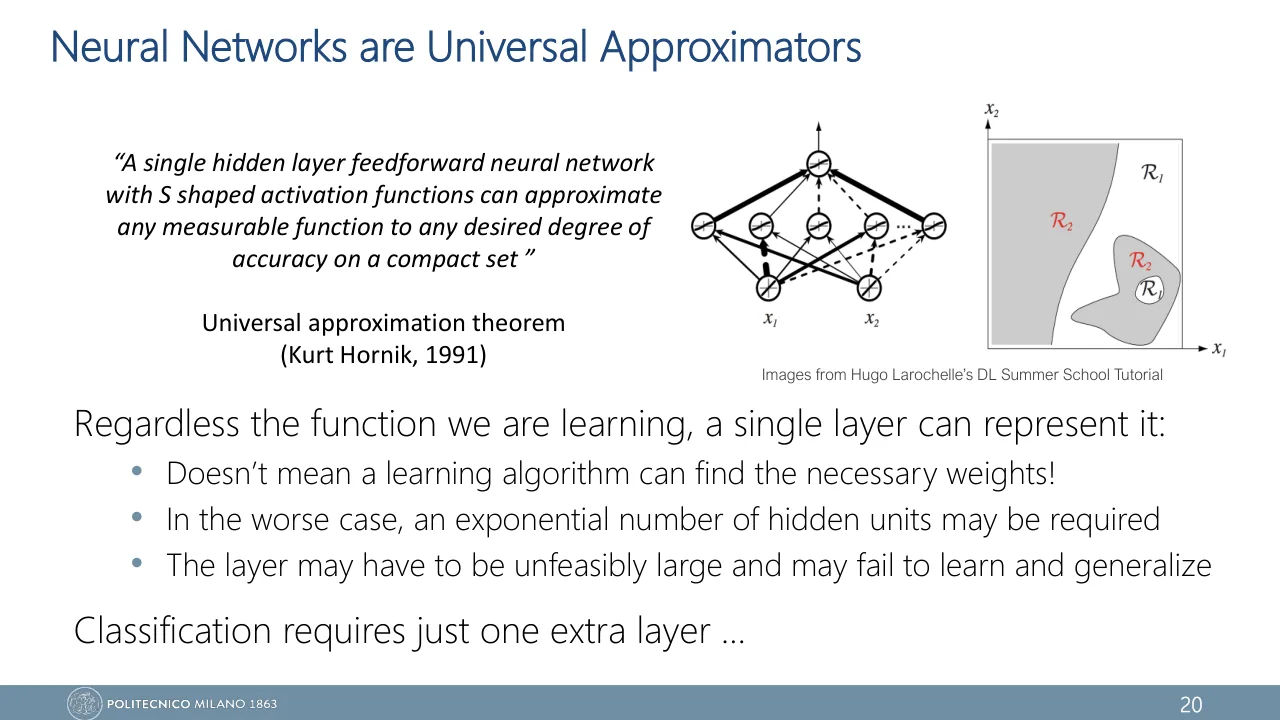
В 1980-е скептики спрашивали: способны ли нейросети выучить любую связь между входом и выходом, или они годятся только для простых функций? В 1989 году George Cybenko доказал теорему для сигмоидных нейронов, а Hornik, Stinchcombe и White выпустили статью с говорящим названием «Multilayer Feedforward Networks are Universal Approximators». В 1991-м Kurt Hornik показал, что дело не в конкретной сигмоиде, а в самой архитектуре со скрытым слоем — на эту работу и ссылается слайд 20 лекции 2. В 1993-м Leshno, Lin, Pinkus и Schocken довели условие до предела: годится любая непрерывная активация, кроме многочлена. Так что ReLU из урока 24, не S-образная и не ограниченная, тоже подходит, хотя конспект на стр. 123 требует «bounded»: это достаточное условие, но не необходимое. Конспект пишет, что эти работы дали нейросетям «mathematical legitimacy»: стало ясно, что это универсальный инструмент, а не набор удачных трюков.
LEGO для функций
После этого урока ты соберёшь из сигмоид приближение любой непрерывной кривой, запишешь universal approximation theorem так, как она стоит на слайде 20 лекции 2, и назовёшь три вещи, которых она не обещает.
В уроке 8 один нейрон не справился с четырьмя точками XOR, и после книги Минского и Пейперта 1969 года интерес к нейросетям надолго остыл. Через двадцать лет, в 1989-м, сразу несколько математиков доказали почти обратное: сети с одним скрытым слоем хватает, чтобы приблизить любую непрерывную функцию с любой точностью. Не «многие функции», а любую.
Тогда загадка. Курс называется Deep Learning, и сети в нём строят слой за слоем. Если одного скрытого слоя достаточно для всего, зачем остальные?
Чтобы ответить, сначала соберём такую «всемогущую» сеть руками, как башню из LEGO. А потом посчитаем, во что обходится постройка, и посмотрим, о чём теорема молчит.
Один кирпичик: ступенька
Возьмём один скрытый нейрон (hidden unit) с одним входом \(x\) и сигмоидой из урока 10. Он считает \(\sigma(w x + w_0)\): вес \(w\), bias \(w_0\). Вынесем вес за скобку, и у формулы появится понятная геометрия.
- \(x\)
- вход
- \(w\)
- вес: крутизна подъёма
- \(w_0\)
- bias нейрона (на стр. 85 конспекта он записан как \(b\))
- \(s\)
- место подъёма: в этой точке нейрон выдаёт ровно 0.5
Конспект (стр. 85) называет это «shifted and stretched S-curve»: bias сдвигает кривую вдоль оси, вес её сжимает или растягивает. Проверь на числах: при \(w = 50\) и \(w_0 = -20\) середина подъёма стоит в точке \(s = 20/50 = 0.4\).
Что будет, если вес сделать большим? Подъём сожмётся в узкую полоску вокруг \(s\). Левее неё выход почти 0, правее почти 1. Сигмоида превращается в ступеньку (step).
До: \(w = 5\)
После: \(w = 50\)
Важная оговорка: ступенька — это всё, на что способен один такой нейрон. Его выход только растёт (или только падает, если \(w \lt 0\)). Подняться и потом опуститься он не может.
Один скрытый нейрон — одна ступенька: вес задаёт крутизну, а \(s = -w_0 / w\) — место.
Два кирпичика: башенка
Одной ступенькой кривую не повторить. Зато из двух получается деталь поинтереснее. Поставим вторую ступеньку правее первой и вычтем её из первой.
Получился bump — «башенка», которая стоит на отрезке от \(s_1\) до \(s_2\) и больше нигде. Умножим её на число \(\alpha\), и у башенки будет высота \(\alpha\). При отрицательном \(\alpha\) она растёт вниз.
- \(s_1, s_2\)
- левая и правая стена башенки
- \(w\)
- крутизна стен; bias двух нейронов: \(-w s_1\) и \(-w s_2\)
- \(\alpha\)
- высота: выходные веса двух нейронов равны \(+\alpha\) и \(-\alpha\)
На языке сетей это сеть 1–2–1: один вход, два скрытых нейрона, один линейный выход, который просто складывает. Линейный выход — тот самый, что в уроке 11 достался задаче regression.
| \(x\) | \(\sigma(50(x - 0.4))\) | \(\sigma(50(x - 0.6))\) | разность |
|---|---|---|---|
| 0.3 | 0.007 | 0.000 | 0.007 |
| 0.4 | 0.500 | 0.000 | 0.500 |
| 0.5 | 0.993 | 0.007 | 0.987 |
| 0.6 | 1.000 | 0.500 | 0.500 |
| 0.7 | 1.000 | 0.993 | 0.007 |
Подсвеченная строка считается так:
\[ \begin{aligned} \sigma(5) - \sigma(-5) &= 0.9933 - 0.0067 \\ &= 0.9866 \approx 0.987 \end{aligned} \]Почти единица в середине, ровно половина на стенах, почти ноль снаружи.
Ряд башенок повторяет любую кривую
Теперь LEGO. Возьмём цель \(f(x) = \sin x\) на отрезке от −3 до 3 — ту же, что на рис. 15 конспекта (стр. 125). Нарежем отрезок на \(M\) одинаковых кусков, на каждый поставим башенку, а её высоту возьмём равной значению \(f\) в середине куска.
Получится столбчатая картинка, знакомая по гистограммам из Applied Statistics: только высоту столбика задаёт не число наблюдений, а значение функции. Каждая башенка — два скрытых нейрона, всего их \(J = 2M\). Выход сети — сумма башенок.
Вся такая сеть помещается в одну строку. В конспекте (стр. 85) она записана так:
\[ \hat f(x) = \sum_{j=1}^{J} w^{(2)}_j \cdot \sigma\bigl(w^{(1)}_j x + b_j\bigr) \]Здесь \(w^{(1)}_j\) и \(b_j\) задают крутизну и место ступеньки номер \(j\), а \(w^{(2)}_j\) — её высоту со знаком. Конспект называет скрытые нейроны basis functions (базисные функции) и сравнивает их с синусами в ряде Фурье: там кривую складывают из волн, здесь из ступенек.
В виджете зазор послушно уменьшался. Но теореме нужно больше: его можно сделать меньше любого заранее названного числа. Почему это всегда получится?
-
Режем отрезок \(K = [A, B]\) на \(M\) одинаковых кусков. Ширина куска:
\[ \Delta = \frac{B - A}{M} \] -
На куске с серединой \(c_i\) сеть с крутыми стенами выдаёт высоту своей башенки:
\[ g(x) \approx f(c_i) \]Так мы её построили.
-
Значит, зазор в точке \(x\) этого куска — то, насколько цель успела измениться по дороге от середины до \(x\):
\[ \abs{f(x) - g(x)} \approx \abs{f(x) - f(c_i)} \] -
От любой точки куска до его середины не дальше \(\Delta/2\). Если наклон цели нигде не превышает \(L\), то на таком пути она меняется не больше чем на
\[ \abs{f(x) - f(c_i)} \le L \cdot \frac{\Delta}{2} \] -
Требуем, чтобы это было меньше \(\varepsilon\), и выражаем число кусков:
\[ L\,\frac{\Delta}{2} \lt \varepsilon \;\;\Rightarrow\;\; M \gt \frac{L\,(B - A)}{2\,\varepsilon} \]Для любого \(\varepsilon \gt 0\) такое \(M\) существует. Это и есть «to any desired degree of accuracy».
-
А если у цели нет предельного наклона \(L\)? Тогда помогает факт из анализа: непрерывная функция на замкнутом ограниченном отрезке равномерно непрерывна. Для любого \(\varepsilon\) есть ширина \(\Delta\), при которой цель внутри каждого куска меняется меньше чем на \(\varepsilon\). Здесь работают оба слова теоремы: continuous и compact.
| башенок \(M\) | нейронов \(J\) | \(\Delta\) | оценка \(L\Delta/2\) | зазор в виджете |
|---|---|---|---|---|
| 10 | 20 | 0.6 | 0.300 | 0.285 |
| 20 | 40 | 0.3 | 0.150 | 0.146 |
| 40 | 80 | 0.15 | 0.075 | 0.073 |
| 300 | 600 | 0.02 | 0.010 | 0.010 |
Зазор в виджете чуть меньше оценки: \(L\) — это самый крутой наклон, а почти везде синус идёт более полого. Жёлтый отрезок стоит на краю \(K\) не случайно: там крайняя башенка держит полную высоту до самой границы. На внутренних стыках стены не вертикальны, сумма плавно переходит от одной высоты к другой и оказывается к цели ещё ближе. Последняя строка посчитана отдельно: ползунок до неё не достаёт.
Можно ли обойтись меньшим числом нейронов?
Можно, и намного. У соседних башенок общая стена, поэтому два нейрона с одинаковыми \(w\) и \(s\) сливаются в один: \(M\) башенок — это на самом деле \(M + 1\) разных ступенек, а не \(2M\).
Но и это не предел. Поставим 20 сигмоид через равные промежутки от −3 до 3, дадим всем вес \(w = 10\) (это втрое более пологие стены, чем в виджете) и подберём только выходные веса методом наименьших квадратов (линейная регрессия из Applied Statistics: выход линеен по \(h_j\)). Зазор для \(\sin x\) падает примерно до 0.015 — почти в двадцать раз меньше, чем 0.285 у нашей постройки из тех же 20 нейронов. Рецепт из доказательства прост, но расточителен. Он доказывает, что веса существуют, и не утверждает, что это лучшие веса.
Теорема: что именно доказано
То, что получилось в виджете, и есть содержание знаменитой теоремы. На слайде профессора она записана одной фразой, и её стоит знать дословно.
"A single hidden layer feedforward neural network with S shaped activation functions can approximate any measurable function to any desired degree of accuracy on a compact set."
Это словесная версия. Формальная стоит в конспекте дважды: теорема 1 на стр. 84 и теорема 3 на стр. 123. Вот она в обозначениях слайдов. Пусть \(K \subset \R^I\) — компакт, а функция \(f: K \to \R\) непрерывна. Тогда для любого \(\varepsilon \gt 0\) существуют число скрытых нейронов \(J\) и веса \(w\), при которых сеть
- \(f\)
- цель: функция, которую приближаем
- \(K\)
- компакт (compact set): замкнутый ограниченный кусок пространства входов
- \(\varepsilon\)
- допустимый зазор в худшей точке; его выбираешь ты
- \(J\)
- число скрытых нейронов; оно зависит от \(f\) и \(\varepsilon\)
- \(w^{(1)}_{ji}\)
- вес в скрытый нейрон \(j\) от входа \(i\); \(w^{(1)}_{j0}\) — его bias
- \(w^{(2)}_{1j}\)
- вес от скрытого нейрона \(j\) к единственному выходу: высота
- \(\sigma\)
- S-образная активация скрытых нейронов; выход линейный
Третья строка — про худшую точку: знак \(\forall\) читается «для всех». Нарисуй вокруг цели коридор шириной \(\varepsilon\) вверх и вниз. Теорема обещает сеть, график которой не выходит из коридора нигде на \(K\).
Конспект пишет ту же сеть другими буквами, причём в двух местах по-разному. Сверь один раз, чтобы читать и то и другое.
| Что | Слайды и этот курс | Конспект, стр. 84–85 | Конспект, стр. 123 |
|---|---|---|---|
| число входов | \(I\) | \(n\) | \(n\) |
| число скрытых нейронов | \(J\) | \(J\) | \(m\) |
| вес «вход → скрытый» | \(w^{(1)}_{ji}\) | \(w^{(1)}_{ji}\) | вектор \(w_j\) |
| bias скрытого нейрона | \(w^{(1)}_{j0}\) | \(b_j\) | \(b_j\) |
| активация скрытого нейрона | \(h_j(\cdot)\) | \(\sigma(\cdot)\) | \(g(\cdot)\) |
| вес «скрытый → выход» | \(w^{(2)}_{1j}\) | \(w^{(2)}_{j}\) | \(\alpha_j\) |
| выход сети | \(g(x|w)\) | \(\hat f(x)\) | \(F(x)\) |
«\(g\) — это всегда выход сети». На слайдах да. А на стр. 123 конспекта буквой \(g\) названа активация скрытого нейрона, выход сети там \(F\). Перед тем как переписывать формулу на экзамене, реши, в чьих обозначениях пишешь, и не смешивай.
В формулировке нет лишних слов. Каждое можно «выключить» и посмотреть, что сломается.
| Слово | Что оно значит | Где это видно |
|---|---|---|
| single hidden layer | один ряд нейронов между входом и выходом; выход — взвешенная сумма | башенки стоят в один ряд |
| S shaped | sigmoid или tanh; с линейной активацией сеть даёт только прямую | урок 9 |
| continuous \(f\) | у цели нет скачков | цель «со скачком»: \(\varepsilon\) не падает ниже 0.4 |
| compact set | входы взяты из замкнутого ограниченного куска, например \([-3, 3]\) | переключатель «за пределами K» |
| any desired accuracy | для любого \(\varepsilon \gt 0\): точность называешь ты, \(J\) подбирается под неё | нижний график в виджете |
| there exist | такие \(J\) и веса существуют; как их найти и сколько их, не сказано | следующий раздел |
| для всех \(x \in K\) | зазор мал в худшей точке, а не «в среднем» | жёлтый отрезок в виджете |
Почему на слайде «measurable», а в конспекте «continuous»?
Это два разных утверждения из одних и тех же статей. Для непрерывной цели сеть близка к ней в каждой точке компакта — ровно то, что записано формулой выше и что показывает жёлтый отрезок.
Измеримая (measurable) функция может иметь скачки. Для неё гарантия слабее: сеть близка к цели везде, кроме множества входов сколь угодно малой вероятности. В виджете это цель «со скачком»: \(\varepsilon\) не падает, но полоска, где сеть ошибается, становится всё уже. На экзамене цитируй слайд 20 лекции 2, а если попросят формулу — пиши версию для непрерывной функции.
Почему без нелинейности ничего не выйдет
Замени сигмоиду на линейную активацию \(h(a) = a\), и сумма из теоремы схлопнется. Для одного входа:
\[ \sum_{j=1}^{J} w^{(2)}_{1j}\,\bigl(w^{(1)}_{j1}\,x + w^{(1)}_{j0}\bigr) = v\,x + c \]Числа \(v\) и \(c\) — просто суммы произведений весов. Сколько бы нейронов ни было, получается прямая: тот же эффект, что в уроке 9, где сто линейных слоёв равнялись одному. К \(\sin x\) на \([-3, 3]\) никакая прямая не подходит ближе чем на 0.63. Конспект говорит об этом на стр. 85: «non-linearity is crucial». Но на той же странице он делает из необходимого условия достаточное.
С двумя входами кирпичик — это ridge
До сих пор вход был один. С несколькими входами устроено так же, только кирпичик выглядит иначе. Нейрон считает \(\sigma(w_1 x_1 + w_2 x_2 + w_0)\). Его выход меняется лишь поперёк прямой \(w_1 x_1 + w_2 x_2 + w_0 = 0\) — той самой, которую нейрон проводил в уроке 6, — а вдоль неё остаётся постоянным. На плоскости это уже не ступенька, а длинный обрыв. Конспект (стр. 124) называет его ridge — гребень.
Один нейрон: ridge
Два нейрона: полоса
Сеть с двумя входами складывает много обрывов под разными углами. В конспекте (стр. 124) эта сумма записана буквами \(\alpha_j\), \(g\) и \(b_j\); в обозначениях слайдов она выглядит так:
\[ g(x_1, x_2) = \sum_{j=1}^{J} w^{(2)}_{1j}\,\sigma(a_j) \] \[ a_j = w^{(1)}_{j1}\,x_1 + w^{(1)}_{j2}\,x_2 + w^{(1)}_{j0} \]Каждый обрыв немного деформирует поверхность, а их сумма способна повторить любой непрерывный рельеф; конспект называет сети «universal sculptors». Но рецепт башенок здесь уже не проходит в лоб: из двух обрывов получается полоса, а не башенка. Доказательство Cybenko вообще ничего не строит: оно показывает, что нужная сеть существует, не предъявляя её. Отсюда и характер всей теоремы: «существует», а не «вот она».
Чего теорема не обещает
На том же слайде под цитатой написано: «Regardless the function we are learning, a single layer can represent it» — и сразу три «но». Профессор ждёт их в ответе не меньше, чем саму формулировку. Теорема — это утверждение о существовании (existence result); конспект на стр. 124 говорит то же тремя словами: «existence, not constructability». Каждое «но» напоминает, чего из существования не следует.
Первое: веса существуют, но их ещё надо найти
На слайде: «Doesn't mean a learning algorithm can find the necessary weights!» В виджете веса выписаны по рецепту, и рецепту нужно значение \(f\) в середине каждого куска. В настоящей задаче функции \(f\) нет, есть только \(N\) примеров \((x_n, t_n)\). Веса ищет алгоритм обучения, он может застрять или не дойти. Этим займёмся в уроке 13.
«Рис. 15 конспекта (стр. 125) показывает теорему в действии». Не совсем. На всех четырёх панелях одна и та же сеть с 20 нейронами, меняется только число итераций обучения: 5, 10, 25, 50. Это картинка про первое «но» — как алгоритм постепенно находит веса. Теорема же говорит о том, что возможно при росте числа нейронов \(J\), а про итерации в ней нет ни слова.
Второе: нейронов может понадобиться экспоненциально много
На слайде: «In the worse case, an exponential number of hidden units may be required». В конспекте этого пункта нет, а он самый неприятный. С одним входом мы резали отрезок. С двумя входами придётся резать квадрат на клетки, с тремя — куб, и на каждой клетке сети нужно выставить свою высоту.
Один вход: 10 башенок
Два входа: уже 100
Теперь с числами из таблицы. Для \(\varepsilon = 0.01\) синусу понадобилось 300 кусков по одной оси. При двух входах с той же точностью это \(300^2 = 90\,000\) клеток, при десяти — \(300^{10} \approx 6 \cdot 10^{24}\). А у картинки 28 × 28 пикселей входов 784.
Третье: огромный слой плохо учится и плохо обобщает
На слайде: «The layer may have to be unfeasibly large and may fail to learn and generalize». Теорема рассуждает так, будто цель известна в каждой точке. В жизни примеров конечное число, и в них есть шум. Сеть, способная повторить любую кривую, повторит и шум. Это overfitting, а умение хорошо работать на новых данных называется generalization (обобщение). Про него теорема молчит совсем. Отсюда растёт бритва Оккама из урока 17: раз сеть может повторить что угодно, из подходящих моделей приходится выбирать самую простую.
К трём пунктам слайда добавь два тихих, которые уже были видны в виджете: гарантия действует только на компакте \(K\) и говорит «приближает», а не «равна».
Что значит последняя строка слайда: «Classification requires just one extra layer …»?
Теорема сформулирована для сети с вещественным линейным выходом, то есть для regression. Цель классификатора — разрывная: внутри области один класс, за границей другой. Чтобы получить такие ответы, поверх приближающей сети ставят ещё одну ступень. В классической картинке из урока 8 (таблица со слайда 16 лекции 2) это выглядит так: первый слой проводит прямые, второй собирает из них выпуклые области, третий объединяет их в произвольные — несвязные и с дырками, как области \(\mathcal{R}_1\) и \(\mathcal{R}_2\) на рисунке слайда 20 лекции 2.
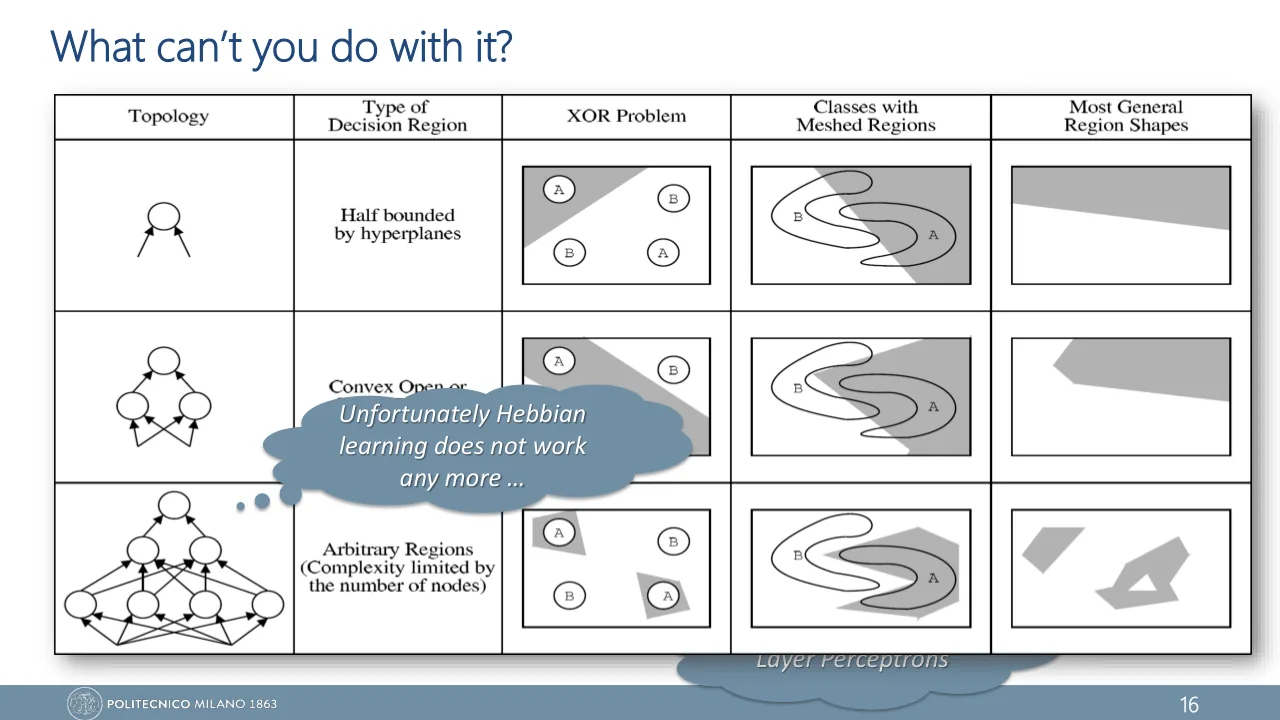
Подробнее профессор эту строку на слайде не раскрывает, так что это прочтение, а не цитата. Для экзамена достаточно сказать: для classification результат сохраняется ценой одного дополнительного слоя.
Каркас ответа на экзамене: цитата со слайда 20 лекции 2, одно слово «existence», три «но». Если останется время — формула с \(\varepsilon\) и оговорка про компакт.
Тогда зачем глубина
Вернёмся к загадке. Одного скрытого слоя хватает на всё — но теорема говорит «можно», а не «дёшево». Второе «но» как раз о цене: в худшем случае число нейронов растёт экспоненциально. Глубина — способ платить меньше.
Вот пример, где это видно без формул. Нужна пила из восьми зубцов. По рецепту башенок на каждый зубец уходит два нейрона одного слоя. А теперь возьмём слой из двух нейронов, который делает один зубец, «домик», и подадим его выход на вход такому же слою. Второй слой нарисует свой домик на каждом склоне первого, и зубцов станет два. Почему: пока \(x\) идёт вверх по левому склону, выход первого слоя пробегает все значения от 0 до 1. Для второго слоя это весь его вход, и он успевает нарисовать целый домик. На правом склоне те же значения идут в обратном порядке — получается второй домик. Третий слой удвоит ещё раз.
Вширь: один слой
Вглубь: 4 слоя × 2 нейрона
Слева цена растёт вместе с числом зубцов, справа — вместе с его логарифмом. Широкая сеть оплачивает каждую деталь отдельно. Глубокая переиспользует уже сделанное: то, что построил один слой, следующий получает готовым. Это та же иерархия признаков, с которой начинался курс в уроке 3.
«Глубокая сеть всегда экономнее широкой». Конспект (стр. 124) пишет, что глубокие сети приближают «the same function with fewer neurons», и объясняет этим победу deep learning. Аккуратнее так: для многих функций, особенно составных, как наша пила, — да, и выигрыш бывает экспоненциальным. Для любой — нет. К тому же глубокие сети труднее обучать (урок 24), а взлёту 2012 года помогли ещё данные и видеокарты (урок 4).
Один скрытый слой может всё, но не обещает сделать это дёшево, найти веса и обобщить; глубина — способ платить меньше.
В формате экзамена
State the universal approximation theorem for feed-forward neural networks. What does it guarantee and what does it not guarantee? Why are deep networks used in practice although one hidden layer is enough in theory?
Show model answer
A feed-forward neural network with a single hidden layer of S-shaped units (sigmoid, tanh) and a linear output can approximate any continuous (more generally, measurable) function on a compact set to any desired degree of accuracy, provided it has enough hidden units (Hornik, 1991). Formally, for continuous \(f\) on a compact \(K\) and every \(\varepsilon \gt 0\) there exist \(J\) and weights \(w\) such that
\[ \abs{f(x) - g(x|w)} \lt \varepsilon \quad \forall x \in K . \]It is an existence result about what the model can represent. It does not guarantee that (i) a learning algorithm can find the necessary weights; (ii) the number of hidden units is reasonable: in the worst case it is exponential, so the layer may be infeasibly large; (iii) the trained network generalizes from a finite, noisy training set. Nothing is claimed outside the compact set.
Deep networks can represent many functions with far fewer units than one wide layer, because each layer reuses the features built by the previous ones. This is why depth is preferred in practice.
Проверяют три вещи. Формулировку: «single hidden layer», «S-shaped», «compact set», «any accuracy». Слово «existence». И три «но» со слайда 20 лекции 2, желательно его же словами. Самая частая потеря баллов — написать «a network can learn any function»: теорема не про обучение.
Which statements about the universal approximation theorem are correct? Select all that apply.
Show model answer
Correct: the first and the third. The theorem is a statement about representation on a compact set. It says nothing about training, about the size of the hidden layer or about generalization, and it requires a non-linear (S-shaped) hidden activation.
Четыре неверных варианта звучат правдоподобно, потому что каждый описывает то, чего от теоремы хочется: обучение, скромный размер, обобщение. Отмечай только то, что прямо следует из формулировки.
A network with one input, two sigmoid hidden units and a linear output computes \(g(x) = \sigma(50x - 20) - \sigma(50x - 30)\), where \(\sigma(a) = 1/(1 + e^{-a})\). Compute \(g(0.45)\). Give three decimal places.
Show model answer
The two hidden units are steps located at \(x = 20/50 = 0.4\) and \(x = 30/50 = 0.6\); their difference is a bump on \([0.4,\ 0.6]\), and \(0.45\) is inside it.
Проверяют, умеешь ли ты читать веса: место ступеньки равно \(-w_0/w\). На калькуляторе: \(e^{-2.5} = 0.0821\), значит \(\sigma(2.5) = 1/1.0821\). Типичная ошибка — посчитать только первую сигмоиду и забыть вычесть вторую.
A function \(f\) on \(K = [0, 1]\) satisfies \(\abs{f'(x)} \le 2\). It is approximated by \(M\) equal-width bumps with ideal vertical walls; the height of each bump is the value of \(f\) at the centre of its interval. What is the smallest \(M\) for which the bound on the worst-case error is at most \(0.05\)?
Show model answer
Inside an interval of width \(\Delta = 1/M\) a point is at most \(\Delta/2\) away from the centre, so
\[ \abs{f(x) - f(c_i)} \le 2 \cdot \frac{\Delta}{2} = \Delta \le 0.05 \] \[ M = \frac{1}{\Delta} \ge 20 \]So \(M = 20\) bumps, i.e. 40 sigmoid hidden units (two per bump). With three inputs and the same resolution per axis the grid has \(20^3 = 8000\) cells: the size grows exponentially with the number of inputs.
Здесь важен ход мысли: «расстояние до середины не больше \(\Delta/2\)» и «наклон не больше 2». Вторая половина ответа — про три входа — показывает, что ты понимаешь, откуда берётся слово «exponential» на слайде 20 лекции 2. Следи за знаком: здесь спрошено «at most», поэтому годится ровно 20. При строгом «less than», как в теореме, понадобилась бы 21 башенка.
Show that a network with one hidden layer of \(J\) units with linear activation \(h(a) = a\) and a linear output computes an affine function of its input for every \(J\). What does this imply for the universal approximation theorem?
Show model answer
with \(v_i = \sum_j w^{(2)}_{1j} w^{(1)}_{ji}\) and \(c = \sum_j w^{(2)}_{1j} w^{(1)}_{j0}\). The output is affine in \(x\) whatever \(J\) is, so the network is equivalent to a single linear unit and cannot approximate a non-linear target to arbitrary accuracy. The theorem therefore needs non-linear hidden units (S-shaped on slide 20 of lecture 2).
Достаточно поменять порядок суммирования и назвать результат: «affine for every J». Хороший штрих — пример: к \(\sin x\) на \([-3, 3]\) никакая прямая не подходит ближе чем на 0.63.
Проверь себя
Один вход, один скрытый сигмоидный нейрон, линейный выход. Какой график \(g(x)\) может дать такая сеть?
Что из перечисленного теорема не гарантирует?
Картинка для памяти: теорема — это справка «такая постройка возможна». В ней нет ни инструкции по сборке, ни сметы, ни гарантии, что дом простоит в непогоду.
Цель \(\sin 3x\) вместо \(\sin x\), отрезок и точность \(\varepsilon\) те же. Как изменится число башенок в нашей постройке?
Сеть из виджета построена для \(K = [-3, 3]\). Что она выдаст при \(x = 10\)?
На рис. 15 конспекта сеть с 20 нейронами после 5 итераций приближает синус плохо, а после 50 — хорошо. Что это говорит о теореме?
Скрытые нейроны используют активацию \(h(a) = a^2\). Вход один, скрытый слой один, выход линейный. Универсальна ли такая сеть?
Почему в теореме выходной нейрон линейный?
Унести с собой
- Один сигмоидный нейрон — одна ступенька в точке \(s = -w_0/w\); bump получается из двух нейронов с выходными весами \(+\alpha\) и \(-\alpha\).
- Ряд башенок с высотами \(f(c_i)\) повторяет непрерывную цель; зазор не больше \(L\Delta/2\) и уменьшается вдвое при удвоении числа нейронов.
- Universal approximation theorem (Hornik, 1991): сеть с одним скрытым слоем S-образных нейронов приближает любую непрерывную функцию на компакте с любой точностью, если нейронов достаточно.
- Это теорема существования: она не даёт ни весов, ни числа нейронов, и ничего не обещает за пределами компакта.
- Три «но» слайда 20 лекции 2: алгоритм может не найти веса; нейронов может понадобиться экспоненциально много; огромный слой плохо учится и плохо обобщает.
- Нелинейность обязательна, но её одной мало: с линейной активацией выходит прямая, с квадратичной — парабола.
- Глубина нужна не потому, что одного слоя мало в принципе, а потому, что многие функции она выражает гораздо меньшим числом нейронов.
Что посмотреть и почитать
-
[1.5] Capacity of neural network
Hugo Larochelle, курс Neural Networks9 мин
Рисунки на слайде 20 лекции 2 взяты у Larochelle. В этом видео своего курса он объясняет ту же серию картинок: что добавляет скрытый слой и откуда берутся области сложной формы.
-
A visual proof that neural nets can compute any function
Michael Nielsen, Neural Networks and Deep Learning, гл. 4
Та же постройка, что в уроке, но все ползунки в твоих руках: ступенька, башенка, ряд башенок, а потом и два входа. Сайт открывается только по http, браузер покажет «не защищено».
-
Why Deep Learning Works Unreasonably Well
Welch Labs
Продолжение последнего раздела в картинках: как слои складывают и растягивают плоскость и почему несколько узких слоёв рисуют границу, на которую одному широкому понадобилось бы намного больше нейронов.
-
Neural Networks Part 1: Setting up the Architecture
Stanford CS231n
Раздел «Representational power»: один скрытый слой универсален, но на практике всё равно берут глубокие сети — на одном экране текста. Удобно сверить свой экзаменационный ответ.
-
Approximation capabilities of multilayer feedforward networks
Kurt Hornik, Neural Networks 4(2), 1991
Та самая статья со слайда. Читать стоит только аннотацию: в ней сказано, что универсальность даёт архитектура, а не выбор конкретной активации.