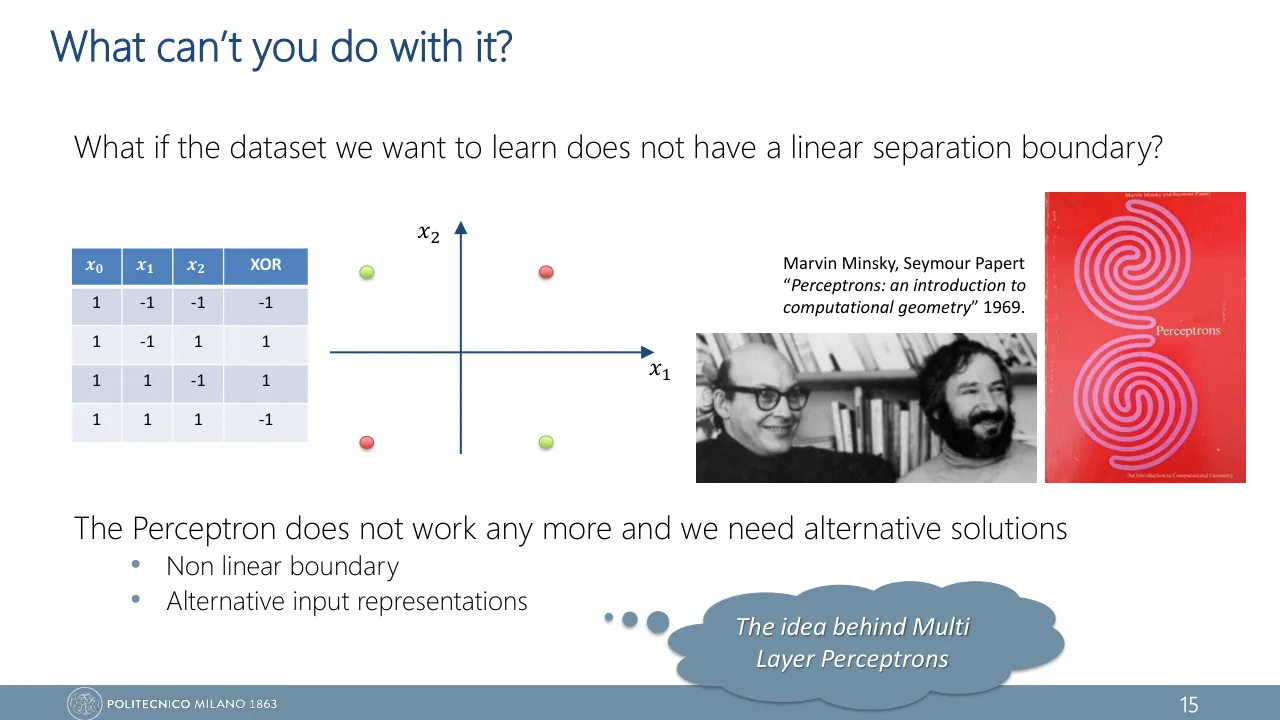
Марвин Минский и Сеймур Пейперт выпускают книгу «Perceptrons: an introduction to computational geometry». Минский и Розенблатт когда-то учились в одной нью-йоркской школе, Bronx High School of Science, с разницей в год. Книга не «открыла» историю с XOR: что один пороговый элемент с ним не справляется, знали и раньше. Её настоящие теоремы — о чётности и связности фигур для однослойных перцептронов, в которых каждый элемент видит лишь часть картинки. А то, что сеть из пороговых элементов способна вычислить любую логическую функцию, было известно ещё с работы Мак-Каллока и Питтса 1943 года. Не хватало другого: способа такие сети обучать. Розенблатт возрождения не увидел: он погиб 11 июля 1971 года, в свой 43-й день рождения, катаясь на лодке в Чесапикском заливе.
Четыре точки, остановившие науку
После этого урока ты четырьмя неравенствами докажешь, что один перцептрон не вычислит XOR, назовёшь два выхода из тупика и объяснишь, почему Hebbian learning не может обучить скрытый слой.
Июль 1958 года. Американский флот показывает журналистам перцептрон Фрэнка Розенблатта. Пока это программа: пятитонный компьютер IBM 704 получает перфокарты и примерно за пятьдесят попыток сам учится отличать карты с меткой слева от карт с меткой справа. На следующий день New York Times пересказывает ожидания флота: такая машина научится ходить, говорить, видеть, писать, воспроизводить себя и осознавать собственное существование.
Через одиннадцать лет выходит книга, после которой интерес к перцептронам надолго гаснет. Довод, который с ней связывают чаще всего, умещается на салфетке. Нарисуй квадрат. Два угла на одной диагонали закрась синим, два на другой — оранжевым. Теперь одной прямой отдели синие углы от оранжевых.
Не выйдет, и к концу урока ты докажешь это в четыре строчки. Но настоящая загадка в другом. Двумя прямыми задача решается за секунду, и об этом знали все. Как же четыре точки смогли остановить целую область науки?
Что можно отрезать одним разрезом
В уроке 6 перцептрон оказался прямой. Он считает активацию \(a = w_0 + w_1 x_1 + w_2 x_2\) и отвечает 1 там, где \(a \gt 0\). Всё, что лежит по одну сторону прямой \(a = 0\), получает один ответ, всё по другую сторону — другой. Один нейрон — это один прямой разрез ножом.
Для логических функций разрез легко увидеть. Входы \(x_1\) и \(x_2\) принимают значения 0 и 1, значит, разных входов всего четыре: это углы квадрата. Логическая функция красит каждый угол в «1» или в «0». Перцептрон вычисляет функцию тогда, когда одним разрезом можно отделить углы с единицей от углов с нулём.
Разрез есть: linearly separable
Разреза нет
У этого свойства есть название, которое нужно знать по-английски.
Набор данных с двумя классами называется linearly separable (линейно разделимым), если существуют веса \(\vb{w}\) и bias \(w_0\), при которых гиперплоскость \(w_0 + \vb{w}\T\vb{x} = 0\) оставляет все точки одного класса по одну сторону, а все точки другого — по другую. На плоскости гиперплоскость — это прямая, в трёхмерном пространстве — плоскость.
- \(\vb{x}_n\)
- точка данных с номером \(n\)
- \(t_n\)
- target: ответ, который модель должна дать на \(\vb{x}_n\)
- \(\vb{w},\ w_0\)
- веса и bias одного перцептрона
Выражение \(w_0 + \vb{w}\T\vb{x}\) знакомо по Applied Statistics: линейная регрессия считает точно такую же сумму. Разница в том, что регрессии нужно само число, а перцептрону — только его знак.
Сколько всего логических функций двух входов? У каждого из четырёх углов два варианта цвета, итого \(2^4 = 16\) раскрасок. Линейно разделимы 14 из них: все, кроме XOR и XNOR. Звучит обнадёживающе, но доля быстро падает: при трёх входах разделимы уже только 104 функции из 256.
Один перцептрон вычисляет функцию тогда и только тогда, когда её два класса linearly separable.
XOR: комната без выхода
XOR (exclusive OR, исключающее «или») отвечает 1, когда включён ровно один из двух входов. Ниже его таблица в двух кодировках: 0/1, как в конспекте, и −1/+1, как на слайде 15 лекции 2. Вторая получается из первой растяжением и сдвигом, поэтому картинка одна и та же: одинаковые ответы стоят по диагонали.
| конспект: 0/1 | слайд 15: −1/+1 | |||||
|---|---|---|---|---|---|---|
| \(x_1\) | \(x_2\) | \(t\) | \(x_0\) | \(x_1\) | \(x_2\) | \(t\) |
| 0 | 0 | 0 | 1 | −1 | −1 | −1 |
| 0 | 1 | 1 | 1 | −1 | 1 | 1 |
| 1 | 0 | 1 | 1 | 1 | −1 | 1 |
| 1 | 1 | 0 | 1 | 1 | 1 | −1 |
Прежде чем что-то доказывать, попробуй руками. В виджете три «комнаты». Первая — честная задача из загадки: один нейрон, три ползунка. Две другие — запасные выходы; загляни в них сразу, объяснение будет в следующем разделе.
Доказательство в четыре неравенства
Перебор ползунков ещё не доказательство: вдруг нужные веса лежат между делениями или за краем шкалы. Докажем для любых чисел. Приём годится для любой таблицы истинности: каждая её строка превращается в одно неравенство на веса.
-
Допустим, веса нашлись: нейрон отвечает 1 при \(a \gt 0\), иначе 0, и воспроизводит всю таблицу XOR (кодировка 0/1).
\[ a = w_0 + w_1 x_1 + w_2 x_2 \] -
Строки с ответом 0 — входы (0, 0) и (1, 1). Нейрон молчит, значит, активация не положительна. Ноль тоже подходит: при \(a = 0\) нейрон отвечает 0, поэтому знак здесь нестрогий.
\[ w_0 \le 0 \] \[ w_0 + w_1 + w_2 \le 0 \] -
Строки с ответом 1 — входы (0, 1) и (1, 0). Нейрон срабатывает, значит, активация положительна:
\[ w_0 + w_2 \gt 0 \] \[ w_0 + w_1 \gt 0 \] -
Сложим два неравенства из шага 3. Сумма двух положительных чисел положительна:
\[ 2w_0 + w_1 + w_2 \gt 0 \] -
Сложим два неравенства из шага 2. Сумма двух неположительных чисел неположительна:
\[ 2w_0 + w_1 + w_2 \le 0 \] -
Одно и то же число оказалось и больше нуля, и не больше нуля. Противоречие: таких весов не существует. XOR не linearly separable.
Это те самые две суммы из виджета. Слева в шагах 4 и 5 стоит одно выражение: сумма активаций двух синих точек всегда равна сумме активаций двух оранжевых. В кодировке −1/+1 со слайда 15 выходит ещё короче: из двух строк с ответом +1 получается \(2w_0 \gt 0\), из двух строк с ответом −1 получается \(2w_0 \lt 0\).
В определении стоит «< 0», а в доказательстве «≤ 0». Это не разные задачи?
Для конечного набора точек — нет. Пусть какая-то точка класса 0 попала ровно на границу, \(a = 0\). Уменьши \(w_0\) на число, которое меньше самой маленькой положительной активации: все активации немного опустятся, эта точка уйдёт на отрицательную сторону, а положительные останутся положительными. Значит, веса с «≤ 0» всегда можно превратить в веса с «< 0». Нестрогий знак в доказательстве нужен, чтобы закрыть оба случая разом.
На экзамене «найди веса для такой-то логической функции» решается тем же приёмом: выпиши по неравенству на строку таблицы и подбери числа. Если неравенства противоречат друг другу, функция не linearly separable, и это тоже ответ.
То же самое одной картинкой
Середина отрезка между синими точками — это \((0.5,\ 0.5)\). Середина отрезка между оранжевыми — та же самая точка. Активация \(a\) меняется вдоль любого отрезка равномерно, поэтому в середине она равна среднему значений на концах. По синим концам выходит \(a(0.5, 0.5) \gt 0\), по оранжевым — \(a(0.5, 0.5) \le 0\). Опять противоречие.
OR: оболочки не касаются
XOR: оболочки пересекаются
Это общее правило: два конечных набора точек linearly separable тогда и только тогда, когда их выпуклые оболочки не пересекаются. Для XOR две диагонали квадрата пересекаются всегда.
Может быть, просто дольше учить?
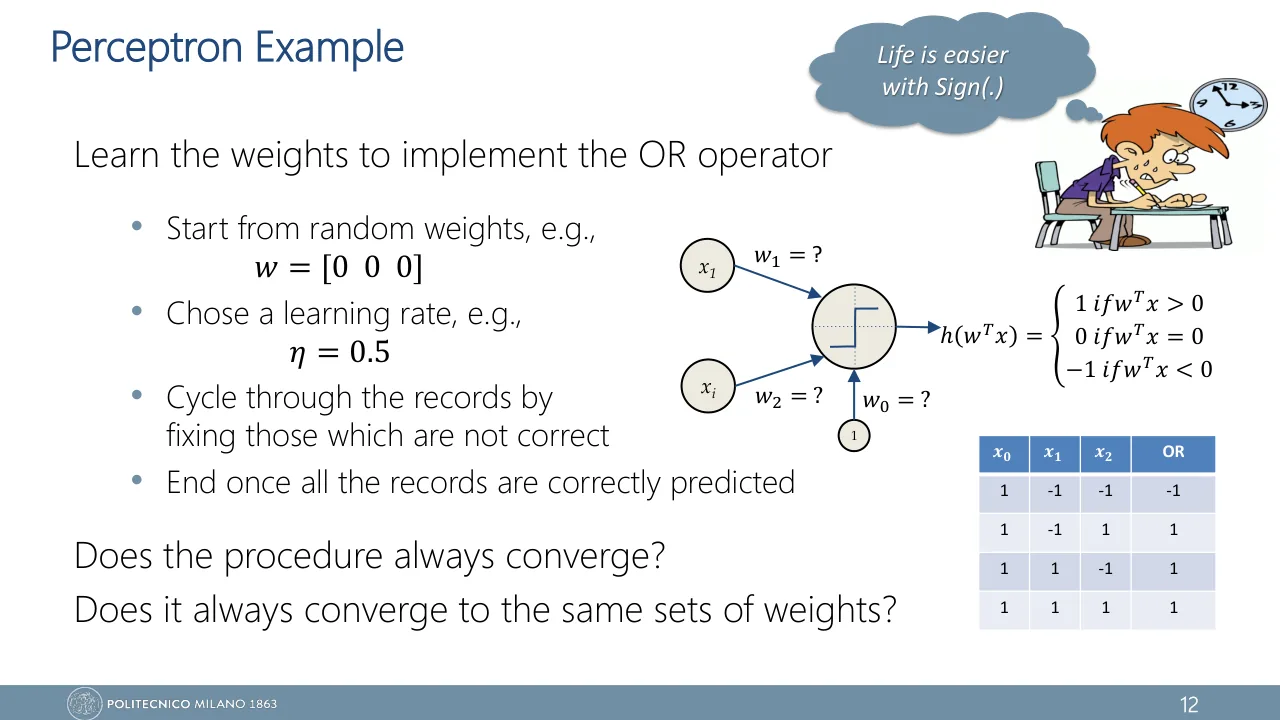
В уроке 7 Hebbian learning находило веса для OR за три исправления. Запустим то же правило \(\Delta w_i = \eta\, x_i\, t\) на XOR с числами со слайда 12: кодировка −1/+1, старт \(\vb{w} = [0\ 0\ 0]\), \(\eta = 0.5\), исправляем только неверно предсказанные записи.
| Шаг | \(\vb{x}\) | \(t\) | \(a\) | Ответ | \(\Delta\vb{w} = \eta\, t\, \vb{x}\) | Новые \(\vb{w}\) |
|---|---|---|---|---|---|---|
| 1 | (1, −1, −1) | −1 | 0 | 0 | (−0.5, 0.5, 0.5) | (−0.5, 0.5, 0.5) |
| 2 | (1, −1, 1) | 1 | −0.5 | −1 | (0.5, −0.5, 0.5) | (0, 0, 1) |
| 3 | (1, 1, −1) | 1 | −1 | −1 | (0.5, 0.5, −0.5) | (0.5, 0.5, 0.5) |
| 4 | (1, 1, 1) | −1 | 1.5 | 1 | (−0.5, −0.5, −0.5) | (0, 0, 0) |
Все четыре записи оказались ошибками, и после четвёртого исправления веса вернулись в \([0\ 0\ 0]\) — туда, откуда начали. Вторая эпоха повторит первую шаг в шаг, третья тоже. Правило ходит по кругу и не остановится никогда: условие остановки «все записи предсказаны верно» недостижимо.
«Перцептрон не может выучить XOR — значит, нужно правило обучения получше или больше эпох». Нет. Он не может XOR представить: нужных весов не существует, поэтому искать их бесполезно любым способом. Это два разных вопроса — существует ли решение (representation) и умеем ли мы его найти (learning). Сама задача при этом тривиальна: трудной её делает только класс моделей «одна прямая».
XOR — самый маленький пример, но не единственный. Конспект (стр. 56) называет ещё два. Parity — ответ 1 при нечётном числе включённых входов; это XOR для любого числа входов. Circle-vs-ring — один класс лежит кружком внутри кольца из точек другого. Причина во всех трёх случаях одна: выпуклые оболочки классов пересекаются, и одной гиперплоскостью класс не отрезать.
Два выхода из комнаты
На слайде 15 лекции 2 под таблицей XOR стоит вывод: «The Perceptron does not work any more and we need alternative solutions», и два пункта: Non linear boundary и Alternative input representations. Рядом приписано: «The idea behind Multi Layer Perceptrons». Оба выхода уже встречались в виджете: это комнаты 2 и 3.
Выход первый: дать нейрону другой вход
Перцептрон линеен относительно того, что ему подали. Так подадим больше. Добавим третий вход \(x_3 = x_1 x_2\): он равен 1 только в углу (1, 1), то есть ровно там, где OR ошибался. Возьмём веса OR и добавим к ним штраф за этот угол:
- \(w_1 = w_2 = 1\)
- как у OR
- \(w_3 = -2\)
- вес нового входа \(x_1 x_2\)
- \(w_0 = -0.5\)
- bias, как у OR
Проверка по четырём строкам: \(a = -0.5,\ 0.5,\ 0.5,\ {-0.5}\), ответы 0, 1, 1, 0. Это XOR. Нейрон остался тем же, изменилось то, что он видит: вместо двух чисел три. В кодировке −1/+1 со слайда 15 выходит совсем коротко: там XOR — это ровно \(t = -x_1 x_2\), и нейрону хватило бы одного этого входа с весом −1.
До: только \(x_1\) и \(x_2\)
После: добавили ось \(x_1 x_2\)
В трёхмерном пространстве нейрон по-прежнему проводит плоскость, то есть остаётся линейным классификатором. А в старой плоскости \((x_1, x_2)\) след этой плоскости — кривая: именно она изгибалась в комнате 2. Поэтому два пункта со слайда — две стороны одной идеи. Alternative input representation в новом пространстве выглядит как non linear boundary в старом.
У этого выхода есть цена: признак \(x_1 x_2\) придумали мы сами. Это hand-crafted feature из урока 3. Для четырёх точек угадать его легко, для фотографий — нет.
Выход второй: пусть новые входы вычисляют нейроны
Вместо придуманного признака поставим перед выходным нейроном два обычных перцептрона и дадим ему их ответы. Такие промежуточные нейроны называются скрытыми (hidden units), их слой — hidden layer, а их ответы на слайдах обозначаются \(h_j\). Подойдут два уже знакомых вентиля: \(h_1 = \mathrm{OR}\), \(h_2 = \mathrm{NAND}\). Тогда XOR — это «хотя бы один» и одновременно «не оба»:
\[ h_1 = \mathrm{OR}(x_1, x_2) \] \[ h_2 = \mathrm{NAND}(x_1, x_2) \] \[ \mathrm{XOR}(x_1, x_2) = \mathrm{AND}(h_1, h_2) \]| \(x_1\) | \(x_2\) | \(h_1\): OR | \(h_2\): NAND | \(g\): AND | \(t\) |
|---|---|---|---|---|---|
| 0 | 0 | −0.5 → 0 | 1.5 → 1 | −0.5 → 0 | 0 |
| 0 | 1 | 0.5 → 1 | 0.5 → 1 | 0.5 → 1 | 1 |
| 1 | 0 | 0.5 → 1 | 0.5 → 1 | 0.5 → 1 | 1 |
| 1 | 1 | 1.5 → 1 | −0.5 → 0 | −0.5 → 0 | 0 |
Геометрически каждый скрытый нейрон проводит свою прямую, и вместе они вырезают полосу. Выходной нейрон исходной плоскости уже не видит: ему достаются только ответы \((h_1, h_2)\). В этих координатах четыре входа превращаются в три точки, и синяя стоит в углу одна.
На языке слайдов эта сеть записывается так. У весов два индекса: первый — в какой нейрон связь входит, второй — откуда она идёт; верхний индекс в скобках — номер слоя. Подробно эти обозначения разбирает урок 9.
- \(h(\cdot)\)
- ступенька: 1 при положительном аргументе, иначе 0
- \(h_j\)
- ответ скрытого нейрона \(j\), здесь \(j = 1, 2\)
- \(w_{ji}^{(l)}\)
- вес в слое \(l\): в нейрон \(j\) от входа \(i\); \(i = 0\) — bias
- \(g(\vb{x} \mid w)\)
- ответ всей сети на вход \(\vb{x}\)
«Для XOR нужны две прямые, значит, хватит двух нейронов». Нейронов три: два скрытых проводят прямые, третий объединяет их ответы. Всего девять чисел — по два веса и одному bias на нейрон.
Чем этот выход лучше первого? Признак \(x_1 x_2\) пришлось придумать. А ответы \(h_1\) и \(h_2\) — тоже новые признаки, но их вычисляют нейроны с обычными весами. Если веса можно выучить, сеть будет строить себе представление сама. Это и есть Multi Layer Perceptron.
Скрытый слой не решает задачу — он переносит точки в пространство, где её решает одна прямая.
Что даёт глубина
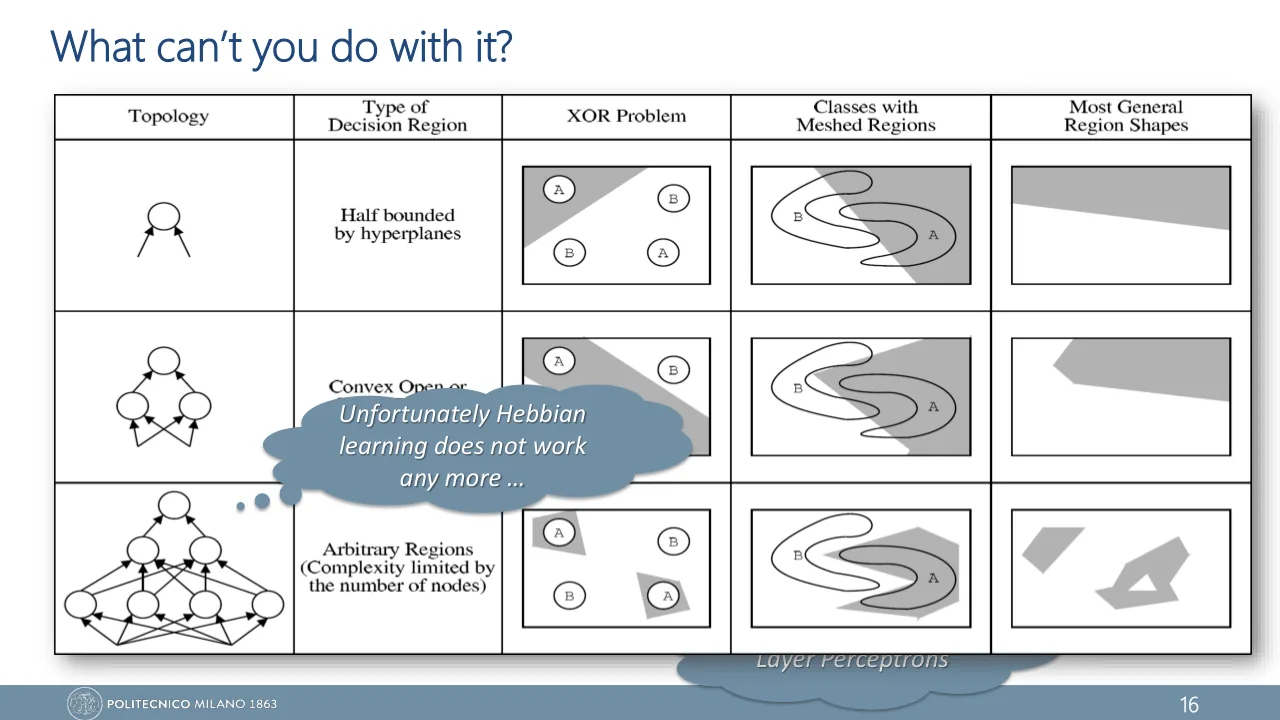
Если один скрытый слой превращает прямую в полосу, что даст ещё один? Слайд 16 лекции 2 отвечает таблицей из обзора Липпмана 1987 года. В ней три строки — три типа сети из пороговых нейронов — и для каждой указан тип области, которую сеть умеет отдать одному классу (decision region).
| Сеть | Type of decision region | Как она получается |
|---|---|---|
| Один нейрон | Half bounded by hyperplanes | полуплоскость (half-plane) по одну сторону прямой |
| Один скрытый слой | Convex open or closed regions | пересечение полуплоскостей: выход работает как AND |
| Два скрытых слоя | Arbitrary regions (complexity limited by the number of nodes) | объединение выпуклых кусков: выход работает как OR |
Логика таблицы — в третьем столбце. Первый слой умеет только резать: каждый его нейрон — одна прямая. Следующий нейрон может потребовать «по правильную сторону от всех этих прямых сразу» — это AND, и получается выпуклая область: полоса, клин, многоугольник. Ещё один слой может сказать «в любом из этих кусков» — это OR, и из выпуклых кусков складывается что угодно: подкова, два острова, кольцо с дыркой.
На слайде каждая строка проиллюстрирована тремя задачами: XOR problem, classes with meshed regions и most general region shapes. В виджете ниже это три набора данных.
Постой: а разве один скрытый слой не умеет всё?
Хороший вопрос, если уже слышно про universal approximation из урока 12: там одного скрытого слоя хватает, чтобы приблизить любую непрерывную функцию. Противоречия нет. Таблица слайда 16 лекции 2 — не теорема, а простейший рецепт: скрытые нейроны дают полуплоскости, выходной нейрон берёт их AND. Дай выходному нейрону другие веса, и тот же скрытый слой вырежет невыпуклую область: сеть для XNOR отвечает 1 всюду вне полосы, то есть на двух отдельных полуплоскостях. Теорема же говорит о приближении, о гладких нейронах и о том, что нейронов может понадобиться очень много.
На вопрос про слайд 16 лекции 2 отвечай так, как на слайде: half-plane, convex regions, arbitrary regions.
Таблица обещает многое: дай сети два скрытых слоя и достаточно нейронов — и она вырежет любую область. Но во всех трёх виджетах веса скрытых нейронов расставлены вручную. Кто будет подбирать их в настоящей задаче? На том же слайде поверх таблицы висит облачко: «Unfortunately Hebbian learning does not work any more …».
Так что же остановило науку
Вернёмся к загадке из начала. Четыре точки не разделить одной прямой, но двумя прямыми и третьим нейроном — легко. Почему это не спасло перцептроны?
Скрытым нейронам некому подсказать ответ
Посмотри на правило из урока 7 ещё раз: \(\Delta w_i = \eta\, x_i\, t\). В нём стоит \(t\) — желаемый ответ того нейрона, чьи веса исправляют. У выходного нейрона \(t\) есть: это столбец ответов в таблице. А какой \(t\) у скрытого нейрона \(h_2\)? В виджете с сетью из трёх нейронов было видно, что годится и NAND, и AND: данные между ними не выбирают. В обучающей выборке вообще нет столбца «что должен ответить скрытый нейрон». Нет цели — правилу нечего подставить.
У этой беды есть имя: credit assignment problem — задача распределения ответственности. Сеть ошиблась на выходе; какой из скрытых нейронов виноват и в какую сторону ему меняться?
Вторая беда — сама ступенька. Чуть сдвинь вес скрытого нейрона: его ответ либо не изменится вовсе, либо перескочит с 0 на 1. Производная ступеньки равна нулю везде, кроме одной точки, где её нет. Поэтому нельзя даже спросить «в какую сторону крутить этот вес, чтобы ошибка на выходе немного уменьшилась» — ошибка на малые изменения не откликается. Отсюда требование следующего слайда: activation functions must be differentiable. Гладкие функции активации появятся в уроке 10, а способ донести ошибку до скрытых весов, backpropagation, — в уроке 14.
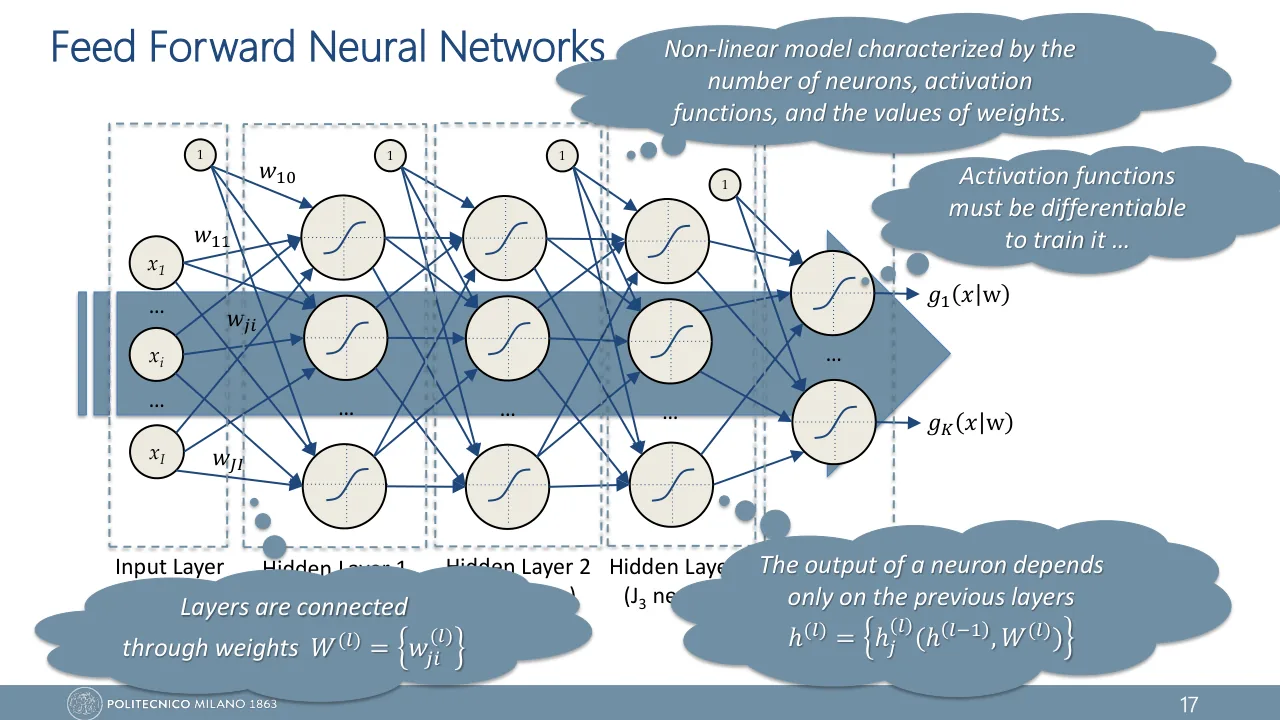
Теперь загадку можно закрыть. Науку остановили не четыре точки. Что XOR решается скрытым слоем, было понятно: мы собрали такую сеть из трёх нейронов за пять минут. Остановило то, что эти три нейрона пришлось настраивать руками. Правило обучения требовало цели для каждого нейрона, а для скрытых нейронов целей не было. Широкую известность выход получил в 1986 году, когда Румельхарт, Хинтон и Уильямс на четырёх страницах журнала Nature показали: с гладкими нейронами и backpropagation скрытые нейроны сами выучивают полезные признаки. Сам метод вычисления при этом был опубликован ещё в 1970 году, в магистерской работе финского студента Сеппо Линнайнмаа, — и нейросети в ней не упоминались.
XOR показал предел одного нейрона, а зиму вызвало другое: никто не умел обучать скрытые слои.
В формате экзамена
Prove that a single perceptron cannot implement the XOR function of two binary inputs. Then name two ways to overcome this limitation.
Show model answer
Use 0/1 coding and a perceptron that outputs 1 iff \(a = w_0 + w_1 x_1 + w_2 x_2 \gt 0\). Assume weights implementing XOR exist. Each row of the truth table gives one inequality:
\[ (0,0) \to 0:\quad w_0 \le 0 \] \[ (0,1) \to 1:\quad w_0 + w_2 \gt 0 \] \[ (1,0) \to 1:\quad w_0 + w_1 \gt 0 \] \[ (1,1) \to 0:\quad w_0 + w_1 + w_2 \le 0 \]Adding the second and third gives \(2w_0 + w_1 + w_2 \gt 0\); adding the first and fourth gives \(2w_0 + w_1 + w_2 \le 0\). This is a contradiction, so no such weights exist: XOR is not linearly separable, and a perceptron can only realise a linear decision boundary.
Remedies: (1) an alternative input representation, e.g. add the feature \(x_1 x_2\); then \(a = x_1 + x_2 - 2x_1x_2 - 0.5\) works. (2) A non-linear boundary obtained with a hidden layer, i.e. a Multi Layer Perceptron: \(\mathrm{XOR} = \mathrm{AND}(\mathrm{OR}, \mathrm{NAND})\).
Проверяют три вещи: четыре неравенства со знаками строго по правилу срабатывания, явное противоречие и оба выхода со слайда 15 лекции 2. Фраза «the points cannot be separated by a line» без выкладки — это утверждение, а не доказательство. В кодировке −1/+1 выкладка короче: \(2w_0 \gt 0\) и \(2w_0 \lt 0\).
Hebbian learning is run on XOR with \(\{-1, +1\}\) coding, records in truth-table order \((-1,-1), (-1,1), (1,-1), (1,1)\), initial weights \(w = [w_0\ w_1\ w_2] = [0\ 0\ 0]\), learning rate \(\eta = 0.5\) and the three-valued \(\mathrm{Sign}\) activation (an output of 0 counts as an error). What is the value of \(w_1\) after the third record has been processed?
Show model answer
Update \(w \leftarrow w + \eta\, t\, x\) with \(x = (1, x_1, x_2)\), only on misclassified records.
Record 1: \(a = 0\), output 0, wrong; \(w = (-0.5,\ 0.5,\ 0.5)\).
Record 2: \(a = -0.5\), output \(-1 \ne 1\), wrong; \(w = (0,\ 0,\ 1)\).
Record 3: \(a = -1\), output \(-1 \ne 1\), wrong; \(w = (0.5,\ 0.5,\ 0.5)\).
So \(w_1 = 0.5\). The fourth record is wrong too (\(a = 1.5\)) and brings the weights back to \((0, 0, 0)\): the procedure cycles forever, because XOR is not linearly separable.
Числа те же, что в упражнении слайда 12 лекции 2, только таблица XOR. Типичные потери: забыть постоянный вход \(x_0 = 1\) и не обновить \(w_0\); посчитать \(\mathrm{Sign}(0)\) верным ответом на первом шаге.
A perceptron (output 1 iff \(a \gt 0\)) receives three inputs \(x_1\), \(x_2\) and \(x_3 = x_1 x_2\), with weights \(w_1 = 1\), \(w_2 = 1\), \(w_3 = -2\) and bias \(w_0 = -0.5\). Compute the activation \(a\) for the input \(x_1 = 1,\ x_2 = 1\).
Show model answer
The activation is not positive, so the output is 0. For the other inputs \(a = -0.5,\ 0.5,\ 0.5\): the perceptron computes XOR in the extended input space.
Проверяют, понимаешь ли ты, что признак \(x_1 x_2\) — просто ещё один вход со своим весом. Если на экзамене попросят «show that this solves XOR», выпиши все четыре активации.
Which of the following Boolean functions of two inputs can be implemented by a single perceptron? Select all that apply.
Show model answer
AND, NAND and NOR are linearly separable; XOR and XNOR are not. Of the 16 Boolean functions of two inputs, 14 are linearly separable.
NAND и NOR забывают чаще всего. Смена знака у всех весов и у bias оставляет прямую на месте и меняет ответы местами, поэтому отрицание разделимой функции тоже разделимо.
According to the decision-region table shown in the lecture, which type of decision region can a network of threshold units with one hidden layer form?
Show model answer
Convex open or closed regions: each hidden unit defines a half-plane and the output unit intersects them. XOR is solved this way by the band between two parallel lines.
Таблицу слайда 16 лекции 2 достаточно помнить тремя парами: один нейрон — half-plane, один скрытый слой — convex, два скрытых слоя — arbitrary.
Проверь себя
Один перцептрон учат правилом Hebbian learning на таблице XOR. После тысячи эпох он всё ещё ошибается. Что поможет?
Какие наборы точек linearly separable? Синие — цель 1, оранжевые — цель 0.
Быстрая проверка: натяни резинку на каждый класс. Если резинки пересекаются или точка одного класса лежит внутри резинки другого — прямой нет.
К входам \(x_1, x_2\) добавили третий, \(x_1 x_2\), и перцептрон вычислил XOR. Что при этом произошло?
Скрытый слой \(h_1 = \mathrm{OR}\), \(h_2 = \mathrm{NAND}\). Сколько разных точек получается в плоскости \((h_1, h_2)\) из четырёх входов XOR?
Почему правило \(\Delta w_i = \eta\, x_i\, t\) нельзя применить к весам скрытого нейрона?
Класс A занимает два отдельных островка, класс B — всё вокруг них и между ними. Сеть какой глубины нужна по таблице слайда 16 лекции 2?
Что на самом деле задержало нейросети после 1969 года?
Унести с собой
- Один перцептрон вычисляет функцию тогда и только тогда, когда её классы linearly separable: существует гиперплоскость \(w_0 + \vb{w}\T\vb{x} = 0\), по разные стороны которой лежат два класса.
- Из 16 логических функций двух входов разделимы 14. Исключения — XOR и XNOR: одинаковые ответы стоят по диагонали.
- Доказательство для XOR — четыре неравенства по строкам таблицы; суммы по классам дают \(2w_0 + w_1 + w_2 \gt 0\) и \(\le 0\) одновременно.
- Перцептрон не может XOR представить, поэтому Hebbian learning на нём не сходится, а ходит по кругу.
- Два выхода со слайда 15 лекции 2: другой вход (признак \(x_1 x_2\)) или скрытый слой (OR и NAND, затем AND). Оба меняют представление точек.
- Слайд 16 лекции 2: один нейрон — half-plane, один скрытый слой — convex regions, два скрытых слоя — arbitrary regions.
- Hebbian learning не обучает скрытые слои: у скрытых нейронов нет target, а производная ступеньки везде, где она есть, равна нулю — ошибке не за что зацепиться.
Что посмотреть и почитать
-
ChatGPT is made from 100 million of these [The Perceptron]
Welch Labsоколо 24 мин
История перцептрона Розенблатта и машины Mark I: правило обучения, его пределы и путь от него к современному backpropagation. Хороший разгон перед уроком.
-
A Neural Network Playground
Daniel Smilkov, Shan Carter
Три опыта по уроку. Данные «Exclusive or» без скрытых слоёв: граница остаётся бесполезной прямой. Добавь скрытый слой из 2–4 нейронов — задача решена. Убери его и включи вход x1·x2 — решена мгновенно. Только здесь веса не расставлены руками, а обучаются.
-
ConvNetJS demo: Classify toy 2D data
Andrej Karpathy
Правая панель показывает данные так, как их видит скрытый слой: сеть на глазах сгибает плоскость, пока классы не разделятся прямой. Это рис. 4 в движении.
-
Neural Networks, Manifolds, and Topology
Christopher Olah
Анимации о том, как слои растягивают плоскость, чтобы распутать два класса, и почему некоторым данным нужна минимальная ширина скрытого слоя. Продолжение идеи «скрытый слой меняет пространство».
-
Perceptrons (book)
Wikipedia
Что на самом деле доказано в книге Минского и Пейперта и откуда взялся миф «книга про XOR». Пригодится, если захочется проверить историческую часть урока.