Метод придумали не для нейросетей. Впервые его опубликовал в 1970 году финский студент Seppo Linnainmaa в магистерской работе — как способ быстро дифференцировать цепочки вычислений. Paul Werbos в 1974 году обсуждал его применение к нейросетям. Знаменитым метод сделала статья Rumelhart, Hinton и Williams в Nature (1986): четыре страницы, на которых показано, что hidden-нейроны с его помощью сами выучивают полезные признаки.
Жалоба идёт назад по конвейеру
После этого урока ты посчитаешь градиент любого веса сети с одним hidden layer — на числах и в общем виде, как на слайде профессора, — и объяснишь, почему на все веса хватает двух проходов.
В сети миллион весов. Gradient descent из прошлого урока на каждом шаге хочет знать про каждый вес одно число: насколько изменится ошибка, если этот вес чуть сдвинуть. Миллион частных производных.
Самый прямой способ узнать такое число — пошевелить вес и прогнать сеть заново. Один вес — один прогон. Миллион весов — миллион прогонов ради одного-единственного шага обучения.
Backpropagation получает тот же миллион чисел за два прогона: один вперёд и один назад. И не приближённо, а точно. Как одна поездка назад успевает сообщить каждому весу его личную долю вины?
Миллион производных и два способа «в лоб»
В уроке 13 всё обучение уместилось в одну строку:
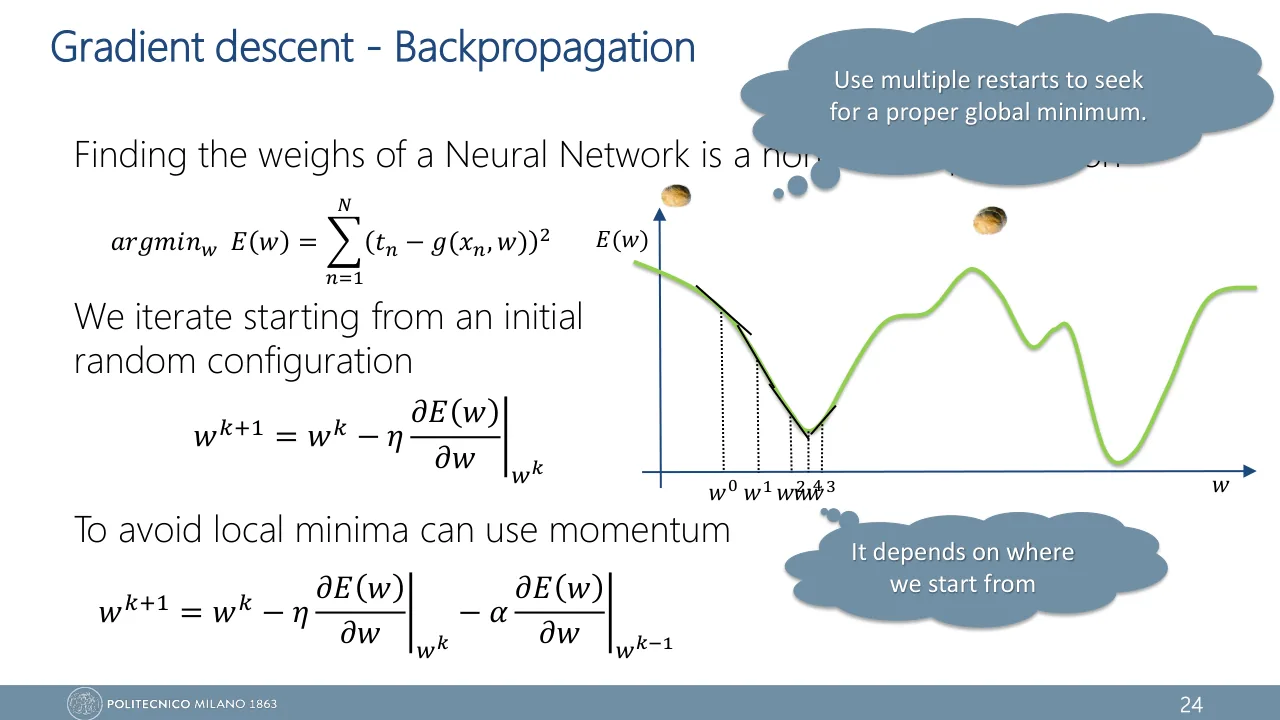
\[ w^{k+1} = w^{k} - \eta \left.\pd{E(w)}{w}\right|_{w^{k}} \]Там ошибка была параболой от одного-двух весов, и производную можно было выписать сразу. В настоящей Feed Forward Neural Network так не получится. Вес первого слоя влияет на ошибку не напрямую, а через всё, что стоит после него: свой нейрон, его activation function, выходной нейрон. И таких весов тысячи.
Получить производные «в лоб» можно двумя способами. Оба плохие.
Сдвинь один вес на крошечное \(\varepsilon\), прогони сеть заново и посмотри, насколько изменилась ошибка: \(\Delta E / \varepsilon\). Способ называется finite differences (конечные разности).
Для \(W\) весов нужен \(W + 1\) прогон, а каждый прогон сам стоит порядка \(W\) умножений. Итого порядка \(W^2\). И ответ приближённый.
Взять правило производной сложной функции и честно выписать \(\partial E / \partial w\) для каждого веса отдельно.
Ответ точный. Но каждая формула заново проходит весь путь от веса до ошибки, и одни и те же куски считаются снова и снова.
Backpropagation (обратное распространение ошибки) — алгоритм, который считает производные ошибки \(E\) по всем весам сети за один проход вперёд и один проход назад. Он применяет правило производной сложной функции по порядку, от выхода ко входу, и переиспользует уже посчитанные промежуточные результаты.
«Backpropagation — это алгоритм обучения». Нет. Он только считает градиент и не меняет ни одного веса. Веса меняет gradient descent, которому этот градиент отдают. Backpropagation отвечает на вопрос «как получить наклон», gradient descent — «что с ним делать». Название слайда 24 лекции 2, "Gradient descent - Backpropagation", склеивает их в одно; на экзамене лучше разделять.
Конвейер с журналом
Представь конвейер. Каждый рабочий берёт то, что приехало по ленте, обрабатывает со своей настройкой и отправляет дальше. При этом он записывает в журнал, что получил и что отдал. В конце заказчик сравнивает изделие с заказом и пишет жалобу с числом: «меньше нужного на 0.066».
Жалоба едет назад по той же ленте. Каждый рабочий делает с ней две вещи. Поправляет свою настройку: на «жалоба × то, что лежало у меня на входе». И пересчитывает жалобу для предыдущего: насколько его деталь повлияла на мой результат. Один проезд вперёд, один назад — и настроены все.
Рабочие — это нейроны со своими весами. Журнал — сохранённые промежуточные числа. Жалоба — число, которое передаётся от выхода ко входу. Осталось понять правило, по которому жалобу пересчитывают при передаче.
Backpropagation считает градиент. Учит сеть gradient descent, которому этот градиент отдают.
Chain rule: умножай всё, что по дороге
Правило пересчёта — производная сложной функции, chain rule («правило цепочки»). Бытовая версия — три шестерёнки подряд. Если вторая крутится вдвое быстрее первой, а третья втрое быстрее второй, то третья крутится в шесть раз быстрее первой. Скорости вдоль цепочки перемножаются.
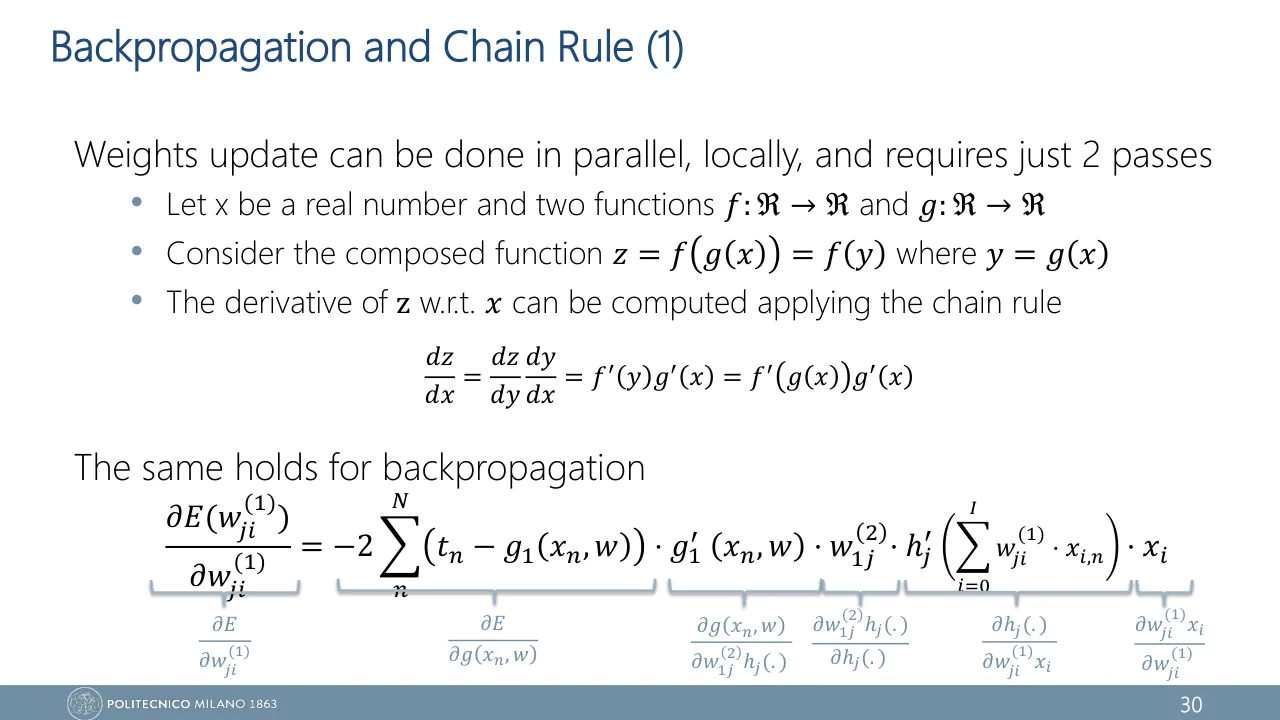
Профессор записывает это так (слайд 30 лекции 2). Пусть \(z = f(g(x))\), то есть \(z = f(y)\), где \(y = g(x)\). Тогда
\[ \frac{dz}{dx} = \frac{dz}{dy}\,\frac{dy}{dx} = f'(y)\,g'(x) \]
- \(dy/dx\)
- как быстро внутренняя функция \(g\) отзывается на \(x\)
- \(dz/dy\)
- как быстро внешняя функция \(f\) отзывается на свой вход \(y\)
Пример из конспекта (стр. 100–101): \(y = (2x + 3)^2\). Внутри стоит \(g = 2x + 3\), снаружи — квадрат. Каждое звено знает только свою производную: у внутреннего это 2, у внешнего \(2g\).
Каждый такой множитель называют local derivative (локальная производная). Звено отвечает только на вопрос «как мой выход отзывается на мой вход» и ничего не знает об остальной цепочке.
Для сети понадобится ещё одно школьное правило. В сумме \(w_1x_1 + w_2x_2 + \dots + w_5x_5\) от веса \(w_5\) зависит только последнее слагаемое. Поэтому производная всей суммы по \(w_5\) равна \(x_5\), а остальные слагаемые исчезают как константы.
Производная вдоль цепочки — произведение local derivatives всех её звеньев.
Сеть 1–1–1: вперёд с журналом, назад с жалобой
Самая маленькая сеть, на которой видно всё, — пример из конспекта (Example 9, стр. 102–106). Один вход, один нейрон в hidden layer с sigmoid, один выходной нейрон с линейной activation function. Обучающий пример (sample) тоже один: \(x = 1\), правильный ответ (target) \(t = 0.5\). Шаг обучения (learning rate) \(\eta = 0.1\).
Конспект и слайды называют одни и те же вещи по-разному. В уроке — обозначения профессора, а таблица поможет читать и то, и другое.
| Конспект | Слайды и урок | Что это |
|---|---|---|
| \(b^{(1)}_1\), \(b^{(2)}_1\) | \(w^{(1)}_{10}\), \(w^{(2)}_{10}\) | bias: вес от входа, который всегда равен 1 |
| \(w^{(l)}_{ij}\) | \(w^{(l)}_{ji}\) | вес слоя \(l\); первый индекс в обоих случаях — нейрон, в который вес входит |
| \(y\) | \(g(x|w)\) | выход сети |
| \(a^{(1)}_1\) в двух смыслах | \(a^{(1)}\) и \(h\) | взвешенная сумма нейрона до активации (net input) и его выход после неё |
| \(E = \tfrac12 (t - y)^2\) | \(E = \sum_n (t_n - g)^2\) | error function; разница — множитель 2 в каждом градиенте |
Forward pass: считаем и записываем
Forward pass (прямой проход) — обычное вычисление ответа сети слева направо. Его цель — узнать, насколько хороши текущие веса. Отличие от простого вычисления одно: каждое промежуточное число сохраняется. Сохранённое называют cache; это и есть журнал рабочих. В него попадут вход \(x\), net input hidden-нейрона \(a^{(1)}\), его выход \(h\), выход сети \(g\) и ошибка \(E\).
Backward pass: жалоба и два правила
Backward pass (обратный проход) начинается там, где forward pass закончился: у ошибки. Его цель — узнать, в какую сторону и насколько сильно менять каждый вес. Назад передаётся одно число на нейрон.
Error signal нейрона, \(\delta\) (в конспекте — error term), — производная ошибки по его net input: \(\delta = \partial E / \partial a\). Это «жалоба», дошедшая до нейрона: во сколько раз изменение ошибки больше маленького сдвига его взвешенной суммы. Знак говорит о направлении: при \(\delta \lt 0\) ошибка падает, когда сумма растёт.
У выходного нейрона жалоба получается прямо из ошибки. В примере \(E = \tfrac12 (t - g)^2\), а выход линейный, \(g = a^{(2)}\), поэтому
\[ \delta^{(2)} = \pd{E}{g} \cdot g'\big(a^{(2)}\big) = -(t - g) \cdot 1 \]Дальше работают два правила.
\[ \pd{E}{w^{(l)}_{ji}} = \delta^{(l)}_j \cdot h^{(l-1)}_i \]
\[ \delta^{(1)} = \delta^{(2)} \cdot w^{(2)}_{11} \cdot \sigma'\big(a^{(1)}\big) \]
- \(\delta^{(l)}_j\)
- error signal нейрона \(j\) слоя \(l\) — того, в который вес входит
- \(h^{(l-1)}_i\)
- то, что пришло по этому весу на forward pass: выход нейрона \(i\) предыдущего слоя. Для первого слоя это вход \(x_i\), для bias — единица
- \(\sigma'(a^{(1)})\)
- производная sigmoid; она равна \(h(1 - h)\) и считается из уже записанного \(h\)
Первое правило — chain rule в два звена. Вес влияет на ошибку только через net input своего нейрона, \(a_j = \sum_i w_{ji} h_i\). Производная этой суммы по \(w_{ji}\) равна \(h_i\): то самое школьное правило про сумму. Всё остальное уже собрано в \(\delta_j\).
Второе правило — передача жалобы на одно звено назад. От \(a^{(1)}\) до \(a^{(2)}\) два шага: через sigmoid (local derivative \(\sigma'\)) и через вес \(w^{(2)}_{11}\). На них жалоба и умножается.
«Назад едет сама ошибка \(t - g\)». Так легко прочитать и конспект (стр. 101): "The error (the difference between the predicted output and the actual target) is propagated backward through the network". Назад едет не разность, а производная ошибки \(\delta\). У линейного выхода она пропорциональна \(t - g\), но уже у hidden-нейрона это другое число: по дороге оно умножилось на вес и на \(\sigma'\).
Градиент веса = error signal нейрона, в который вес входит, × то, что по этому весу пришло.
Весь пример на одной странице — с округлением, как в конспекте. Номера шагов те же, что в виджете. Удобно сверять свои выкладки на калькуляторе.
| Шаг | Что считаем | Числа |
|---|---|---|
| 1 | дано | \(w^{(1)}_{11} = 0.4\), \(w^{(1)}_{10} = 0.3\), \(w^{(2)}_{11} = 0.5\), \(w^{(2)}_{10} = 0.1\) |
| 2 | \(a^{(1)} = w^{(1)}_{11}x + w^{(1)}_{10}\) | \(0.4 \cdot 1 + 0.3 = 0.7\) |
| 3 | \(h = \sigma(a^{(1)})\) | \(1 / (1 + e^{-0.7}) = 0.668\) |
| 4 | \(g = w^{(2)}_{11}h + w^{(2)}_{10}\) | \(0.5 \cdot 0.668 + 0.1 = 0.434\) |
| 5 | \(E = \tfrac12 (t - g)^2\) | \(\tfrac12 \cdot 0.066^2 = 0.0022\) |
| 6 | \(\delta^{(2)} = -(t - g) \cdot 1\) | \(-(0.5 - 0.434) = -0.066\) |
| 7 | \(\partial E/\partial w^{(2)}_{11} = \delta^{(2)} h\) | \(-0.066 \cdot 0.668 = -0.044\) |
| \(\partial E/\partial w^{(2)}_{10} = \delta^{(2)} \cdot 1\) | \(-0.066\) | |
| 8 | \(\delta^{(1)} = \delta^{(2)} w^{(2)}_{11}\, h(1 - h)\) | \(-0.066 \cdot 0.5 \cdot 0.222 = -0.0073\) |
| 9 | \(\partial E/\partial w^{(1)}_{11} = \delta^{(1)} x\) | \(-0.0073 \cdot 1 = -0.0073\) |
| \(\partial E/\partial w^{(1)}_{10} = \delta^{(1)} \cdot 1\) | \(-0.0073\) | |
| 10 | \(w \leftarrow w - \eta\,\partial E/\partial w\) | \(w^{(2)}_{11} = 0.5044\), \(w^{(2)}_{10} = 0.1066\), \(w^{(1)}_{11} = 0.40073\), \(w^{(1)}_{10} = 0.30073\) |
| 11 | новый forward pass | \(g = 0.444\), \(E = 0.0016\) |
Что дал один шаг
До: веса из условия
После: один шаг с \(\eta = 0.1\)
Конспект обрывает пример на обновлении весов и этот результат не показывает. Если повторять те же три действия — forward, backward, update, — выход подбирается к цели: 0.452 после двух шагов, 0.487 после десяти, 0.49998 после пятидесяти.
Заметь, как по-разному сдвинулись слои. Вес у выхода получил градиент \(-0.044\), вес у входа — всего \(-0.0073\), в шесть раз меньше. По дороге назад жалоба умножилась на \(w^{(2)}_{11}\,\sigma'(a^{(1)}) = 0.5 \cdot 0.222\). Производная sigmoid никогда не превышает 0.25 (урок 10), поэтому каждый слой с sigmoid ослабляет жалобу по дороге назад — если только большой вес этого не перекроет. В глубокой сети из этого вырастает отдельная проблема — о ней урок 24.
Формула профессора: \(\partial E / \partial w^{(1)}_{ji}\)
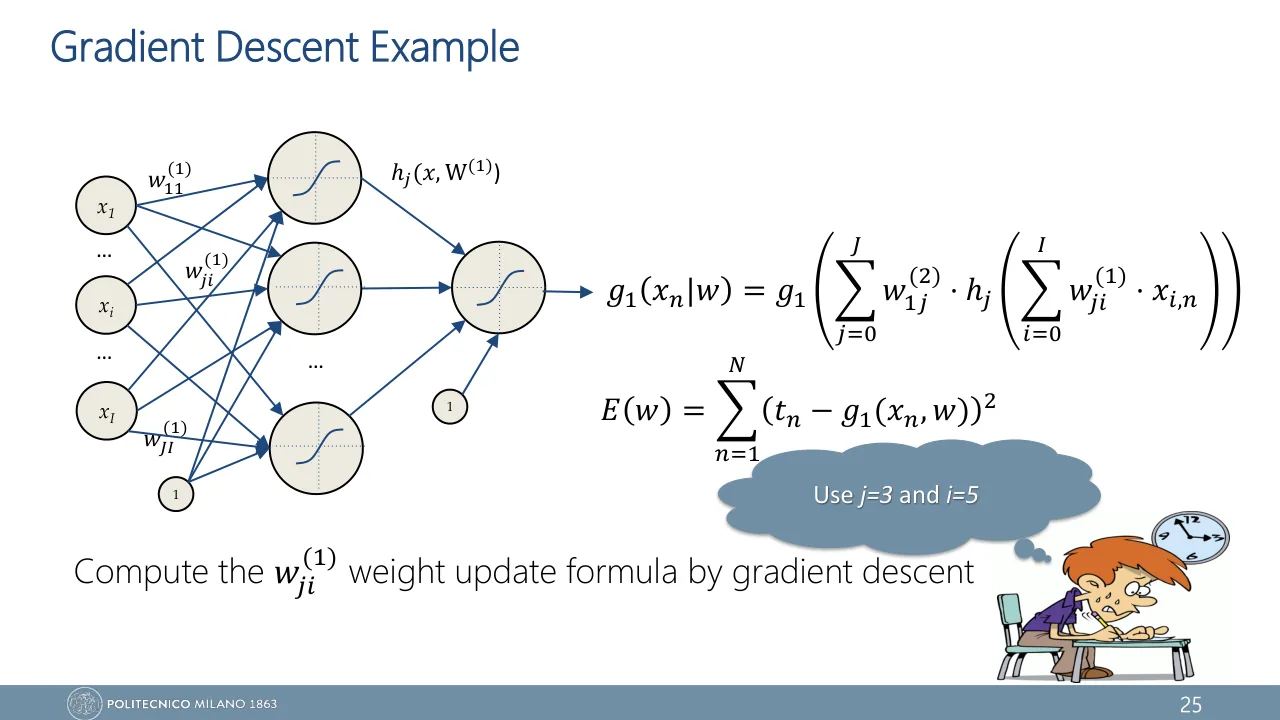
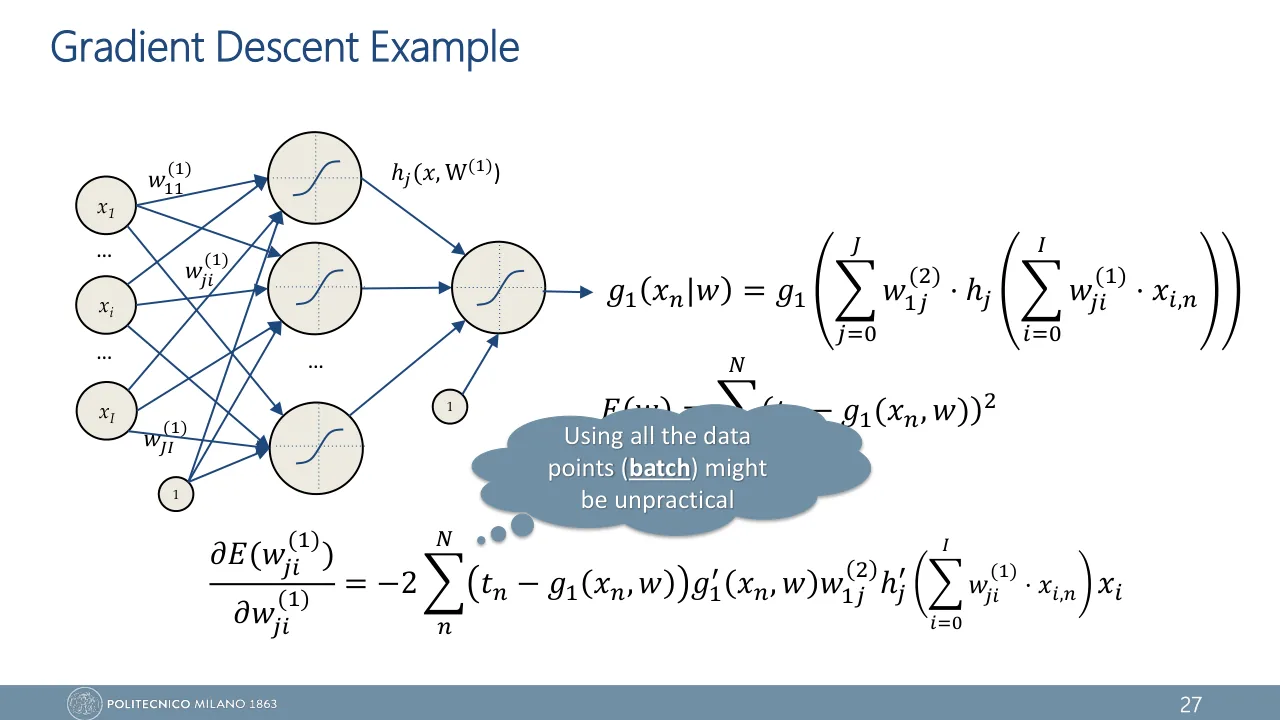
Теперь та же механика в общем виде — так, как она записана на слайдах и как её естественно спросить на экзамене. На слайде 25 лекции 2 профессор рисует сеть с \(I\) входами, одним hidden layer из \(J\) нейронов и одним выходом и даёт задание: "Compute the \(w^{(1)}_{ji}\) weight update formula by gradient descent". С подсказкой: "Use j=3 and i=5".
\[ g_1(x_n|w) = g_1\Big(\sum_{j=0}^{J} w^{(2)}_{1j}\, h_j\big(a_{j,n}\big)\Big) \]
\[ a_{j,n} = \sum_{i=0}^{I} w^{(1)}_{ji}\, x_{i,n} \]
\[ E(w) = \sum_{n=1}^{N} \big(t_n - g_1(x_n, w)\big)^2 \]
- \(x_{i,n}\)
- \(i\)-й вход sample \(n\); \(x_{0,n} = 1\) — вход для bias
- \(a_{j,n}\)
- net input hidden-нейрона \(j\). Буква введена для краткости: на слайдах эта сумма написана целиком или заменена точкой, \(h_j(.)\)
- \(h_j\)
- activation function hidden-нейрона \(j\) и его выход; \(h_0 = 1\) — вход для bias выходного нейрона
- \(g_1\)
- activation function выходного нейрона и выход сети
- \(t_n\)
- target sample \(n\)
- \(E(w)\)
- error function, здесь Sum of Squared Errors
Вес \(w^{(1)}_{35}\) — связь от пятого входа к третьему hidden-нейрону. От него до ошибки пять звеньев, и у каждого своя local derivative.
Тот же вывод на бумаге
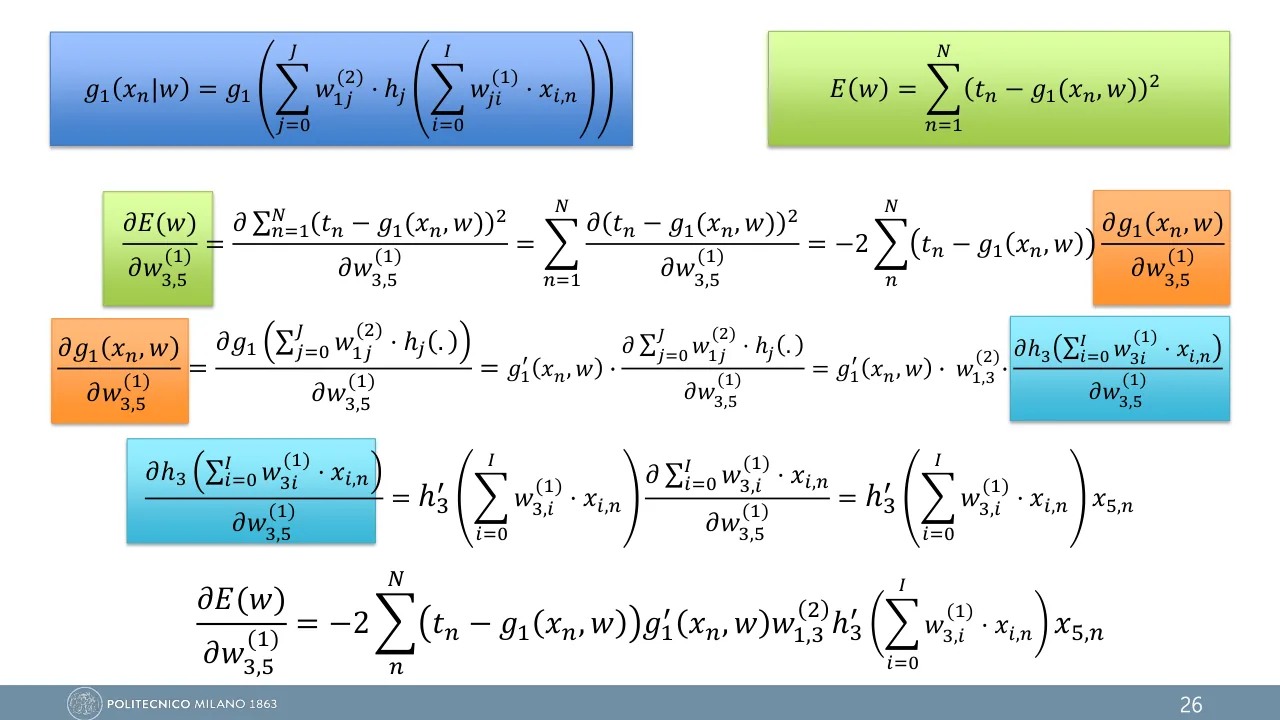
На бумаге тот же путь записывают формулами. Ниже — вывод со слайда 26 для \(j = 3\), \(i = 5\), по одному действию за шаг. Для краткости \(g_1\) означает \(g_1(x_n, w)\).
-
Ошибка — сумма по samples. Производная суммы равна сумме производных, поэтому разбираемся с одним слагаемым:
\[ \pd{E}{w^{(1)}_{35}} = \sum_{n=1}^{N} \pd{\,(t_n - g_1)^2}{w^{(1)}_{35}} \] -
Внешнее звено — квадрат. По chain rule: производная квадрата, умноженная на производную того, что внутри. Внутри стоит \(t_n - g_1\), и от веса зависит только \(g_1\), со знаком минус:
\[ \pd{\,(t_n - g_1)^2}{w^{(1)}_{35}} = -2\,(t_n - g_1)\,\pd{g_1}{w^{(1)}_{35}} \] -
Следующее звено — выходной нейрон: \(g_1\) есть activation function от суммы. Снова chain rule: производная активации на производную суммы.
\[ \pd{g_1}{w^{(1)}_{35}} = g_1'(\cdot)\,\pd{}{w^{(1)}_{35}} \sum_{j=0}^{J} w^{(2)}_{1j} h_j \]Здесь \(g_1'(\cdot)\) — производная activation function выхода, взятая в её собственном net input, то есть в сумме \(\sum_j w^{(2)}_{1j} h_j\). Профессор пишет её как \(g_1'(x_n, w)\).
-
В сумме по \(j\) от веса \(w^{(1)}_{35}\) зависит одно слагаемое: это входной вес нейрона 3, остальные нейроны его не видят. Остаётся \(w^{(2)}_{13} h_3\), а \(w^{(2)}_{13}\) — константа:
\[ \pd{}{w^{(1)}_{35}} \sum_{j=0}^{J} w^{(2)}_{1j} h_j = w^{(2)}_{13}\,\pd{h_3}{w^{(1)}_{35}} \] -
Звено hidden-нейрона: \(h_3\) — activation function от суммы \(a_{3,n}\). Chain rule в третий раз:
\[ \pd{h_3}{w^{(1)}_{35}} = h_3'(a_{3,n})\,\pd{a_{3,n}}{w^{(1)}_{35}} \] -
В сумме \(a_{3,n} = \sum_i w^{(1)}_{3i} x_{i,n}\) от \(w^{(1)}_{35}\) зависит только слагаемое с \(i = 5\). Его производная — то, что пришло по весу:
\[ \pd{a_{3,n}}{w^{(1)}_{35}} = x_{5,n} \] -
Собираем звенья обратно, от ошибки к весу:
\[ \begin{aligned} \pd{E}{w^{(1)}_{35}} = -2 \sum_{n=1}^{N} & (t_n - g_1)\, g_1'(\cdot) \\ & \cdot\, w^{(2)}_{13}\, h_3'(a_{3,n})\, x_{5,n} \end{aligned} \] -
В выводе не использовано ничего особенного про числа 3 и 5. Заменяем их на \(j\) и \(i\) и подставляем градиент в правило gradient descent:
\[ w^{(1)}_{ji} \leftarrow w^{(1)}_{ji} - \eta\,\pd{E}{w^{(1)}_{ji}} \]
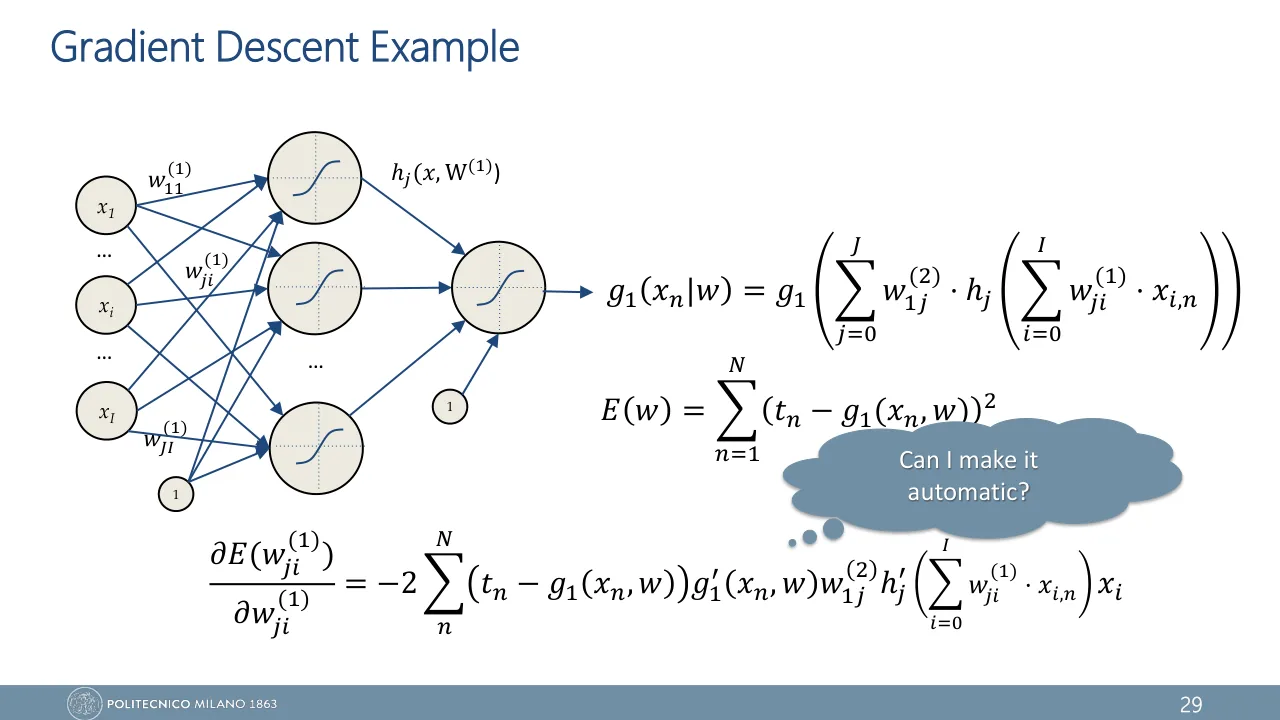
Получается формула, которую профессор повторяет на слайдах 27, 29 и 33. Её стоит уметь и вывести, и прочитать по множителям.
\[ \begin{aligned} \pd{E}{w^{(1)}_{ji}} = {} & -2 \sum_{n=1}^{N} \big(t_n - g_1(x_n, w)\big) \\ & \cdot\, g_1'(x_n, w)\; w^{(2)}_{1j} \\ & \cdot\, h_j'\Big(\sum_{i=0}^{I} w^{(1)}_{ji}\, x_{i,n}\Big)\; x_{i,n} \end{aligned} \]
| № | Множитель | Чья это local derivative | Где живёт |
|---|---|---|---|
| 1 | \(-2(t_n - g_1)\) | \(\partial E / \partial g\) | у ошибки |
| 2 | \(g_1'(x_n, w)\) | \(\partial g / \partial (w^{(2)}_{1j} h_j)\) | выходной нейрон |
| 3 | \(w^{(2)}_{1j}\) | \(\partial (w^{(2)}_{1j} h_j) / \partial h_j\) | связь hidden → выход |
| 4 | \(h_j'(a_{j,n})\) | \(\partial h_j / \partial (w^{(1)}_{ji} x_i)\) | hidden-нейрон \(j\) |
| 5 | \(x_{i,n}\) | \(\partial (w^{(1)}_{ji} x_i) / \partial w^{(1)}_{ji}\) | вход \(i\) |
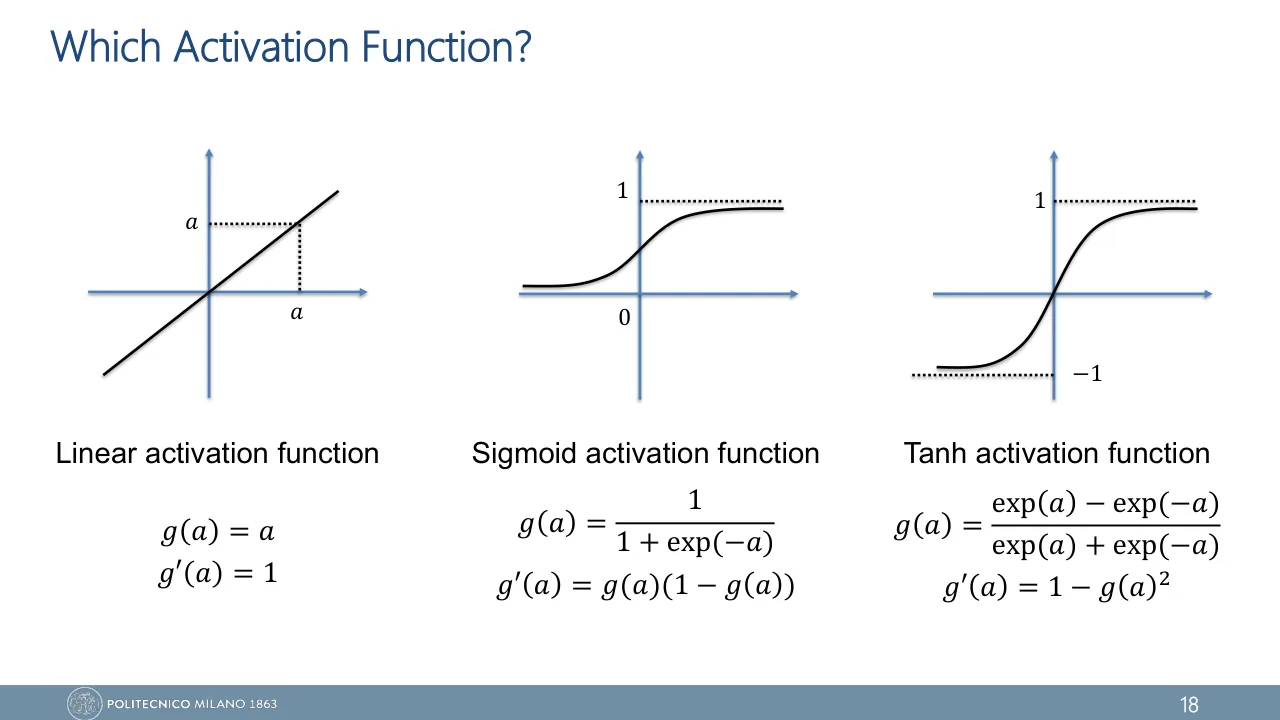
Производные трёх activation functions курса считаются из уже записанного выхода (слайд 18 лекции 2): linear — \(g' = 1\), sigmoid — \(g' = g(1 - g)\), tanh — \(g' = 1 - g^2\). На экзамене это экономит время: \(e^{-a}\) второй раз считать не нужно.
Вес выходного слоя: путь короче
У веса \(w^{(2)}_{1j}\) дорога до ошибки короче на два звена. Первые два множителя те же, а дальше сразу стоит то, что пришло по весу, — выход \(h_j\):
\[ \pd{E}{w^{(2)}_{1j}} = -2 \sum_{n=1}^{N} (t_n - g_1)\, g_1'(\cdot)\, h_j(\cdot) \]Это снова первое правило из примера 1–1–1: жалоба нейрона, в который вес входит, на вход веса. В обозначениях с \(\delta\) обе формулы урока выглядят так:
\[ \delta^{\text{out}}_n = -2\,(t_n - g_1)\; g_1'(\cdot) \]
\[ \delta_{j,n} = \delta^{\text{out}}_n\; w^{(2)}_{1j}\; h_j'(a_{j,n}) \]
\[ \pd{E}{w^{(2)}_{1j}} = \sum_{n=1}^{N} \delta^{\text{out}}_n\, h_j(a_{j,n}) \] \[ \pd{E}{w^{(1)}_{ji}} = \sum_{n=1}^{N} \delta_{j,n}\, x_{i,n} \]
- \(\delta^{\text{out}}_n\)
- error signal выходного нейрона на sample \(n\): множители 1 и 2
- \(\delta_{j,n}\)
- error signal hidden-нейрона \(j\): та же жалоба, прошедшая через вес и через активацию (множители 3 и 4)
Два прохода вместо миллиона
Вернёмся к задачке из начала. Выводить такую формулу руками для каждого веса нельзя, и на слайде 29 лекции 2 профессор спрашивает у неё: "Can I make it automatic?" Ответ — на слайде 30, одной фразой: "Weights update can be done in parallel, locally, and requires just 2 passes". Теперь каждое слово можно расшифровать.
- Locally. Градиент веса — это жалоба нейрона, в который вес входит, умноженная на то, что по весу пришло. Оба числа лежат на «станции» самого веса. Про остальную сеть ему знать не нужно.
- In parallel. Когда жалобы слоя известны, градиенты всех его весов не зависят друг от друга и считаются одновременно.
- Just 2 passes. Forward pass заполняет журнал. Backward pass идёт от ошибки ко входу и считает по одной жалобе на нейрон. После этого каждый вес стоит одного умножения.
Разгадка в том, что произведения для разных весов почти целиком совпадают. В виджете это было видно: первые два множителя общие для всей сети, следующие два — для всех весов одного нейрона. Backpropagation считает общую часть один раз и передаёт её назад готовым числом \(\delta\).
Формула для каждого веса отдельно
Backpropagation
Посчитаем на сети со слайда при \(I = 5\), \(J = 3\). Весов в ней 22: \((5 + 1) \cdot 3\) в первом слое и \(3 + 1\) во втором. Шевелением это 23 прогона. У backpropagation один прогон вперёд, четыре жалобы на обратном пути (одна у выхода и три у hidden-нейронов) и 22 умножения. Для миллиона весов счёт тот же: два прохода вместо миллиона и одного.
Шевеление при этом не бесполезно. Им проверяют готовую реализацию: если backpropagation и finite differences дают одно число, формулы верны. В обоих виджетах урока такая проверка есть: это строка «пошевелить вес на ±0.001» под ползунками.
Два следствия, которые стоит уметь объяснить
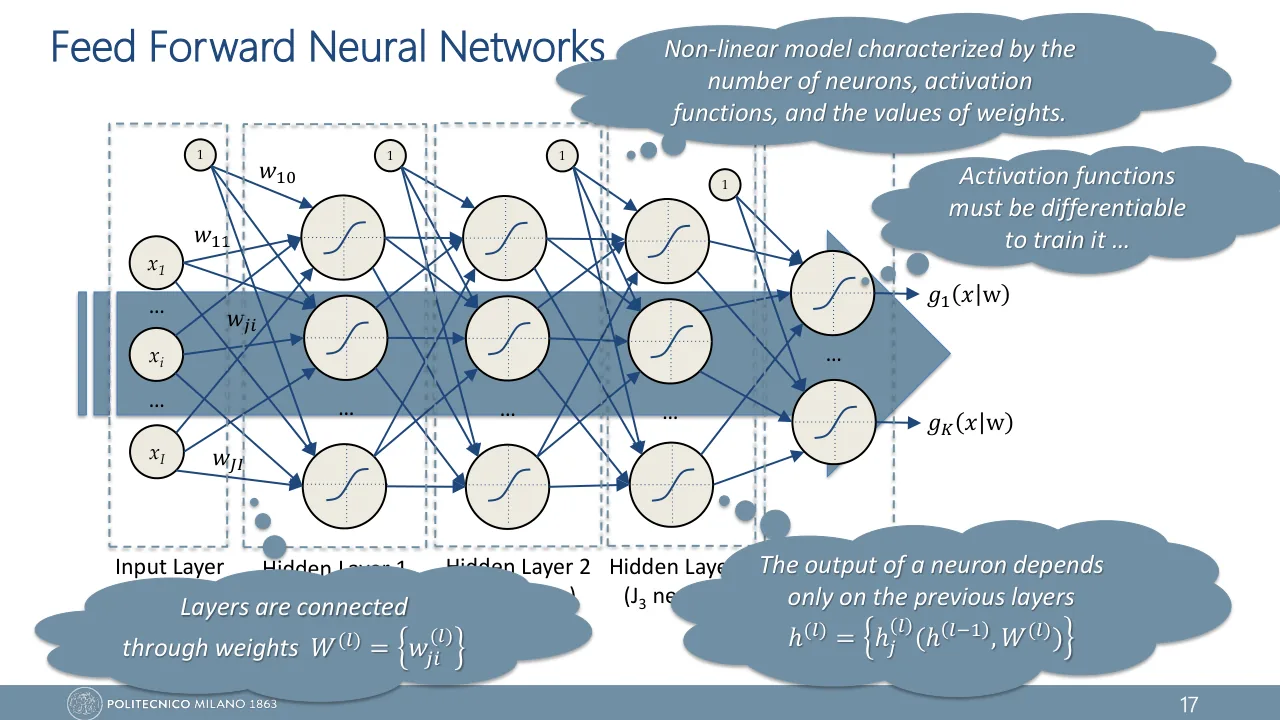
Activation function обязана быть дифференцируемой. На каждом шаге назад жалоба умножается на \(h'(a)\). У ступеньки перцептрона производная равна нулю везде, кроме точки скачка (там её нет вовсе): жалоба обнуляется и до первого слоя не доходит. Поэтому на слайде 17 лекции 2 стоит требование "Activation functions must be differentiable to train it". Правило из урока 7, Hebbian learning, тут не выручит: ему нужен target для каждого нейрона, а у hidden-нейронов своего target нет (урок 8).
Сумма по \(n\) — не часть backpropagation. Backpropagation даёт градиент для одного sample. Что делать с градиентами разных samples, решает вариант gradient descent из урока 13: batch складывает все \(N\), stochastic берёт один, mini-batch — несколько.
А если выходов несколько или слоёв больше?
Тогда от hidden-нейрона до ошибки ведёт не одна дорога, а несколько: через каждый нейрон следующего слоя. Chain rule для нескольких дорог складывает их вклады:
\[ \delta_j = h_j'(a_j) \sum_{k} w_{kj}\, \delta_k \]Сумма идёт по всем нейронам \(k\), в которые входит выход нейрона \(j\). При одном выходе в ней одно слагаемое, и получается формула этого урока. Правило для веса не меняется: жалоба × вход.
Двух проходов хватает, потому что множители у ошибки общие для всех весов: их считают один раз и передают назад.
В формате экзамена
Consider a feed-forward neural network with one hidden layer of \(J\) neurons and a single output:
\[ \begin{aligned} g_1(x_n|w) = g_1\Big( & \sum_{j=0}^{J} w^{(2)}_{1j} \\ & \cdot\, h_j\Big(\sum_{i=0}^{I} w^{(1)}_{ji}\, x_{i,n}\Big)\Big) \end{aligned} \]It is trained by minimising \(E(w) = \sum_{n=1}^{N} (t_n - g_1(x_n, w))^2\). Derive \(\partial E / \partial w^{(1)}_{ji}\) and write the gradient descent update rule for this weight.
Show model answer
Let \(a_{j,n} = \sum_i w^{(1)}_{ji} x_{i,n}\). Apply the chain rule from the error back to the weight.
\[ \pd{E}{w^{(1)}_{ji}} = -2 \sum_{n=1}^{N} (t_n - g_1)\,\pd{g_1}{w^{(1)}_{ji}} \] \[ \pd{g_1}{w^{(1)}_{ji}} = g_1'(x_n, w)\; w^{(2)}_{1j}\;\pd{h_j}{w^{(1)}_{ji}} \](only the \(j\)-th term of \(\sum_j w^{(2)}_{1j} h_j\) depends on \(w^{(1)}_{ji}\))
\[ \pd{h_j}{w^{(1)}_{ji}} = h_j'(a_{j,n})\; x_{i,n} \](only the \(i\)-th term of \(a_{j,n}\) depends on \(w^{(1)}_{ji}\)). Hence
\[ \begin{aligned} \pd{E}{w^{(1)}_{ji}} = -2 \sum_{n=1}^{N} & (t_n - g_1)\; g_1'(x_n, w) \\ & \cdot\, w^{(2)}_{1j}\; h_j'(a_{j,n})\; x_{i,n} \end{aligned} \]Update rule, with learning rate \(\eta\), starting from random initial weights:
\[ w^{(1)}_{ji} \leftarrow w^{(1)}_{ji} - \eta\,\pd{E}{w^{(1)}_{ji}} \]В полном ответе есть три вещи. Первая — множитель \(-2\) и знак. Вторая — сказано словами, что из суммы по \(j\) выживает одно слагаемое и из суммы по \(i\) тоже одно. Третья — последний множитель \(x_{i,n}\) и сумма по \(n\). Легче всего потерять \(g_1'\): он равен единице только для линейного выхода.
A network has two inputs, two hidden neurons with sigmoid activation and one output neuron with linear activation. The weights are (the bias is the weight with second index 0):
- hidden neuron 1: \(w^{(1)}_{10} = 0\), \(w^{(1)}_{11} = 1\), \(w^{(1)}_{12} = -0.5\)
- hidden neuron 2: \(w^{(1)}_{20} = -1\), \(w^{(1)}_{21} = 1\), \(w^{(1)}_{22} = 0.5\)
- output neuron: \(w^{(2)}_{10} = 0.1\), \(w^{(2)}_{11} = 0.4\), \(w^{(2)}_{12} = 0.6\)
For the single training sample \(x = (1, 2)\), \(t = 1\) and the error \(E(w) = (t - g_1(x, w))^2\), compute \(\partial E / \partial w^{(1)}_{22}\).
Show model answer
Forward pass: \(a_1 = 0 + 1 - 1 = 0\), \(h_1 = 0.5\); \(a_2 = -1 + 1 + 1 = 1\), \(h_2 = \sigma(1) = 0.7311\).
\[ \begin{aligned} g_1 &= 0.1 + 0.4 \cdot 0.5 + 0.6 \cdot 0.7311 \\ &= 0.7386 \end{aligned} \]Backward pass, factor by factor: \(-2(t - g_1) = -0.5227\); \(g_1' = 1\) (linear output); \(w^{(2)}_{12} = 0.6\); \(h_2' = h_2(1 - h_2) = 0.1966\); \(x_2 = 2\).
\[ \begin{aligned} \pd{E}{w^{(1)}_{22}} &= -0.5227 \cdot 1 \cdot 0.6 \cdot 0.1966 \cdot 2 \\ &= -0.1233 \end{aligned} \]Нейрон 1 в ответ не входит совсем: вес \(w^{(1)}_{22}\) идёт в нейрон 2, и из суммы по \(j\) остаётся только он. Считать \(h_1\) всё равно нужно — без него не получить \(g_1\). Держи четыре знака после запятой до самого конца и не перепутай \(x_2 = 2\) с \(x_1 = 1\).
A network has one input, one hidden neuron with sigmoid activation and one output neuron with linear activation: \(w^{(1)}_{11} = 0.4\), \(w^{(1)}_{10} = 0.3\), \(w^{(2)}_{11} = 0.5\), \(w^{(2)}_{10} = 0.1\). The training sample is \(x = 1\), \(t = 0.5\), the error is \(E(w) = (t - g(x|w))^2\) and the learning rate is \(\eta = 0.1\). Compute the value of \(w^{(2)}_{11}\) after one step of gradient descent.
Show model answer
Forward pass: \(a = 0.4 + 0.3 = 0.7\), \(h = \sigma(0.7) = 0.6682\), \(g = 0.5 \cdot 0.6682 + 0.1 = 0.4341\).
\[ \begin{aligned} \pd{E}{w^{(2)}_{11}} &= -2\,(t - g)\, g'\, h \\ &= -2 \cdot 0.0659 \cdot 1 \cdot 0.6682 \\ &= -0.0881 \end{aligned} \] \[ w^{(2)}_{11} \leftarrow 0.5 - 0.1 \cdot (-0.0881) = 0.5088 \]Это сеть из конспекта, но с ошибкой профессора. В конспекте получается 0.5044, потому что там \(E = \tfrac12 (t - y)^2\) и градиент вдвое меньше. Для веса выходного слоя множителей три: \(-2(t - g)\), \(g'\) и вход веса \(h\).
For a network with one hidden layer and a single output neuron with sigmoid activation, trained with \(E(w) = \sum_n (t_n - g_1(x_n, w))^2\), which expression is \(\partial E / \partial w^{(2)}_{1j}\), the derivative with respect to a weight of the output neuron?
Show model answer
The path from \(w^{(2)}_{1j}\) to the error has three links: \(\partial E / \partial g_1 = -2(t_n - g_1)\), the output activation \(g_1'(\cdot) = g_1(1 - g_1)\), and \(\partial (w^{(2)}_{1j} h_j) / \partial w^{(2)}_{1j} = h_j\).
Правило одно для всех слоёв: error signal нейрона, в который вес входит, × вход веса. Для выходного слоя вход веса — \(h_j\), для первого — \(x_{i,n}\).
Backpropagation computes the gradient of the error with one forward and one backward pass. (a) Why is this cheaper than perturbing each weight in turn? (b) Explain the statement "weights update can be done in parallel, locally, and requires just 2 passes". (c) Why must the activation functions be differentiable?
Show model answer
(a) Perturbing the weights (finite differences) needs one extra forward pass per weight, i.e. \(W + 1\) passes for \(W\) weights, and gives only an approximation. Backpropagation applies the chain rule from the output backwards and reuses the shared factors: the error signal of a neuron, \(\partial E / \partial a\), is computed once and used by all its incoming weights and by the previous layer. The cost is one forward plus one backward pass, and the gradient is exact.
(b) Local: the derivative with respect to a weight is the error signal of the neuron the weight enters times the signal that came through the weight; both are available at the weight itself. Parallel: given the error signals of a layer, the gradients of all its weights are independent and can be computed at once. Two passes: the forward pass computes and stores the outputs of all neurons; the backward pass propagates the error signals from the output to the input using the stored values.
(c) Every backward step multiplies the error signal by the derivative of an activation function, \(g'(a)\) or \(h'(a)\). A step function has zero derivative almost everywhere, so no error signal would reach the earlier weights.
Опорные слова ответа: chain rule, reuse of shared factors, stored values. Фраза "because it is faster" без объяснения, что именно переиспользуется, на вопрос не отвечает.
Select all true statements about backpropagation.
Show model answer
True: the first, the second and the fourth. Backpropagation is an exact, efficient way to compute the gradient with one forward and one backward pass; it relies on values stored during the forward pass; the derivative with respect to a first-layer weight contains the factor \(x_{i,n}\).
В вопросах «select all» разбирай каждое утверждение отдельно, как самостоятельный вопрос «верно или нет». Типичная ловушка — смешать backpropagation с gradient descent или с численной проверкой градиента.
Проверь себя
В примере 1–1–1 жалоба у выхода равна \(\delta^{(2)}\). На какое число её умножают, чтобы получить \(\partial E / \partial w^{(2)}_{11}\)?
Что именно едет назад на backward pass?
Формула профессора для \(\partial E / \partial w^{(1)}_{ji}\) состоит из пяти множителей. Какие из них одинаковы для всех весов первого слоя (при одном и том же sample)?
Первые два множителя — жалоба выходного нейрона. Её считают один раз, и поэтому хватает одного прохода назад.
У sample вход \(x_4\) равен нулю. Что этот sample добавит в градиенты весов \(w^{(1)}_{j4}\)?
Ошибку \(\tfrac12 (t - g)^2\) заменили на \((t - g)^2\), а \(\eta\) не тронули. Что произойдёт с первым шагом обучения?
В hidden layer sigmoid заменили на ступеньку перцептрона. Что даст backpropagation для весов первого слоя?
Унести с собой
- Backpropagation считает градиент ошибки по всем весам; сами веса меняет gradient descent.
- Chain rule: производная вдоль цепочки равна произведению local derivatives её звеньев. В сумме от конкретного веса зависит одно слагаемое.
- Forward pass считает выход и складывает промежуточные числа в cache. Backward pass идёт от ошибки ко входу и берёт из cache готовое.
- Градиент веса — это error signal \(\delta\) нейрона, в который вес входит, умноженный на то, что по весу пришло (для bias — на единицу).
- Для веса первого слоя множителей пять: \(-2(t_n - g_1)\), \(g_1'\), \(w^{(2)}_{1j}\), \(h_j'\), \(x_{i,n}\), и сумма по samples. У веса выходного слоя — первые два и \(h_j\).
- "In parallel, locally, just 2 passes": множители у ошибки общие для всех весов, их считают один раз и передают назад числом \(\delta\).
- Множитель \(-2\) идёт от \(E = \sum_n (t_n - g)^2\). В конспекте стоит \(\tfrac12 (t - y)^2\), и там все градиенты вдвое меньше.
Что посмотреть и почитать
-
What is backpropagation really doing?
3Blue1Brown, глава 3
Интуиция без формул: каждый sample «хочет» сдвинуть веса и активации предыдущего слоя, и эти пожелания едут назад. Хорошо ложится на метафору жалобы.
-
Backpropagation, Intuitions
CS231n, Stanford
Схемы с числом на каждом проводе: тот же forward и backward, что в виджете, включая разбор нейрона с sigmoid. Открой рядом с примером 1–1–1.
-
Calculus on Computational Graphs: Backpropagation
Christopher Olah
Точный ответ на вопрос «почему хватает одного прохода назад»: одна производная выхода по всем входам за один обратный обход графа.
-
The spelled-out intro to neural networks and backpropagation: building micrograd
Andrej Karpathy2 ч 25 мин
Backpropagation с нуля в полутора сотнях строк Python. После него числовые задачи «посчитай градиент» становятся рутиной. Смотреть частями.
-
Learning representations by back-propagating errors
Rumelhart, Hinton, Williams, Nature, 1986
Первоисточник на четыре страницы. Достаточно аннотации: главное в ней — hidden-нейроны сами выучивают полезные признаки.