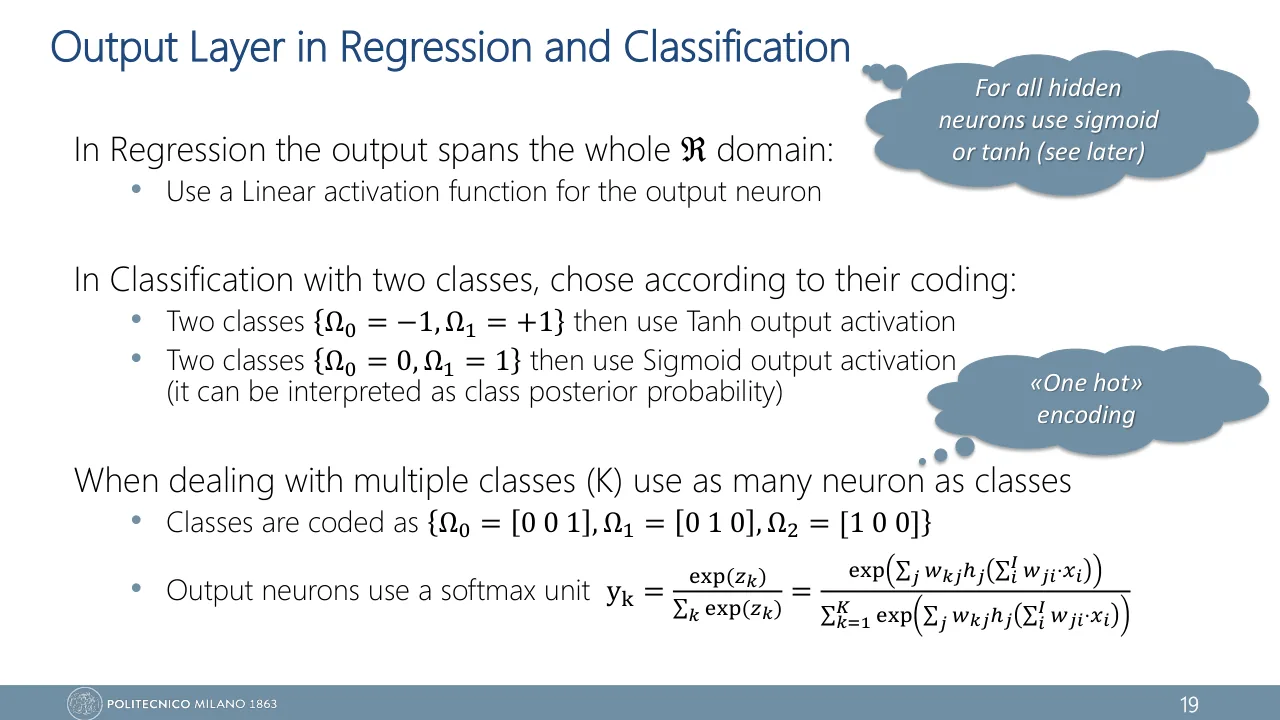
Авторы AlexNet — сети, с которой начался бум глубокого обучения (урок 4), — сравнили две одинаковые четырёхслойные свёрточные сети на наборе CIFAR-10. С ReLU сеть дошла до 25% ошибки на обучающей выборке в шесть раз быстрее, чем с tanh. Это и есть "6x" со слайда 26 лекции 3; в статье сравнение сделано с tanh, а на слайде записано шире — "sigmoid/tanh". В статье прямо сказано, что с насыщающимися нейронами эксперименты с такими большими сетями были бы невозможны.
Испорченный телефон
После этого урока ты по глубине сети, весам и функции активации оценишь, какая доля сигнала об ошибке дойдёт до первого слоя, и объяснишь, чем ReLU лечит затухание и почему сам может «умереть».
В игре «испорченный телефон» фразу шепчут по цепочке, и до последнего игрока доходит что-то невнятное. Глубокая сеть играет в эту игру на каждом шаге обучения, только задом наперёд: выход узнаёт, насколько он ошибся, и это сообщение идёт назад, слой за слоем, к самому первому.
Вот самая простая глубокая сеть: цепочка из 10 слоёв, в каждом один нейрон с sigmoid, все веса равны 1. На выходе сообщение об ошибке имеет силу 1. Какой силы оно дойдёт до первого слоя: 0.5? 0.1? 0.001? Запиши свою догадку.
Ответ: не больше четырёх миллионных. И это лучший случай, когда ни один нейрон не «заснул». Первый слой при этом не сломан: он просто почти ничего не слышит и потому не учится. В 1991 году причину формально описал студент, Sepp Hochreiter, в дипломной работе на немецком языке. А одним из главных лекарств через двадцать лет оказалась функция проще сигмоиды: \(\max(0, a)\). К концу урока у тебя будут и «четыре миллионных», и объяснение, почему с ней сообщение доходит целиком.
Градиент — это длинное произведение
В уроке 14 обратное распространение было жалобой, которая идёт назад по конвейеру. Сейчас важна одна деталь этого механизма: жалобу не просто передают дальше, её на каждой передаче умножают на число. Если число меньше единицы, жалоба становится тише.
Чтобы увидеть это число, возьмём цепочку из задачки: в каждом слое один нейрон. Нейрон слоя \(l\) берёт выход предыдущего, умножает на вес, прибавляет смещение и пропускает результат через функцию активации \(g\).
\[ a^{(l)} = w^{(l)}\, h^{(l-1)} + w_0^{(l)} \]
\[ h^{(l)} = g\big(a^{(l)}\big), \qquad h^{(0)} = x \]
- \(a^{(l)}\)
- pre-activation: число до функции активации (в уроках 10 и 14 оно называлось net input)
- \(h^{(l)}\)
- выход нейрона слоя \(l\)
- \(w^{(l)},\ w_0^{(l)}\)
- вес и смещение (bias) нейрона слоя \(l\)
- \(L\)
- число слоёв; по выходу \(h^{(L)}\) считается ошибка \(E\)
Сигнал ошибки (error signal) нейрона — число \(\delta^{(l)} = \partial E / \partial a^{(l)}\): насколько изменится ошибка \(E\), если чуть сдвинуть его pre-activation. Это и есть «сообщение», которое идёт назад. Градиент по весу получается из него одним умножением: \(\partial E / \partial w^{(l)} = \delta^{(l)}\, h^{(l-1)}\).
Значит, вопрос «как быстро учится слой» сводится к вопросу «какой силы \(\delta\) до него дошла». Посмотрим на цепочку из четырёх нейронов с настоящими числами (откуда они, посчитаем в следующем разделе).
Откуда берутся множители «×0.2»? Это выводится за пять шагов из цепного правила.
-
Чего хотим: выразить сообщение слоя \(l-1\) через сообщение слоя \(l\). Ошибка зависит от \(a^{(l-1)}\) только через \(a^{(l)}\), поэтому по цепному правилу (chain rule):
\[ \delta^{(l-1)} = \pd{E}{a^{(l)}} \cdot \pd{a^{(l)}}{a^{(l-1)}} \]Первый множитель — это уже известная \(\delta^{(l)}\).
-
Второй множитель считаем по определению слоя. \(a^{(l)}\) зависит от \(a^{(l-1)}\) через \(h^{(l-1)} = g(a^{(l-1)})\), и на пути стоит вес:
\[ \pd{a^{(l)}}{a^{(l-1)}} = w^{(l)} \cdot g'\big(a^{(l-1)}\big) \] -
Подставляем. Одна передача назад — одно умножение:
\[ \delta^{(l-1)} = \delta^{(l)} \cdot w^{(l)}\, g'\big(a^{(l-1)}\big) \]Множитель состоит из двух частей: веса связи и наклона функции активации в той точке, где сейчас сидит нейрон.
-
Повторяем от выхода до первого слоя — всего \(L - 1\) раз:
\[ \delta^{(1)} = \delta^{(L)} \prod_{l=2}^{L} w^{(l)}\, g'\big(a^{(l-1)}\big) \] -
Оценка для sigmoid: её наклон нигде не больше \(\tfrac14\). Если ещё и \(\abs{w} \le 1\), каждая передача ослабляет сообщение минимум вчетверо:
\[ \abs{\delta^{(1)}} \le \abs{\delta^{(L)}} \cdot \left(\tfrac14\right)^{L-1} \]При \(L = 10\) это \(0.25^{9} \approx 3.8 \cdot 10^{-6}\) — те самые четыре миллионных из задачки.
До первого слоя доходит \(\delta\) выхода, умноженная на \(L - 1\) множителей вида \(w \cdot g'(a)\). Произведение не затухает и не взрывается, только пока множители держатся около 1.
Затухающий градиент (vanishing gradient problem; в конспекте ещё и zero-gradient problem) — ситуация, когда сигнал ошибки по дороге от выхода ко входу становится почти нулевым. Градиенты весов первых слоёв тогда около нуля, правило обновления \(w \leftarrow w - \eta \cdot 0 = w\) оставляет веса на месте, и эти слои перестают учиться, хотя ошибка ещё велика.
То же самое для настоящих слоёв
Когда в слое много нейронов, сообщение приходит к нейрону от всех, кому он передаёт свой выход, и складывается с весами. Структура та же: местный наклон, умноженный на то, что пришло сзади.
\[ \delta_i^{(l-1)} = g'\big(a_i^{(l-1)}\big) \sum_j w_{ji}^{(l)}\, \delta_j^{(l)} \]
- \(w_{ji}^{(l)}\)
- вес в нейрон \(j\) слоя \(l\) из нейрона \(i\) слоя \(l-1\) (индекс получателя первый, как на слайдах)
- \(g'(a_i^{(l-1)})\)
- местный наклон: производная активации самого нейрона \(i\)
- \(\sum_j \dots\)
- унаследованная часть: сообщения следующего слоя, взвешенные связями
| В конспекте | В уроке и на слайдах | Что это |
|---|---|---|
| \(z_i^{(l)}\) | \(a_j^{(l)}\) | pre-activation, аргумент \(g(\cdot)\) |
| \(a_i^{(l)} = g(z_i^{(l)})\) | \(h_j^{(l)} = g(a_j^{(l)})\) | выход скрытого нейрона |
| \(w_{ij}^{(l)}\): в \(i\) из \(j\) | \(w_{ji}^{(l)}\): в \(j\) из \(i\) | вес; получатель всегда первый |
| \(b_i^{(l)}\) | \(w_{j0}^{(l)}\), коротко \(w_0\) | смещение (bias) |
| \(y\) | \(g(x_n \vert w)\) | выход сети; цель — \(t_n\) |
| \(\delta_i^{(l)}\) | \(\delta_j^{(l)}\); на слайдах этой буквы нет | сигнал ошибки; слайды выписывают всё произведение по множителям |
Насыщение: посредник, который заснул
Какого размера бывает множитель \(g'(a)\)? В уроке 10 sigmoid и tanh были диммерами: в середине хода ручка чувствительна, у упоров свет почти не меняется, сколько ни крути. Положение «у упора» называется насыщением.
Насыщение (saturation) — режим, в котором функция активации почти плоская: \(\abs{a}\) велико, выход прижат к краю диапазона, а производная \(g'(a) \approx 0\).
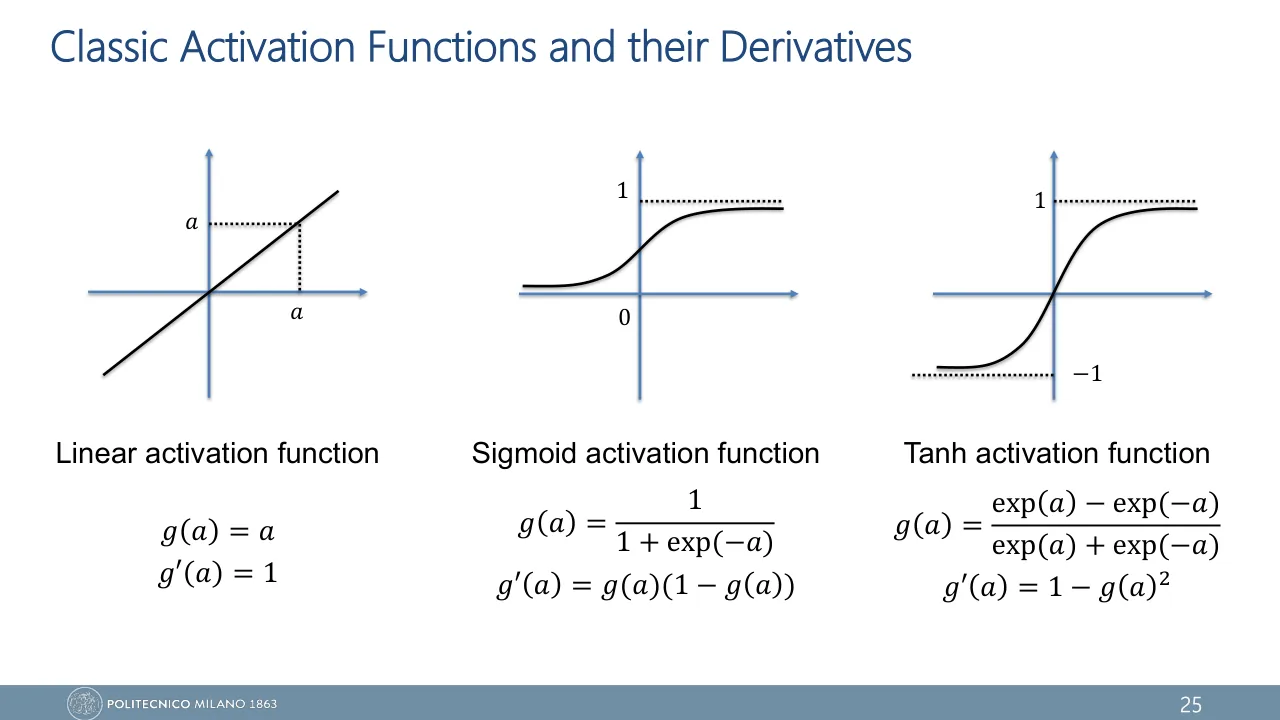
\[ g(a) = \frac{1}{1 + e^{-a}} \]
\[ g'(a) = g(a)\,\big(1 - g(a)\big) \le \tfrac14 \]
\[ g(a) = \tanh(a) = \frac{e^{a} - e^{-a}}{e^{a} + e^{-a}} \]
\[ g'(a) = 1 - g(a)^2 \le 1 \]
Обе функции вместе с производными стоят на слайде "Classic Activation Functions and their Derivatives" (лекция 3, слайд 25); это повтор слайда из урока 10 (лекция 2, слайд 18). Экспонента там записана как \(\exp(-a)\). Границ \(\le \tfrac14\) и \(\le 1\) на слайде нет: они дописаны здесь, потому что на них держится весь урок. Третья функция того же слайда — линейная: \(g(a) = a\), \(g'(a) = 1\). Её наклон равен 1 при любом \(a\), так что сообщение она не глушит совсем; зато сеть из одних линейных нейронов сама линейна. Запомни эту пару свойств до раздела про ReLU.
У sigmoid и tanh максимум производной достигается в одной и той же точке, \(a = 0\). Конспект на стр. 177 даёт таблицу со значками «≈»; вот она же с настоящими числами.
| \(a\) | sigmoid \(g\) | sigmoid \(g'\) | tanh \(g\) | tanh \(g'\) |
|---|---|---|---|---|
| −5 | 0.0067 | 0.0066 | −0.9999 | 0.00018 |
| −2 | 0.119 | 0.105 | −0.964 | 0.071 |
| 0 | 0.5 | 0.25 | 0 | 1 |
| 2 | 0.881 | 0.105 | 0.964 | 0.071 |
| 5 | 0.9933 | 0.0066 | 0.9999 | 0.00018 |
sigmoid: \(g' \le 0.25\)
tanh: \(g' \le 1\)
На языке испорченного телефона насыщенный нейрон — посредник, который заснул. Сообщение через него почти не проходит: при \(a = 5\) от него остаётся меньше процента. Но посмотри ещё раз на подсвеченную строку таблицы. У sigmoid даже самый бодрый посредник передаёт только четверть.
«Градиент затухает, потому что функция активации насыщается». Так объясняет и конспект (стр. 177): "it happens when the activation function saturates". Это только половина причины. У sigmoid градиент затухает и без насыщения: множитель на слой равен \(w \cdot g'(a)\), а \(g' \le 0.25\) всегда. Насыщение делает то же самое быстрее: один заснувший нейрон гасит сообщение почти целиком.
Проверка — пример ниже: четыре нейрона, все сидят в чувствительной зоне (\(a\) от 0.66 до 1), а первый вес учится в 69 раз медленнее последнего. На экзамене ответ «потому что функция насыщается» неполон: нужно сказать про произведение множителей, каждый из которых меньше 1.
Тот же сюжет на слайде профессора
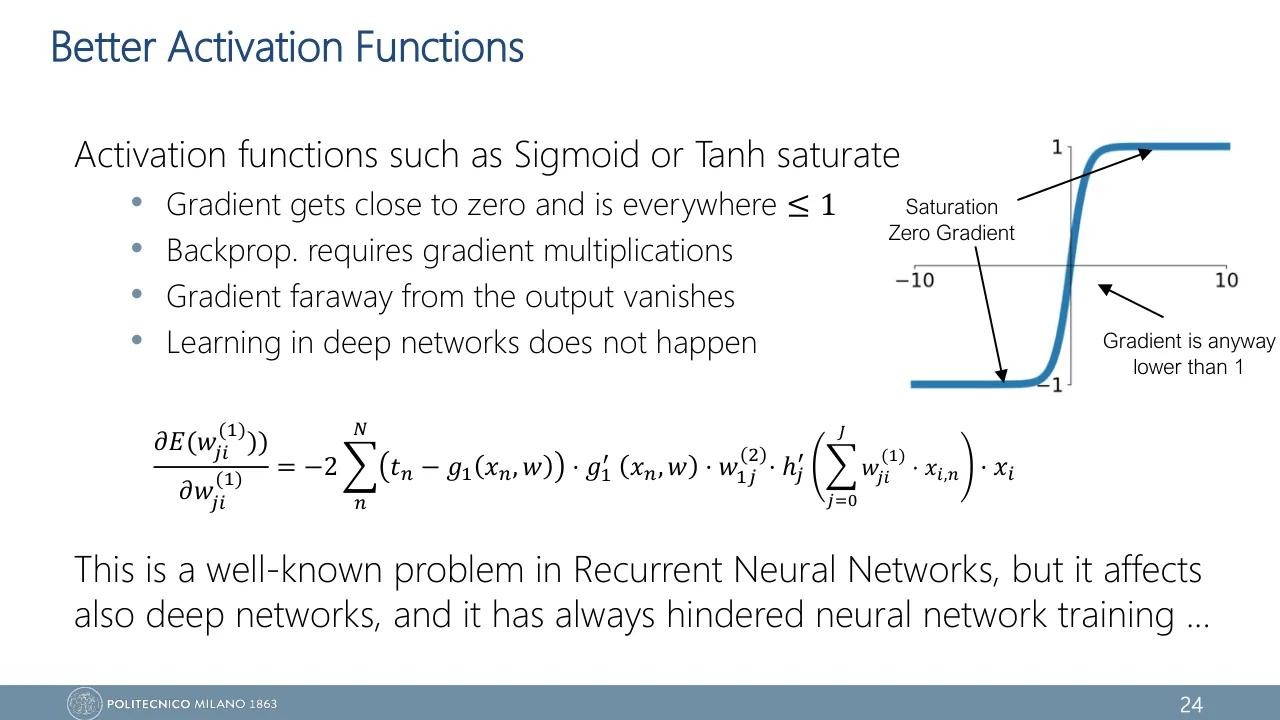
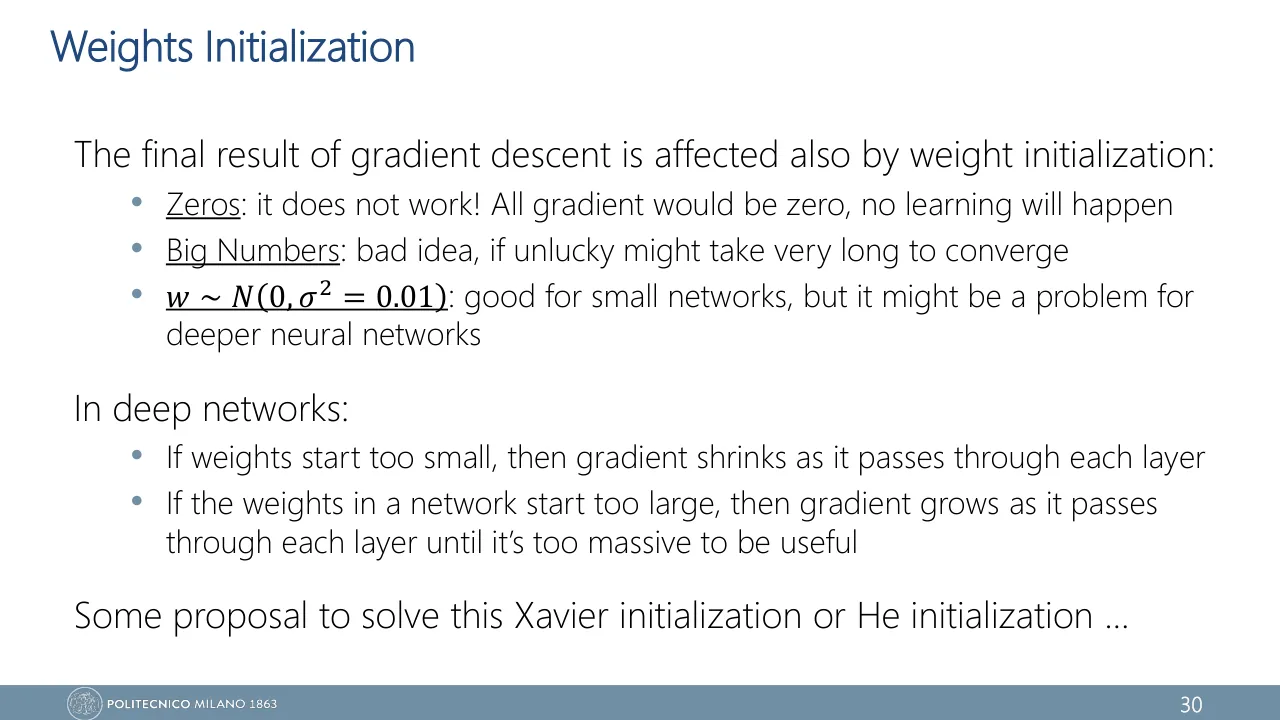
Теперь слайд "Better Activation Functions" (лекция 3, слайд 24) читается целиком. Под заголовком "Activation functions such as Sigmoid or Tanh saturate" на нём четыре пункта. Это готовый скелет экзаменационного ответа, запомни их по-английски:
- "Gradient gets close to zero and is everywhere \(\le 1\)" — производная активации в насыщении почти нулевая и нигде не больше единицы;
- "Backprop. requires gradient multiplications" — градиент веса есть произведение таких производных, по одной на слой;
- "Gradient faraway from the output vanishes" — до слоёв, далёких от выхода, доходит почти ноль;
- "Learning in deep networks does not happen" — эти слои не учатся.
Рядом на слайде нарисована S-образная кривая от −1 до 1 (то есть tanh) с двумя подписями. У плоских краёв: "Saturation" и "Zero Gradient". У крутой середины: "Gradient is anyway lower than 1". Вторая подпись — та самая половина причины из ловушки выше: даже там, где насыщения нет, множитель \(g'\) не дотягивает до единицы.
Под пунктами стоит формула из урока 14: градиент веса первого слоя в сети с одним hidden layer. Буквы \(\delta\) на слайдах нет, произведение выписано множитель за множителем.
\[ \begin{aligned} \pd{E}{w^{(1)}_{ji}} = {} & -2 \sum_{n=1}^{N} \big(t_n - g_1(x_n, w)\big) \\ & \cdot\, g_1'(x_n, w)\; w^{(2)}_{1j} \\ & \cdot\, h_j'\Big(\sum_{i=0}^{I} w^{(1)}_{ji}\, x_{i,n}\Big)\; x_{i,n} \end{aligned} \]
- \(g_1'(x_n, w)\)
- производная активации выходного нейрона: один множитель вида \(g'(a)\)
- \(h_j'(\cdot)\)
- производная активации скрытого нейрона \(j\), взятая в его pre-activation: второй такой множитель
- \(w^{(2)}_{1j}\)
- вес между ними: часть \(w\) множителя \(w \cdot g'(a)\)
На самом слайде внутренняя сумма напечатана с индексом \(j\) от 0 до \(J\), а последний множитель — как \(x_i\), без номера примера \(n\). Это опечатки; верная запись — здесь и в уроке 14. Производных активации в формуле две, потому что слоёв с активацией два. В сети из \(L\) слоёв у веса первого слоя их \(L\), и между ними стоят \(L - 1\) весов: это и есть "gradient multiplications".
Слово gradient в первом пункте слайда 24 лекции 3 означает производную активации \(g'(a)\). Граница "everywhere \(\le 1\)" верна для обеих функций, но для sigmoid она грубая: точная граница вчетверо ниже, \(g' \le 0.25\). У tanh единица достигается в одной-единственной точке \(a = 0\). На экзамене приводи формулировку слайда и рядом оба точных числа: с ними ответ сильнее.
Последняя строка слайда называет затухание "a well-known problem in Recurrent Neural Networks" и добавляет: "it affects also deep networks", а обучению нейронных сетей оно мешало всегда. Рекуррентная сеть применяет один и тот же слой на каждом шаге по времени, поэтому длинная последовательность для градиента — та же глубокая цепочка, только с одним и тем же весом на каждой передаче. Там затухание заметили раньше всего; сами рекуррентные сети появятся в курсе позже.
Пример на калькуляторе: четыре нейрона, ни одного спящего
Цепочка с рис. 1: четыре sigmoid-нейрона, все веса \(w = 1\), смещения нулевые, вход \(x = 1\). Прямой проход даёт такую таблицу.
| слой \(l\) | \(a^{(l)}\) | \(h^{(l)}\) | \(g'(a^{(l)})\) |
|---|---|---|---|
| 1 | 1.000 | 0.731 | 0.197 |
| 2 | 0.731 | 0.675 | 0.219 |
| 3 | 0.675 | 0.663 | 0.224 |
| 4 | 0.663 | 0.660 | 0.224 |
Сравним, насколько выход чувствителен к последнему весу и к первому. До последнего веса одна передача, до первого — четыре (и в конце умножение на вход \(x = 1\), которое ничего не меняет).
\[ \begin{aligned} \pd{h^{(4)}}{w^{(4)}} &= g'\big(a^{(4)}\big)\, h^{(3)} \\ &= 0.224 \cdot 0.663 = 0.149 \end{aligned} \] \[ \begin{aligned} \pd{h^{(4)}}{w^{(1)}} &= 0.224 \cdot 0.224 \cdot 0.219 \cdot 0.197 \\ &= 0.00216 \end{aligned} \]Отношение \(0.149 / 0.00216 \approx 69\). Ни один нейрон не насыщен, а первый вес получает сигнал в 69 раз слабее последнего. Всего четыре слоя.
«Веса первых слоёв перестали меняться — значит, сеть сошлась». Нет. При сходимости мала ошибка. При затухании ошибка остаётся большой, просто до первых слоёв не доходит сообщение о ней. Последние слои при этом продолжают учиться — поверх случайных признаков, которые им выдают необученные первые.
Затухание и взрыв — одна и та же арифметика
В примере множители были разными, но все около 0.2. Упростим картинку до предела: пусть все \(L\) нейронов цепочки одинаковы — один и тот же вес \(w\) и одно и то же значение \(a\). Тогда каждая передача умножает сообщение на одно число \(w \cdot g'(a)\), и видно, что с ним делает глубина.
Зеркальная болезнь: exploding gradient
Взрывающийся градиент (exploding gradient) — обратная ситуация: множитель на слой больше 1, градиент растёт экспоненциально с глубиной, шаги по весам становятся огромными и обучение расходится.
У профессора отдельного слайда про взрыв нет. Он упомянут в скобках среди плюсов ReLU (лекция 3, слайд 26) и описан одной фразой там, где речь идёт о слишком больших начальных весах (лекция 3, слайд 30; это уже урок 25). Пример, симптомы и лекарства ниже — из конспекта.
Пример из конспекта (стр. 179): каждый слой удваивает градиент. Через 50 слоёв множитель равен \(2^{50} \approx 1.13 \cdot 10^{15}\), и крошечный градиент \(10^{-10}\) превращается в \(10^{5}\). Чаще всего так бывает в глубоких полносвязных сетях с неудачными начальными весами и в рекуррентных сетях, где один и тот же вес перемножается на каждом шаге по времени.
Что видно: веса первых слоёв почти не двигаются, норма градиента убывает от выхода ко входу, ошибка рано застывает на высоком уровне.
Что помогает: ReLU вместо sigmoid, правильная инициализация, batch normalization, residual connections.
Что видно: ошибка внезапно становится NaN или Inf, веса огромные, норма градиента исчисляется сотнями и тысячами, обучение скачет или расходится.
Что помогает: gradient clipping, правильная инициализация, слои нормализации, LSTM и GRU в рекуррентных сетях.
Что такое gradient clipping и residual connection — в одну строку каждое
Gradient clipping ограничивает длину градиента, не меняя его направления: если норма больше порога \(c\), градиент укорачивают до длины \(c\).
\[ \nabla E \leftarrow \nabla E \cdot \min\Big(1,\ \frac{c}{\norm{\nabla E}}\Big) \]Residual connection добавляет к выходу блока его вход: \(h^{(l+1)} = h^{(l)} + F(h^{(l)})\). Производная такого блока равна \(1 + F'\): у сообщения всегда есть обходная дорога с множителем ровно 1. Конспект оба приёма только называет, без формул; для этого урока достаточно идеи.
Почему нельзя просто увеличить learning rate?
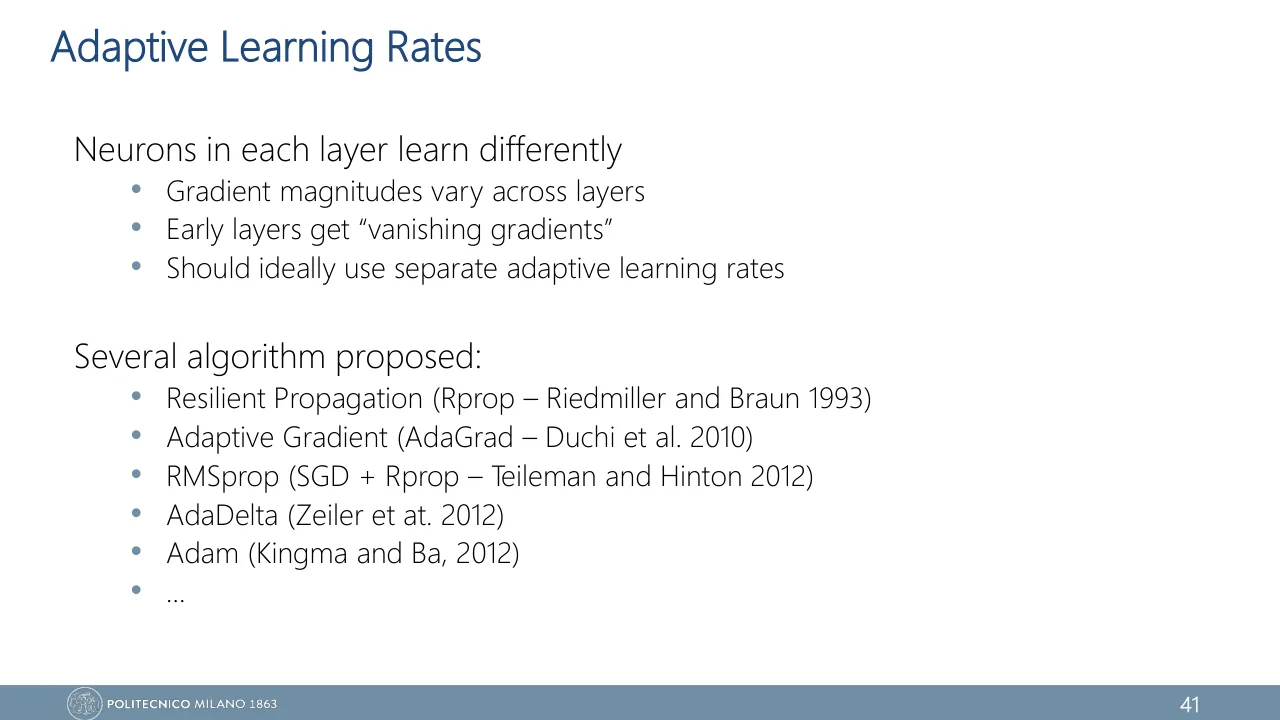
Потому что \(\eta\) один на все слои. Если градиент первого слоя в миллион раз меньше, чем последнего, то шаг, подходящий первому слою, в миллион раз велик для последнего, и тот разойдётся. Отсюда растут методы с отдельным шагом для каждого параметра — о них урок 27. Профессор приходит к ним тем же путём (лекция 3, слайд 40; в углу напечатано 41): раз ранним слоям достаётся затухающий градиент, шаг в идеале должен быть у каждого параметра свой — "separate adaptive learning rates".
ReLU: посредник, который повторяет слово в слово
Итак, беда в множителе \(g'(a)\): у sigmoid он не больше четверти, у tanh равен единице только в одной точке. Нужна функция, у которой наклон равен 1 не в точке, а на целой полуоси. Самая простая такая функция — та самая линейная \(g(a) = a\) со слайда 25 лекции 3, обрезанная нулём слева, чтобы сохранить нелинейность.
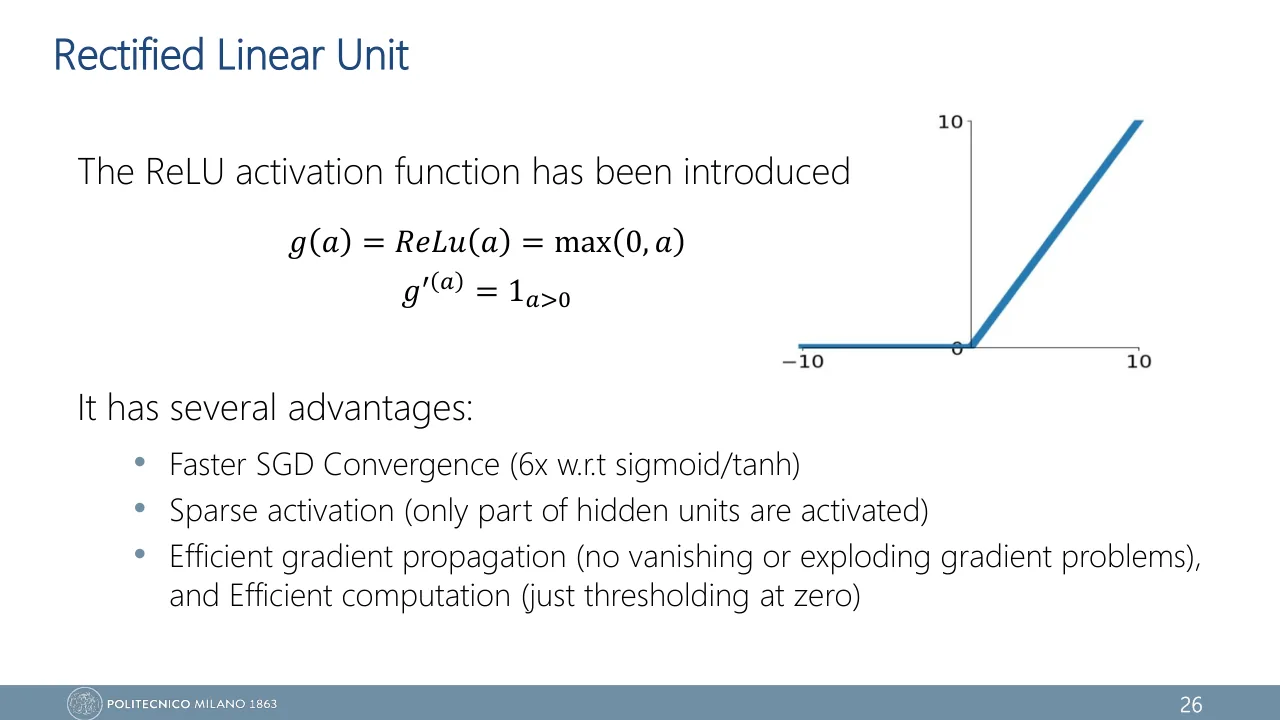
ReLU (Rectified Linear Unit) — функция активации \(g(a) = \max(0, a)\): положительный вход проходит без изменений, отрицательный заменяется нулём.
\[ g(a) = \max(0, a) \]
\[ g'(a) = \begin{cases} 1, & a \gt 0 \\ 0, & a \le 0 \end{cases} \]
На слайде "Rectified Linear Unit" (лекция 3, слайд 26) функция записана как \(\mathrm{ReLu}(a) = \max(0, a)\), а производная — одним символом: \(g'(a) = 1_{a \gt 0}\). Это индикатор: он равен 1, когда условие в индексе выполнено, и 0, когда нет. При \(a = 0\) условие не выполнено, поэтому и на слайде \(g'(0) = 0\), как в формуле (64) конспекта.
В игре это посредник двух состояний. Если он активен (\(a \gt 0\)), он повторяет сообщение слово в слово: множитель на передачу равен просто \(w\). Если нет — молчит совсем. Вот та же цепочка из задачки до и после замены активации.
До: sigmoid, \(w = 1\), \(a = 0\)
После: ReLU, \(w = 1\), \(a \gt 0\)
Почему ReLU стал выбором по умолчанию для скрытых слоёв? У профессора на это четыре плюса под строкой "It has several advantages" (лекция 3, слайд 26). На экзамене перечисляй их теми же английскими словами.
- Faster SGD convergence. Обучение сходится быстрее; на слайде в скобках стоит "6x w.r.t sigmoid/tanh". Откуда шестёрка — в истории ниже.
- Sparse activation. На слайде: "only part of hidden units are activated". На каждом входе часть нейронов выдаёт ровно 0, так что представление получается разреженным. При симметричных начальных весах и нулевом смещении нейрон активен примерно на половине входов.
- Efficient gradient propagation. Справа ReLU не насыщается: при \(a \gt 0\) производная равна 1 при любом, сколь угодно большом \(a\). В скобках слайд обещает больше — "no vanishing or exploding gradient problems"; что из этого правда, разобрано в ловушке ниже.
- Efficient computation. На слайде: "just thresholding at zero". Сравнение с нулём вместо экспоненты.
- Scale invariance — этого пункта на слайдах нет, он из учебников. \(\max(0, c \cdot a) = c \cdot \max(0, a)\) при \(c \ge 0\): масштаб входа просто переходит на выход.
«С ReLU нет ни затухания, ни взрыва градиента». Так легко прочитать скобку на слайде 26 лекции 3: "no vanishing or exploding gradient problems". Точное утверждение скромнее. В множителе \(w \cdot g'(a)\) ReLU чинит только часть \(g'\): у активного нейрона она равна ровно 1, то есть сама активация сообщение не сжимает и не усиливает. Вес \(w\) остаётся в произведении: при \(\abs{w} \lt 1\) сообщение по-прежнему затухает, при \(\abs{w} \gt 1\) взрывается (третье задание виджета «Эстафета градиента»). А выключенный нейрон передаёт ровно 0.
Сама лекция с этим согласна: на слайде про инициализацию (лекция 3, слайд 30) сказано, что при слишком маленьких весах "gradient shrinks as it passes through each layer", а при слишком больших растёт. На экзамене называй плюс словами слайда, efficient gradient propagation, и добавляй оговорку: для активных нейронов и при разумных весах.
«ReLU не насыщается». Наполовину. Слева от нуля он насыщен сильнее любой сигмоиды: производная там не «почти ноль», а ровно ноль. Его преимущество в том, что активная половина пропускает сообщение с множителем ровно 1.
У лекарства есть побочные эффекты, и их четыре. У профессора (лекция 3, слайд 27) они названы "potential disadvantages" и уложены в три пункта: второй и третий минус стоят там в одной строке. Конспект называет только последний; в экзаменационном ответе приведи все четыре.
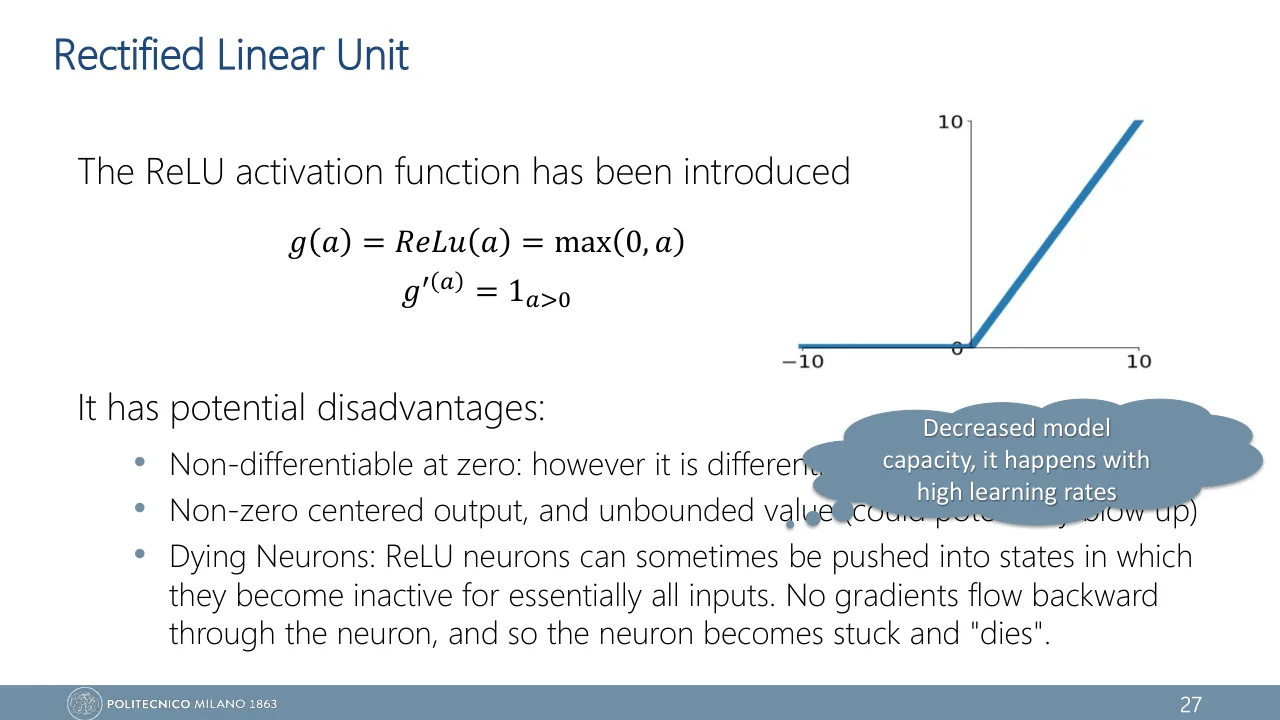
- Не дифференцируем в нуле. В точке \(a = 0\) у графика излом. На слайде: "Non-differentiable at zero", и тут же оговорка — "however it is differentiable anywhere else".
- Выход не центрирован вокруг нуля: он всегда \(\ge 0\). На слайде: "Non-zero centered output".
- Не ограничен сверху: большая активация ничем не срезается и может расти от слоя к слою. На слайде: "unbounded value (could potentially blow up)".
- Dying neurons: нейрон может замолчать навсегда. Формулировка слайда и разбор — в следующем разделе.
«ReLU состоит из двух прямых, значит и сеть из ReLU линейна». Нет: функция кусочно-линейная, и нелинейность сидит в изломе. Сумма многих ReLU с изломами в разных местах даёт ломаную с любым числом звеньев — так в уроке 12 из простых деталей собирались сложные функции.
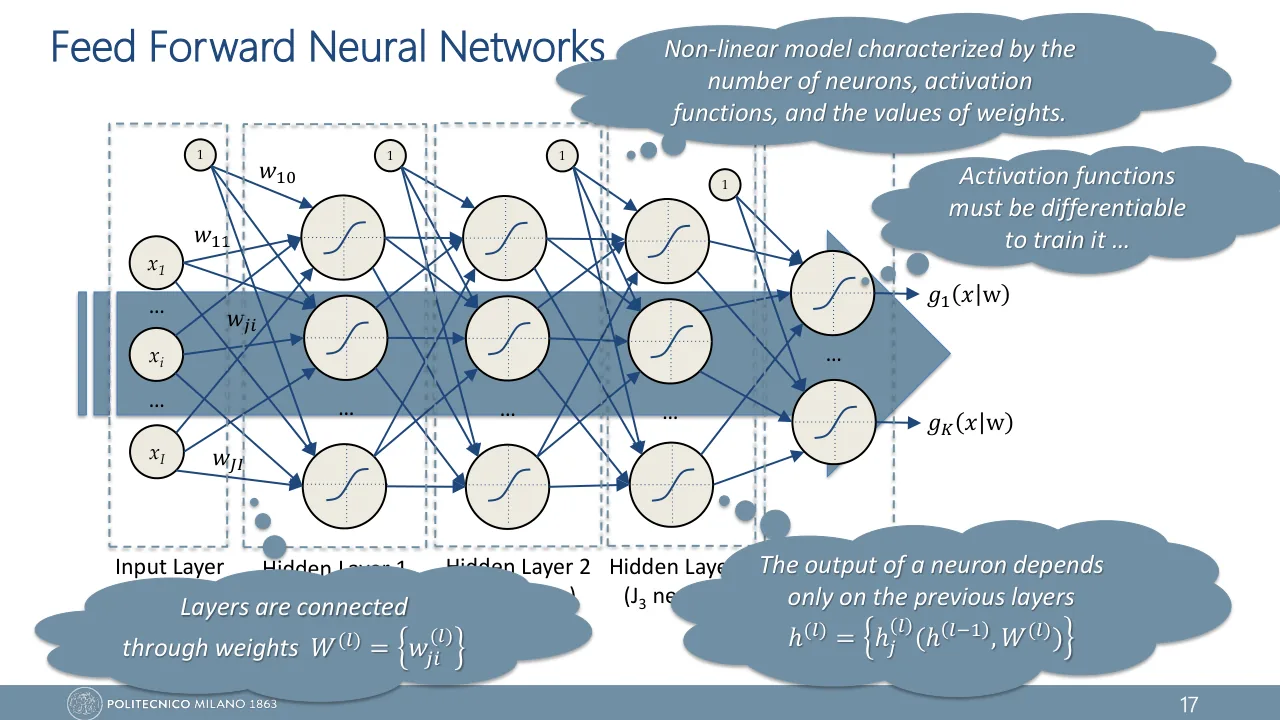
На слайдах сказано, что активация должна быть дифференцируемой. А как же излом в нуле?
В начале курса (лекция 2, слайд 17) написано: "Activation functions must be differentiable to train it …". Ответ профессора стоит прямо в списке минусов (лекция 3, слайд 27): "however it is differentiable anywhere else". ReLU не дифференцируем ровно в одной точке, и попасть в неё точно почти невозможно. На этот случай договариваются о значении: и в определении конспекта, и в записи слайда \(1_{a \gt 0}\) это \(g'(0) = 0\), так же поступают библиотеки. Подойдёт любое число от 0 до 1 — это наклоны прямых, которые касаются графика в изломе снизу.
Чем мешает выход, не центрированный вокруг нуля?
Градиент по весу равен \(\delta_j \cdot h_i\). Если все входы нейрона \(h_i \ge 0\), то градиенты всех его весов имеют один знак — знак \(\delta_j\). За один шаг нейрон может либо увеличить все свои веса, либо уменьшить все; чтобы одни росли, а другие убывали, приходится идти зигзагом. Это та же причина, по которой в уроке 10 tanh был лучше sigmoid.
В уроке 10 на слайде про выходной слой (лекция 2, слайд 19) стояла пометка: "For all hidden neurons use sigmoid or tanh (see later)". Это "later" наступило сейчас, со слов "The ReLU activation function has been introduced" (лекция 3, слайд 26): теперь для скрытых слоёв по умолчанию берут ReLU, а sigmoid и tanh остаются там, где нужен ограниченный выход, прежде всего в выходном слое.
Умирающий ReLU и нейроны с запасным выходом
Молчащий посредник не передаёт сообщение дальше. Хуже того: он и сам его не слышит. А в сообщении как раз и была просьба проснуться.
Мёртвый нейрон (dead ReLU; сам процесс — dying ReLU) — нейрон с ReLU, у которого \(a \le 0\) на всех обучающих примерах. Его выход всегда 0, градиент всегда 0, и обновиться он больше не может.
У профессора это последний минус ReLU, "Dying Neurons" (лекция 3, слайд 27), и описан он так. Нейрон попадает в состояние, где он "inactive for essentially all inputs". Тогда "no gradients flow backward through the neuron", и он застревает: "becomes stuck and 'dies'". Наше «на всех обучающих примерах» — точная версия слов essentially all inputs: градиент считается только по обучающим примерам, значит важны именно они.
До: часть примеров справа от нуля
После слишком большого шага: все слева
Почему нейрон не может выбраться сам — четыре шага.
-
Пусть у нейрона \(j\) на каждом обучающем примере \(a_j \le 0\). Тогда на каждом примере:
\[ h_j = \max(0, a_j) = 0 \] \[ g'(a_j) = 0 \] -
В сообщение, которое получает сам нейрон, входит его местный наклон. Что бы ни пришло от следующего слоя, оно умножается на ноль:
\[ \delta_j = g'(a_j) \sum_k w_{kj}\, \delta_k = 0 \] -
Градиенты входящих весов и смещения — это \(\delta_j\), умноженная на вход:
\[ \pd{E}{w_{ji}} = \delta_j\, h_i = 0 \] \[ \pd{E}{w_{j0}} = \delta_j = 0 \] -
Правило обновления ничего не меняет:
\[ w_{ji} \leftarrow w_{ji} - \eta \cdot 0 = w_{ji} \]На следующей эпохе веса те же, значит снова \(a_j \le 0\). Круг замкнулся: нейрон не учится, потому что молчит, и молчит, потому что не учится.
В первом скрытом слое это навсегда: его входы — сами данные, они не меняются. В более глубоких слоях входы нейрона ещё могут сдвинуться, пока учатся предыдущие слои, но рассчитывать на такое воскрешение нельзя. Конспект (стр. 181) называет три причины смерти: большое отрицательное смещение, слишком большой learning rate и неудачная инициализация, при которой много нейронов с самого начала сидят слева от нуля. Облачко на слайде 27 выделяет вторую: "it happens with high learning rates". Именно так нейрон погибает в первом задании виджета ниже.
Один мёртвый нейрон — не беда. Беда, когда их много: сеть, в которой умерла заметная часть нейронов, фактически стала меньше и уже не может выучить сложную зависимость. В том же облачке слайда это названо "Decreased model capacity".
«Sparse activation — это и есть мёртвые нейроны». Нет. При разреженной активации разные нейроны молчат на разных входах, и каждый где-то работает. Мёртвый нейрон молчит на всех входах сразу. Нейрон, который выдал 0 на текущем примере, не мёртв.
Лекарство очевидно из шага 2: сделать так, чтобы слева от нуля наклон был не нулевым. Тогда у нейрона остаётся запасной выход — слабая, но живая обратная связь. В виджете ниже это можно проверить руками.
Четыре варианта из конспекта
Все варианты совпадают с ReLU справа от нуля (или почти совпадают) и отличаются только тем, что делают слева.
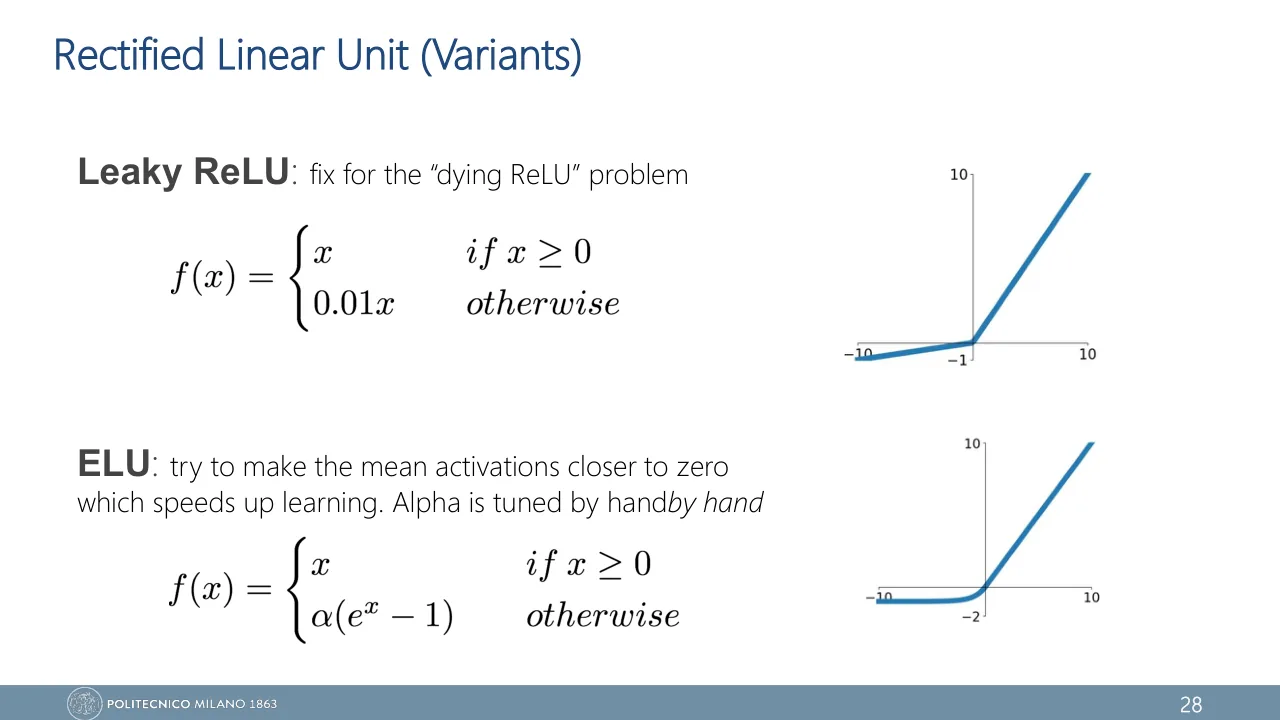
На слайдах из четырёх только два: слайд "Rectified Linear Unit (Variants)" (лекция 3, слайд 28) даёт Leaky ReLU и ELU. PReLU и SELU есть только в конспекте: понимать их полезно, но в ответе «как на лекции» они не обязательны. Формулы на слайде 28 записаны через \(f(x)\). Там \(f\) — это наша \(g\), а \(x\) — наш \(a\), то есть pre-activation нейрона, а не вход сети. Точка ноль на слайде отнесена к правой ветви (\(x \ge 0\)), в конспекте — к левой. Функция от этого не меняется: обе ветви дают в нуле 0.
\[ g(a) = \begin{cases} a, & a \gt 0 \\ \alpha a, & a \le 0 \end{cases} \]
\[ g'(a) = \begin{cases} 1, & a \gt 0 \\ \alpha, & a \le 0 \end{cases} \]
Формула (65) конспекта. \(\alpha\) — маленькая константа, например 0.01. У профессора (лекция 3, слайд 28) буквы нет, там сразу число: слева от нуля \(f(x) = 0.01x\). Подпись на слайде: "fix for the 'dying ReLU' problem". Мёртвых нейронов нет: градиент слева равен \(\alpha\), а не 0; справа всё как у ReLU. Плата: \(\alpha\) — ещё один гиперпараметр, точные нули (sparsity) пропадают, а выигрыш над ReLU на практике непостоянен. В конспекте среди минусов стоит «still linear for negative inputs», но и сам ReLU линеен на каждой половине: нелинейность даёт излом, а не форма левой ветви.
\[ g(a) = \begin{cases} a, & a \gt 0 \\ \alpha_j a, & a \le 0 \end{cases} \]
\[ \pd{g}{\alpha_j} = \begin{cases} 0, & a \gt 0 \\ a, & a \le 0 \end{cases} \]
Формула (66), Parametric ReLU. На слайдах его нет, только в конспекте. Тот же Leaky ReLU, но наклон \(\alpha_j\) — обучаемый параметр: сеть подбирает его тем же градиентным спуском, что и веса. Плюс: каждый нейрон получает свой наклон. Минус: дополнительные параметры. Предложен в той же статье 2015 года, что и инициализация He из следующего урока.
\[ g(a) = \begin{cases} a, & a \gt 0 \\ \alpha\,(e^{a} - 1), & a \le 0 \end{cases} \]
\[ g'(a) = \begin{cases} 1, & a \gt 0 \\ \alpha e^{a}, & a \le 0 \end{cases} \]
Формула (67), Exponential Linear Unit. Слева функция плавно уходит к \(-\alpha\), а производная \(\alpha e^{a} = g(a) + \alpha\) нигде не равна нулю. Главный плюс: выход бывает отрицательным, поэтому средняя активация ближе к нулю, а это смягчает зигзаг из-за нецентрированного выхода. Для \(a \sim N(0, 1)\) среднее ReLU равно 0.40, а ELU с \(\alpha = 1\) — 0.16. Минусы: экспонента дороже сравнения, \(\alpha\) подбирают руками.
Профессор говорит про ELU то же двумя фразами (лекция 3, слайд 28). Зачем он нужен: "try to make the mean activations closer to zero", и это ускоряет обучение. Чем платим: "Alpha is tuned by hand". Формула там та же, только через \(f(x)\).
\[ g(a) = \lambda \begin{cases} a, & a \gt 0 \\ \alpha\,(e^{a} - 1), & a \le 0 \end{cases} \]
\[ g'(a) = \begin{cases} \lambda, & a \gt 0 \\ \lambda \alpha e^{a}, & a \le 0 \end{cases} \]
Формула (68), Scaled ELU; на слайдах его нет. Это ELU, умноженный на \(\lambda\), с фиксированными константами \(\lambda \approx 1.0507\), \(\alpha \approx 1.6733\) (Klambauer и др., 2017). Константы подобраны так, чтобы активации сами держались около среднего 0 и дисперсии 1 — self-normalizing; такой сети меньше нужен batch normalization. Это работает только при особой инициализации весов и стандартизованных входах — той самой z-стандартизации из Applied Statistics.
| Функция | \(g(a)\), \(a \le 0\) | \(g(a)\), \(a \gt 0\) | \(g'\), \(a \le 0\) | \(g'\), \(a \gt 0\) | Чем платим |
|---|---|---|---|---|---|
| ReLU | \(0\) | \(a\) | \(0\) | \(1\) | нейроны умирают |
| Leaky ReLU | \(\alpha a\) | \(a\) | \(\alpha\) | \(1\) | \(\alpha\) выбирать руками |
| PReLU | \(\alpha_j a\) | \(a\) | \(\alpha_j\) (учится) | \(1\) | лишние параметры |
| ELU | \(\alpha(e^{a} - 1)\) | \(a\) | \(\alpha e^{a}\) | \(1\) | экспонента |
| SELU | \(\lambda\alpha(e^{a} - 1)\) | \(\lambda a\) | \(\lambda\alpha e^{a}\) | \(\lambda\) | своя инициализация |
График на слайде 29 лекции 3: ещё три имени
Последний слайд блока (лекция 3, слайд 29) повторяет предыдущий, но поверх формул на нём лежит график "E-swish and other well-known activations". Кривых семь. ReLU, Leaky ReLU и ELU уже знакомы; формул для остальных на слайде нет, так что их достаточно узнавать в лицо.
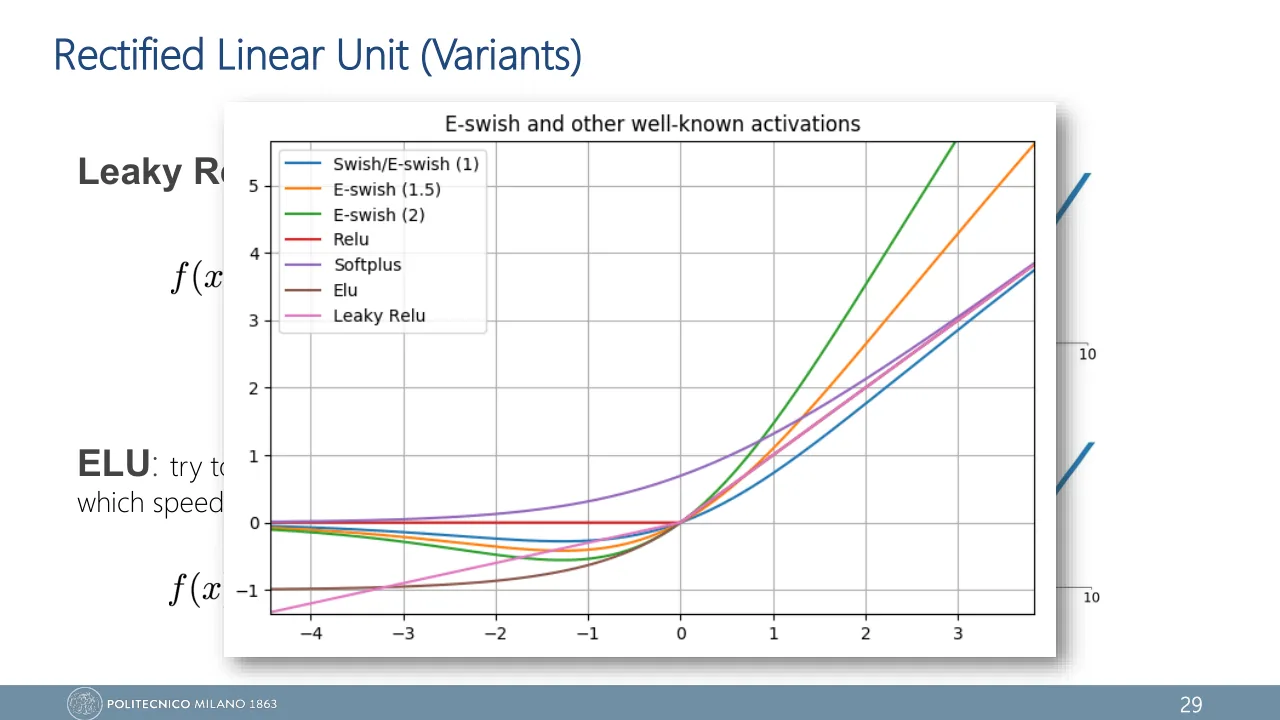
- Softplus, \(g(a) = \ln(1 + e^{a})\) — сглаженный ReLU без излома. На графике это кривая, которая везде лежит выше ReLU и в нуле проходит через \(\ln 2 \approx 0.69\). Её производная — sigmoid: нулю она не равна нигде, но слева насыщается.
- Swish, \(g(a) = a \cdot \sigma(a)\), где \(\sigma\) — sigmoid. Справа это почти ReLU, а слева не ноль, а неглубокая ямка: минимум около \(-0.28\) при \(a \approx -1.28\), дальше кривая возвращается к нулю.
- E-swish — тот же Swish, умноженный на константу: \(g(a) = \beta \cdot a \cdot \sigma(a)\). Числа 1, 1.5 и 2 в легенде графика — это \(\beta\); при \(\beta = 1\) получается Swish.
Leaky ReLU на графиках слайдов нарисован с наклоном заметно больше 0.01: около 0.1 на слайде 28 и около 0.3 на слайде 29. Иначе левую ветвь было бы не отличить от оси. В формуле слайда стоит 0.01, и считать нужно с ним.
На стр. 176 конспект обещает ещё GELU, но нигде его не определяет; на слайдах его нет совсем. На всякий случай: \(\mathrm{GELU}(a) = a \cdot \Phi(a)\), где \(\Phi\) — функция распределения стандартного нормального закона. Это гладкий родственник ReLU, по форме похожий на Swish.
Развязка: куда делось сообщение
Вернёмся к задачке. Десять слоёв — это девять передач. У sigmoid наклон не больше 0.25, веса равны 1, значит каждая передача оставляет от сообщения не больше четверти:
\[ 0.25^{9} = \frac{1}{4^{9}} = \frac{1}{262\,144} \approx 3.8 \cdot 10^{-6} \]Четыре миллионных, и то при условии, что все нейроны сидят точно в нуле. С ReLU те же девять передач умножают на 1, пока нейроны активны, и сообщение приходит целиком. За это ReLU платит возможностью замолчать навсегда; от неё страхует ненулевой наклон слева.
Но произведение остаётся произведением. В множителе \(w \cdot g'(a)\) две части, и ReLU чинит только вторую. Остальные уроки главы — про остальное:
- часть \(g'(a)\) — выбор функции активации: этот урок;
- часть \(w\) — с каких весов начинать: урок 25;
- обе части на лету, во время обучения — batch normalization: урок 26;
- разный масштаб градиента в разных слоях — свой шаг для каждого параметра: урок 27.
У профессора этот блок открывается титульным слайдом "Tips and Tricks in Neural Networks Training" (лекция 3, слайд 23) и идёт в том же порядке: функции активации, инициализация весов, batch normalization, шаг обучения.
Sepp Hochreiter описал затухание градиента в дипломной работе «Untersuchungen zu dynamischen neuronalen Netzen» в Техническом университете Мюнхена; его научным руководителем был Jürgen Schmidhuber. До бума глубокого обучения оставалось двадцать лет. Позже тот же Hochreiter стал соавтором двух лекарств: LSTM (1997) для рекуррентных сетей и ELU (2015) из этого урока.
В формате экзамена
What is the vanishing gradient problem? Which layers does it affect most, and why do sigmoid and tanh activations cause it? Name three remedies.
Show model answer
In backpropagation the error signal of a hidden unit is built from the signals of the next layer:
\[ \delta_i^{(l-1)} = g'\big(a_i^{(l-1)}\big) \sum_j w_{ji}^{(l)}\, \delta_j^{(l)} \]Unrolling this recursion, the gradient that reaches the first layer is a product of \(L-1\) per-layer factors of size about \(\abs{w \cdot g'(a)}\). For the sigmoid \(g' \le 0.25\) (and \(g' \approx 0\) when the unit is saturated); for tanh \(g' \le 1\) (and \(\approx 0\) when saturated). With factors below 1 the product shrinks exponentially with depth, so the layers closest to the input receive almost no gradient and their weights are not updated, although the error is still large.
The slides show it on the gradient of a first-layer weight in a network with one hidden layer, \(\partial E / \partial w_{ji}^{(1)}\): it already contains two activation derivatives, \(g_1'\) and \(h_j'\). Sigmoid and tanh saturate, so this derivative gets close to zero and is never above 1; backpropagation multiplies such derivatives, hence the gradient far away from the output vanishes and learning in a deep network does not happen. The problem is best known from recurrent neural networks, but it affects every deep network.
Remedies: non-saturating activations such as ReLU (\(g' = 1\) for \(a \gt 0\)); variance-preserving weight initialisation (Xavier, He); batch normalisation; residual connections.
Проверяют три вещи: механизм (произведение множителей по слоям, а не одно слово saturation), кто страдает (слои у входа) и конкретные лекарства. Сильный ответ отдельно говорит, что у sigmoid затухание есть и без насыщения, потому что \(g' \le 0.25\). Скелет ответа — четыре пункта профессора (лекция 3, слайд 24): saturate, производная не больше 1, gradient multiplications, градиент вдали от выхода исчезает, глубокая сеть не учится.
A chain of 10 sigmoid neurons (one neuron per layer) has all weights equal to 1. Compute the largest possible value of \(\abs{\delta^{(1)}} / \abs{\delta^{(10)}}\), i.e. the largest fraction of the error signal that can reach the first neuron. Give the answer in units of \(10^{-6}\) (type 2.5 for \(2.5 \cdot 10^{-6}\)). What changes if the neurons are ReLU?
Show model answer
Going from neuron 10 back to neuron 1 takes 9 backward steps. Each step multiplies the signal by \(w \cdot g'(a) \le 1 \cdot 0.25\), with equality only at \(a = 0\):
\[ \frac{\abs{\delta^{(1)}}}{\abs{\delta^{(10)}}} \le 0.25^{9} \approx 3.81 \cdot 10^{-6} \]With ReLU and active units (\(a \gt 0\)) each factor is exactly \(w \cdot 1 = 1\): no attenuation. Through any inactive unit the factor is exactly 0.
Частая ошибка — возвести в десятую степень: нейронов 10, а передач между ними 9. Вторая — забыть слово «at most»: это верхняя граница, она достигается только при \(a = 0\) во всех нейронах.
A hidden unit \(i\) has pre-activation \(a_i = -2\). The backpropagated sum from the next layer is \(\sum_j w_{ji}\,\delta_j = 0.5\). Compute the error signal \(\delta_i\) of the unit if its activation is (a) ReLU, (b) Leaky ReLU with \(\alpha = 0.01\), (c) ELU with \(\alpha = 1\). Enter the value for (c).
Show model answer
\(\delta_i = g'(a_i) \cdot \sum_j w_{ji}\,\delta_j\), with the derivative taken on the branch \(a \le 0\).
(a) ReLU: \(g'(-2) = 0\), so \(\delta_i = 0\).
(b) Leaky ReLU: \(g'(-2) = \alpha = 0.01\), so \(\delta_i = 0.01 \cdot 0.5 = 0.005\).
(c) ELU: \(g'(-2) = \alpha e^{-2} = 0.1353\), so \(\delta_i = 0.1353 \cdot 0.5 = 0.0677\).
Проверяют производные слева от нуля. Ровный ноль у ReLU — причина dying ReLU; у Leaky ReLU и ELU сигнал остаётся. Для ELU удобно помнить \(g'(a) = g(a) + \alpha\): здесь \(-0.8647 + 1 = 0.1353\).
Define the ReLU activation function and its derivative. List its advantages and disadvantages. What is a dying ReLU, and how do Leaky ReLU and ELU address it?
Show model answer
\(g(a) = \max(0, a)\); \(g'(a) = 1_{a \gt 0}\), i.e. 1 for \(a \gt 0\) and 0 for \(a \lt 0\) (not differentiable at 0; by convention \(g'(0) = 0\)).
Advantages: faster SGD convergence (about 6 times faster than tanh in Krizhevsky et al., 2012); sparse activation (only part of the hidden units are active); efficient gradient propagation: it does not saturate for \(a \gt 0\), so the backward factor \(g'\) of an active unit is exactly 1 and the activation itself neither shrinks nor amplifies the gradient (the weights still can); efficient computation (just a threshold at zero, no exponential). Not on the slides, but true: it is scale-invariant, \(\max(0, c\,a) = c \max(0, a)\) for \(c \ge 0\).
Disadvantages: not differentiable at zero (but differentiable anywhere else); output not zero-centred; unbounded output, which could potentially blow up; dying neurons.
A ReLU neuron dies when it is pushed into a state in which it is inactive for essentially all inputs: its pre-activation is negative for all training samples. It happens with high learning rates (one too large update), and also with a large negative bias or after a poor initialisation. Its output is 0 and \(g' = 0\), so no gradient flows backward through the neuron: its \(\delta\) and the gradients of its weights and bias are exactly zero, it is stuck and is never updated again. Many dead neurons mean a decreased model capacity. Leaky ReLU fixes the dying ReLU problem with a small slope on the left: \(g(a) = 0.01\,a\) for \(a \lt 0\) (in general \(\alpha a\)), so the gradient there is \(\alpha\) instead of 0. ELU uses \(g(a) = \alpha(e^{a} - 1)\) for \(a \lt 0\), with gradient \(\alpha e^{a} \gt 0\); it also makes the mean activation closer to zero, which speeds up learning, and its \(\alpha\) is tuned by hand.
Балл теряют на двух местах. Первое: в определении мёртвого нейрона нужны слова «for all training samples» (на слайде 27 лекции 3 — "for essentially all inputs"): нейрон, выдавший ноль на одном примере, не мёртв. Второе: в минусах пишут только dying ReLU и забывают три остальных.
Списки плюсов и минусов в ответе взяты у профессора почти дословно (лекция 3, слайд 26 и слайд 27); формулы Leaky ReLU и ELU — со слайда 28 лекции 3. У плюса efficient gradient propagation на слайде в скобках стоит "no vanishing or exploding gradient problems": в открытом ответе пиши точную версию про множитель \(g'\) и веса, как здесь.
Which of the following are advantages of the ReLU activation function with respect to sigmoid and tanh, as seen in class? Select all that apply.
Show model answer
Correct: faster SGD convergence, sparse activation, efficient gradient propagation and efficient computation. These are the four advantages listed in class. The other three statements are the opposite of ReLU's potential disadvantages: its output is not zero-centred, it is unbounded, and it is not differentiable at zero. The fourth disadvantage is dying neurons.
Вопрос на узнавание двух списков профессора: четыре плюса (лекция 3, слайд 26) и четыре минуса (лекция 3, слайд 27). Неверные варианты здесь — минусы, вывернутые наизнанку. Если в тесте плюс про градиент записан словами слайда, "no vanishing or exploding gradient problems", это тот же третий плюс из списка профессора. Ложным его делают добавки вроде "whatever the weights are", как в следующем вопросе.
Select all correct statements.
Show model answer
Correct: the first, third and fourth statements. The per-layer backward factor is \(w \cdot g'(a)\): ReLU fixes \(g'\) on the active side but not \(w\); the sigmoid derivative is bounded by 1/4; a dead ReLU has \(g' = 0\) on all samples; Leaky ReLU's slope \(\alpha\) applies to \(a \le 0\); tanh saturates for large \(\abs{a}\).
Каждая строка проверяет один факт о множителе \(w \cdot g'(a)\). Ловушка — второе утверждение. Фраза «ReLU solves the vanishing gradient» встречается в учебниках, а у профессора среди плюсов ReLU стоит "no vanishing or exploding gradient problems" (лекция 3, слайд 26). Без оговорки про веса это неверно, и слова "whatever the weights are" делают вариант ложным.
Suppose every layer multiplies the backpropagated gradient by a factor of 2. What is the minimum number of layers after which the gradient has been amplified by more than a factor of 1000? Which symptoms would you observe during training, and what is a standard remedy?
Show model answer
We need \(2^{n} \gt 1000\), i.e. \(n \gt \log_2 1000 \approx 9.97\), so \(n = 10\) (\(2^{10} = 1024\)). With 50 layers the factor is \(2^{50} \approx 1.13 \cdot 10^{15}\).
This is the exploding gradient problem: when the weights are too large, the gradient grows as it passes back through each layer. Symptoms: the error (loss) suddenly becomes NaN or Inf; the weights take extremely large values; the gradient norm is in the hundreds or thousands; training oscillates wildly or diverges. Remedies: gradient clipping; proper weight initialisation (Xavier, He); normalisation layers; LSTM or GRU units in recurrent networks.
Числовая часть простая; баллы дают за связку «множитель на слой больше 1 → экспоненциальный рост → симптомы → gradient clipping». У профессора про взрыв одна фраза о слишком больших начальных весах (лекция 3, слайд 30); пример с двойкой, симптомы и clipping — из конспекта.
Проверь себя
Сеть из 10 слоёв с sigmoid учится уже много эпох. Ошибка на обучении большая и почти не падает, веса первого слоя практически не меняются, веса последнего меняются заметно. Что происходит?
На что умножается сообщение \(\delta\) при одной передаче назад в цепочке с одним нейроном на слой?
Что из этого верно про ReLU?
Картинка для памяти: активный ReLU повторяет слово в слово, выключенный молчит совсем.
Нейрон с ReLU выдаёт 0 на 7 из 12 обучающих примеров и положительные числа на остальных пяти. Он мёртв?
Нейрон первого скрытого слоя с ReLU умер. Что из перечисленного может вернуть его к жизни?
Цепочка из 6 слоёв, все веса равны 1, все нейроны сидят в \(a = 0\). Во сколько раз сообщение в первом слое сильнее с tanh, чем с sigmoid?
ELU с \(\alpha = 0.5\). Есть ли у графика излом в нуле?
Унести с собой
- Сообщение об ошибке \(\delta\) идёт от выхода ко входу и на каждой передаче умножается на \(w \cdot g'(a)\); до первого слоя оно доходит после \(L - 1\) таких умножений.
- У sigmoid \(g' \le 0.25\), у tanh \(g' \le 1\), в насыщении обе производные около нуля. Затухание у sigmoid есть и без насыщения. У профессора (лекция 3, слайд 24) граница общая, "everywhere \(\le 1\)", а причина та же: производные перемножаются.
- Множитель меньше 1 даёт vanishing gradient (первые слои не учатся при большой ошибке), больше 1 — exploding gradient (NaN, огромные веса); от второго лечит gradient clipping.
- ReLU \(g(a) = \max(0, a)\) на активной стороне имеет \(g' = 1\): множитель становится просто \(w\), так что затухание и взрыв теперь зависят от весов. Плюсы (лекция 3, слайд 26): faster SGD convergence, sparse activation, efficient gradient propagation, efficient computation. Минусы (лекция 3, слайд 27): не дифференцируем в нуле, выход не центрирован, не ограничен, нейроны умирают.
- Мёртвый ReLU — нейрон с \(a \le 0\) на всех обучающих примерах: градиент ровно 0, обновиться он не может. Причины: слишком большой \(\eta\) (её называет и слайд 27 лекции 3), большое отрицательное смещение, неудачная инициализация. Много мёртвых нейронов — меньше ёмкость модели.
- Leaky ReLU, PReLU, ELU и SELU оставляют слева ненулевую производную; ELU и SELU заодно приближают среднюю активацию к нулю. У профессора из них два (лекция 3, слайд 28): Leaky ReLU с наклоном 0.01 и ELU.
Что посмотреть и почитать
-
Neural Networks Pt. 3: ReLU In Action!!!
StatQuest
Самое мягкое знакомство с ReLU: как из нескольких «согнутых прямых» складывается кривая. Посмотри, если ReLU для тебя пока только формула.
-
Why are deep neural networks hard to train?
Michael Nielsen, глава 5
Та же цепочка из одиночных нейронов и тот же множитель \(w \cdot \sigma'(z)\), но со столбиками скорости обучения по слоям, измеренными на MNIST. Сайт открывается только по http: значок «не защищено» — это нормально.
-
Lecture 6: Training Neural Networks I
Stanford CS231n, 2017
Весь зоопарк активаций на одной лекции: три проблемы sigmoid, картинка мёртвого ReLU, Leaky ReLU, PReLU, ELU. Вторая половина лекции — материал уроков 25 и 26.
-
Building makemore Part 3: Activations & Gradients, BatchNorm
Andrej Karpathy1 ч 55 мин
Настоящая сеть ведёт себя плохо прямо в кадре: гистограмма выходов tanh, прижатых к ±1, и мёртвые нейроны. Хороший итог для уроков 24–26 сразу.
-
ImageNet Classification with Deep Convolutional Neural Networks
Krizhevsky, Sutskever, Hinton, 2012
Читать целиком не нужно: открой раздел 3.1 и рисунок 1 — те самые «в шесть раз быстрее» из этого урока, на одном графике.