Статья про BN вышла через пять дней после статьи с He initialization: 6 и 11 февраля 2015 года. Авторы BN объясняли успех тем, что слой уменьшает internal covariate shift. В 2018 году группа из MIT (Santurkar, Tsipras, Ilyas, Madry) показала, что стабильность распределений мало связана с успехом BN; по их версии, слой делает поверхность ошибки более гладкой, и идти по ней градиентом легче. Метод работает, а спор о причине не закрыт. На слайдах этого спора нет: там BN объясняется через internal covariate shift (лекция 3, слайд 34), как в исходной статье и в конспекте. На экзамене излагай именно это объяснение. Одна фраза о том, что его оспаривают, — необязательное дополнение сверх слайдов.
Оценка по кривой
После этого урока ты на калькуляторе посчитаешь выход Batch Normalization для любого mini-batch, объяснишь, зачем слою \(\gamma\) и \(\beta\), и скажешь, что в нём меняется при переходе от обучения к inference.
Один и тот же экзамен сдают три потока. Первому достался лёгкий вариант, третьему — тяжёлый, и сравнивать сырые баллы нечестно. Преподаватель «оценивает по кривой»: внутри каждого потока вычитает средний балл и делит на разброс. Теперь ноль означает «как средний в своём потоке», какой бы вариант ни попался.
На пересдачу приходит один человек. Поток из одного студента. Средний балл такого потока равен его собственному баллу, разность равна нулю — что бы он ни написал. Как оценить по кривой его?
11 февраля 2015 года Sergey Ioffe и Christian Szegedy выложили статью, в которой эта процедура встроена внутрь нейросети: каждый нейрон на каждом шаге обучения пересчитывает свои значения относительно текущего mini-batch. По словам авторов, модель классификации изображений дошла до той же точности, сделав в 14 раз меньше шагов обучения. Своя «пересдача в одиночку» у этого слоя тоже есть, и решена она так, как поступил бы разумный преподаватель.
Стандартизация, которая устаревает на каждом шаге
Перед PCA в Applied Statistics признаки стандартизируют: из каждого вычитают среднее и делят на стандартное отклонение. После этого у всех признаков среднее 0 и разброс 1, и ни один не перекрикивает остальные только из-за единиц измерения. С входами нейросети поступают так же.
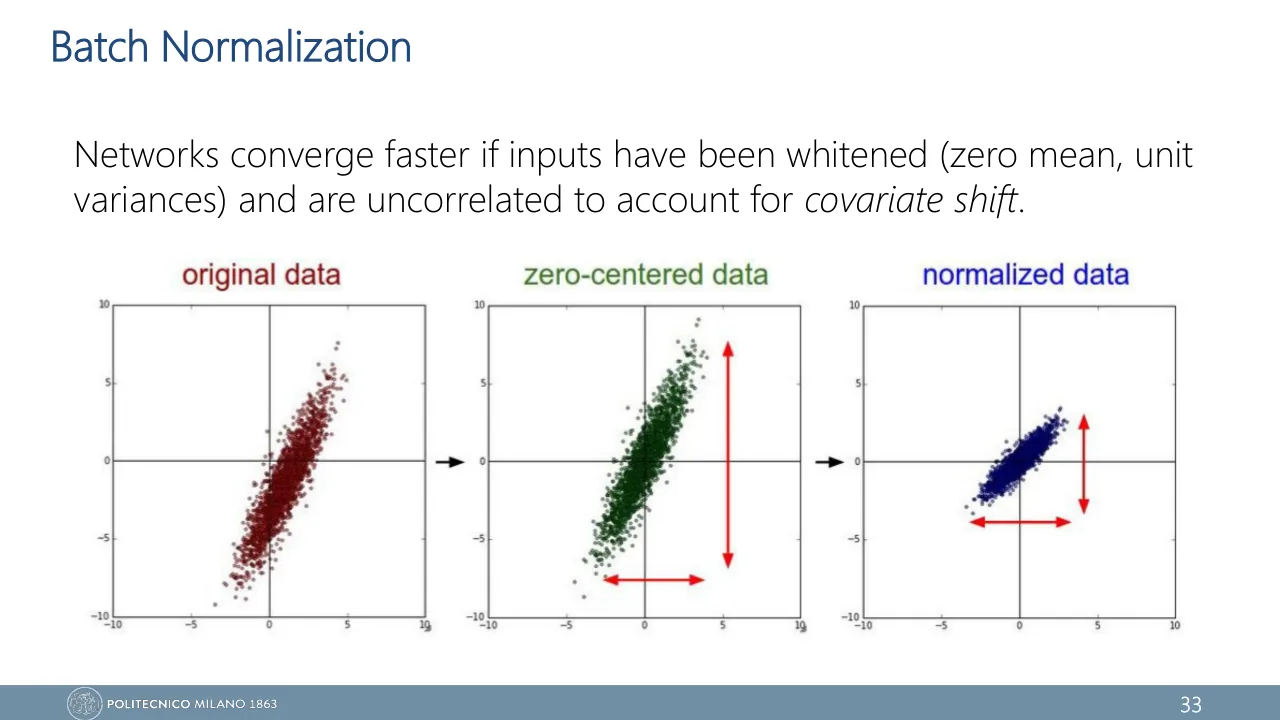
Слайды о Batch Normalization начинаются с этой мысли: "Networks converge faster if inputs have been whitened (zero mean, unit variances) and are uncorrelated to account for covariate shift" (лекция 3, слайд 33). Zero mean, unit variances — та самая стандартизация. Uncorrelated добавляет к ней второе требование: признаки не должны коррелировать друг с другом. В строгом смысле whitening — это оба требования вместе. А covariate shift — сдвиг распределения входов; точное определение будет чуть ниже.
Под этой фразой на слайде три облака точек. Original data: облако стоит в стороне от начала координат. Zero-centered data: из каждой координаты вычли её среднее, облако переехало в центр. Normalized data: каждую ось поделили на её стандартное отклонение, и красные стрелки размаха стали одинаковой длины. Третье облако всё ещё вытянуто вдоль диагонали: корреляцию рисунок не убирает, на нём стандартизация, а не полный whitening.
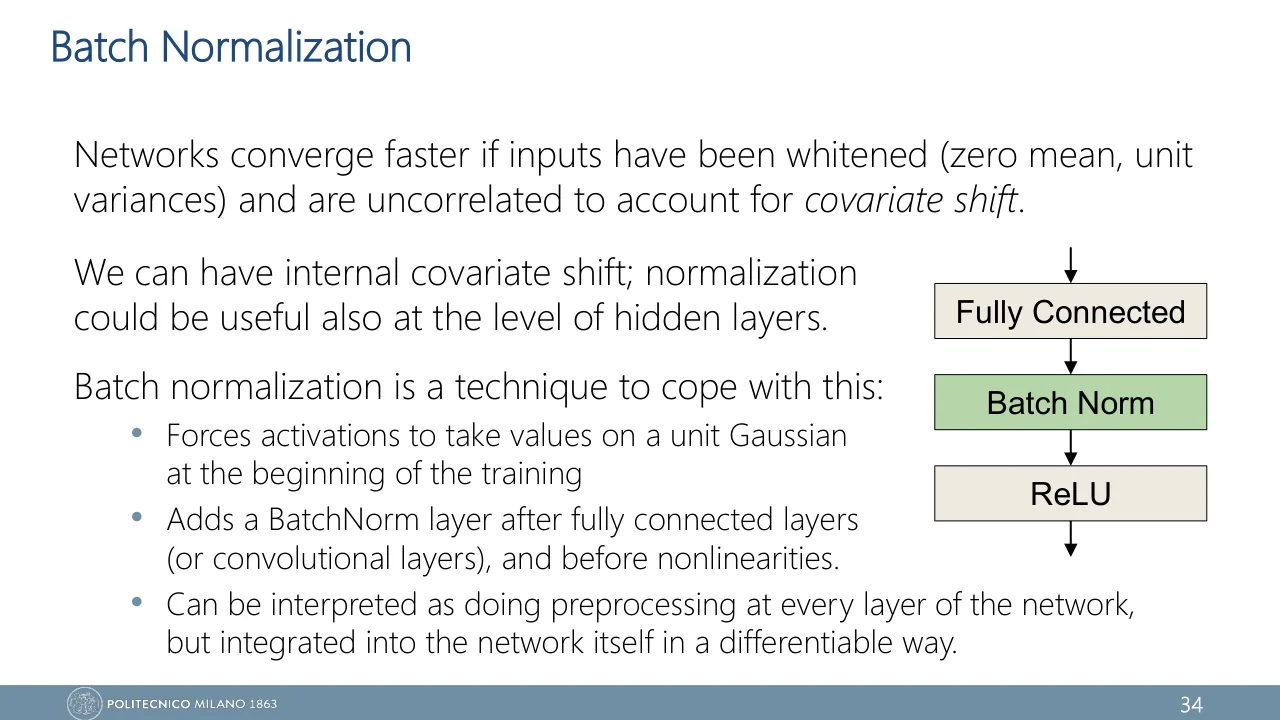
Входы стандартизируют один раз, до обучения: данные не меняются, значит, и статистика не устареет. Но у второго слоя свои «данные» — выходы первого. У третьего — выходы второго. А эти выходы меняются после каждого обновления весов. Слой подстроился под одно распределение своих входов, а шаг спустя оно уже другое. У явления есть имя: internal covariate shift. На слайде оно появляется одной строкой: "We can have internal covariate shift; normalization could be useful also at the level of hidden layers" (лекция 3, слайд 34).
Internal covariate shift — изменение распределения входов скрытого слоя в ходе обучения, вызванное тем, что обновляются веса предыдущих слоёв.
Слово internal здесь несёт весь смысл. Без него получается другое, более старое понятие. Слайды их тоже разводят (лекция 3, слайды 33–34): covariate shift стоит во фразе про входы сети, internal covariate shift — во фразе про скрытые слои.
Распределение входов модели на обучении и на тесте разное: \(P_{train}(X) \ne P_{test}(X)\), а задача та же. Пример конспекта: детектор кошек учили на ярких студийных фото, а проверяют на тёмных уличных.
Датасет один и тот же. Меняется то, что течёт между слоями: распределение входов слоя на шаге 100 не такое, как на шаге 1, потому что слои перед ним успели измениться.
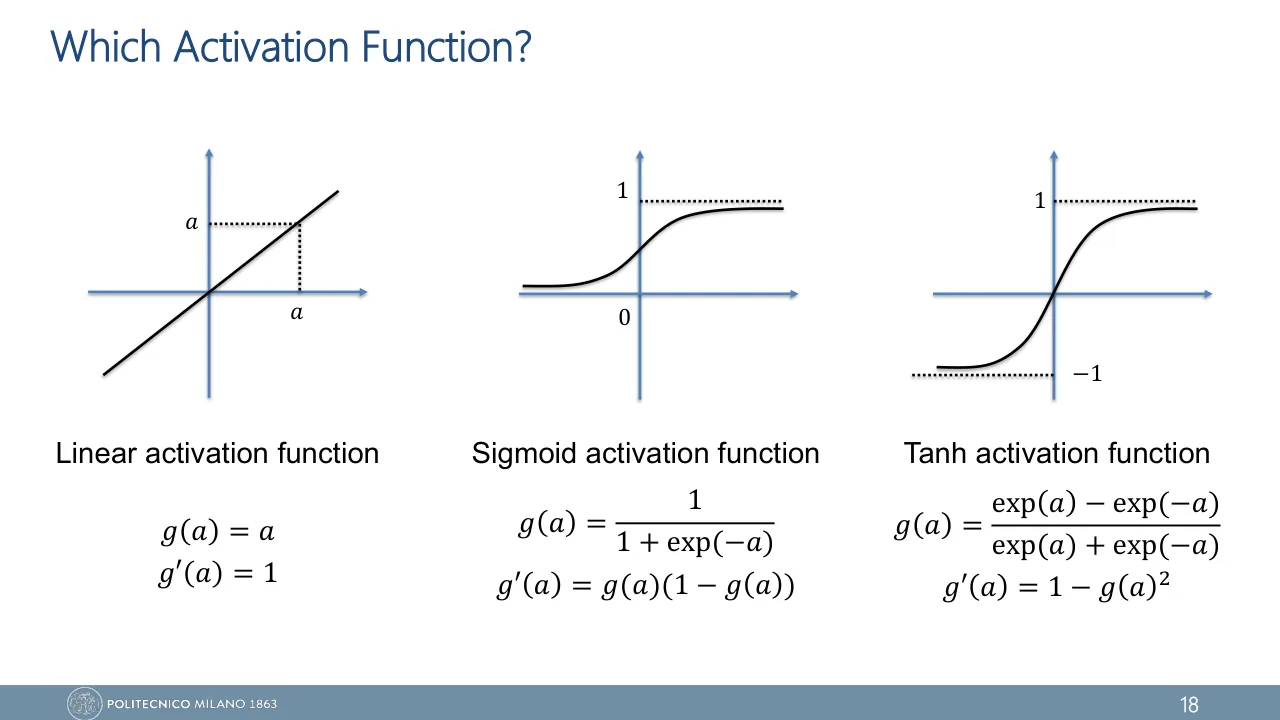
Насколько далеко может уехать распределение? Конспект даёт такие числа: на итерации 1 вход слоя имеет среднее 0 и дисперсию 1, на итерации 100 — среднее 3 и дисперсию 10. Посмотрим, что это значит для одного нейрона с tanh. Его pre-activation обозначим \(x\): так она названа в алгоритме на слайде, до которого дойдём в следующем разделе (в лекции 2 это \(a\)). Будем считать пример насыщенным, когда \(\abs{x} \gt 2\): там \(\tanh'(x) \lt 0.071\), и градиент через нейрон почти не проходит. Это механизм из урока 24.
Итерация 1: среднее 0, дисперсия 1
Итерация 100: среднее 3, дисперсия 10
На итерации 100 две трети примеров дают нейрону почти нулевой градиент. При этом сам нейрон никто не трогал: его собственные веса могли вообще не измениться. Уехали слои перед ним.
Конспект перечисляет три последствия. Нейроны попадают в насыщение, и градиент затухает. Поток градиента становится нестабильным: масштаб сигналов гуляет от шага к шагу. И приходится брать маленький learning rate и очень аккуратную инициализацию, чтобы распределения не уезжали слишком быстро.
Каждый слой учится на данных, которые производят слои перед ним, а они всё время меняются: слой целится в движущуюся мишень.
Четыре шага Batch Normalization
Идея Ioffe и Szegedy простая: раз стандартизация входов помогает, а внутри сети она устаревает, будем делать её заново на каждом шаге — прямо внутри сети. На слайде метод описан тремя пунктами под строкой "Batch normalization is a technique to cope with this:" (лекция 3, слайд 34).
- "Forces activations to take values on a unit Gaussian at the beginning of the training". Unit Gaussian здесь — короткое имя для «среднее 0, дисперсия 1». Почему только в начале обучения и почему настоящей гауссианы никто не обещает, разберём в разделе про \(\gamma\) и \(\beta\).
- "Adds a BatchNorm layer after fully connected layers (or convolutional layers), and before nonlinearities." Рядом на слайде схема из трёх блоков сверху вниз: Fully Connected → Batch Norm → ReLU. К месту слоя вернёмся на рис. 3.
- "Can be interpreted as doing preprocessing at every layer of the network, but integrated into the network itself in a differentiable way." Это и есть идея целиком: та же предобработка, но в каждом слое и такая, через которую проходит backpropagation.
Пересчитывать статистику по всему датасету после каждого обновления весов слишком дорого, поэтому берут ту, что под рукой: по текущему mini-batch. Это и есть оценка по кривой. Поток — это mini-batch, сырой балл — pre-activation нейрона.
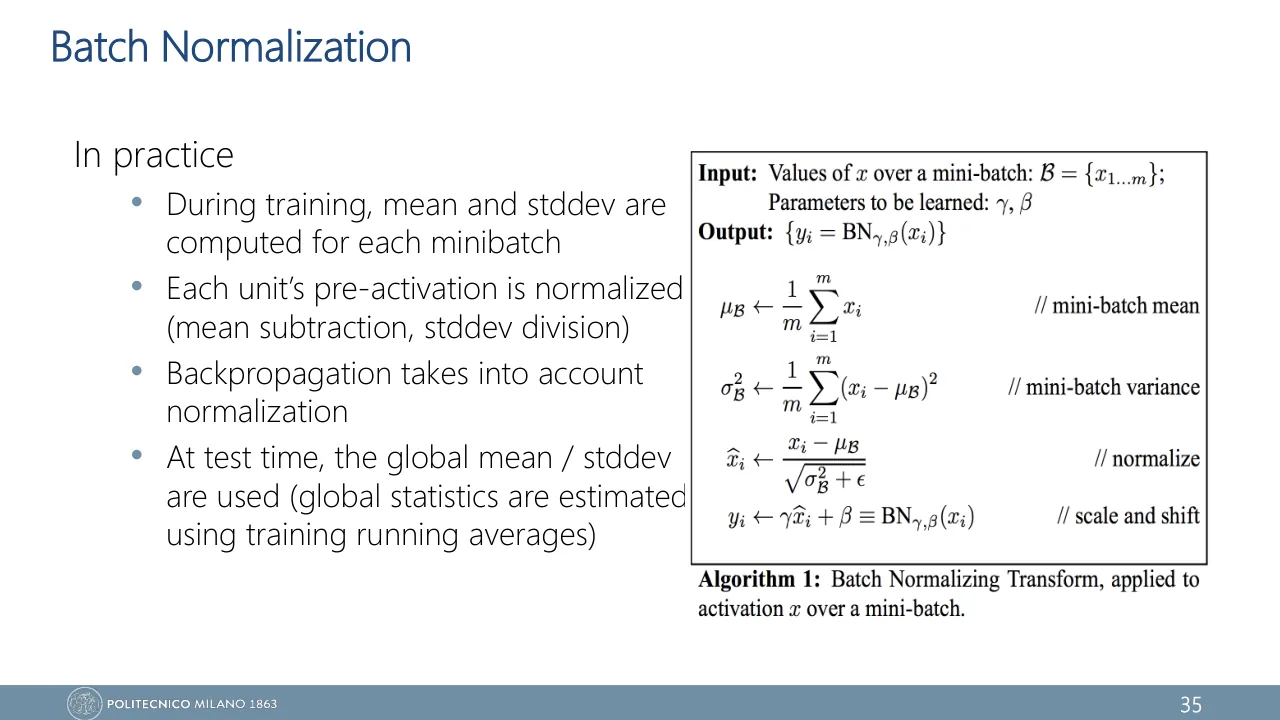
Важно, что именно усредняется. Представь таблицу: строки — примеры из mini-batch, столбцы — нейроны слоя. BN работает по столбцам: у каждого нейрона своё среднее и своя дисперсия, посчитанные по \(m\) примерам. На слайде на это указывает слово unit: "Each unit's pre-activation is normalized" (лекция 3, слайд 35). Корреляции между нейронами BN не трогает: как и на рисунке со слайда 33, это стандартизация, а не полный whitening.
Теперь формулы. Берём один нейрон и смотрим на его pre-activation на каждом примере из mini-batch: \(x_1, \dots, x_m\). Обозначения взяты из рамки с алгоритмом на слайде (лекция 3, слайды 35–37). Под рамкой подпись: "Algorithm 1: Batch Normalizing Transform, applied to activation x over a mini-batch". Буква \(x\) здесь — не вход сети, а значение, к которому применяют BN. Слово activation в подписи означает ту самую pre-activation, число до нелинейности.
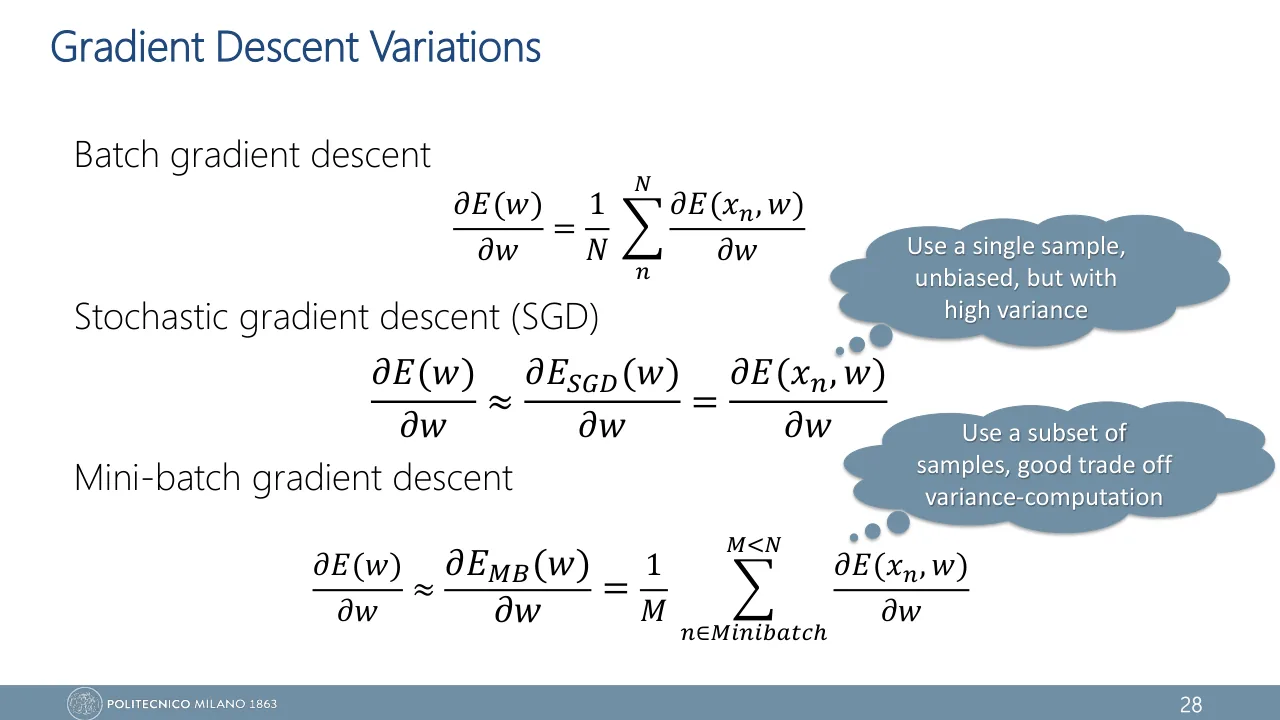
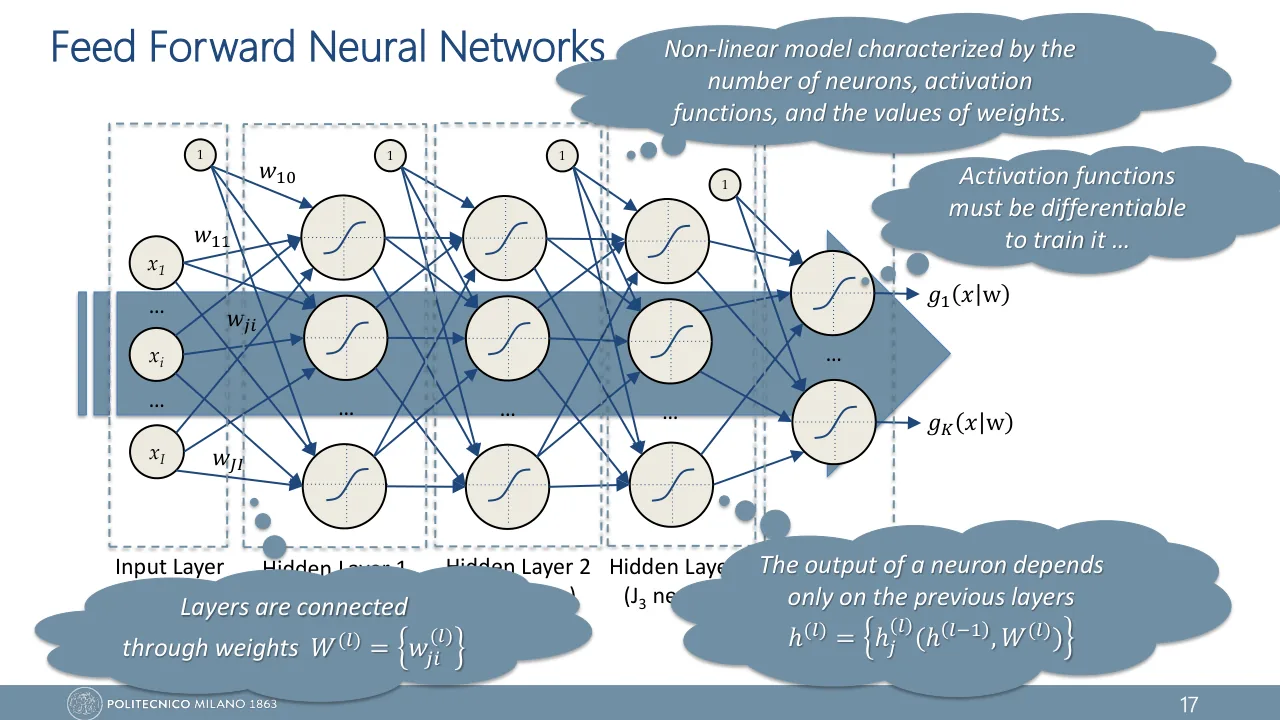
С другими источниками рамка соотносится так. В конспекте то же число записано как \(z_i^{(l)}\), с номером слоя \(l\); здесь, как в рамке, номер слоя опущен. В лекции 2 pre-activation обозначалась \(a\) (слайд 18), номер примера \(n\), размер mini-batch \(M\) (слайд 28). В рамке номер примера \(i\), а размер \(m\), как и в конспекте.
\[ \mu_B \leftarrow \frac{1}{m}\sum_{i=1}^{m} x_i \]
\[ \sigma_B^2 \leftarrow \frac{1}{m}\sum_{i=1}^{m} (x_i - \mu_B)^2 \]
\[ \hat x_i \leftarrow \frac{x_i - \mu_B}{\sqrt{\sigma_B^2 + \epsilon}} \]
\[ y_i \leftarrow \gamma\,\hat x_i + \beta \equiv \mathrm{BN}_{\gamma,\beta}(x_i) \]
- \(x_i\)
- pre-activation нейрона на примере \(i\)
- \(m\)
- размер mini-batch
- \(\mu_B,\ \sigma_B^2\)
- mini-batch mean и mini-batch variance (в конспекте batch mean и batch variance): среднее и дисперсия по mini-batch. Индекс \(B\) — имя самого набора; на слайде он рукописный, \(\mathcal{B} = \{x_{1 \ldots m}\}\)
- \(\epsilon\)
- маленькая константа, чтобы не делить на ноль
- \(\hat x_i\)
- нормализованное значение (normalize): среднее 0, дисперсия 1
- \(\gamma,\ \beta\)
- scale и shift: два обучаемых числа на нейрон, в рамке "Parameters to be learned"
- \(y_i\)
- выход слоя BN. Запись \(\equiv \mathrm{BN}_{\gamma,\beta}(x_i)\) даёт всему преобразованию имя; дальше оно пишется короче, \(\mathrm{BN}(x)\). Это не целевое значение: цель в курсе обозначена \(t_n\)
- \(\leftarrow\)
- запись алгоритма: посчитать правую часть и сохранить под именем слева. В расчётах ниже вместо стрелки стоит обычный знак равенства
Первые три шага — та же стандартизация, что перед PCA. Отличий два: статистика берётся по mini-batch, а не по всей выборке, и дисперсия делится на \(m\), а не на \(m - 1\). Четвёртый шаг новый, о нём следующий раздел. Сначала числа: mini-batch из четырёх примеров \(x = (1, 3, 5, 7)\), параметры \(\gamma = 2\), \(\beta = 1\), а \(\epsilon\) так мал, что его не видно.
-
Mini-batch mean. Складываем четыре значения и делим на \(m = 4\):
\[ \mu_B = \frac{1 + 3 + 5 + 7}{4} = 4 \] -
Mini-batch variance. Отклонения от среднего: \(-3,\ -1,\ 1,\ 3\). Берём средний квадрат:
\[ \sigma_B^2 = \frac{9 + 1 + 1 + 9}{4} = 5 \]Стандартное отклонение \(\sigma_B = \sqrt{5} \approx 2.236\).
-
Normalize. Из каждого значения вычитаем 4 и делим на 2.236. Для последнего примера:
\[ \hat x_4 = \frac{7 - 4}{2.236} = 1.342 \]Остальные три: \(-1.342\), \(-0.447\), \(0.447\). Сумма равна нулю, сумма квадратов равна 4, значит, дисперсия \(4 / 4 = 1\).
-
Scale and shift. Умножаем на \(\gamma = 2\) и прибавляем \(\beta = 1\):
\[ y_4 = 2 \cdot 1.342 + 1 = 3.683 \] -
Что получилось. Среднее \(y\) по mini-batch равно 1, то есть \(\beta\). Стандартное отклонение равно 2, то есть \(\gamma\). Исходные 4 и 2.236 из ответа исчезли: какими бы они ни были, у результата были бы те же среднее и разброс.
| пример | \(x_i\) | \(x_i - \mu_B\) | \(\hat x_i\) | \(y_i\) |
|---|---|---|---|---|
| 1 | 1 | −3 | −1.342 | −1.683 |
| 2 | 3 | −1 | −0.447 | 0.106 |
| 3 | 5 | 1 | 0.447 | 1.894 |
| 4 | 7 | 3 | 1.342 | 3.683 |
| среднее | 4 | 0 | 0 | 1 |
| разброс | 2.236 | 2.236 | 1 | 2 |
Если в условии задачи \(\epsilon\) не задан, считай его нулём. Дисперсию дели на \(m\). На калькуляторе это режим \(\sigma_n\), а не \(s\) и не \(\sigma_{n-1}\): с ними для того же примера выйдет \(\hat x_4 = 1.162\) вместо \(1.342\).
Зачем после нормализации снова растягивать
После шага 3 у каждого нейрона среднее 0 и разброс 1. У всех одинаково, и это слишком жёстко. У нейрона с tanh большая часть примеров попадает на средний, почти линейный участок кривой. У нейрона с ReLU примерно половина примеров даёт ноль. А если для задачи нужно другое? Чистая нормализация ограничивает то, что слой способен выразить (representational power).
Поэтому есть шаг 4: \(y_i = \gamma\,\hat x_i + \beta\). Параметр \(\gamma\) растягивает или сжимает, \(\beta\) сдвигает. Оба — обычные параметры сети (learnable parameters). У каждого нейрона своя пара, начальные значения \(\gamma = 1\) и \(\beta = 0\), дальше их учит gradient descent вместе с весами. В истории про экзамен это официальная шкала: после кривой баллы переводят в шкалу со средним \(\beta\) и разбросом \(\gamma\), и шкалу эту выбирает сама сеть.
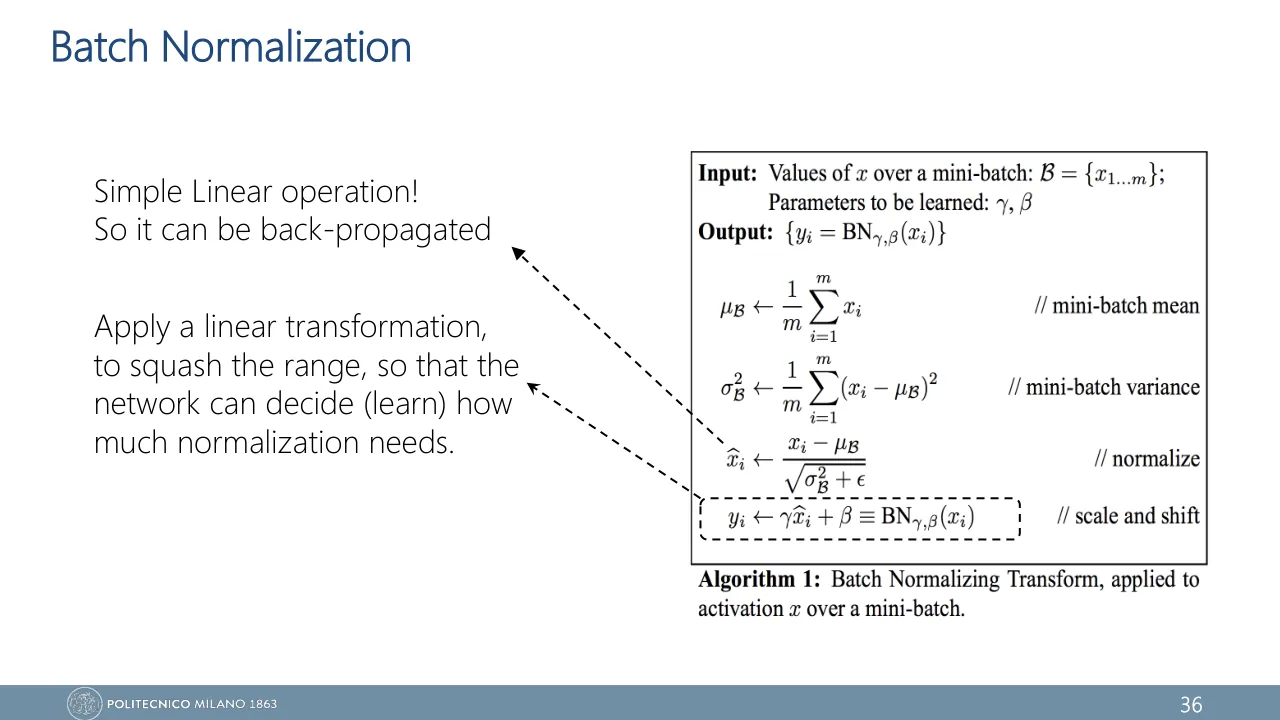
На слайде эта строка алгоритма обведена пунктиром, и стрелка от неё ведёт к пояснению: "Apply a linear transformation, to squash the range, so that the network can decide (learn) how much normalization needs" (лекция 3, слайд 36; в конце фразы пропущено слово, читай how much normalization it needs). Linear transformation здесь — умножение на \(\gamma\) и сдвиг на \(\beta\); строго говоря, такое преобразование называют аффинным. Squash the range — сжать размах значений, хотя растянуть его \(\gamma\) может так же легко. Главное в этой фразе — the network can decide (learn): сколько нормализации оставить, сеть решает сама. При \(\gamma = 1\), \(\beta = 0\) она остаётся полной.
Конспект показывает другой край (Example 4, стр. 190). Пусть до нормализации у нейрона было \(\mu = 2\), \(\sigma = 3\). Если сеть выучит \(\gamma = 3\), \(\beta = 2\), то
\[ y_i = 3 \cdot \frac{x_i - 2}{3} + 2 = x_i . \]Нормализация отменена полностью, вход вернулся таким, каким пришёл.
«Раз \(\gamma\) и \(\beta\) могут вернуть всё как было, BN ничего не делает». Делает. Раньше среднее и разброс входа нейрона получались как побочный результат всех весов всех предыдущих слоёв и гуляли вместе с ними. Теперь это два собственных числа нейрона. Предыдущие слои могут меняться как угодно: среднее выхода BN по mini-batch останется \(\beta\), разброс останется \(\gamma\), пока сам нейрон не решит их поменять. И оговорка к Example 4: равенство \(y_i = x_i\) точно выполняется только для mini-batch с такими же \(\mu_B\) и \(\sigma_B\). У следующего статистика чуть другая, а \(\gamma\) и \(\beta\) те же.
Слайд говорит о том же осторожнее конспекта: "Forces activations to take values on a unit Gaussian at the beginning of the training" (лекция 3, слайд 34). Слова at the beginning of the training точны: среднее 0 и дисперсия 1 на входе активации держатся, пока \(\gamma = 1\) и \(\beta = 0\), а дальше сеть двигает их сама. Слова unit Gaussian понимай как «среднее 0, дисперсия 1». Вычесть число и поделить на число — значит сдвинуть гистограмму и изменить её ширину, форма остаётся прежней: если значения \(x\) не были распределены нормально, не будут и \(\hat x\). На экзамене можно повторить формулировку слайда и добавить в скобках zero mean, unit variance.
Проверь себя на рисунке из конспекта. На рис. 22 (стр. 192) средняя панель подписана «After BN During Training». Гистограммы трёх mini-batch на ней совпали, но стоят они около −1, а не около нуля, и заметно шире распределения с дисперсией 1. Как это согласуется с «mean 0, variance 1»?
Проверить себя
На панели показан выход слоя \(y\), а не \(\hat x\). При \(\gamma \approx 2\) и \(\beta \approx -1\) картинка должна выглядеть именно так. Конспект об этих значениях молчит, поэтому рисунок и подпись кажутся несогласованными.
Где стоит слой
BN ставят между линейной частью слоя и функцией активации. На слайде: "after fully connected layers (or convolutional layers), and before nonlinearities", а на схеме рядом три блока, Fully Connected → Batch Norm → ReLU (лекция 3, слайд 34). Конспект называет тот же порядок Linear → Batch Norm → Activation.
\[ x^{(l)} = W^{(l)} h^{(l-1)} + b^{(l)} \] \[ y^{(l)} = \mathrm{BN}\bigl(x^{(l)}\bigr) \] \[ h^{(l)} = g\bigl(y^{(l)}\bigr) \]Здесь \(x^{(l)}\) — pre-activation слоя \(l\), то самое \(x\) из алгоритма; в конспекте это \(z^{(l)}\). Выход слоя конспект пишет как \(a^{(l)}\) — не путай с \(a\) из лекции 2, где так названа pre-activation. На слайдах выход скрытого слоя — \(h^{(l)}\) (лекция 2, слайд 17), и здесь он такой же.
У этой схемы два следствия, которых нет ни в конспекте, ни на слайдах. Смещение \(b\) перед BN бесполезно. И общий масштаб весов нейрона тоже ни на что не влияет — из этого вырастет одно из главных преимуществ слоя. Оба получаются в четыре строки.
-
Прибавим ко всем значениям нейрона одну и ту же константу \(b\). Среднее сдвинется на столько же:
\[ x'_i = x_i + b \quad\Rightarrow\quad \mu'_B = \mu_B + b \] -
Отклонения от среднего не изменились, значит, не изменились ни дисперсия, ни \(\hat x_i\):
\[ x'_i - \mu'_B = x_i - \mu_B \]Итог: \(\mathrm{BN}(x + b) = \mathrm{BN}(x)\). Смещение стёрто, его работу делает \(\beta\). Поэтому слой перед BN создают без смещения (в Keras
use_bias=False). -
Теперь умножим все значения на \(c \gt 0\): например, все веса нейрона выросли в \(c\) раз. Среднее и стандартное отклонение умножатся на то же число:
\[ \mu'_B = c\,\mu_B, \qquad \sigma'_B = c\,\sigma_B \] -
В дроби \(c\) сокращается (при пренебрежимо малом \(\epsilon\)):
\[ \hat x'_i = \frac{c\,x_i - c\,\mu_B}{c\,\sigma_B} = \hat x_i \]Итог: \(\mathrm{BN}(c\,x) = \mathrm{BN}(x)\). Масштаб весов тоже стёрт.
Пересдача в одиночку: training и inference
Вернёмся к студенту с пересдачи. В сети его ситуация называется inference (на слайдах — test time): модель обучена, и ей приносят один пример. Посчитай честно шаги 1–3 для mini-batch из единственного значения \(x_1 = 7\). Что выдаст слой?
Проверить себя
\(\mu_B = 7\), \(\sigma_B^2 = 0\), \(\hat x_1 = 0\), выход равен \(\beta\). Для любого входа. Слой выдаёт константу и ничего не сообщает о примере.
Дело не только в размере. Даже если на тест пришло сто примеров сразу, считать статистику по ним плохо: ответ для каждого зависел бы от того, кто оказался рядом. Один и тот же снимок давал бы разные предсказания в разной компании. На обучении такая зависимость терпима и даже полезна, это будет видно ниже. На inference она недопустима: предсказание должно быть функцией одного входа.
Разумный преподаватель достал бы архив: средний балл и разброс по всем прошлым потокам. BN делает то же. Пока идёт обучение, слой для каждого нейрона ведёт running averages (они же moving averages) — скользящие средние статистик всех mini-batch, которые через него прошли.
На слайде весь порядок работы слоя уместился в четыре строки под заголовком "In practice" (лекция 3, слайд 35):
- "During training, mean and stddev are computed for each minibatch". Это шаги 1 и 2; stddev (standard deviation) — корень из дисперсии, алгоритм делит на \(\sqrt{\sigma_B^2 + \epsilon}\).
- "Each unit's pre-activation is normalized (mean subtraction, stddev division)". Это шаг 3, для каждого нейрона отдельно.
- "Backpropagation takes into account normalization". Градиент идёт и через \(\mu_B\), и через \(\sigma_B\); об этом последний раздел урока.
- "At test time, the global mean / stddev are used (global statistics are estimated using training running averages)". Global statistics и есть архив: среднее и разброс не одного mini-batch, а всей обучающей выборки.
Как именно вести running averages, слайд не говорит. Формулы ниже — из конспекта.
\[ \mu_{\mathrm{run}} \leftarrow (1 - \alpha)\,\mu_{\mathrm{run}} + \alpha\,\mu_B \]
\[ \sigma^2_{\mathrm{run}} \leftarrow (1 - \alpha)\,\sigma^2_{\mathrm{run}} + \alpha\,\sigma_B^2 \]
- \(\mu_{\mathrm{run}},\ \sigma^2_{\mathrm{run}}\)
- накопленные оценки среднего и дисперсии; в конспекте индекс написан целиком: running
- \(\alpha\)
- маленькая константа, в конспекте 0.1: насколько сильно свежий mini-batch сдвигает оценку. Буква та же, что у momentum coefficient в уроке 27, но это другая величина
Это экспоненциальное сглаживание: свежие mini-batch весят больше, старые постепенно забываются. Пример на числах: \(\mu_{\mathrm{run}}\) стартует с нуля, а каждый mini-batch даёт \(\mu_B = 4\). После первого шага оценка равна 0.4, после второго 0.76, после третьего 1.08, после десятого 2.61, после двадцать второго 3.61. Общая формула: \(\mu_{\mathrm{run}} = 4\,(1 - 0.9^k)\). Архиву нужно несколько десятков шагов, чтобы наполниться.
На inference эти два числа замораживают и подставляют вместо статистики mini-batch:
\[ y = \gamma\,\frac{x - \mu_{\mathrm{run}}}{\sqrt{\sigma^2_{\mathrm{run}} + \epsilon}} + \beta \]Всё, кроме \(x\), здесь константы. Никакой зависимости от соседей, никакой случайности.
Training: статистика этого mini-batch
Inference: замороженный архив
Если раскрыть скобки, на inference весь слой BN оказывается обычной прямой:
\[ y = a\,x + c \] \[ a = \frac{\gamma}{\sqrt{\sigma^2_{\mathrm{run}} + \epsilon}}, \qquad c = \beta - a\,\mu_{\mathrm{run}} \]Буквы \(a\) и \(c\) здесь — просто два числа, наклон и сдвиг прямой; с \(a\) из лекции 2 они не связаны. Умножить на число и прибавить число умеет и сам линейный слой. Поэтому после обучения \(a\) и \(c\) можно заранее вмонтировать в веса и смещение предыдущего слоя, и на inference BN не будет стоить ничего.
«Режим переключится сам». Не всегда. В PyTorch его переключают вручную: model.eval() перед предсказанием, model.train() перед обучением. В Keras fit() и predict() выбирают режим сами, но при прямом вызове model(x) его задаёт аргумент training. Типичный симптом забытого переключения: модель с BN хорошо обучилась, а ответ для одного и того же примера меняется в зависимости от того, с чем его подали.
Вот и ответ на задачку из начала урока. Поток из одного студента по кривой оценить нельзя: получится ноль. Его оценивают по архиву прошлых потоков. Слой BN ведёт такой архив всё обучение и на inference пользуется только им.
Что BN даёт и чего стоит
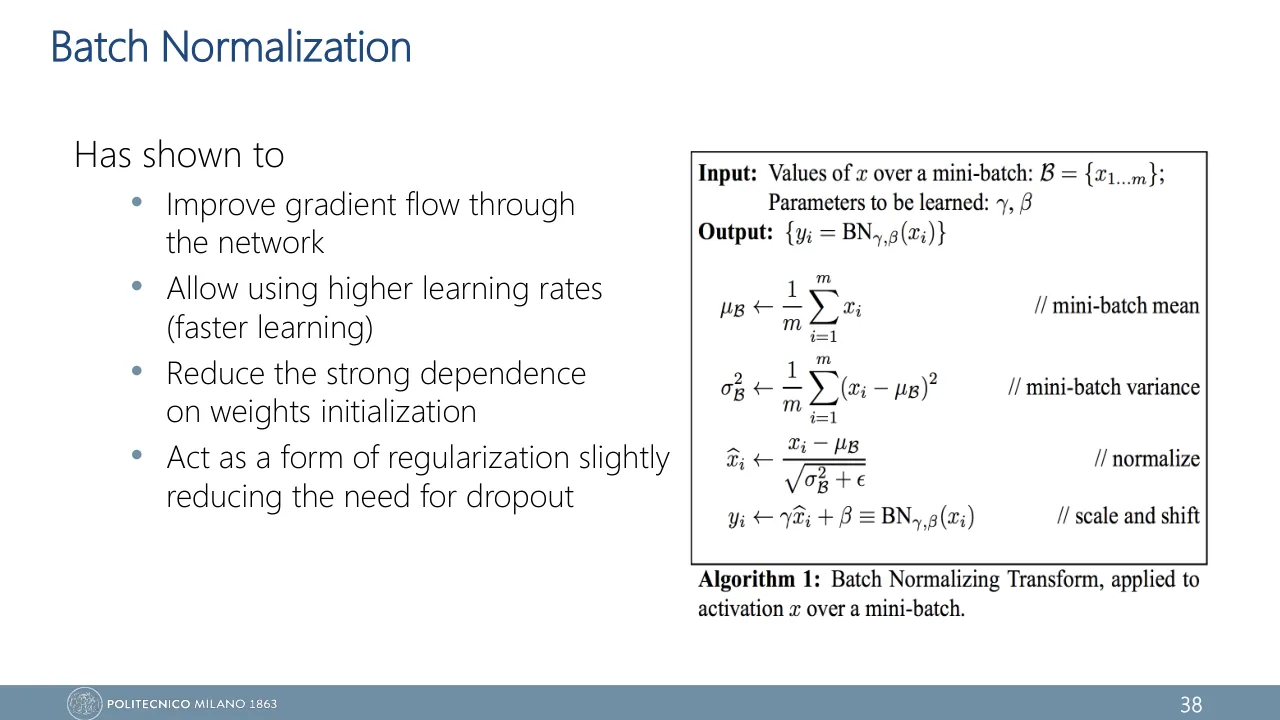
На слайде четыре преимущества под заголовком "Has shown to" (лекция 3, слайд 37; в углу самого слайда напечатано 38). За каждым стоит механизм, который в этом уроке уже был.
- "Improve gradient flow through the network". Вход активации держится в рабочей зоне: на стенде доля насыщенных примеров упала с 67.5 % до 4.5 %. Градиенту есть через что проходить. В конспекте этот пункт назван Stabilizes training.
- "Allow using higher learning rates (faster learning)". \(\mathrm{BN}(c\,x) = \mathrm{BN}(x)\): если шаг вышел слишком большим и веса нейрона выросли в \(c\) раз, выход слоя не изменится, а градиент по этим весам станет в \(c\) раз меньше. Слой сам гасит раскачку. В конспекте: Allows higher learning rates.
- "Reduce the strong dependence on weights initialization". Масштаб сигнала на входе активации задают \(\gamma\) и \(\beta\), а не начальные веса. Xavier и He из урока 25 по-прежнему полезны, но промах в них перестаёт быть роковым. В конспекте: Reduces sensitivity to initialization.
- "Act as a form of regularization slightly reducing the need for dropout". На обучении выход для примера зависит от случайных соседей по mini-batch. Этот шум мешает сети заучивать отдельные примеры и немного (на слайде — slightly) снижает потребность в dropout из урока 23: совсем dropout он не заменяет. В конспекте: Regularization effect.
В конспекте пунктов пять. Пятый, Improves convergence speed, — общий итог первых четырёх: отсюда «в 14 раз меньше шагов» из статьи. На слайдах ему отвечают слова faster learning во втором пункте и converge faster в первой фразе темы (лекция 3, слайд 33).
Почему градиент уменьшается, когда веса растут?
Пусть \(x = \vb{w}\T\vb{h}\), и все веса нейрона умножили на \(c \gt 0\). Выход BN не изменился, значит, не изменилась и ошибка: \(E(c\,\vb{w}) = E(\vb{w})\) при любом \(\vb{w}\). Продифференцируем обе части по \(\vb{w}\):
\[ c\,\nabla E(c\,\vb{w}) = \nabla E(\vb{w}) \] \[ \nabla E(c\,\vb{w}) = \frac{1}{c}\,\nabla E(\vb{w}) \]Веса в \(c\) раз длиннее — градиент в \(c\) раз короче. Без BN большой шаг раздувает веса, а те раздувают следующий градиент. С BN обратная связь отрицательная.
BN — обычная дифференцируемая операция, и backpropagation проходит через неё по цепному правилу. Особенность одна: \(\mu_B\) и \(\sigma_B\) сами зависят от всех примеров mini-batch, поэтому градиент идёт и через них. На слайде это строка "Backpropagation takes into account normalization" (лекция 3, слайд 35).
На следующем слайде от строки normalize идёт стрелка к подписи "Simple Linear operation! So it can be back-propagated" (лекция 3, слайд 36). Буквально её понимать не стоит. Вычесть число и поделить на число — линейная операция, пока эти числа постоянны, как на inference. На обучении \(\mu_B\) и \(\sigma_B\) сами считаются по тем же \(x_i\), а в \(\sigma_B\) сидят квадраты и корень. Проверка: удвой все \(x_i\) — и \(\hat x_i\) не изменятся вовсе (при пренебрежимо малом \(\epsilon\)), чего с линейной операцией не бывает. Для backpropagation линейность и не нужна, хватает дифференцируемости; точное слово стоит на слайде 34: in a differentiable way.
Для двух новых параметров формулы короткие, они прямо следуют из \(y_i = \gamma \hat x_i + \beta\):
\[ \pd{E}{\beta} = \sum_{i=1}^{m} \pd{E}{y_i} \] \[ \pd{E}{\gamma} = \sum_{i=1}^{m} \pd{E}{y_i}\,\hat x_i \]А как выглядит градиент по самому входу \(x_i\)?
Обозначим \(g_i = \pd{E}{y_i}\). Значение \(x_i\) влияет на ошибку тремя путями: через свой \(\hat x_i\), через \(\mu_B\) и через \(\sigma_B\). Два последних входят в выход каждого примера. Если сложить все три пути (при пренебрежимо малом \(\epsilon\)), получится
\[ \pd{E}{x_i} = \frac{\gamma}{\sigma_B}\Bigl( g_i - \bar g - \hat x_i\,\overline{g \hat x} \Bigr) \]Черта означает среднее по mini-batch: \(\bar g\) — среднее всех \(g_k\), а \(\overline{g \hat x}\) — среднее произведений \(g_k \hat x_k\). Из пришедшего градиента BN вычитает его среднее и его составляющую вдоль \(\hat x\). Это те самые два направления, которые нормализация всё равно стёрла бы: общий сдвиг и общий масштаб. Главная мысль короче формулы: на обратном проходе \(\mu_B\) и \(\sigma_B\) не считаются константами.
Сколько параметров добавляет слой
На каждый нейрон (в свёрточной сети — на каждый канал) BN хранит четыре числа.
| Число | Роль | Кто его меняет | Тип |
|---|---|---|---|
| \(\gamma\) | scale | gradient descent | trainable |
| \(\beta\) | shift | gradient descent | trainable |
| \(\mu_{\mathrm{run}}\) | running mean | формула (79) | non-trainable |
| \(\sigma^2_{\mathrm{run}}\) | running variance | формула (80) | non-trainable |
BN после полносвязного слоя из 64 нейронов — это \(4 \cdot 64 = 256\) чисел, из них 128 обучаемых и 128 необучаемых. Вопросы на счёт параметров ловят на двух неверных ответах: «у BN параметров нет» и «все параметры BN обучаемые».
Где BN подводит
Всё держится на том, что статистика mini-batch — хорошая оценка статистики всей выборки. Среднее по \(m\) примерам шумит со стандартной ошибкой \(\sigma / \sqrt{m}\). При \(m = 32\) это \(0.18\,\sigma\), терпимо. При \(m = 4\) уже \(0.5\,\sigma\): центр промахивается на половину разброса самих значений. При \(m = 2\) нормализованные значения всегда равны \(\pm 1\). При \(m = 1\) слой выдаёт константу \(\beta\). Маленькие mini-batch и BN плохо совместимы.
В формате экзамена
Write the Batch Normalization transform applied to the pre-activations \(x_1, \dots, x_m\) of one unit over a mini-batch (a) at training time and (b) at test time. Explain why the learnable parameters \(\gamma\) and \(\beta\) are introduced.
Show model answer
(a) Training: mean and stddev are computed for each mini-batch, separately for each unit; the unit's pre-activation is normalized (mean subtraction, stddev division), then scaled and shifted.
\[ \mu_B = \frac{1}{m}\sum_{i=1}^{m} x_i \] \[ \sigma_B^2 = \frac{1}{m}\sum_{i=1}^{m}(x_i - \mu_B)^2 \] \[ \hat x_i = \frac{x_i - \mu_B}{\sqrt{\sigma_B^2 + \epsilon}} \] \[ y_i = \gamma\,\hat x_i + \beta \equiv \mathrm{BN}_{\gamma,\beta}(x_i) \]Backpropagation takes the normalization into account. Meanwhile running averages are updated: \(\mu_{\mathrm{run}} \leftarrow (1-\alpha)\mu_{\mathrm{run}} + \alpha\mu_B\), and the same for \(\sigma^2_{\mathrm{run}}\).
(b) Test: the global mean / stddev are used instead of the mini-batch ones; these global statistics are the running averages estimated during training. They are frozen, so the output is a deterministic function of the single input and does not depend on the other samples.
\[ y = \gamma\,\frac{x - \mu_{\mathrm{run}}}{\sqrt{\sigma^2_{\mathrm{run}} + \epsilon}} + \beta \]\(\gamma\) and \(\beta\): normalisation alone would force every unit to zero mean and unit variance and would limit the representational power of the layer. The scale and shift step is a linear transformation that lets the network decide (learn) how much normalization it needs: it can give each unit any mean and scale, and even undo the normalisation with \(\gamma = \sigma\), \(\beta = \mu\). These become two directly learnable quantities, decoupled from the weights of the preceding layers.
В полном ответе четыре вещи: все четыре шага с \(\epsilon\) под корнем; слова «for each unit, over the mini-batch»; другой источник статистики на тесте; и объяснение, зачем нужны \(\gamma\), \(\beta\). Слова слайдов, которые стоит повторить: "global mean / stddev", "running averages", "the network can decide (learn) how much normalization" (лекция 3, слайды 35–36). Фраза «to restore the original distribution» сама по себе ничего не объясняет: скажи про representational power.
During training a unit receives the mini-batch of pre-activations \(x = (2,\ 4,\ 4,\ 6)\). Its Batch Normalization parameters are \(\gamma = 3\), \(\beta = -1\); neglect \(\epsilon\). Compute the output of the BN layer for the sample with \(x = 6\).
Show model answer
\[ \mu_B = \frac{2 + 4 + 4 + 6}{4} = 4 \]
\[ \sigma_B^2 = \frac{4 + 0 + 0 + 4}{4} = 2, \quad \sigma_B = 1.414 \]
\[ \hat x = \frac{6 - 4}{1.414} = 1.414 \]
\[ y = 3 \cdot 1.414 - 1 = 3.243 \]
Две типичные потери: деление на \(m - 1\) (тогда \(\sigma_B^2 = 2.67\) и ответ 2.674) и забытый корень (деление на дисперсию 2 вместо 1.414 даёт ровно 2).
A fully connected layer with 64 units is followed by a Batch Normalization layer. How many trainable parameters does the Batch Normalization layer add to the model?
Show model answer
One \(\gamma\) and one \(\beta\) per unit: \(2 \cdot 64 = 128\) trainable parameters. The layer also stores a running mean and a running variance per unit, \(2 \cdot 64 = 128\) non-trainable parameters, 256 in total.
Смотри на слово в вопросе: trainable — 128, total — 256. Число входов слоя на ответ не влияет.
Which statements about Batch Normalization at inference (test) time are correct? Select all that apply.
Show model answer
Correct: the first, the third and the fifth. At test time the global statistics estimated with running averages are used: \(y = \gamma (x - \mu_{\mathrm{run}}) / \sqrt{\sigma^2_{\mathrm{run}} + \epsilon} + \beta\), where everything except \(x\) is a constant fixed after training.
Вопрос проверяет одну идею с трёх сторон: на тесте BN детерминирован. Если понятна причина, все пять вариантов решаются без запоминания.
The running mean of a Batch Normalization layer is initialised to 0 and updated as \(\mu_{\mathrm{run}} \leftarrow (1 - \alpha)\mu_{\mathrm{run}} + \alpha \mu_B\) with \(\alpha = 0.1\). The first three mini-batches have mini-batch means 2, 6 and 4. Compute the running mean after the third update.
Show model answer
\[ 0.9 \cdot 0 + 0.1 \cdot 2 = 0.2 \]
\[ 0.9 \cdot 0.2 + 0.1 \cdot 6 = 0.78 \]
\[ 0.9 \cdot 0.78 + 0.1 \cdot 4 = 1.102 \]
Ответ далёк от настоящего среднего 4: скользящее среднее стартует с нуля и разгоняется медленно. Если в задаче \(\alpha\) стоит при старом значении, а не при новом, — это запись Keras; прочитай формулу в условии.
A fully connected layer computes the pre-activations \(x = W h + b\) and is followed by Batch Normalization. (a) Why is the bias \(b\) redundant? (b) Why does Batch Normalization work poorly with very small mini-batches, and what is its output for a mini-batch of a single sample at training time?
Show model answer
(a) BN subtracts the mini-batch mean. Adding the same constant \(b\) to every \(x_i\) shifts \(\mu_B\) by \(b\) and leaves \(x_i - \mu_B\) and \(\sigma_B^2\) unchanged, so \(\mathrm{BN}(x + b) = \mathrm{BN}(x)\). The shift is provided by \(\beta\) instead.
(b) \(\mu_B\) and \(\sigma_B^2\) are estimates from \(m\) samples; their noise grows as \(m\) decreases (standard error \(\sigma/\sqrt{m}\)), so the output for a sample depends strongly on its random companions, and the running averages become noisy as well. With \(m = 1\): \(\mu_B = x\), \(\sigma_B^2 = 0\), \(\hat x = 0\), so the output is \(\beta\) for every input.
В (a) нужна одна строка алгебры, а не слова «BN нормализует». В (b) нужны слова noisy estimates и конкретный ответ «\(\beta\)» для одного примера.
What is internal covariate shift, and how does Batch Normalization cope with it? State where the Batch Normalization layer is placed in the network.
Show model answer
Networks converge faster if their inputs have been whitened (zero mean, unit variances) and are uncorrelated. The same issue appears inside the network: during training the distribution of the inputs of each hidden layer keeps changing, because the weights of the preceding layers are updated. This is internal covariate shift, so normalization is useful also at the level of hidden layers.
Batch Normalization normalizes each unit's pre-activation with the mean and stddev of the current mini-batch. This forces the activations to take values on a unit Gaussian (zero mean, unit variance) at the beginning of the training; a learnable scale \(\gamma\) and shift \(\beta\) then let the network decide how much normalization it needs. The BatchNorm layer is added after fully connected (or convolutional) layers and before the nonlinearities: Fully Connected → Batch Norm → ReLU. It can be interpreted as doing preprocessing at every layer of the network, but integrated into the network itself in a differentiable way.
Ответ собран из формулировок слайдов 33–34 лекции 3: их стоит узнавать и уметь повторить. Covariate shift без слова internal — другое явление: распределение входов сети на обучении и на тесте разное.
List four effects that Batch Normalization has been shown to have on the training of a network, and give a one-sentence reason for each.
Show model answer
1. It improves the gradient flow through the network: the pre-activations stay in the non-saturating range of the nonlinearity, so the gradients do not vanish.
2. It allows using higher learning rates (faster learning): the layer output does not depend on the scale of the incoming weights, \(\mathrm{BN}(c\,x) = \mathrm{BN}(x)\) for any \(c \gt 0\), and larger weights get smaller gradients.
3. It reduces the strong dependence on weight initialization: the scale of the signal entering the nonlinearity is set by \(\gamma\) and \(\beta\), not by the initial weights.
4. It acts as a form of regularization, slightly reducing the need for dropout: at training time the output for a sample depends on the other samples of its mini-batch, which adds noise.
Четыре пункта — это список "Has shown to" (лекция 3, слайд 37). Причин на слайде нет, они из этого урока; без них ответ превращается в перечисление. Пятому пункту конспекта, Improves convergence speed, на слайде отвечает скобка faster learning.
Проверь себя
В слое 5 нейронов, в mini-batch 8 примеров. Сколько значений \(\mu_B\) посчитает BN на одном шаге обучения?
Слой BN с \(\gamma = 2\), \(\beta = -1\) работает в режиме training. Чему равны среднее и стандартное отклонение его выхода по mini-batch?
Почему на inference BN не берёт статистику текущего batch? Отметь все верные причины.
Картинка для памяти: пересдающего оценивают по архиву, а не по нему самому.
Что такое internal covariate shift?
В mini-batch два примера: \(x = (3,\ 9)\). Чему равны \(\hat x\) при пренебрежимо малом \(\epsilon\)?
Ко всем смещениям \(b\) слоя, стоящего перед BN, прибавили 10. Что произойдёт с выходом BN в режиме training?
Унести с собой
- Internal covariate shift — распределение входов скрытого слоя меняется в ходе обучения, потому что меняются веса перед ним. Covariate shift без internal — это про разницу между обучением и тестом.
- BN для каждого нейрона по mini-batch считает \(\mu_B\) и \(\sigma_B^2\), нормализует и применяет \(y = \gamma \hat x + \beta\). Место слоя: после fully connected или convolutional слоя, перед нелинейностью — Fully Connected → Batch Norm → ReLU.
- \(\gamma\) и \(\beta\) обучаемые: среднее и разброс входа активации становятся собственными параметрами нейрона и перестают зависеть от предыдущих слоёв.
- На обучении статистику дают соседи по mini-batch, и попутно копятся running averages. На inference используются только они, замороженные (на слайде 35 лекции 3 — global mean / stddev): слой становится прямой \(y = ax + c\).
- Четыре эффекта со слайда 37 лекции 3: лучше gradient flow, выше допустимый learning rate, слабее зависимость от инициализации весов, лёгкая регуляризация. Механизм второго: BN стирает общий масштаб своего входа, поэтому рост весов уменьшает градиент. Общий сдвиг он стирает тоже, поэтому смещение перед BN не нужно.
- На нейрон четыре числа: \(\gamma\), \(\beta\) (trainable) и \(\mu_{\mathrm{run}}\), \(\sigma^2_{\mathrm{run}}\) (non-trainable). Маленький mini-batch даёт шумную статистику; один пример в режиме training даёт константу \(\beta\).
Что посмотреть и почитать
-
Lecture 6 | Training Neural Networks I
Stanford CS231n, Spring 2017
Лекция на английском, где BN идёт сразу после инициализации, с гистограммами активаций по слоям. Смотри часть про batch normalization рядом с разделом о четырёх шагах: те же формулы, произнесённые вслух на языке экзамена.
-
Building makemore Part 3: Activations & Gradients, BatchNorm
Andrej Karpathy1 ч 55 мин
Настоящая сеть ломается и чинится в том же порядке, что в уроках 24–26: насыщение tanh, инициализация, затем слой BatchNorm, написанный с нуля, вместе с running mean и running variance для inference.
-
Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift
Sergey Ioffe, Christian Szegedy, 2015
Источник, на который ссылается конспект; рамка с алгоритмом на слайдах 35–37 лекции 3 — это Algorithm 1 из этой статьи. Читать стоит два места: Algorithm 1 — это четыре шага, Algorithm 2 — разница между обучением и inference.
-
How Does Batch Normalization Help Optimization?
Santurkar, Tsipras, Ilyas, Madry, 2018
Та самая работа, которая оспаривает объяснение через internal covariate shift. Материал сверх слайдов: достаточно аннотации и введения, чтобы при желании уверенно сказать на экзамене одну фразу о споре.