По рассказу самого Джеффри Хинтона, идея пришла к нему в банке. Он заметил, что кассиры в его отделении всё время меняются, и решил: так банк мешает сотрудникам сговориться, ведь для мошенничества нужна кооперация. Случайно убирать разные нейроны на каждом примере значит точно так же мешать «сговору» нейронов. В статье 2014 года образ остался: десять заговоров по пять человек, скорее всего, наделают больше бед, чем один заговор на пятьдесят. Когда условия всё время меняются, у маленького заговора больше шансов сработать.
Тренировка с отсутствующими
После этого урока ты по активациям слоя, маске и вероятности \(p\) выпишешь, что слой отдаёт на обучении и на тесте в обоих вариантах dropout, и двумя способами объяснишь, почему выключенные нейроны помогают сети обобщать.
Тренер перед каждой тренировкой бросает монетку за каждого игрока. Решка — сегодня сидишь дома. Состав каждый раз новый, и заранее его никто не знает. В день матча выходят все.
Здесь две странности. Первая: команда, которой так мешали, играет лучше той, что всегда тренировалась полным составом. Вторая: в день матча на площадке заметно больше игроков, чем обычно приходило на тренировку. Если каждый сыграет в привычную силу, получится перебор.
Это не выдумка. В 2012 году так обучали сеть AlexNet: в первых двух полносвязных слоях каждый нейрон на каждом шаге выключался с вероятностью 0.5. Приём называется dropout. К концу урока обе странности превратятся в две короткие формулы.
Нейроны, которые привыкли друг к другу
В блоке про переобучение уже есть два приёма. Early stopping ограничивает, сколько сеть учится. Weight decay ограничивает, насколько большими вырастают веса. Но большая сеть умеет зубрить и третьим способом, которого эти двое не замечают.
Представь нейрон A, который выучил: «когда нейрон B активен, отвечай так-то». Сам по себе A почти ничего не умеет, он только подправляет B. Если B запомнил шум обучающей выборки, A унаследует его ошибку. Такая взаимная подгонка называется co-adaptation (коадаптация): нейроны полезны только в одной конкретной компании.
До: B всегда на месте
После: сегодня B выключен
Лекарство простое и грубое: не давать нейрону рассчитывать ни на кого. На каждом шаге обучения часть нейронов случайно выключают, то есть их выход принудительно делают нулём. Сегодня B есть, завтра его нет, и A вынужден извлекать пользу из любого набора соседей. Одно и то же знание сеть теперь хранит в нескольких местах сразу; конспект называет это redundant representations (избыточные представления).
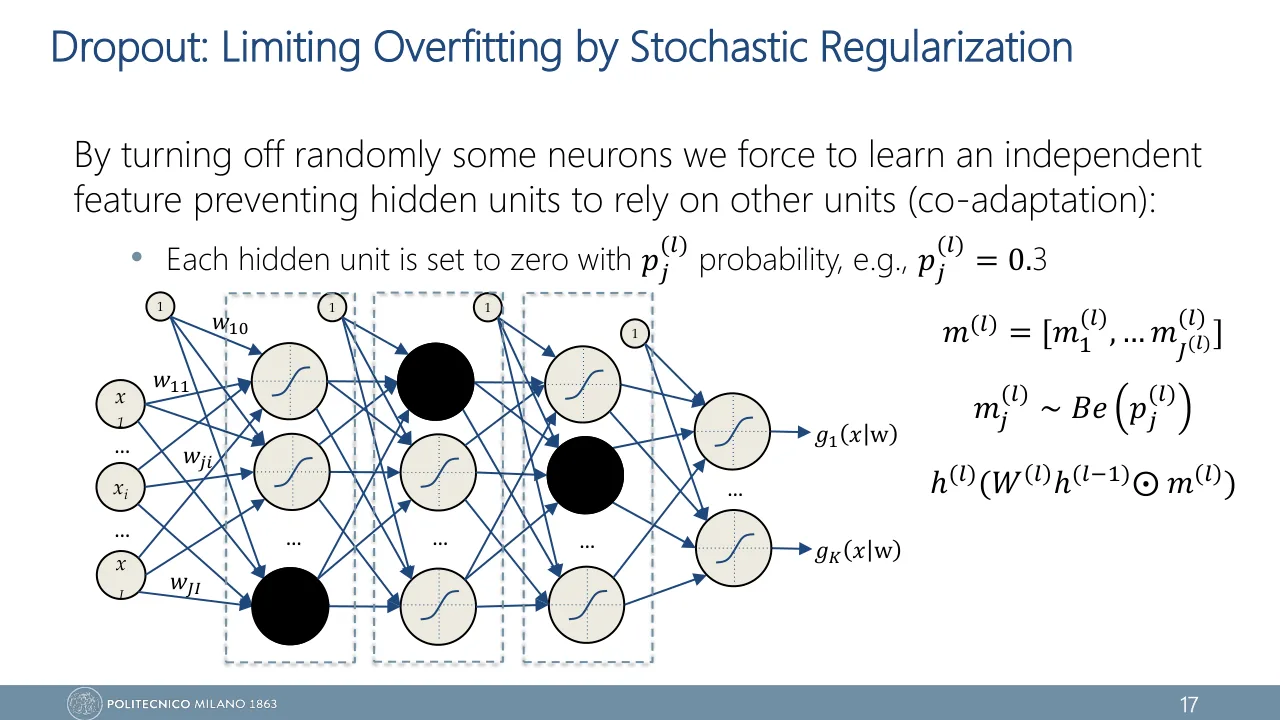
У лектора та же мысль уложена в одну фразу (лекция 3, слайд 17): "By turning off randomly some neurons we force to learn an independent feature preventing hidden units to rely on other units (co-adaptation)". Два оборота из неё стоит узнавать с первого взгляда. Independent feature — признак, полезный сам по себе. Rely on other units — то самое «A слушает только B».
Dropout — приём регуляризации: во время обучения каждый нейрон независимо от остальных выключается (его выход обнуляется) с вероятностью \(1 - p\), где \(p\) — вероятность оставить нейрон. На каждом шаге набор выключенных новый. На тесте работают все нейроны.
Сравни с weight decay. Там к функции ошибки, error function \(E(w)\), прибавляли штраф. Здесь к \(E(w)\) ничего не прибавляют: шум вносится прямо в выходы нейронов. Поэтому и раздел конспекта, и слайды называют приём stochastic regularization — регуляризация случайностью. Заголовок слайдов 17–22 лекции 3: "Dropout: Limiting Overfitting by Stochastic Regularization".
Маска: монетка для каждого нейрона
Сначала обычный слой, без dropout. Нейрон \(j\) слоя \(l\) складывает выходы предыдущего слоя с весами и пропускает сумму через функцию активации (activation function):
\[ h_j^{(l)} = g\Big(\sum_{i} w_{ji}^{(l)}\, h_i^{(l-1)} + w_{j0}^{(l)}\Big) \]
- \(h_i^{(l-1)}\)
- выходы предыдущего слоя
- \(w_{ji}^{(l)}\)
- вес связи в нейрон \(j\) из нейрона \(i\)
- \(w_{j0}^{(l)}\)
- bias нейрона \(j\)
- \(g(\cdot)\)
- activation function, например tanh или сигмоида
Dropout добавляет каждому нейрону одну случайную величину — маску \(m_j^{(l)}\). Это монетка: единица с вероятностью \(p\), ноль иначе. В статистике такая величина называется бернуллиевской; на слайдах курса распределение Бернулли пишется \(Be(p)\), и маска записана так же (лекция 3, слайд 17).
\[ m_j^{(l)} \sim Be(p) \]
\[ P\big(m_j^{(l)} = 1\big) = p \]
\[ P\big(m_j^{(l)} = 0\big) = 1 - p \]
\[ \tilde h_j^{(l)} = m_j^{(l)} \cdot h_j^{(l)} \]
- \(m_j^{(l)} = 1\)
- нейрон оставлен (kept)
- \(m_j^{(l)} = 0\)
- нейрон выключен (dropped)
- \(p\)
- вероятность оставить нейрон (keep probability)
- \(\tilde h_j^{(l)}\)
- post-dropout activation: то, что на самом деле уходит в следующий слой
Для слоя целиком то же пишут одной строкой: \(\tilde{\vb{h}}^{(l)} = \vb{m}^{(l)} \odot \vb{h}^{(l)}\), где \(\odot\) — поэлементное умножение. Следующий слой получает уже не \(h_j^{(l)}\), а \(\tilde h_j^{(l)}\). Его нейрон \(k\) считает:
\[ h_k^{(l+1)} = g\Big(\sum_{j} w_{kj}^{(l+1)}\, \tilde h_j^{(l)} + w_{k0}^{(l+1)}\Big) \]Вот пример из конспекта (Example 3, стр. 175): пять нейронов, \(p = 0.6\), монетки выпали как [1, 0, 1, 0, 1].
Три свойства маски, которые легко упустить.
- Она новая на каждом шаге. В библиотеках у каждого примера в mini-batch маска своя. На слайде 21 сказано проще, "on different mini-batches": новая маска на каждый mini-batch.
- Она одна и та же в forward pass и в backward pass. Выключенный нейрон ничего не передал вперёд, поэтому и назад через него ничего не идёт: его входящие и исходящие веса на этом примере не обновляются.
- Она не трогает выходной слой и bias. Выключить выход значит выбросить сам ответ сети. На рисунках слайдов 17–22 закрашены чёрным только скрытые нейроны, по одному в слое; входы, узлы «1» и выходы на месте.
Из курса статистики про такую монетку известно всё нужное: \(\E[m] = p\) и \(\mathrm{Var}[m] = p(1 - p)\). Отсюда \(\mathrm{Var}[\tilde h_j] = p(1 - p)\,h_j^2\). Шум от dropout умножается на саму активацию и исчезает при \(p = 1\). В абсолютных числах дисперсия наибольшая при \(p = 0.5\). Но среднее \(p\,h_j\) тоже падает вместе с \(p\), и по отношению к нему разброс растёт всё время, пока \(p\) уменьшается: чем меньше \(p\), тем сильнее регуляризация.
Та же маска на слайде
У лектора маска и слой с dropout занимают три строки (лекция 3, слайд 17):
\[ m^{(l)} = \big[m_1^{(l)}, \dots, m_{J^{(l)}}^{(l)}\big] \]
\[ m_j^{(l)} \sim Be\big(p_j^{(l)}\big) \]
\[ h^{(l)}\big(W^{(l)} h^{(l-1)} \odot m^{(l)}\big) \]
- \(J^{(l)}\)
- число нейронов слоя \(l\): в маске по одной монетке на нейрон
- \(p_j^{(l)}\)
- вероятность своя у каждого нейрона; в уроке и в конспекте она общая для слоя и пишется без индексов. Что это за вероятность — сразу ниже
- \(W^{(l)}\)
- матрица весов слоя \(l\); bias уже в ней, это веса от узла «1»
- \(h^{(l)}(\cdot)\)
- функция активации слоя \(l\); той же буквой на слайдах назван и его выход. В формуле конспекта функция названа \(g\)
Третья строка — выход слоя \(l\): функция активации, а в её скобках взвешенные суммы и маска. В конспекте маска стоит снаружи, на выходе нейрона. Скобок вокруг произведения на слайде нет, поэтому строку можно прочитать двумя способами.
- Маска умножает выходы предыдущего слоя: \(W^{(l)}\big(h^{(l-1)} \odot m^{(l)}\big)\). Это та же запись, что в формуле для \(h_k^{(l+1)}\) выше, только маска носит номер слоя, который её получает, а не слоя, который она прореживает.
- Маска умножает взвешенные суммы самого слоя \(l\): \(\big(W^{(l)} h^{(l-1)}\big) \odot m^{(l)}\). На это указывает число компонент: в \(m^{(l)}\) их \(J^{(l)}\), как нейронов в слое \(l\). Выключенный нейрон тогда отдаёт \(g(0)\): для tanh и ReLU это ноль, а для сигмоиды 0.5.
Что имеется в виду, говорит текст того же слайда: "Each hidden unit is set to zero". На экзамене годится и строка слайда как есть. Но считать надёжнее с маской на выходе нейрона, \(\tilde h_j^{(l)} = m_j^{(l)} h_j^{(l)}\): так он обнуляется при любой функции активации, и на этой записи построены все расчёты ниже.
Что именно называется \(p\)
Главная ловушка темы — сама буква \(p\). В конспекте и в исходной статье \(p\) — вероятность оставить нейрон. В Keras и PyTorch число в скобках Dropout(0.2) — вероятность выключить, drop rate, то есть \(1 - p\). Вероятность выключить названа и в тексте слайда (лекция 3, слайд 17): "Each hidden unit is set to zero with \(p_j^{(l)}\) probability, e.g., \(p_j^{(l)} = 0.3\)". При этом формула на том же слайде с его текстом расходится, а конспект путает эти два числа дважды.
«На слайде 17 лекции 3 \(m_j^{(l)} \sim Be(p_j^{(l)})\) и \(p_j^{(l)} = 0.3\), значит единица в маске выпадает с вероятностью 0.3». По формуле так и выходит: \(Be(p)\) равна 1 с вероятностью \(p\), а нейрон с единицей в маске остаётся. Но в тексте того же слайда 0.3 — вероятность нейрон обнулить. Прочитанные буквально, текст и формула спорят: по тексту выключаются 30 % нейронов, по формуле 70 %.
Имеется в виду текст. Так и нарисовано: в каждом скрытом слое закрашен один нейрон из трёх нарисованных. Монетка, на которую умножают, тогда \(Be\big(1 - p_j^{(l)}\big)\): единица с вероятностью 0.7. С буквой урока слайд связан так: \(p = 1 - p_j^{(l)}\). Слайдовое 0.3 — это drop rate, в формулах урока ему отвечает \(p = 0.7\).
На экзамене не пиши голое «dropout 0.3» и не оставляй букву \(p\) без слов. Пиши словами: «keep probability 0.7» или «each unit is dropped with probability 0.3». Если нужна формула, первой строкой скажи, что значит твоя буква, и подбери монетку под неё: "each unit is kept with probability \(p\), so \(m_j \sim Be(p)\)" или, словами слайда, "each unit is set to zero with probability \(p\), so \(m_j \sim Be(1 - p)\)". Так ответ верен при любом из двух соглашений.
А в условии задачи первым делом найди, какой из двух вариантов там назван \(p\). Если написано «each unit is set to zero with probability 0.3», как на слайде 17 лекции 3, то в формулах этого урока \(p = 0.7\).
Одна сеть, а внутри тысячи
Посмотри на маску иначе. Вычеркнутые нейроны исчезают вместе со своими связями, и остаётся сеть поменьше — thinned network (прореженная сеть). Каждая маска задаёт свою прореженную сеть. Если выключать можно \(n\) нейронов, то масок \(2^n\): каждый нейрон либо есть, либо нет.
Для пяти нейронов из примера это \(2^5 = 32\) сети, для десяти — 1024, для слоя из тысячи нейронов — число из 302 цифр. Вероятность конкретной маски, в которой оставлено \(k\) нейронов из \(n\):
\[ P(m) = p^{\,k}\,(1 - p)^{\,n - k} \]Маска [1, 0, 1, 0, 1] при \(p = 0.6\) выпадает с вероятностью \(0.6^3 \cdot 0.4^2 \approx 0.035\).
Теперь главное. Все эти сети делят одни и те же веса: вес между двумя нейронами один, в какой бы прореженной сети они ни встретились. Каждый шаг обучения берёт одну случайную сеть из \(2^n\) и немного её подучивает. А на тесте хочется получить ответ, усреднённый по всем сразу. Усреднение многих моделей называется ensemble (ансамбль). Оно уменьшает переобучение: ошибки отдельных моделей смотрят в разные стороны и частично гасят друг друга.
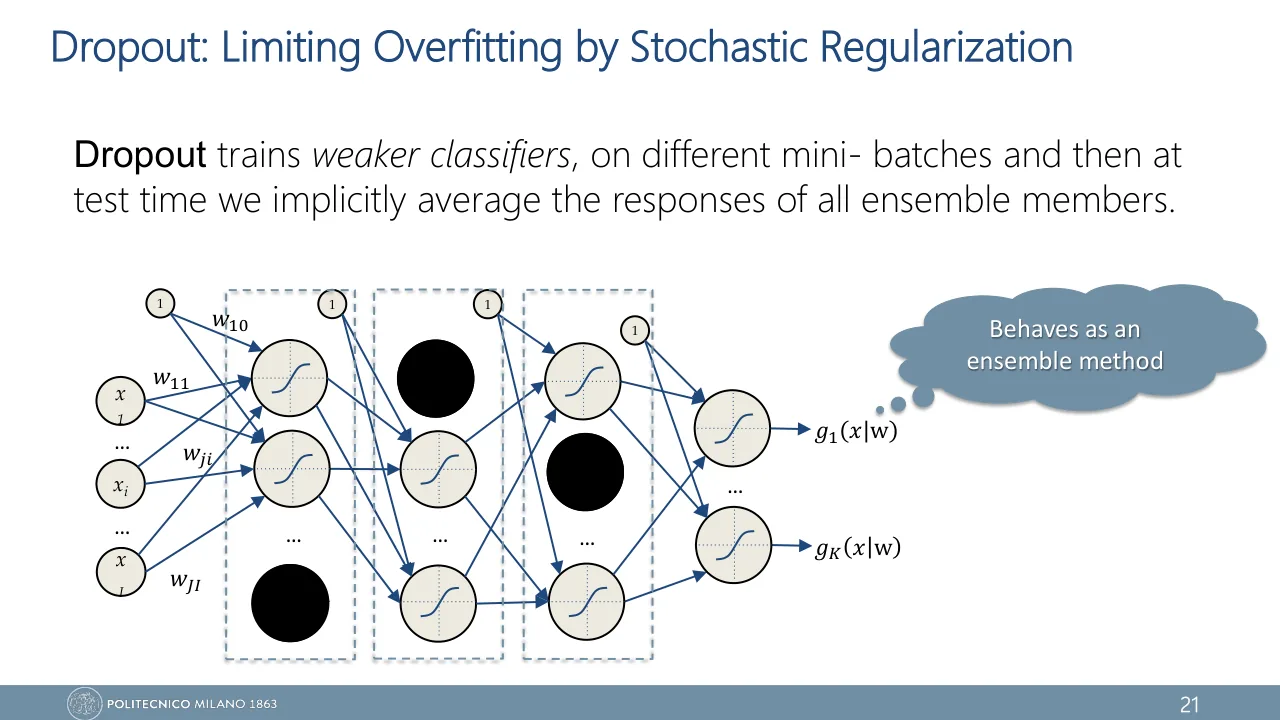
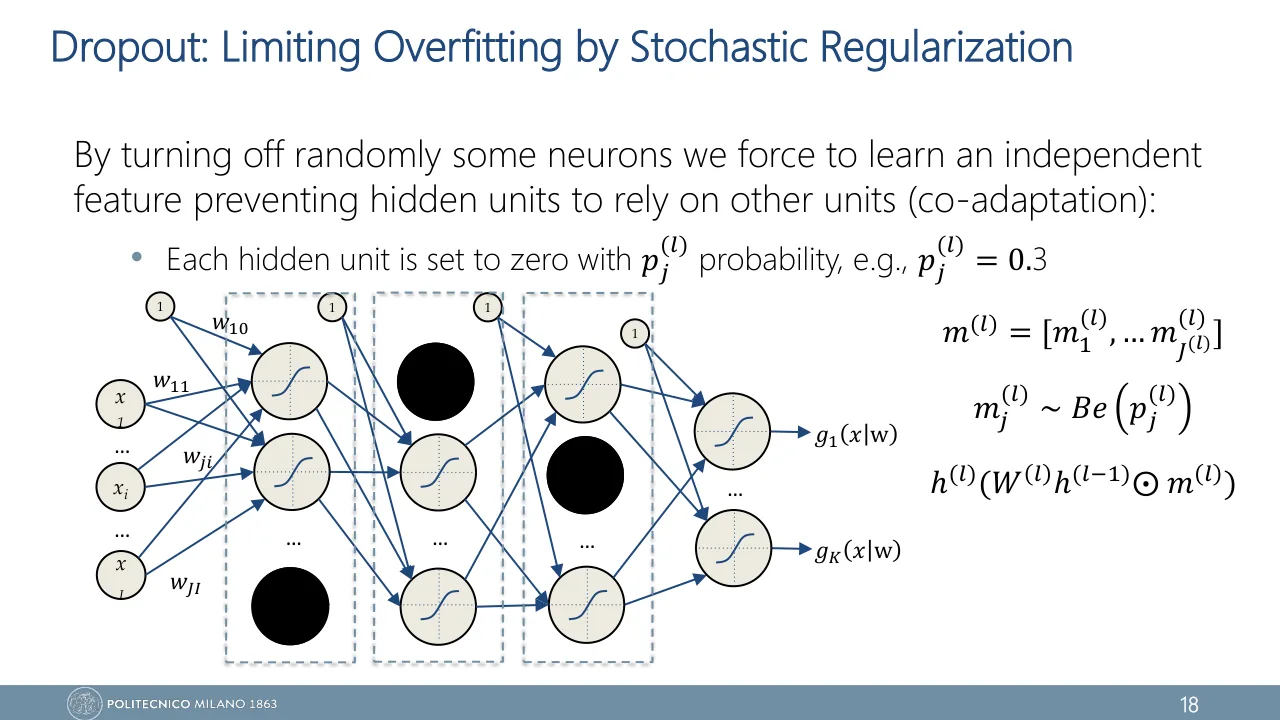
У лектора всё это — одна фраза (лекция 3, слайд 21): "Dropout trains weaker classifiers, on different mini-batches and then at test time we implicitly average the responses of all ensemble members". И вывод в облачке рядом: "Behaves as an ensemble method". Weaker classifiers и ensemble members — это прореженные сети: нейронов в каждой меньше, и по отдельности она слабее полной. Implicitly — потому что на тесте ни одну из них отдельно не считают. Слайды 18–20 показывают трёх участников ансамбля: сеть одна и та же, набор закрашенных нейронов каждый раз другой, а их связи убраны.
Классический способ собрать ансамбль — bagging: обучить несколько независимых моделей, каждую на своей bootstrap-выборке (случайной выборке с возвращением), и усреднить их ответы. Dropout делает то же самое почти бесплатно.
Моделей несколько, у каждой свои веса.
Каждая обучена до конца на своей выборке.
На тесте считают все модели и усредняют ответы явно.
Сетей \(2^n\), веса у всех общие.
Каждой достаётся от силы один шаг обучения.
На тесте работает одна полная сеть, усреднение неявное. Как именно — в следующем разделе.
Dropout помогает по двум причинам: ломает co-adaptation и обучает ансамбль из \(2^n\) прореженных сетей с общими весами.
День матча: куда поставить множитель
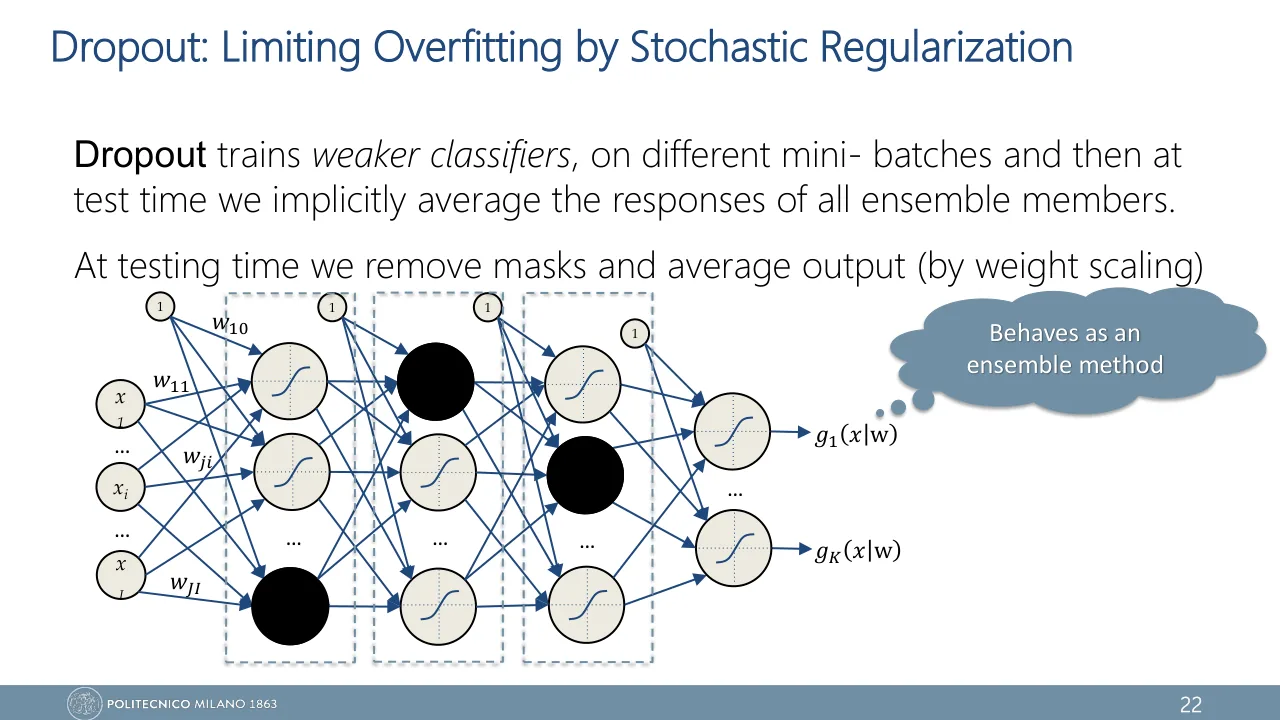
На тесте маски выключают: ответ сети не должен зависеть от броска монетки, и выбрасывать выученное незачем. На слайде про тест одна строка (лекция 3, слайд 22): "At testing time we remove masks and average output (by weight scaling)". С первой половиной всё ясно. А на что умножать веса и почему, слайд не говорит. Тут и появляется вторая странность из начала урока. Нейрон следующего слоя всё обучение получал сумму от прореженного слоя. Теперь на него приходят все сразу.
На числах конспекта. Пусть все веса к следующему нейрону равны 1, а bias равен 0. С маской [1, 0, 1, 0, 1] он получает \(0.4 + 0.3 + 0.9 = 1.6\). Полный слой даёт \(2.4\). А сколько нейрон получал в среднем по всем маскам? Это считается в несколько строк. Номер слоя \((l)\) ниже опущен, чтобы формулы читались легче.
-
Что нейрон \(j\) отдаёт на обучении:
\[ \tilde h_j = m_j\, h_j, \qquad m_j \sim Be(p) . \] -
Среднее значение монетки. Она равна 1 с вероятностью \(p\) и 0 с вероятностью \(1 - p\):
\[ \E[m_j] = 1 \cdot p + 0 \cdot (1 - p) = p . \] -
Для данного входа \(h_j\) — обычное число, от монетки оно не зависит и выносится за знак среднего. Это формула (62) конспекта:
\[ \E[\tilde h_j] = \E[m_j]\, h_j = p\, h_j . \] -
Нейрон следующего слоя считает pre-activation — взвешенную сумму. Сумма линейна, поэтому её среднее равно сумме средних:
\[ a = \sum_j w_j\, \tilde h_j + w_0 \] \[ \E[a] = p \sum_j w_j\, h_j + w_0 . \]Именно к такому входу нейрон привык за время обучения.
-
На тесте масок нет, все \(m_j = 1\):
\[ a_{\mathrm{full}} = \sum_j w_j\, h_j + w_0 . \]Взвешенная сумма теперь в \(1/p\) раз больше, чем была в среднем на обучении. На наших числах: \(2.4\) вместо \(0.6 \cdot 2.4 = 1.44\).
-
Починим, умножив исходящие веса на \(p\). Bias не трогаем, он и на обучении приходил всегда:
\[ a_{\mathrm{test}} = \sum_j (p\, w_j)\, h_j + w_0 = \E[a] . \]Это weight scaling rule.
-
Другой путь: исправить не тест, а обучение. Разделим оставшиеся активации на \(p\):
\[ \tilde h_j = \frac{m_j}{p}\, h_j \;\Rightarrow\; \E[\tilde h_j] = h_j . \]Тогда \(\E[a] = a_{\mathrm{full}}\), и на тесте обычная сеть уже даёт то, к чему нейрон привык. Это inverted dropout.
Weight scaling rule (на слайде 22 лекции 3 коротко: weight scaling) — правило классического dropout для теста: ни один нейрон не выключается, а каждая активация слоя умножается на keep probability, \(h_j^{(l,\mathrm{test})} = p \cdot h_j^{(l)}\). Равносильно — умножить на \(p\) исходящие веса этого слоя. Формула (60) конспекта.
Теперь строка слайда 22 читается до конца. Remove masks: на тесте работает полная сеть, и на рисунке слайда связи закрашенных нейронов снова на месте. Average output (by weight scaling): ответ ансамбля получают не прогоном \(2^n\) сетей, а одним проходом сети с уменьшенными весами. Сам множитель на слайде не назван. Это вероятность, с которой нейрон был на месте: в буквах урока \(p\), в буквах слайда 17 это \(1 - p_j^{(l)}\). При слайдовом примере 0.3 веса умножаются на 0.7, а не на 0.3.
| Ситуация | \(a\) | Как посчитано |
|---|---|---|
| обучение, маска [1, 0, 1, 0, 1] | 1.60 | \(0.4 + 0.3 + 0.9\) |
| обучение, ожидание \(\E[a]\) по маскам | 1.44 | \(0.6 \cdot 2.4\) |
| тест, weight scaling | 1.44 | \(0.24 + 0.42 + 0.18 + 0.06 + 0.54\) |
| тест без поправки | 2.40 | \(0.4 + 0.7 + 0.3 + 0.1 + 0.9\) |
Без поправки нейрон получил бы на 67 % больше, чем привык видеть в среднем. С сигмоидой или tanh такой перебор уводит его в насыщение, и ответы всей сети съезжают.
Обучение: веса \(w\)
Тест: веса \(p \cdot w\)
Библиотеки делают наоборот. В inverted dropout поправку вносят во время обучения: оставшиеся активации делят на \(p\). В библиотеках, где задают drop rate \(r = 1 - p\), это деление на \(1 - r\). Код для теста тогда ничего не знает о dropout — это обычная сеть без единого множителя. На слайдах этого варианта нет: там назван только weight scaling. Inverted dropout пришёл из конспекта (стр. 175) и из кода библиотек.
Обучение: \(\tilde h_j = m_j\, h_j\)
[0.4, 0, 0.3, 0, 0.9]
Тест: \(h_j^{\mathrm{test}} = p\, h_j\)
[0.24, 0.42, 0.18, 0.06, 0.54]
Обучение: \(\tilde h_j = m_j\, h_j / p\)
[0.67, 0, 0.5, 0, 1.5]
Тест: \(h_j^{\mathrm{test}} = h_j\)
[0.4, 0.7, 0.3, 0.1, 0.9]
Оба варианта дают следующему слою одно и то же ожидание. Разница только в том, где стоит множитель и какой он: \(p\) на тесте или \(1/p\) на обучении. Поставить оба сразу или не поставить ни одного — ошибка.
«Weight scaling в точности равен среднему ответу всех подсетей». Только до первой нелинейности. Правило выравнивает среднюю pre-activation, но среднее от \(g(a)\) не равно \(g\) от среднего. Два нейрона с выходами \(h = (1, 1)\), веса \(+1\) и \(-1\), следующий нейрон — ReLU, \(p = 0.5\):
| маска | \(a\) | ReLU\((a)\) |
|---|---|---|
| (0, 0) | 0 | 0 |
| (1, 0) | 1 | 1 |
| (0, 1) | −1 | 0 |
| (1, 1) | 0 | 0 |
Средний ответ четырёх подсетей равен \(1/4 = 0.25\). Сеть с weight scaling считает \(a = 0.5 - 0.5 = 0\) и отвечает 0. Для глубокой нелинейной сети правило — дешёвое приближение к усреднению ансамбля, которое на практике работает хорошо. Конспект (стр. 174–175) говорит о сохранении «expected activation»: для активации это верно, для ответа сети — приближённо. Слайды 21–22 лекции 3 говорят без оговорок: "implicitly average", "average output (by weight scaling)". В ответе на экзамене бери эти слова; добавить к ним approximately — не ошибка.
Сколько выключать и чем за это платят
Конспект называет типичные значения: \(p = 0.5\) для скрытых слоёв и \(p = 0.8\)–\(0.9\) для входного. В коде Keras это Dropout(0.5) и Dropout(0.2) или Dropout(0.1): там в скобках drop rate. Входы берегут, потому что выключенный признак некому восстановить, а скрытые нейроны отчасти дублируют друг друга. На слайде 17 лекции 3 число одно и только для скрытых нейронов: 0.3 как вероятность выключить, то есть \(p = 0.7\). Про dropout на входах слайды не говорят.
\(p\) — это hyperparameter: градиентный спуск его не подбирает, его выбирают по validation error, как в уроке 21. Слишком маленькое \(p\) — сеть не может выучить даже обучающую выборку. Значение \(p\), близкое к 1, — регуляризации почти нет.
Бесплатным dropout не бывает.
- Обучение идёт дольше. Авторы AlexNet отмечают, что с dropout для сходимости понадобилось примерно вдвое больше итераций: градиент шумный, а каждая подсеть учится редко.
- Слой приходится делать шире: в каждый момент работает в среднем \(p \cdot n\) нейронов из \(n\).
- У сети появляются два режима. В Keras это аргумент
training, в PyTorch —model.train()иmodel.eval(). Если забыть переключить сеть на тест, она будет отвечать по случайной подсети. - Кривые читаются иначе. Training error считают с масками, validation error — полной сетью. Поэтому training error может лежать выше validation error, и это не поломка.
Чем dropout похож на weight decay?
Возьми линейную регрессию и выключай не нейроны, а входы: каждый элемент матрицы данных \(X\) умножается на свою монетку \(m_{nj} \sim Be(p)\). Средняя по маскам Sum of Squared Errors \(\E\,\norm{\vb{t} - (M \odot X)\vb{w}}^2\) раскладывается на два слагаемых:
\[ \norm{\vb{t} - pX\vb{w}}^2 + p(1 - p) \sum_j s_j\, w_j^2 \]где \(s_j = \sum_n x_{nj}^2\). Первое слагаемое — обычная ошибка для весов \(p\vb{w}\), тех самых, что работают на тесте. Второе — штраф на квадраты весов: оно получилось из дисперсии монетки \(p(1 - p)\). Если входы z-стандартизованы, как в Applied Statistics, все \(s_j\) одинаковы, и штраф превращается в обычный ridge, то есть в weight decay из урока 22. В пересчёте на тестовые веса \(p\vb{w}\) его сила пропорциональна \((1 - p)/p\): при \(p = 1\) штрафа нет, чем меньше \(p\), тем он сильнее.
Три способа не дать сети зубрить
Этим уроком блок про борьбу с переобучением (уроки 20–23) закрыт. Сведём три приёма в одну таблицу. Общее у них одно: ни один не убирает из сети ни одного веса. Число параметров остаётся прежним, уменьшается effective capacity — то, насколько сложную функцию сеть на деле способна выучить.
| Early stopping урок 20 | Weight decay урок 22 | Dropout этот урок | |
|---|---|---|---|
| Семейство | Training control | Model complexity control | Randomization / Model averaging |
| Что ограничивает | сколько шагов сеть учится | насколько большими вырастают веса | насколько нейроны зависят друг от друга |
| Куда вмешивается | в цикл обучения: останавливает его | в error function: штраф на \(\sum_q w_q^2\) | в forward pass: маска на активациях |
| Добавляет слагаемое в \(E(w)\) | нет | да | нет |
| Hyperparameter | patience | \(\gamma\) | keep probability \(p\) |
| Что на тесте | веса лучшей эпохи по validation error | та же сеть, штраф не считается | все нейроны; веса \(\times\, p\) или, при inverted, без поправки |
| Цена | часть данных уходит в validation set | перебор \(\gamma\) | больше итераций, слой шире |
| Другой взгляд | веса не успевают уйти далеко от начальных | MAP с гауссовским prior на веса | ансамбль из \(2^n\) сетей с общими весами |
Hyperparameter tuning из урока 21 в таблице нет: это не четвёртый регуляризатор, а процедура, которая выставляет ручки первых трёх — patience, \(\gamma\) и \(p\) — по validation error. Сами приёмы друг другу не мешают, и на практике их включают вместе.
Вернёмся к команде
Теперь обе странности из начала урока объясняются. Команда с пропусками играет лучше, потому что никто не может стать приложением к одному партнёру: нет co-adaptation. К тому же каждая тренировка готовит один из \(2^n\) возможных составов с общими навыками, а матч играет «средний состав»: это ensemble.
А в день матча, когда выходят все, каждый играет в долю \(p\) от привычной силы: это weight scaling rule. Или, что то же самое, на тренировках пришедшие играют в \(1/p\) раза сильнее, и тогда в день матча ничего менять не нужно: это inverted dropout.
В формате экзамена
Describe dropout at training time and at test time. Why is a scaling factor needed? State where the factor is applied in (a) the weight scaling rule and (b) inverted dropout.
Show model answer
Training. Let \(p\) be the probability of keeping a unit. At every iteration each hidden unit is kept with probability \(p\) and set to zero with probability \(1 - p\), independently of the other units: \(\tilde h_j = m_j h_j\) with \(m_j \sim Be(p)\). A new mask is sampled every time, so different mini-batches train different thinned networks; the same mask is used in the forward and in the backward pass, so only the weights of the sampled thinned network are updated.
Test. The masks are removed: no unit is dropped. Since \(\E[\tilde h_j] = p\,h_j\), the next layer was trained on inputs that are on average \(p\) times the full ones; with all units active, the weighted sums it receives would be \(1/p\) times larger than their average during training, so its units would work in a regime they were not trained for.
(a) Weight scaling rule: use the full network and multiply the activations of the dropout layer (equivalently, its outgoing weights) by \(p\) at test time; this single pass approximately averages the outputs of all the thinned networks. (b) Inverted dropout: divide the kept activations by \(p\) during training, \(\tilde h_j = m_j h_j / p\), and use the plain network at test time. Both make the expected pre-activation of the next layer the same in training and at test time.
Проверяют три вещи: что маска случайная и новая на каждом шаге; что на тесте работают все нейроны; что множитель назван с местом и значением (\(p\) на тесте или \(1/p\) на обучении). Обязательно скажи словами, что \(p\) — keep probability: на слайде 17 лекции 3 буквой \(p_j^{(l)}\) названа вероятность нейрон обнулить, и без слов твой множитель прочтут наоборот. Слова слайда 22 лекции 3, которые стоит повторить: remove masks, average output, weight scaling. Inverted dropout есть только в конспекте, на слайдах его нет.
A hidden layer outputs \(h = [0.4,\ 0.7,\ 0.3,\ 0.1,\ 0.9]\). It was trained with classical dropout, keep probability \(p = 0.6\). A unit of the next layer has all five incoming weights equal to 1 and zero bias. Compute its pre-activation at test time under the weight scaling rule.
Show model answer
At test time no unit is dropped and every activation is multiplied by \(p\):
\[ \begin{aligned} a &= 0.6 \cdot (0.4 + 0.7 + 0.3 + 0.1 + 0.9) \\ &= 0.6 \cdot 2.4 = 1.44 \end{aligned} \]Две типичные ошибки: применить на тесте маску (на тесте её нет) и умножить на \(1 - p = 0.4\). Ответ 2.4 означает, что поправка забыта.
Same layer and same next-layer unit as above, but now the network is trained with inverted dropout, keep probability \(p = 0.6\). In one training step the sampled mask is \(m = [1,\ 0,\ 1,\ 0,\ 1]\). Compute the pre-activation of the next-layer unit in this step (three decimals).
Show model answer
Kept activations are divided by \(p\), dropped ones are zero:
\[ \tilde h = [0.667,\ 0,\ 0.5,\ 0,\ 1.5] \] \[ a = \frac{0.4 + 0.3 + 0.9}{0.6} = \frac{1.6}{0.6} \approx 2.667 \]At test time the plain network gives \(a = 2.4\), which is the expected value of \(a\) over all masks.
Проверяют, что ты отличаешь inverted dropout от классического: здесь множитель \(1/p\) стоит на обучении. Ответ 1.6 — это классический вариант, 0.96 — лишнее умножение на \(p\).
A network is trained with dropout: each hidden unit is set to zero with probability 0.3. For a test input a hidden layer outputs \(h = [0.5,\ 0.2,\ 0.8]\). A unit of the next layer has incoming weights \(w = [1,\ {-2},\ 1]\) and bias \(w_0 = 0.1\). Compute its pre-activation at test time under weight scaling.
Show model answer
The probability given is that of dropping a unit, so each unit is kept with probability \(1 - 0.3 = 0.7\). At test time the masks are removed and the weights coming out of the dropout layer are multiplied by the keep probability; the bias is not scaled:
\[ \sum_j w_j h_j = 0.5 - 0.4 + 0.8 = 0.9 \] \[ a = 0.7 \cdot 0.9 + 0.1 = 0.73 \]Условие написано словами слайда 17 лекции 3: 0.3 — вероятность выключить, а множитель на тесте — вероятность остаться. Ответ 0.37 — умножение на 0.3 вместо 0.7. Ответ 0.70 — множитель попал и на bias. Ответ 1.0 — поправка забыта.
Give two reasons why dropout reduces overfitting. How many thinned networks does a hidden layer with 10 units define? How does dropout differ from bagging?
Show model answer
1. It prevents co-adaptation. By randomly turning off some neurons we force each hidden unit to learn an independent feature: it cannot rely on specific other units being present, so its feature has to be useful together with many random subsets of the other units. The representation becomes redundant and robust.
2. It behaves as an ensemble method. A layer with 10 droppable units defines \(2^{10} = 1024\) thinned networks that share weights. Dropout trains these weaker classifiers on different mini-batches: each training iteration updates one randomly sampled thinned network. At test time the masks are removed and we implicitly average the responses of all ensemble members: weight scaling approximates the average of their predictions, which reduces variance.
Bagging trains a few independent models, each with its own weights, to convergence on bootstrap samples and averages their outputs explicitly. Dropout trains exponentially many weight-sharing sub-networks, each for at most a few steps, and averages them implicitly with a single forward pass.
Ждут оба объяснения и оба ключевых слова: co-adaptation и ensemble (model averaging). Первая причина — это слайд 17 лекции 3 почти дословно (independent feature, rely on other units), вторая — слайд 21 лекции 3 (weaker classifiers, implicitly average, ensemble members). Про bagging достаточно двух отличий: общие веса и неявное усреднение.
A network is trained with dropout on its hidden layers; \(p\) denotes the keep probability. Which statements are true? Select all that apply.
Show model answer
True: the first, the second and the fifth. Dropout is active only in training; classical dropout rescales by \(p\) at test time, inverted dropout rescales by \(1/p\) in training and does nothing at test time; a dropped unit has zero output, hence its weights get zero gradient from that example. Dropout is neither pruning nor a penalty on the error function.
В вопросах «select all» чаще всего ловят на двух подменах: dropout против pruning и множитель \(p\) не в том варианте.
Early stopping, weight decay and dropout all reduce the effective capacity of a network without removing any weight. For each technique state what it constrains and name its hyperparameter. How are these hyperparameters chosen?
Show model answer
Early stopping constrains the number of training iterations, i.e. how far the weights can move from their initial values; hyperparameter: patience. Weight decay constrains the magnitude of the weights through a penalty on \(\sum_q w_q^2\) added to the error function; hyperparameter: \(\gamma\). Dropout constrains how much units depend on each other, by multiplicative noise on the activations (implicit model averaging); hyperparameter: the keep probability \(p\).
All three are selected on validation data (hold-out or cross-validation): never on the training error, which would always choose no regularisation, and never on the test set.
Это вопрос на весь блок. Ценится параллельная структура ответа: «что ограничивает — чем управляется» трижды, и одна общая фраза про validation.
Проверь себя
Слой выдал \(h = [0.2,\ 0.8]\), keep probability \(p = 0.5\), маска \(m = [0,\ 1]\). Что уйдёт в следующий слой на обучении при inverted dropout?
Сеть обучена с классическим dropout, \(p = 0.5\). Что верно про тест?
Картинка для памяти: в день матча выходят все, и каждый играет вполсилы.
В коде на Keras написано Dropout(0.2). Какая доля нейронов в среднем остаётся включённой и чему равно \(p\) в обозначениях конспекта?
Чем ансамбль, который строит dropout, отличается от bagging?
На графике обучения сети с dropout training error лежит выше validation error. Что это значит?
На очередном примере нейрон выключен маской. Что произойдёт с его входящими весами от этого примера?
Какие утверждения про три регуляризатора блока верны?
Унести с собой
- Dropout на обучении оставляет каждый нейрон с вероятностью \(p\): \(\tilde h_j = m_j h_j\), \(m_j \sim Be(p)\). Маска новая на каждом шаге и одна для forward и backward pass.
- Он помогает по двум причинам: ломает co-adaptation и обучает ансамбль из \(2^n\) thinned networks с общими весами. На слайде 21 лекции 3 это "behaves as an ensemble method".
- На тесте масок нет. Классический вариант умножает активации (исходящие веса) на \(p\): weight scaling rule, единственный вариант, названный на слайдах (слайд 22 лекции 3). Inverted dropout из конспекта делит на \(p\) на обучении и ничего не делает на тесте.
- Обоснование одно: \(\E[\tilde h_j] = p\,h_j\), поэтому средняя pre-activation следующего слоя на обучении и на тесте совпадает. После нелинейности это уже приближение.
- В конспекте и в этом уроке \(p\) — keep probability. В библиотеках и в тексте слайда 17 лекции 3 (set to zero, пример 0.3) названа вероятность выключить, \(1 - p\). Типичные значения: \(p = 0.5\) для скрытых слоёв, 0.8–0.9 для входа.
- Цена: больше итераций, слой шире, два режима у сети. К error function при этом ничего не прибавляется.
- Блок целиком: early stopping ограничивает время обучения, weight decay — величину весов, dropout — зависимость нейронов друг от друга; все три настраиваются по validation error.
Что посмотреть и почитать
-
MIT Introduction to Deep Learning (2025) | 6.S191, Lecture 1
Alexander Aminiнужен только конец лекции
В заключительной части dropout и early stopping показаны на кривых training и validation, языком экзамена. Перцептрон и backprop в начале можно пропустить.
-
CS231n: Neural Networks Part 2 — Setting up the Data and the Model
Stanford, A. Karpathy
Раздел про dropout: классический и inverted варианты стоят рядом, каждый в нескольких строках кода. Лучшее место, чтобы увидеть, куда переезжает множитель.
-
Dropout: A Simple Way to Prevent Neural Networks from Overfitting
Srivastava, Hinton, Krizhevsky, Sutskever, Salakhutdinov, 2014
Первоисточник. Хватит разделов 1–2 и рисунков 1–2: прореженная сеть и weight scaling rule. Обозначения те же, что в конспекте: \(p\) — keep probability.
-
Deep Learning, глава 7: Regularization for Deep Learning
Goodfellow, Bengio, Courvilleраздел 7.12
Dropout как дешёвый bagging: откуда берётся ансамбль с общими весами и почему weight scaling — приближение. В той же главе weight decay и early stopping, то есть весь блок уроков 20–23.
-
Dive into Deep Learning, 5.6: Dropout
Zhang, Lipton, Li, Smola
Dropout, написанный с нуля, и код, который можно запустить. Осторожно с обозначениями: там \(p\) — вероятность выключить, как в PyTorch и в тексте слайда 17 лекции 3.