James Bergstra и Yoshua Bengio опубликовали статью «Random Search for Hyper-Parameter Optimization». Её главный довод помещается в одну картинку: при девяти пробах сетка 3 × 3 проверяет всего три разных значения того hyperparameter, который важен, а девять случайных точек — девять. Доска выше повторяет эту картинку.
Ручки, которые сеть не крутит сама
После этого урока ты отличишь hyperparameters от parameters, объяснишь, почему их выбирают только на validation set, посчитаешь цену grid search и скажешь, почему девять случайных проб обычно полезнее таблицы 3 × 3.
У сети две ручки настройки, learning rate и dropout rate, а времени хватает на девять обучений. План А: аккуратная таблица 3 × 3 — три значения одной ручки на три значения другой. План Б: девять раз бросить кости и обучить то, что выпало. Какой план надёжнее?
Почти все выбирают таблицу: она покрывает поле ровно, без дыр. В 2012 году James Bergstra и Yoshua Bengio одной картинкой из девяти точек показали, что кости, как правило, выигрывают.
Дело не в везении, и причину можно увидеть глазами. Но сначала разберёмся, что это за ручки и почему сеть не может покрутить их сама.
Два вида чисел в одной сети
Представь, что печёшь хлеб в незнакомой духовке. Тесто поднимается само: это работа процесса, ты в неё не вмешиваешься. А температуру, время и высоту противня выставляешь ты, причём до того, как закрыть дверцу. Ошибку увидишь, только когда буханка готова. Каждая проба стоит целой буханки.
У нейросети числа делятся так же. Одни подбирает сам процесс обучения, другие задаёшь ты перед запуском.
Parameters (параметры) — веса \(w_{ji}^{(l)}\) и смещения \(w_0\). Их подбирает gradient descent, уменьшая error function \(E(\vb{w})\) на training set. Они определяют, какую функцию \(g(x_n|\vb{w})\) вычисляет сеть.
Hyperparameters (гиперпараметры) — настройки, которые фиксируют до обучения: число слоёв \(L\), число нейронов \(J^{(l)}\) в скрытом слое \(l\), learning rate \(\eta\) и другие. Они определяют, как идёт обучение и насколько сложной может стать модель.
Одну конкретную расстановку всех ручек будем называть конфигурацией и обозначать \(\theta\): например, «два слоя по 32 нейрона, \(\eta = 0.01\)». И слово, и буква — из конспекта. На слайдах третьей лекции общей буквы для набора ручек нет: каждая названа отдельно — \(L\), \(J^{(l)}\), \(\gamma\).
Почему сеть не подберёт hyperparameters тем же gradient descent? Есть причина техническая: число слоёв — целое, по нему не взять производную, а \(\eta\) вообще не входит в \(E(\vb{w})\). Но главная причина глубже, и в экзаменационном ответе нужна именно она.
Возьмём одну ручку — число нейронов \(J^{(1)}\) в единственном скрытом слое — и для каждого значения обучим сеть. Чем больше \(J^{(1)}\), тем гибче модель и тем ниже ошибка на training set: большая сеть в крайнем случае просто запомнит примеры.
Если выбирать \(J^{(1)}\) по training error, победит самая большая сеть. Всегда. То же случится с любой ручкой, которая управляет сложностью: training error выберет \(\gamma = 0\), то есть никакой регуляризации, и нулевой dropout. Такие ручки приходится судить по данным, которых веса не видели, — по validation set.
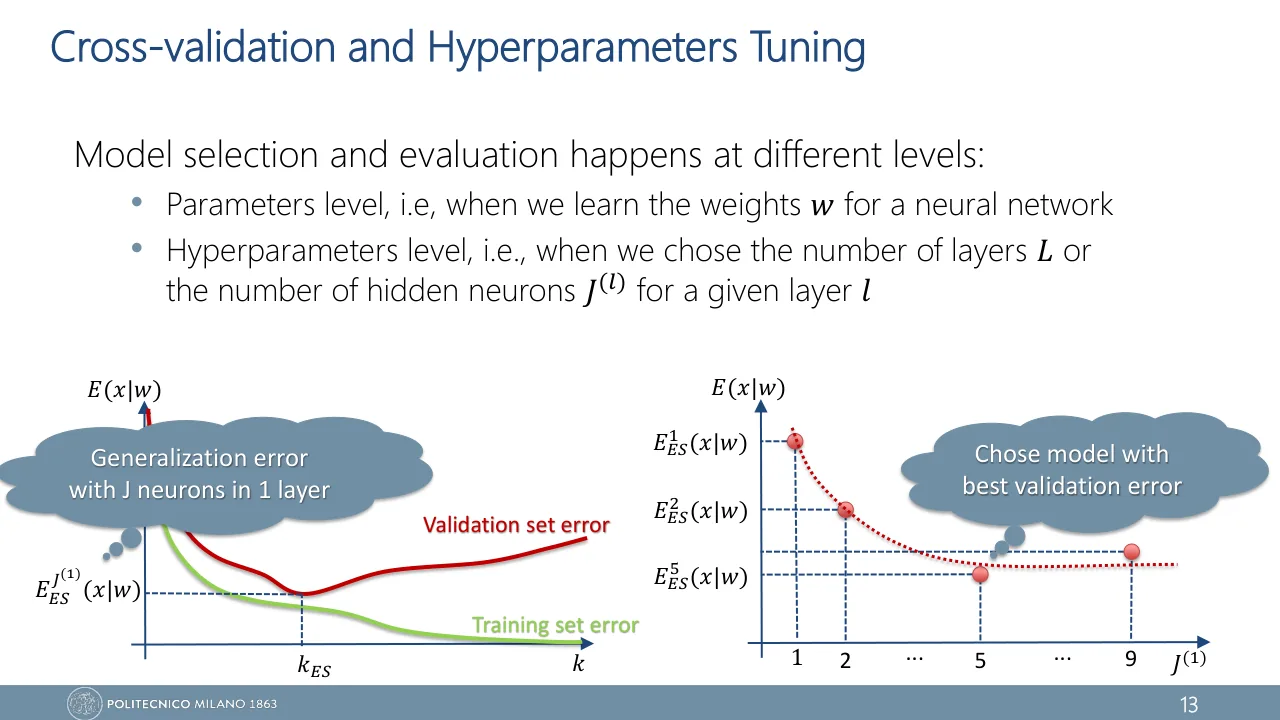
Именно эту ручку профессор берёт на слайде (лекция 3, слайд 13, "Cross-validation and Hyperparameters Tuning"). Для каждого значения \(J^{(1)}\) сеть обучают с early stopping из прошлого урока и записывают validation error в точке остановки \(k_{ES}\). На слайде это число обозначено \(E_{ES}^{J^{(1)}}(x|w)\): снизу пометка early stopping, сверху число нейронов. Потом эти числа сравнивают между собой.
Одно обучение при фиксированном \(J^{(1)}\)
Одно обучение — одна точка
У рисунка на слайде две подписи. У графика с кривыми обучения: "Generalization error with J neurons in 1 layer". Число \(E_{ES}^{J^{(1)}}(x|w)\) служит оценкой того, как сеть с таким числом нейронов поведёт себя на новых данных. У графика с точками: "Chose model with best validation error", то есть бери модель с наименьшей ошибкой на validation set. На слайде напечатано именно "chose"; это опечатка, читать и писать надо "choose".
На рис. 1 правая ветвь validation error заметно растёт, а на слайде она почти плоская. Противоречия нет: на слайде каждая сеть остановлена в своей лучшей точке \(k_{ES}\), и большая сеть не успевает так сильно заучить шум. Главное у двух картинок общее: лучшая модель — не самая большая.
Конспект записывает то же правило в общем виде: не для одной ручки, а для целой конфигурации \(\theta\).
\[ \theta^{*} = \argmin_{\theta_i \in \Theta}\, E_{\mathrm{val}}(\theta_i) \]
- \(\theta_i\)
- одна конфигурация: значения всех hyperparameters сразу
- \(\Theta\)
- список кандидатов, которые решено проверить
- \(E_{\mathrm{val}}(\theta_i)\)
- ошибка на validation set у сети, обученной с настройками \(\theta_i\)
- \(\theta^{*}\)
- победитель: конфигурация с наименьшей validation error
\(E_{\mathrm{val}}(\theta_i)\) — обозначение конспекта. На слайдах та же величина записана для каждой ручки по-своему: \(E_{ES}^{J^{(1)}}(x|w)\), когда выбирают число нейронов (лекция 3, слайд 13), и \(E_{\gamma}^{VAL}\), когда выбирают \(\gamma\) (лекция 3, слайд 16). И ещё одна мелочь: на осях этих слайдов написано \(E(x|w)\). Это та же error function, что \(E(\vb{w})\) во второй лекции, только в скобках названы ещё и данные \(x\), на которых она посчитана.
Parameters подбирает gradient descent на training set, hyperparameters — ты или алгоритм поиска на validation set.
На слайде выбор модели разложен на два уровня (лекция 3, слайд 13): "Model selection and evaluation happens at different levels". Первый — "Parameters level, i.e., when we learn the weights \(w\) for a neural network". Второй — "Hyperparameters level, i.e., when we chose the number of layers \(L\) or the number of hidden neurons \(J^{(l)}\) for a given layer \(l\)". Удобная рамка для ответа на открытый вопрос: назови уровень, скажи, кто на нём выбирает и по каким данным.
Пульт: какая ручка что делает
Список ручек у обычной Feed Forward Neural Network короткий. Его полезно сразу разложить на три кучки — по тому, что ручка делает со сложностью модели.
- Добавляют сложность. Число слоёв \(L\) (глубина) и число нейронов в слое \(J^{(l)}\) (ширина): это те две ручки, которые названы на слайде (лекция 3, слайд 13). Больше — модель гибче. Сюда же относится длительность обучения, но её подбирает early stopping из прошлого урока.
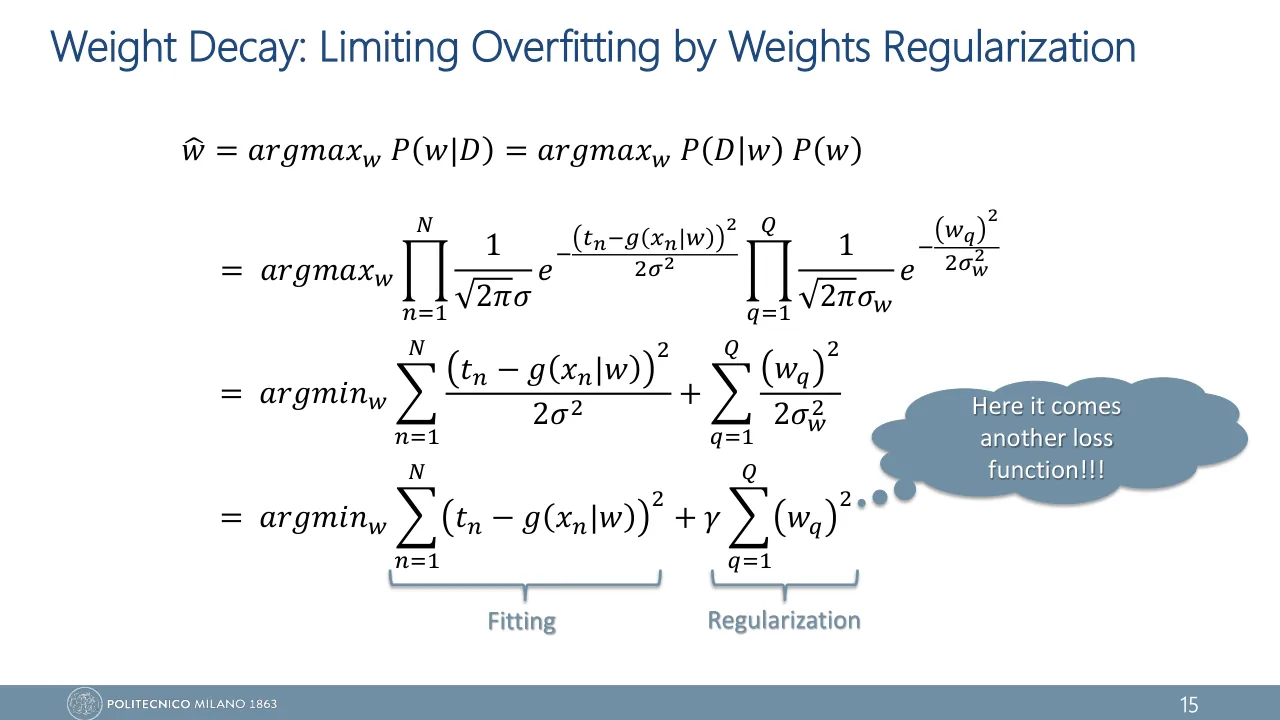
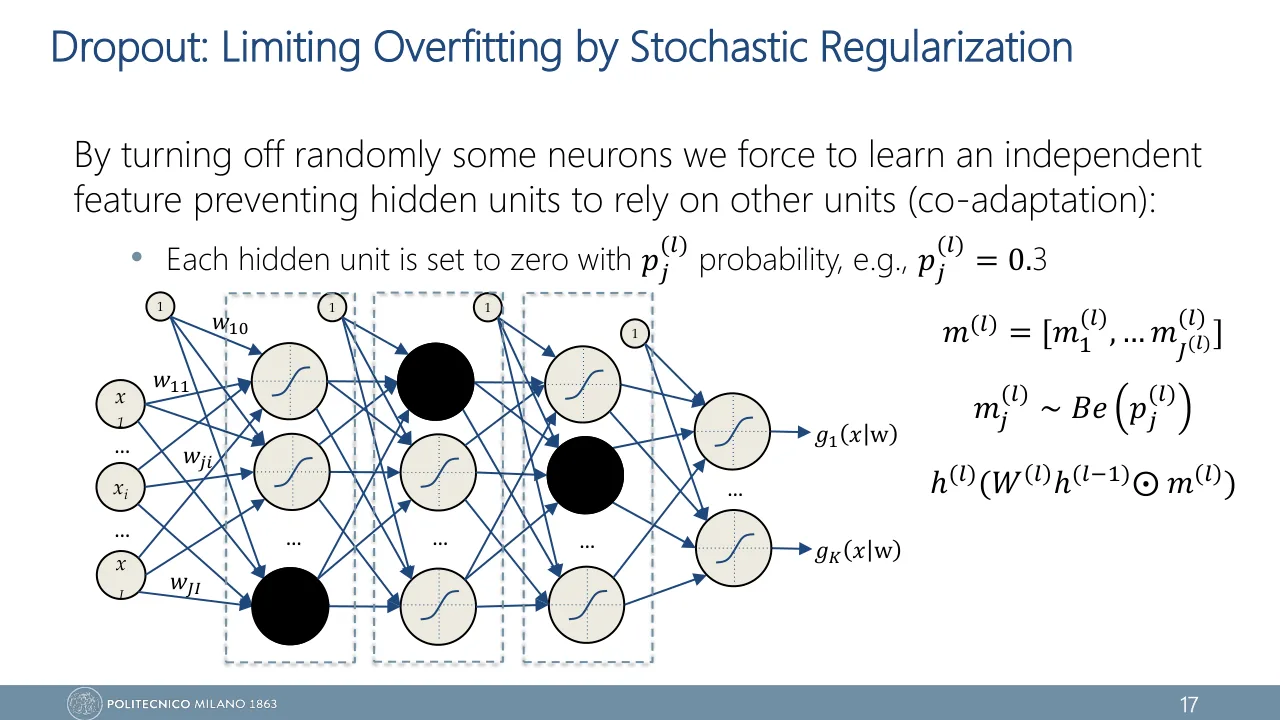
- Отнимают сложность. Сила регуляризации \(\gamma\) — множитель перед штрафом в weight decay (лекция 3, слайд 15; в конспекте regularization strength; урок 22). И dropout rate — доля нейронов, которые выключаются на каждом шаге обучения; на слайде это вероятность \(p_j^{(l)}\), например 0.3 (лекция 3, слайд 17; урок 23). Больше — модель скованнее.
- Управляют самим спуском. Learning rate \(\eta\) и batch size \(M\) — сколько примеров идёт в одну оценку градиента. Они не меняют набор функций, доступных сети. Они решают, дойдёт ли спуск до хорошей точки и как быстро.
В конспекте то же собрано в Table 2 на стр. 156. Ниже она в исправленном виде и с добавленной строкой про batch size.
| Hyperparameter | Слишком мало | Слишком много |
|---|---|---|
| слои \(L\), нейроны \(J^{(l)}\) | underfitting: модель слишком простая | overfitting: модель слишком гибкая |
| learning rate \(\eta\) | спуск ползёт: slow convergence | спуск прыгает и расходится: плоха уже training error |
| batch size \(M\) | шумная оценка градиента, зато шаг дешёвый | точная оценка, зато шаг дорогой |
| \(\gamma\) | штраф слабый: overfitting | штраф душит модель: underfitting |
| dropout rate | регуляризации почти нет: overfitting | выключено слишком много: underfitting |
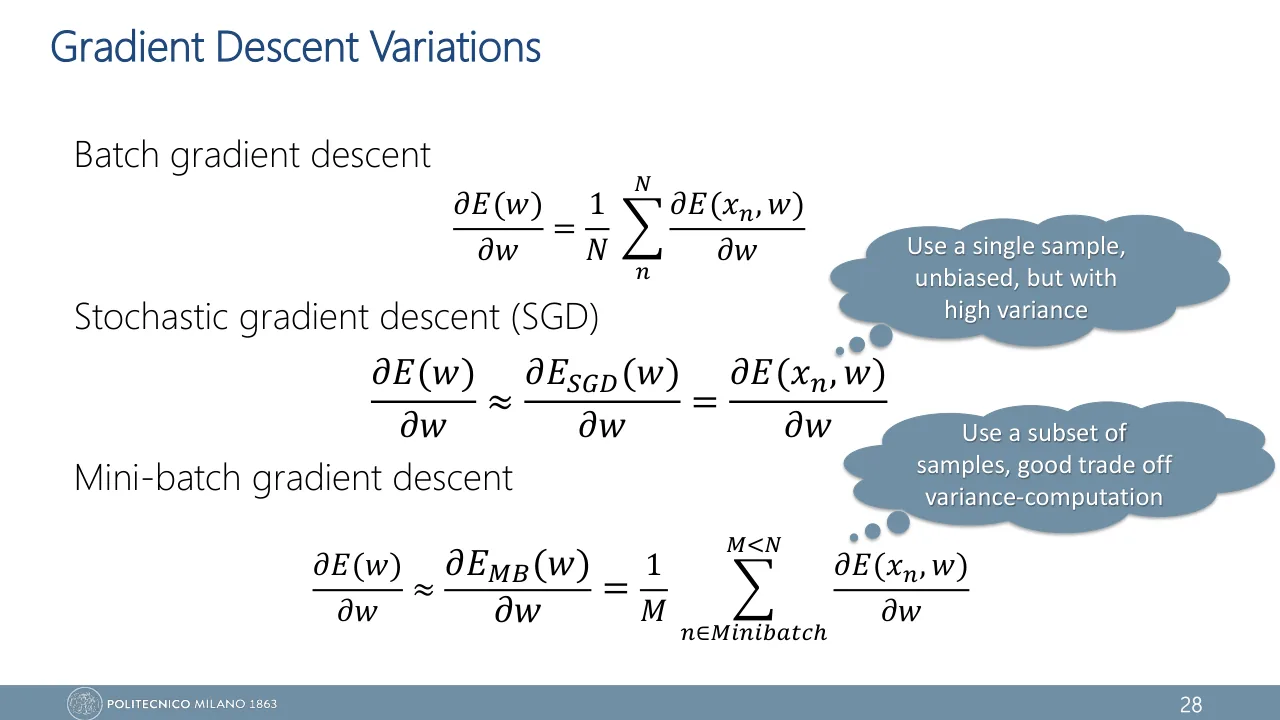
Отдельно про batch size: здесь конспект ошибается в направлении. На слайде градиент оценивается по mini-batch из \(M\) примеров вместо всех \(N\) (лекция 2, слайд 28):
\[ \pd{E(\vb{w})}{\vb{w}} \approx \frac{1}{M} \sum_{n \in \text{mini-batch}} \pd{E(x_n, \vb{w})}{\vb{w}} \]Это среднее по случайной выборке. Из Applied Statistics ты знаешь, как оно себя ведёт: выборочное среднее не смещено, а его дисперсия падает как \(1/M\). Меньше mini-batch — оценка шумнее, а не точнее.
\(M = 4\): оценки смотрят кто куда
\(M = 64\): оценки почти совпадают
Один цикл на всех
Как узнать \(E_{\mathrm{val}}(\theta)\) для одной конфигурации? Способ один: обучить сеть с этими настройками от начала до конца и измерить ошибку на validation set. Одна проба — одно полное обучение, одна «буханка». Поэтому вся наука о подборе hyperparameters сводится к вопросу, как потратить поменьше проб.
Процедура из конспекта (стр. 157–158) укладывается в пять шагов.
- Задать кандидатов: список конфигураций \(\Theta\).
- Для каждой \(\theta_i\) обучить сеть на \(D_{\mathrm{train}}\) и посчитать \(E_{\mathrm{val}}(\theta_i)\) на \(D_{\mathrm{val}}\).
- Выбрать \(\theta^{*}\) с наименьшей validation error.
- Оставить эту модель — или обучить заново с \(\theta^{*}\) на \(D_{\mathrm{train}} \cup D_{\mathrm{val}}\), чтобы веса увидели больше данных. Плата за второй вариант: следить за validation error уже не на чем, поэтому число эпох берут то, которое early stopping нашёл раньше (урок 20).
- Один раз измерить ошибку на отложенном \(D_{\mathrm{test}}\).
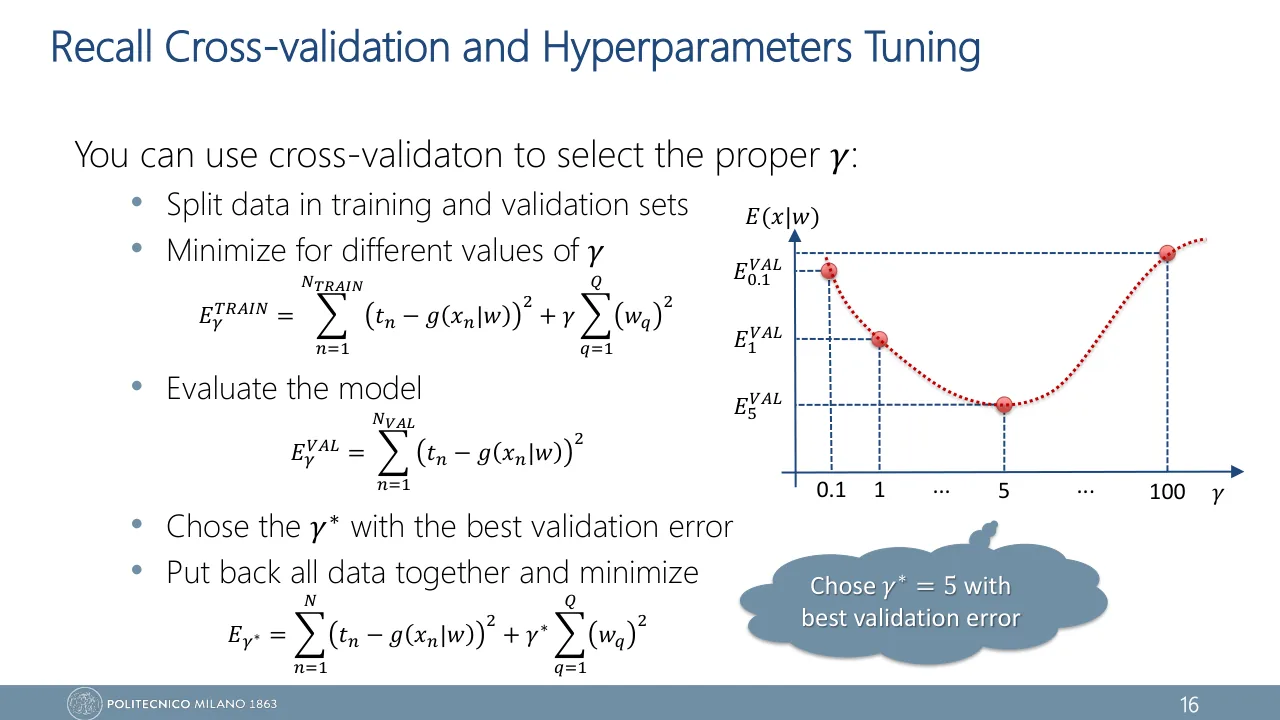
На слайдах та же процедура расписана для одной ручки, для \(\gamma\) (лекция 3, слайд 16, "Recall Cross-validation and Hyperparameters Tuning"). Слайд открывается фразой "You can use cross-validaton to select the proper \(\gamma\)" и перечисляет пять действий. В слове "cross-validation" на нём пропущена буква.
- "Split data in training and validation sets".
- "Minimize for different values of \(\gamma\)": для каждого значения из списка веса подбирают на training set, минимизируя \(E_{\gamma}^{TRAIN}\).
- "Evaluate the model": на validation set считают \(E_{\gamma}^{VAL}\).
- "Chose the \(\gamma^{*}\) with the best validation error".
- "Put back all data together and minimize": с найденной \(\gamma^{*}\) сеть обучают заново на всех данных, минимизируя \(E_{\gamma^{*}}\).
\[ \begin{aligned} E_{\gamma}^{TRAIN} = {} & \sum_{n=1}^{N_{TRAIN}} \bigl(t_n - g(x_n|\vb{w})\bigr)^2 \\ & + \gamma \sum_{q=1}^{Q} (w_q)^2 \end{aligned} \]
\[ E_{\gamma}^{VAL} = \sum_{n=1}^{N_{VAL}} \bigl(t_n - g(x_n|\vb{w})\bigr)^2 \]
\[ \begin{aligned} E_{\gamma^{*}} = {} & \sum_{n=1}^{N} \bigl(t_n - g(x_n|\vb{w})\bigr)^2 \\ & + \gamma^{*} \sum_{q=1}^{Q} (w_q)^2 \end{aligned} \]
- \(N_{TRAIN}\), \(N_{VAL}\)
- число примеров в training set и в validation set; \(N\) — все примеры вместе
- \(Q\)
- число весов сети
- \(\gamma \sum_q (w_q)^2\)
- штраф за большие веса; что он делает с сетью — тема урока 22
Посмотри на среднюю строку: в \(E_{\gamma}^{VAL}\) штрафа нет. Штраф нужен только во время обучения, а сравнивают модели по чистой ошибке на отложенных данных. На графике слайда отмечены значения \(\gamma = 0.1,\ 1,\ \dots,\ 5,\ \dots,\ 100\), а кривая \(E_{\gamma}^{VAL}\) похожа на букву U: слева штраф слишком слаб, справа слишком силён. Подпись под графиком: "Chose \(\gamma^{*} = 5\) with best validation error".
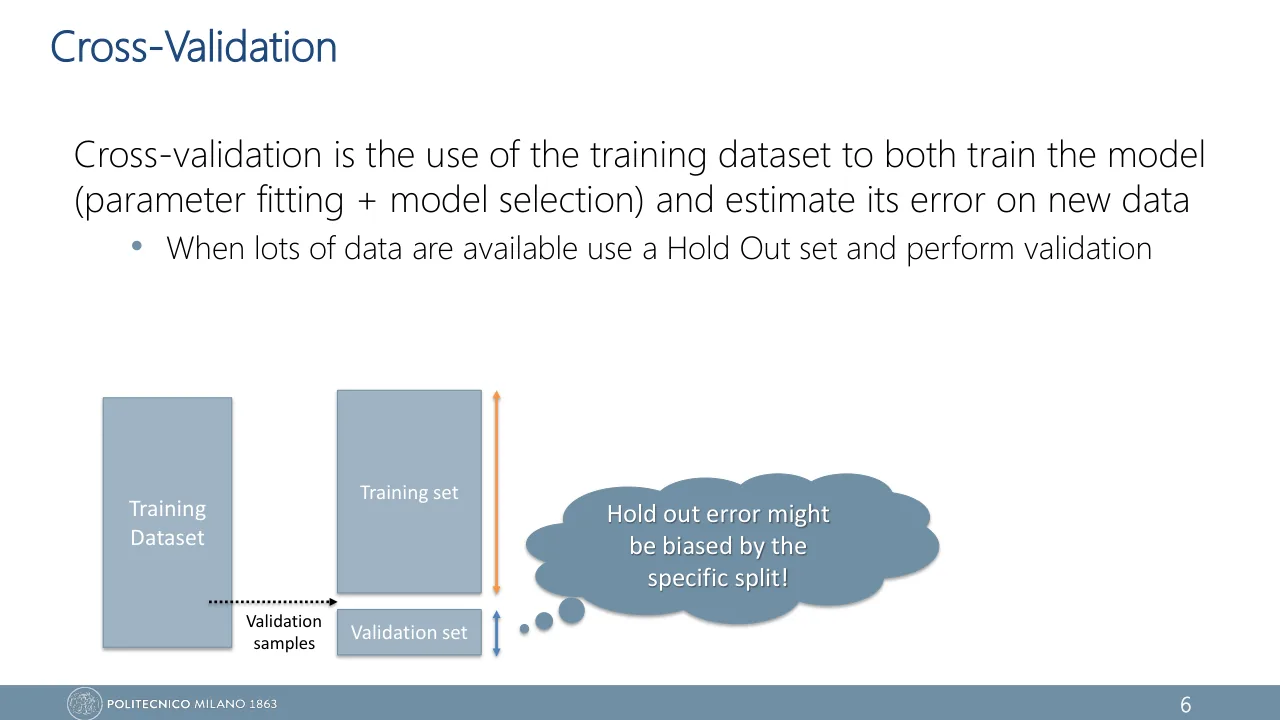
Сравни со списком из конспекта. Действия 2–4 слайда — это шаги 1–3: список значений \(\gamma\), обучение и оценка для каждого, выбор лучшего. "Put back all data together and minimize" — второй вариант шага 4; первого варианта, оставить модель как есть, на слайде нет. Шага 5 на этом слайде тоже нет: test set профессор вводит раньше, когда разбирает термины (лекция 3, слайд 5). И ещё про слово "cross-validation": на слайдах это общее название для любого использования данных и для обучения модели, и для оценки её ошибки на новых данных. Одно разбиение hold-out, как здесь, сюда тоже входит (лекция 3, слайд 6).
На обоих слайдах (лекция 3, слайды 13 и 16) кандидатов просто перечисляют: \(J^{(1)} = 1,\ 2,\ \dots,\ 9\) и \(\gamma = 0.1,\ 1,\ \dots,\ 100\). Перебор готового списка значений одной ручки — это grid search в одном измерении, хотя такого названия на слайдах нет. Откуда брать кандидатов, когда ручек несколько, слайды не говорят. Конспект отвечает на это тремя методами: grid search, random search и Bayesian optimisation. Всё, что дальше в уроке сказано про эти три метода, выходит за рамки слайдов: источник — конспект (стр. 158–163) и материалы из списка в конце урока. Все три — один и тот же цикл. Они отличаются единственной строкой: кто предлагает следующую \(\theta\).
То же псевдокодом. Листинги 5–8 конспекта — четыре варианта этих строк, учить их по отдельности не нужно.
best_err = +inf
repeat until the budget is spent:
    theta = PROPOSE(history)
    # train
    f = A(D_train, theta)
    # evaluate
    e = E_val(f, D_val)
    history += (theta, e)
    if e < best_err:
        best_err = e
        theta_star = theta
retrain on D_train + D_val
report E_test once
Зачем третий набор данных
Шаг 5 в конспекте помечен как необязательный. Это ошибка, и вот почему. Каждая \(E_{\mathrm{val}}(\theta_i)\) посчитана по конечной выборке, в ней есть шум: одной конфигурации с validation set повезло, другой нет. Выбирая минимум из многих шумных чисел, ты систематически выбираешь ту, которой повезло. Её validation error окажется ниже настоящей ошибки на новых данных — и тем заметнее, чем больше конфигураций участвовало в отборе.
Крайний случай показывает это лучше всего. Пусть 20 конфигураций на самом деле одинаково хороши, а их \(E_{\mathrm{val}}\) различаются только шумом.
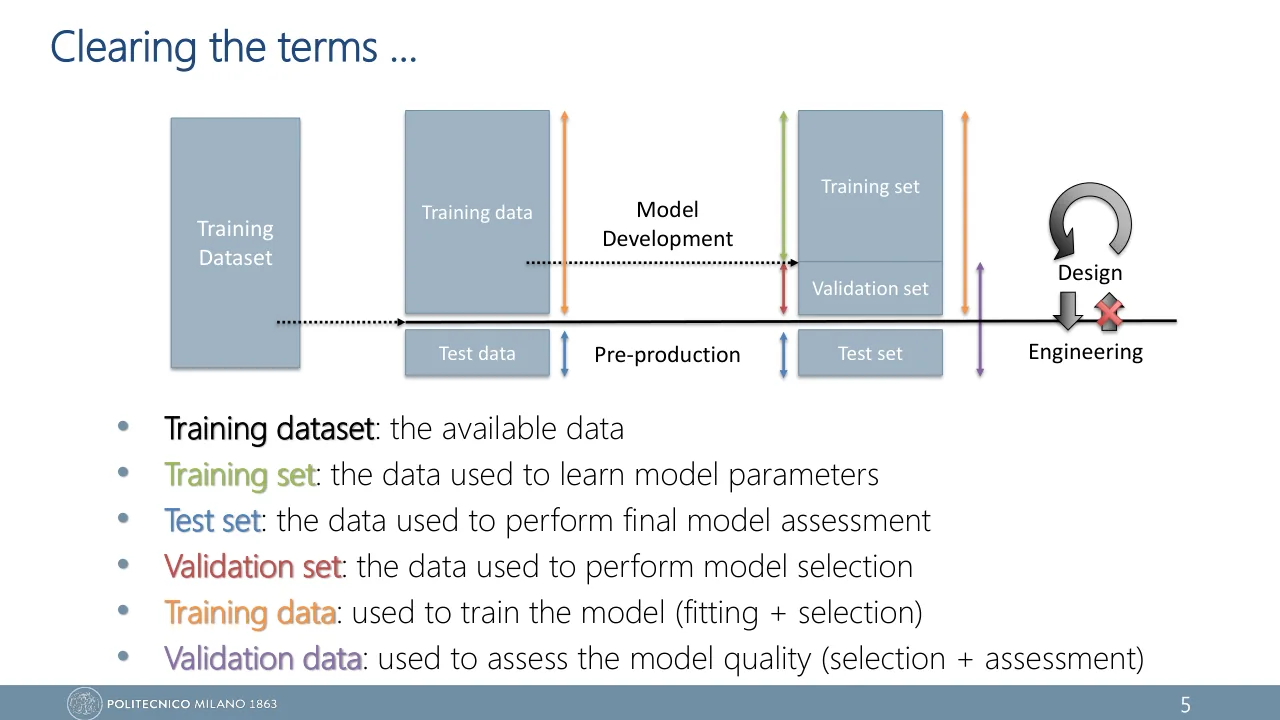
Слайды разводят роли наборов так же (лекция 3, слайд 5): "Validation set: the data used to perform model selection", "Test set: the data used to perform final model assessment". Поэтому подпись "Generalization error with J neurons in 1 layer" (лекция 3, слайд 13) читай аккуратно. \(E_{ES}^{J^{(1)}}(x|w)\) — оценка ошибки обобщения, по которой модели сравнивают между собой. Для победителя она занижена, и итоговую оценку даёт test set.
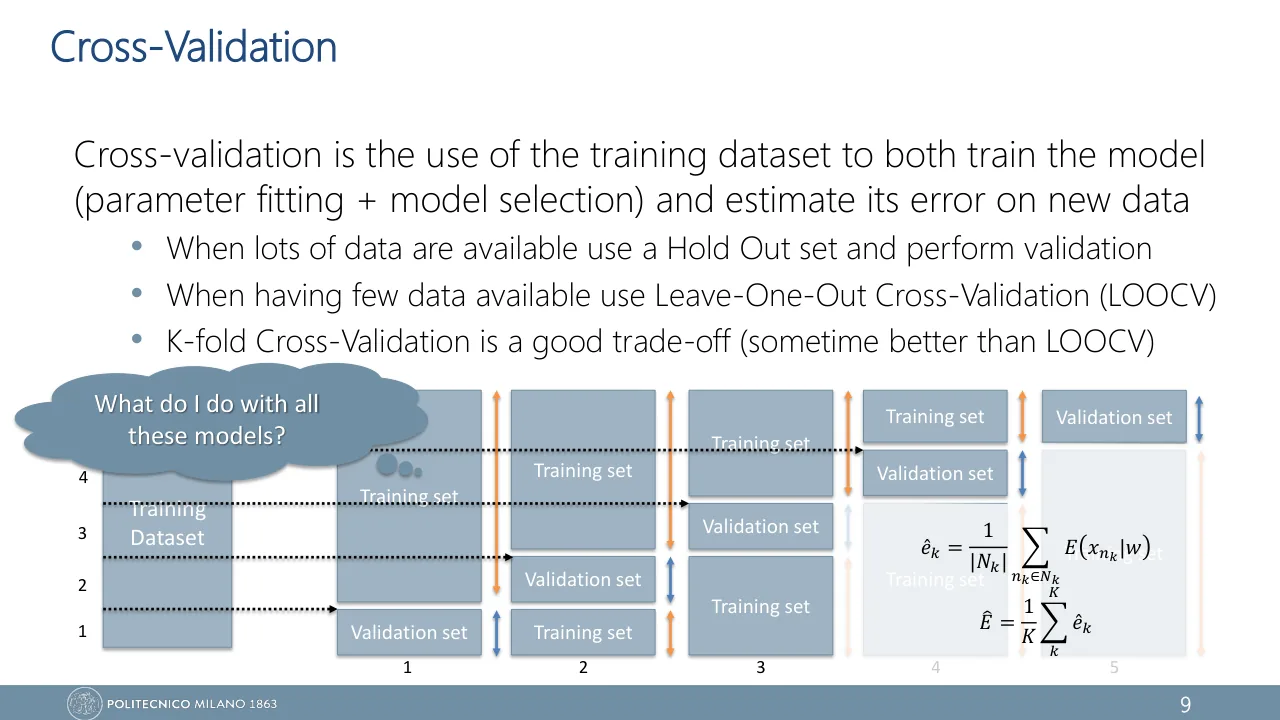
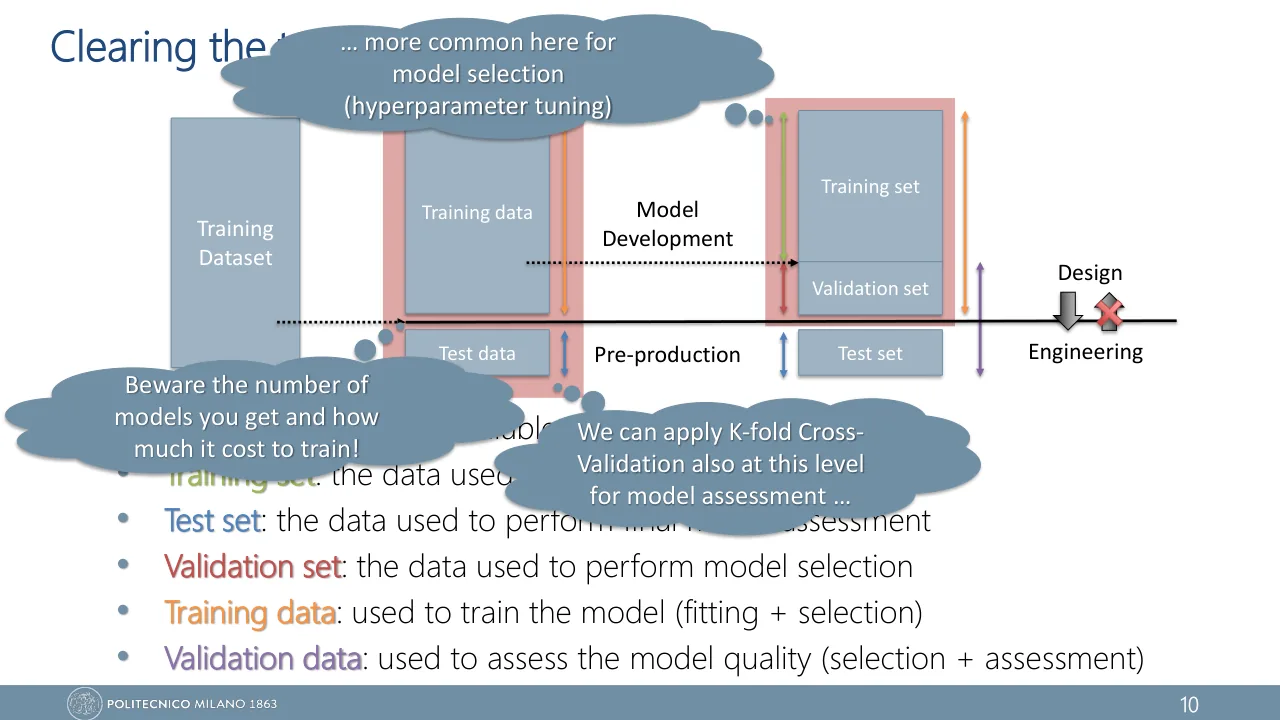
Если данных мало и отдельный validation set — роскошь, вместо одного разбиения берут K-fold cross-validation (урок 19): каждая конфигурация обучается \(K\) раз, а её \(E_{\mathrm{val}}\) — среднее по fold'ам, на слайдах \(\hat{E}\) (лекция 3, слайд 9). Цена подбора растёт в \(K\) раз. Об этом же две подписи на слайде про термины (лекция 3, слайд 10): K-fold "more common here for model selection (hyperparameter tuning)" и "Beware the number of models you get and how much it cost to train!".
Число эпох в перебор обычно не включают: early stopping подбирает его внутри каждого обучения бесплатно.
Grid search против random search
Grid search: все клетки таблицы
Для каждой ручки выписывают несколько значений и обучают сеть для каждой комбинации. Пример из конспекта:
\[ \eta \in \{0.001,\ 0.01,\ 0.1\} \] \[ \gamma \in \{0.01,\ 0.1,\ 1.0\} \] \[ \mathrm{layers} \in \{2,\ 3,\ 4\} \]Список кандидатов — декартово произведение этих множеств, а его размер — произведение их размеров.
\[ |\Theta| = \prod_{j=1}^{p} n_j \]
\[ T = K \cdot \prod_{j=1}^{p} n_j \]
- \(|\Theta|\)
- число конфигураций в сетке
- \(p\)
- сколько ручек перебирается
- \(n_j\)
- сколько значений выписано для ручки \(j\)
- \(T\)
- сколько сетей придётся обучить
- \(K\)
- число fold'ов; при одном validation set \(K = 1\)
В примере это \(3 \cdot 3 \cdot 3 = 27\) обучений, с 5-fold cross-validation — 135. Метод простой и хорошо параллелится: клетки независимы. Беда в показателе степени. Шесть ручек по пять значений — уже \(5^6 = 15\,625\) обучений. Grid search годится, только когда ручек две-три.
Random search: бросок костей
Вместо таблицы каждой ручке назначают распределение и \(N\) раз независимо бросают все ручки сразу: \(\theta_i \sim P(\theta)\). Здесь \(N\) — число проб, как в конспекте, а не размер training set. Бюджет \(N\) выбираешь ты, и он не обязан быть произведением: можно остановиться после любого обучения или добавить ещё десять. Броски независимы, поэтому параллелится метод так же легко, как сетка.
Слабых мест у него два, и конспект называет оба. Метод по-прежнему слепой: следующая проба не учитывает предыдущие. И гарантий нет: при невезении все \(N\) точек лягут мимо хорошей области.
А теперь задача из начала урока. Доска ниже модельная: validation error на ней сильно зависит от одной ручки и почти не зависит от другой.
У этого наблюдения есть название: low effective dimensionality, низкая эффективная размерность. Validation error обычно сильно зависит от одной-двух ручек из многих, причём от каких именно — заранее неизвестно. Сетка тратит обучения на то, чтобы повторять одни и те же значения важной ручки при разных значениях неважной. Случайные точки не повторяются ни по одной оси.
Сколько бросков нужно
У random search есть ещё одно удобное свойство: шанс попасть в хорошую область считается в одну строку.
-
Назовём «хорошей» лучшую долю \(q\) области поиска, например \(q = 0.05\). Одна случайная конфигурация попадает туда с вероятностью \(q\), а промахивается с вероятностью
\[ 1 - q . \] -
Броски независимы, поэтому вероятности промахов перемножаются. Все \(N\) конфигураций мимо:
\[ (1 - q)^N . \] -
«Хотя бы одна попала» — противоположное событие:
\[ P = 1 - (1 - q)^N . \] -
Подставим \(q = 0.05\). Вероятность растёт быстро:
\[ N = 10:\ 0.40 \qquad N = 20:\ 0.64 \] \[ N = 30:\ 0.79 \qquad N = 60:\ 0.95 \] -
Сколько бросков нужно, чтобы вероятность была не меньше заданной \(P\)? Перенесём единицу и возьмём логарифм обеих частей:
\[ (1 - q)^N \le 1 - P \] \[ N \ln(1 - q) \le \ln(1 - P) \]Число \(\ln(1 - q)\) отрицательно, поэтому при делении на него знак неравенства переворачивается:
\[ N \ge \frac{\ln(1 - P)}{\ln(1 - q)} \]Для \(P = 0.95\) и \(q = 0.05\) получается \(N \ge 58.4\), то есть 59 обучений. В формуле нет числа ручек: шестьдесят бросков с вероятностью 0.95 дают конфигурацию из лучших 5 %, сколько бы hyperparameters ни перебиралось.
«Шестьдесят бросков находят оптимум». Нет: они находят точку из лучших 5 % области поиска. Если по-настоящему хорошие настройки занимают тысячную долю этой области, шестидесяти бросков мало. Формула честно считает попадания, а насколько хороши «лучшие 5 %», зависит от того, какие диапазоны заданы для поиска.
По какой шкале бросать
Ручки \(\eta\) и \(\gamma\) действуют как множители: шаг от 0.001 к 0.01 так же значим, как от 0.01 к 0.1. Поэтому их перебирают по логарифмической шкале: равномерно бросают не саму \(\eta\), а её показатель степени.
\[ u \sim \mathrm{Uniform}(-3,\, -1), \qquad \eta = 10^{u} \]Это и есть LogUniform. Что случится, если равномерно бросать саму \(\eta\), видно на рис. 6.
До: Uniform(0.001, 0.1)
После: LogUniform(0.001, 0.1)
«\(\eta \sim \mathrm{Uniform}(0.001,\ 0.1)\)» — так в конспекте записан пример для random search. При таком распределении доля проб ниже 0.01 равна \(0.009 / 0.099 \approx 0.09\): девять обучений из десяти уйдут в верхнюю декаду. Для \(\gamma\) в том же примере стоит LogUniform — так же надо поступать и с \(\eta\).
Вторая практическая привычка — искать в два захода, от грубого к точному (coarse to fine). Сначала широкий диапазон и мало проб: цель — понять, в какой области вообще есть жизнь. Потом диапазон сужают вокруг лучших точек и бросают снова.
Bayesian optimisation: поиск с блокнотом
У grid и random общий недостаток: они слепые. Девятая проба выбирается так, будто первых восьми не было. Опытный пекарь так не делает. После каждой буханки он записывает результат в блокнот, прикидывает, как вкус зависит от настроек, и следующую пробу ставит туда, где ждёт лучшего, — или туда, где ещё ничего не понятно.
Bayesian optimisation делает именно это. Она считает \(f(\theta) = E_{\mathrm{val}}(\theta)\) дорогим «чёрным ящиком» и на каждом шаге повторяет четыре действия.
- Surrogate model (модель-заместитель). По уже сделанным пробам \(H = \{(\theta_i, e_i)\}\) строится дешёвая вероятностная модель функции \(f\), например Gaussian Process или Tree-structured Parzen Estimator (в конспекте — «Tree Parzen Estimator»). Для каждой \(\theta\) она выдаёт два числа: прогноз \(\mu(\theta)\) и неуверенность \(s(\theta)\). Рядом с обученными точками \(s\) мала, вдали от них велика.
- Acquisition function (функция полезности пробы). По \(\mu\) и \(s\) считается, насколько выгодно обучить сеть в точке \(\theta\). Она взвешивает exploitation — идти туда, где прогноз хороший, — и exploration — идти туда, где неуверенность велика.
- Следующая проба ставится в максимум acquisition: \(\theta_{\mathrm{next}} = \argmax_{\theta}\, a(\theta \mid H)\).
- Сеть обучается с \(\theta_{\mathrm{next}}\), измеряется \(E_{\mathrm{val}}\), пара добавляется в \(H\), и всё повторяется с первого пункта.
Простейшая acquisition — оптимистичная оценка: берём прогноз и вычитаем из него неуверенность с коэффициентом \(\kappa\). Получается ответ на вопрос «насколько хорошо там может оказаться». Чем эта нижняя граница ниже, тем точка интереснее, поэтому acquisition — она же со знаком минус.
\[ a(\theta) = \kappa\, s(\theta) - \mu(\theta) \]
\[ \theta_{\mathrm{next}} = \argmax_{\theta}\ a(\theta) \]
- \(\mu(\theta)\)
- прогноз surrogate: какую \(E_{\mathrm{val}}\) ждём в точке \(\theta\)
- \(s(\theta)\)
- неуверенность surrogate в этом прогнозе
- \(\kappa\)
- вес exploration; при \(\kappa = 0\) остаётся чистая exploitation
Бюджет в Listing 8 конспекта устроен так: первые \(N_{\mathrm{init}}\) проб случайные, потому что блокнот пуст и прогноз строить не по чему. Дальше цикл идёт до общего числа обучений \(T\). Когда бюджет исчерпан, ответ — не минимум surrogate, а лучшая из реально обученных конфигураций:
\[ \theta^{*} = \argmin_{(\theta,\, e) \in H}\ e \]А что такое Expected Improvement, которое упоминает конспект?
Другая acquisition, без ручки \(\kappa\). Пусть \(e_{\mathrm{best}}\) — текущий рекорд. Expected Improvement спрашивает: на сколько в среднем новая проба его улучшит, если верить surrogate?
\[ EI(\theta) = \E\bigl[\max(e_{\mathrm{best}} - f(\theta),\ 0)\bigr] \]Для гауссовского прогноза это считается в явном виде, с \(z = (e_{\mathrm{best}} - \mu)/s\):
\[ EI(\theta) = (e_{\mathrm{best}} - \mu)\,\Phi(z) + s\,\varphi(z) \]Первое слагаемое велико там, где прогноз ниже рекорда (exploitation), второе — там, где велика неуверенность (exploration). Формулу знать не обязательно, смысл двух слагаемых — стоит.
За ум приходится платить. Плюсы: нужно гораздо меньше обучений, поиск подстраивается под уже увиденное, и это окупается, когда одно обучение идёт часами. Минусы: метод сложнее в реализации, плохо ладит с дискретными ручками вроде числа слоёв, каждая итерация дороже. И ещё один минус, которого в конспекте нет: в базовом виде поиск последовательный. Следующую пробу нельзя выбрать, пока не закончилась предыдущая, а клетки сетки и случайные броски можно раздать на сто машин сразу.
| Grid search | Random search | Bayesian optimisation | |
|---|---|---|---|
| Откуда следующая \(\theta\) | очередная клетка таблицы | бросок из \(P(\theta)\) | максимум acquisition |
| Смотрит на прошлые пробы | нет | нет | да |
| Число обучений | \(\prod_j n_j\): растёт экспоненциально | \(N\): сколько решишь | \(T\): обычно намного меньше |
| Параллельный запуск | да | да | плохо: пробы идут по очереди |
| Слабое место | цена; много обучений уходит на неважные ручки | слепой; может промахнуться случайно | сложная реализация; неудобен для дискретных ручек |
| Когда брать | две-три ручки, грубая прикидка | почти всегда как первый выбор | одно обучение очень дорогое |
«Bayesian optimisation — это байесовская нейросеть или MAP-оценка весов». Нет. Слово Bayesian относится к surrogate model: это она обновляет своё мнение о \(E_{\mathrm{val}}(\theta)\) после каждой пробы. Сама нейросеть обучается обычным gradient descent. Априорное распределение на веса и MAP — тема следующего урока, и это другая история.
Назад к девяти обучениям
Вернёмся к задаче из начала. Таблица 3 × 3 кажется надёжнее, потому что ровно покрывает плоскость. Но validation error зависит не от места на плоскости, а от значений отдельных ручек, и обычно в основном от одной. По этой одной ручке таблица делает всего три разные пробы, по три раза каждую. Девять случайных точек делают девять разных проб по каждой ручке сразу, какая бы из них ни оказалась важной.
Таблица выигрывает, только если линия сетки случайно прошла по дну долины. А где долина, заранее неизвестно — иначе не пришлось бы искать.
Отсюда рабочий порядок действий.
- Выпиши ручки и диапазоны. Для \(\eta\) и \(\gamma\) — на log-шкале.
- Первый заход — random search по широким диапазонам с небольшим бюджетом.
- Посмотри на результаты по каждой ручке отдельно, как в полосках на доске. Какая из них важная? Сузь диапазоны вокруг лучших проб и повтори.
- Если одно обучение идёт часами, переходи на Bayesian optimisation.
- Внутри каждого обучения оставь early stopping: число эпох подберётся само.
- Победителя один раз проверь на test set. Только это число можно называть оценкой обобщения.
В формате экзамена
Explain the difference between the parameters and the hyperparameters of a Feed Forward Neural Network. Why can the number of hidden neurons or the regularization strength \(\gamma\) not be selected by minimising the training error? What is the test set needed for?
Show model answer
Model selection happens at two levels. At the parameters level we learn the weights \(\vb{w}\) (biases included): gradient descent minimises the error function \(E(\vb{w})\) on the training set. At the hyperparameters level we choose the number of layers \(L\), the number of hidden neurons \(J^{(l)}\) of each layer \(l\) and the other settings that are fixed before training (learning rate, batch size, \(\gamma\), dropout rate); they control how learning proceeds and how complex the model can become.
The training error decreases as model capacity grows, so minimising it would always select the largest network and \(\gamma = 0\), i.e. the model that overfits most. Hyperparameters are therefore selected on data not used to fit the weights: we choose the model with the best validation error,
\[ \theta^{*} = \argmin_{\theta}\, E_{\mathrm{val}}(\theta) . \]The validation error of the selected configuration is the minimum of several noisy estimates, hence optimistically biased. An independent test set, used once at the end for the final model assessment, gives an unbiased estimate of the generalization error.
В полном ответе три вещи: кто подбирает каждую группу чисел и на каких данных; training error только убывает с ростом сложности; оценка после отбора смещена. Ответ «потому что так делают cross-validation» ничего не объясняет: нужна сама причина — по training error всегда победит самая сложная модель. Рамка первого абзаца взята со слайда (лекция 3, слайд 13): "Parameters level" и "Hyperparameters level". Запись \(\theta\) и \(E_{\mathrm{val}}\) — из конспекта; на слайде ту же ошибку обозначает \(E_{ES}^{J^{(1)}}(x|w)\).
You have to select the number of hidden neurons \(J^{(1)}\) of a network with one hidden layer. Describe the procedure, which relies on a validation set and on early stopping. Which quantity is compared across the candidate models? How does the procedure change when the hyperparameter is the weight decay coefficient \(\gamma\), and what do you do once the best value has been found?
Show model answer
Split the data in a training set and a validation set. For each candidate value of \(J^{(1)}\) train the network on the training set with early stopping: the training error keeps decreasing with the iterations \(k\), while the validation error reaches its minimum at \(k_{ES}\). Record the validation error at that point, \(E_{ES}^{J^{(1)}}(x|w)\): it estimates the generalization error with \(J^{(1)}\) neurons in one layer. Choose the model with the best (lowest) validation error.
For \(\gamma\) the scheme is the same. For different values of \(\gamma\) minimise on the training set
\[ \begin{aligned} E_{\gamma}^{TRAIN} = {} & \sum_{n=1}^{N_{TRAIN}} \bigl(t_n - g(x_n|\vb{w})\bigr)^2 \\ & + \gamma \sum_{q=1}^{Q} (w_q)^2 , \end{aligned} \]then evaluate each model on the validation set, without the penalty,
\[ E_{\gamma}^{VAL} = \sum_{n=1}^{N_{VAL}} \bigl(t_n - g(x_n|\vb{w})\bigr)^2 , \]and choose the \(\gamma^{*}\) with the best validation error. Finally put all the data back together and minimise again with \(\gamma^{*}\).
The validation error of the winner has been used to make the choice, so the final assessment of the selected model requires a separate test set.
Опорные фразы слайдов: "Chose model with best validation error" (лекция 3, слайд 13) и "Put back all data together and minimize" (лекция 3, слайд 16). В своём ответе пиши "choose": "chose" на слайдах — опечатка. Две детали теряют чаще всего: в \(E_{\gamma}^{VAL}\) нет штрафа, а после выбора сеть обучают заново на всех данных.
A network with one hidden layer is trained with early stopping for four values of \(J^{(1)}\). The validation errors at the early-stopping point are
\[ E_{ES}^{1} = 0.55, \quad E_{ES}^{2} = 0.38, \] \[ E_{ES}^{5} = 0.21, \quad E_{ES}^{9} = 0.24, \]and the training errors at the same points are 0.52, 0.33, 0.14 and 0.06. Which model do you select?
Show model answer
\(J^{(1)} = 5\): choose the model with the best validation error, \(E_{ES}^{5} = 0.21\). The training error cannot be used for the choice: it keeps decreasing as the network grows.
Числа повторяют график слайда (лекция 3, слайд 13): ошибка падает до пяти нейронов, а у девяти она чуть выше.
A grid search explores 4 hyperparameters with 5 candidate values each. Every configuration is evaluated with 5-fold cross-validation. How many networks are trained in total?
Show model answer
\[ |\Theta| = 5^4 = 625 \ \mathrm{configurations} \]
\[ 625 \cdot 5 = 3125 \ \mathrm{trainings} \]
Две типичные ошибки: сложить вместо того, чтобы перемножить (\(4 \cdot 5 = 20\)), и забыть множитель \(K\) от cross-validation. Сам grid search на слайдах третьей лекции не назван: вопрос опирается на конспект.
A random search draws \(N = 20\) independent configurations. What is the probability that at least one of them falls in the best 5% of the search space? Give a number between 0 and 1.
Show model answer
Each trial misses the region with probability \(0.95\); the trials are independent.
\[ P = 1 - 0.95^{20} = 1 - 0.358 = 0.642 \]Считается через противоположное событие «все двадцать мимо». На калькуляторе: клавиша \(x^y\). Ответ \(20 \cdot 0.05 = 1\) — признак того, что вероятности сложены, а так можно только для несовместных событий. Random search на слайдах третьей лекции тоже нет: вопрос по конспекту.
Which statements about hyperparameter search are correct? Select all that apply.
Show model answer
Correct: the first, the third and the fourth statement.
Каждое утверждение проверяй отдельно, как вопрос «верно или нет», и отмечай только то, что можешь обосновать одной фразой. Две ловушки здесь построены на перестановке: свойство Bayesian optimisation приписано random search, а свойство test error — validation error. Три метода поиска — материал конспекта, на слайдах третьей лекции их нет.
Compare grid search, random search and Bayesian optimisation for hyperparameter tuning. Why is random search usually preferred to grid search when the budget of trainings is the same?
Show model answer
All three minimise the validation error \(E_{\mathrm{val}}(\theta)\) with the same loop (propose a configuration, train, evaluate); they differ in how the next configuration is proposed.
Grid search evaluates every combination of predefined values: simple and parallelisable, but the cost \(\prod_j n_j\) is exponential in the number of hyperparameters. Random search samples \(N\) configurations from chosen distributions (log-uniform for \(\eta\) and \(\gamma\)): the budget \(N\) is chosen freely and the trials run in parallel, but it ignores previous trials and may miss the good region by chance. Bayesian optimisation fits a probabilistic surrogate model to the past trials and chooses the next configuration by maximising an acquisition function that balances exploration (uncertain regions) and exploitation (promising regions): far fewer trainings, but more machinery and inherently sequential.
Random search is preferred to grid search because the validation error usually depends strongly on only a few hyperparameters. An \(n \times n\) grid tests only \(n\) distinct values of the important one, while \(N = n^2\) random trials test \(N\) distinct values of every hyperparameter.
Ключевая фраза для полного балла — про число разных значений важного hyperparameter. Простое «random is more efficient» повторяет конспект, но ничего не объясняет. Вопрос целиком по конспекту: на слайдах третьей лекции этих трёх методов нет.
The mini-batch size \(M\) is reduced from 64 to 4, everything else unchanged. The mini-batch estimate of the gradient becomes…
Show model answer
Noisier but still unbiased: the estimate is a sample mean of \(M\) per-sample gradients, its variance scales as \(1/M\).
Слова со слайда, которые стоит использовать в открытом ответе (лекция 2, слайд 28): unbiased, high variance, trade off variance-computation.
Проверь себя
Что из перечисленного — hyperparameters?
Быстрый тест: если число меняется на каждом шаге gradient descent — это parameter. Если его надо знать, чтобы запустить обучение, — hyperparameter.
Число скрытых нейронов выбирают из вариантов 5, 20, 80 и 320 по training error. Какой вариант победит?
Важна только \(\eta\). Сетка 4 × 4 против 16 случайных точек. Сколько разных значений \(\eta\) попробует каждый метод?
Из 50 конфигураций выбрана лучшая, её \(E_{\mathrm{val}} = 0.12\). Какой ошибки разумно ждать на test set?
\(\eta\) бросают как \(\mathrm{Uniform}(0.001,\ 0.1)\). Какая доля проб окажется ниже 0.01?
Где acquisition \(a(\theta) = \kappa\,s(\theta) - \mu(\theta)\) при \(\kappa \gt 0\) принимает большие значения?
Bayesian optimisation запущена с \(\kappa = 0\). Что произойдёт вероятнее всего?
Унести с собой
- Выбор модели идёт на двух уровнях (лекция 3, слайд 13). Parameters level: веса и смещения \(\vb{w}\) подбирает gradient descent на training set. Hyperparameters level: \(L\), \(J^{(l)}\), \(\eta\), \(M\), \(\gamma\), dropout rate фиксируют до обучения и выбирают по validation error.
- По training error выбирать нельзя: она убывает с ростом сложности и всегда выберет самую большую сеть без регуляризации. Правило со слайда (лекция 3, слайд 13): "Chose model with best validation error".
- Ручки делятся по действию: добавляют сложность (\(L\), \(J^{(l)}\)), отнимают её (\(\gamma\), dropout rate), управляют спуском (\(\eta\), \(M\)). Меньший mini-batch даёт более шумную оценку градиента, а не более точную.
- Подбор — один цикл: предложить \(\theta\), обучить, измерить. На слайдах он показан дважды (лекция 3, слайды 13 и 16): для \(J^{(1)}\), где сравнивают \(E_{ES}^{J^{(1)}}(x|w)\), и для \(\gamma\), где сравнивают \(E_{\gamma}^{VAL}\), а потом обучают заново на всех данных. Validation error победителя занижена, поэтому test set в конце обязателен.
- Три способа предлагать \(\theta\) — из конспекта, на слайдах третьей лекции их нет. Grid search стоит \(\prod_j n_j\) обучений и пробует только \(n\) значений каждой ручки; random search при том же бюджете пробует \(N\) значений каждой.
- \(\eta\) и \(\gamma\) перебирают на log-шкале и в два захода: сначала грубо и широко, потом мелко вокруг лучших проб.
- Bayesian optimisation строит surrogate с прогнозом \(\mu\) и неуверенностью \(s\) и ставит следующую пробу в максимум acquisition. Цена — сложность и последовательный запуск.
Что посмотреть и почитать
-
TensorFlow Playground
Daniel Smilkov, Shan Carter
Покрути те же ручки руками: число слоёв и нейронов, learning rate, regularization rate, batch size. Десять минут ручного подбора лучше всего объясняют, зачем нужен автоматический.
-
CS231n: Neural Networks Part 3, Learning and Evaluation
Stanford, A. Karpathy и др.
Раздел про hyperparameter optimization — практическая шпаргалка к этому уроку: log-шкала, random вместо grid, от грубого к точному.
-
Random Search for Hyper-Parameter Optimization
James Bergstra, Yoshua Bengio · JMLR, 2012
Нужны только abstract и Figure 1: та самая картинка с девятью точками, которую повторяет первая доска.
-
Exploring Bayesian Optimization
Apoorv Agnihotri, Nipun Batra · Distill, 2020
Surrogate model и acquisition functions с интерактивными картинками. Читай, когда второй виджет понятен и хочется увидеть Expected Improvement в деле.
-
Deep Learning Tuning Playbook
Godbole, Dahl, Gilmer, Shallue, Nado · Google
Как подбор устроен в большой практике. Пригодится к challenge: там, например, советуют выбирать batch size ради скорости обучения, а не ради validation error.