Пружины на весах
После этого урока ты запишешь error function с weight decay, сделаешь шаг градиентного спуска «с усадкой», выведешь штраф из Gaussian prior и объяснишь, чему равна \(\gamma\) и как её выбирают.
Десять точек: синусоида с шумом, все значения лежат между −1.5 и 1.1. Через десять точек можно провести многочлен девятой степени — у него как раз десять коэффициентов. Он пройдёт через каждую точку, ошибка на обучении ровно ноль. Теперь загляни в сами коэффициенты: −196, 123, 109, 104. Числа в сотни, чтобы описать данные размером с единицу.
Привяжи каждый коэффициент к нулю слабой пружиной. Кривая перестанет попадать точно в точки, зато на десяти новых точках ошибка упадёт с 5.99 до 1.33. Вся пружина — одно слагаемое в error function (функции ошибки): \(\gamma \sum_q w_q^2\).
Два вопроса на этот урок. Почему запрет на большие числа лечит переобучение? И почему именно квадрат: кто решил, что пружина — «правильное» наказание? К концу окажется, что этот квадрат — колокол Гаусса, с которого сняли логарифм, а жёсткость пружины задаётся отношением двух дисперсий.
Большие веса — инструмент переобучения
В уроке 17 бритва Оккама советовала: из моделей, которые одинаково хорошо объясняют данные, бери простую. В уроке 20 сложность ограничивали временем: early stopping (ранняя остановка) прерывал обучение, пока сеть не начала заучивать шум. Сегодня второй способ — ограничить сами веса. Третий, dropout, ждёт в уроке 23.
Сначала о том, чем плохи большие веса. Вернись к многочлену из задачки. Чтобы пройти через все десять шумных точек, кривой приходится резко поворачивать между ними. Резкий поворот многочлен умеет делать одним способом: взять огромные коэффициенты с разными знаками, которые почти уничтожают друг друга. Сумма получается маленькой, но стоит чуть сдвинуть \(x\) — баланс рушится, и кривая улетает.
У нейронной сети та же история, и её проще увидеть. Возьми один скрытый нейрон с одним входом: \(h = \tanh(wx)\).
Маленький вес: \(h = \tanh(0.3x)\)
Большой вес: \(h = \tanh(10x)\)
Сеть из нейронов с маленькими весами близка к линейной функции — самой простой из возможных. Из ступенек же собирается сколь угодно изломанная функция, в том числе та, что проходит через каждую шумную точку.
Большие веса — инструмент переобучения: без них сеть не может строить резкие изгибы, которыми заучивают шум.
Конспект говорит то же одной фразой (стр. 164): сеть, которой позволили свободно минимизировать ошибку, может взять очень большие веса, чтобы подогнать каждую деталь. Отсюда идея: сделать большие веса дорогими.
Штраф за размер весов
У идеи «заранее ограничить модель» есть имя, и слайды начинают тему именно с него.
Regularization (регуляризация) — ограничение «свободы» модели, которое опирается на априорное предположение о ней и нужно, чтобы уменьшить переобучение. Это определение профессора (лекция 3, слайд 14): там сказано "constraining the model «freedom»", а предположение названо a-priori assumption.
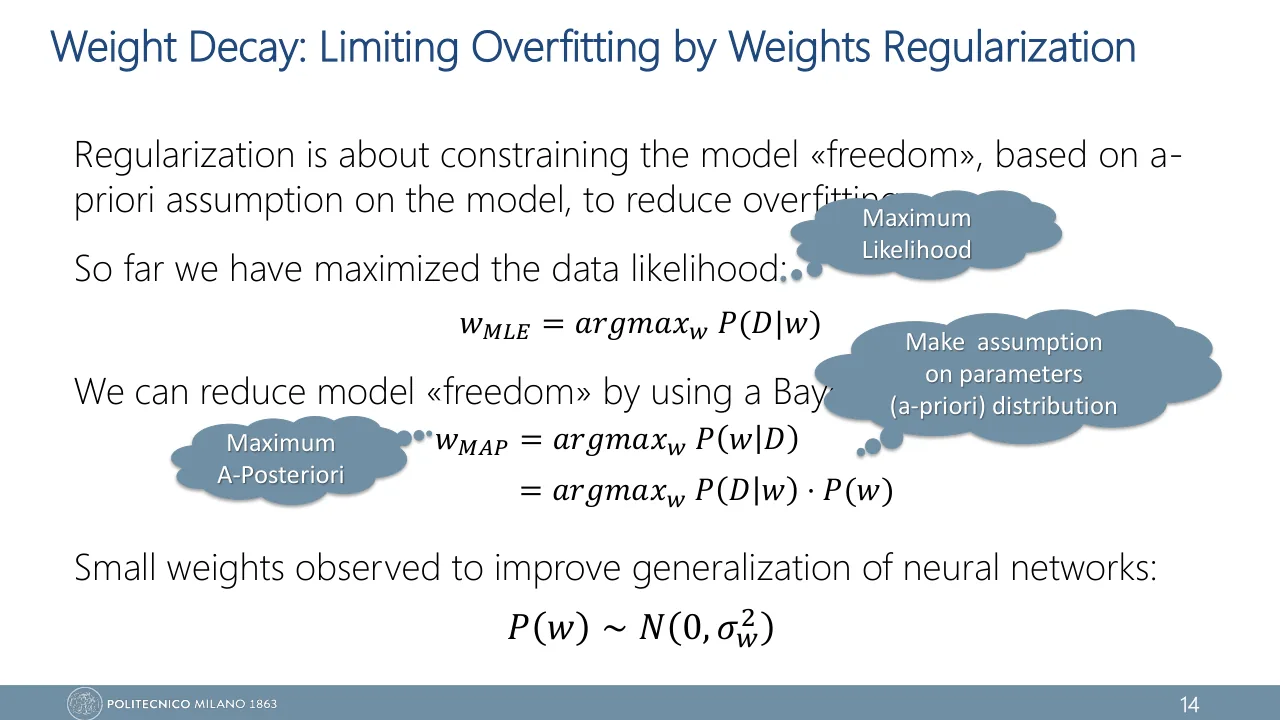
У weight decay предположение такое: веса сети малы. Способ прямолинейный: к ошибке на данных прибавляют слагаемое, которое растёт вместе с весами.
Weight decay («затухание весов»), или L2 regularization (L2-регуляризация), — приём против переобучения: к error function добавляют штраф, пропорциональный сумме квадратов всех весов сети. Архитектура и число весов остаются прежними; меняется то, какие значения весов выгодны. На слайдах (лекция 3, слайды 14–15) приём называется weight decay или weights regularization; названия «L2» там нет, оно из конспекта (стр. 164).
- \(t_n\)
- target (целевое значение) для примера \(n\)
- \(g(x_n|\vb{w})\)
- выход сети; первое слагаемое — Sum of Squared Errors (сумма квадратов ошибок) на training set
- \(w_q\)
- \(q\)-й вес: один индекс \(q\) перебирает подряд все веса \(w_{ji}^{(l)}\) всех слоёв
- \(Q\)
- число весов сети: \(q = 1, \dots, Q\)
- \(\gamma\)
- regularization parameter, он же weight decay coefficient: сила штрафа, \(\gamma \ge 0\)
В таком виде функция стоит у профессора (лекция 3, слайд 15), с теми же подписями под слагаемыми: Fitting и Regularization. Пределы суммы по весам, от \(q = 1\) до \(Q\), тоже оттуда; дальше в уроке для краткости стоит \(\sum_q\). Откуда эта сумма берётся на слайде, покажет раздел 4.
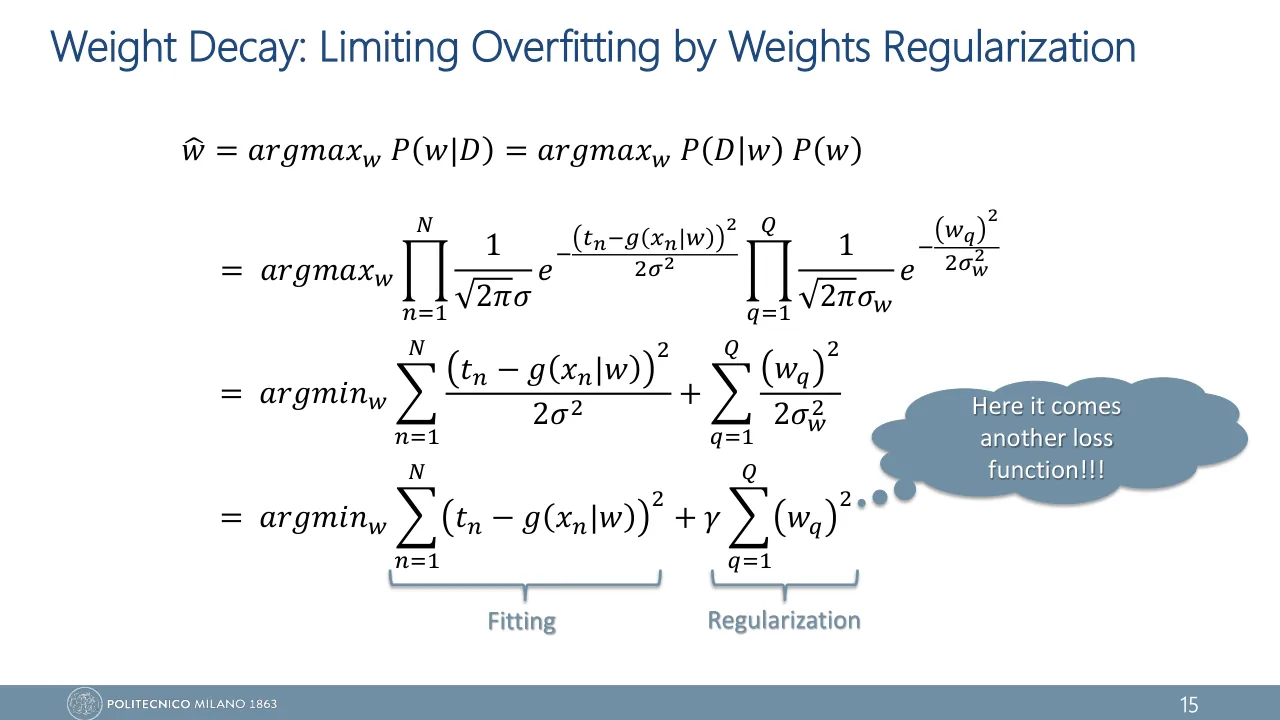
Теперь оптимизатор ищет компромисс. Вырастить вес стоит денег: большой \(w_q\) окупится, только если он уменьшает первое слагаемое сильнее, чем увеличивает второе.
Пружина здесь не просто образ. Энергия пружины жёсткости \(k\), растянутой на \(w\), равна \(\tfrac{1}{2}kw^2\). Штраф \(\gamma w_q^2\) — это в точности энергия пружины жёсткости \(2\gamma\), привязавшей вес к нулю. Конспект так и пишет: оптимизатор минимизирует «both error and weight energy».
\(y_i\) — target, \(f(x_i; w)\) — выход сети.
\(t_n\) вместо \(y_i\), \(g(x_n|\vb{w})\) вместо \(f(x_i; w)\).
Ошибка — Sum of Squared Errors, без \(\frac{1}{N}\); штраф без \(\frac{1}{2}\), сумма по \(q\) от 1 до \(Q\).
Смысл один, отличается масштаб: множители \(\frac{1}{2}\) и \(\frac{1}{N}\) прячутся в \(\gamma\). Поэтому число \(\gamma\) из одного источника нельзя переносить в формулу другого, не посмотрев, как записан штраф.
Что делает \(\gamma\)
При \(\gamma = 0\) штрафа нет — обычное обучение. Маленькая \(\gamma\) почти не мешает весам расти: модель гибкая, у неё большая variance (разброс). Большая \(\gamma\) прижимает веса к нулю: модель простая, растёт bias (систематическая ошибка). Где-то между ними ошибка на новых данных минимальна.
Обрати внимание: ни один вес не удалён. Номинальная ёмкость сети — число весов — прежняя. Уменьшилась эффективная ёмкость (effective capacity): какой частью своей свободы сеть реально пользуется.
Если всё это кажется знакомым — так и есть. Для модели, линейной по весам, weight decay — это ridge regression (гребневая регрессия) из Applied Statistics, и минимум находится точно: \(\vb{w} = (X\T X + \gamma I)^{-1} X\T \vb{t}\). Многочлен линеен по своим коэффициентам, поэтому в лаборатории ниже градиентный спуск не нужен.
«Чем сильнее регуляризация, тем безопаснее». Нет: \(E_{\mathrm{val}}\) как функция \(\gamma\) имеет форму U. Слишком большая \(\gamma\) даёт underfitting — и на первой выборке лаборатории это оказалось хуже, чем полное отсутствие штрафа: 7.89 против 5.99.
Почему decay: каждый шаг сжимает вес
Название weight decay («затухание весов») становится понятным, если записать шаг градиентного спуска. На слайдах лекции 3 такого шага нет: там есть только сама функция ошибки (слайд 15), а шаг получается из неё дифференцированием. Производная штрафа \(\gamma w_q^2\) по \(w_q\) равна \(2\gamma w_q\), поэтому:
- \(\eta\)
- learning rate (шаг обучения)
- \(E_{\mathrm{train}}\)
- первое слагаемое: ошибка на данных, без штрафа
- \(1 - 2\eta\gamma\)
- множитель чуть меньше единицы
Вторая строка — это первая, в которой собраны слагаемые с \(w_q\). Она читается как два действия: сначала вес умножают на число чуть меньше единицы, потом делают обычный шаг по градиенту ошибки на данных.
Без штрафа: 2.00 → 1.95
Со штрафом: 2.00 → 1.90 → 1.85
Если данные про этот вес молчат — градиент ошибки равен нулю, — остаётся одна усадка, и после \(k\) шагов от веса остаётся доля \((1 - 2\eta\gamma)^k\). Это геометрическое затухание, отсюда слово decay. При \(\eta = 0.1\), \(\gamma = 0.01\) множитель равен 0.998, и за 347 шагов вес уменьшается вдвое. Вес выживает, только если данные на каждом шаге заново за него «платят».
Производная штрафа: \(2\gamma w_q\).
Множитель усадки: \(1 - 2\eta\gamma\).
Производная штрафа: \(\gamma w_q\).
Множитель усадки: \(1 - \eta\gamma\). Половинку в штрафе ставят как раз затем, чтобы сократить двойку.
Проверь на числах \(w = 2\), \(\partial E_{\mathrm{train}}/\partial w = 0.5\), \(\eta = 0.1\), \(\gamma = 0.01\). Шаг по градиенту в обоих случаях равен \(0.1 \cdot 0.5 = 0.05\), отличается только усадка:
- запись конспекта, множитель 0.999: \(0.999 \cdot 2 - 0.05 = 1.948\);
- запись слайда 15, множитель 0.998: \(0.998 \cdot 2 - 0.05 = 1.946\);
- без штрафа: \(2 - 0.05 = 1.95\).
На экзамене сначала посмотри, как в условии записан штраф, и продифференцируй именно его. Формула шага получается в одну строку, а перепутанная двойка стоит балла.
Не все веса сжимаются одинаково
Пружины у всех весов одинаковые, а результат разный. Он зависит от того, насколько крепко данные «держат» вес.
В направлении, где ошибка на данных круто растёт, пружина почти ничего не сдвигает. В пологом направлении, где данным всё равно, вес уезжает к нулю почти без сопротивления. Weight decay убирает не «всё понемногу», а в первую очередь то, что данные не подтверждают.
Насколько именно сжимается каждое направление?
Около минимума ошибка на данных похожа на чашу. Если вдоль направления \(i\) она равна \(\lambda_i (w_i - w_i^{*})^2\), где \(w_i^{*}\) — положение минимума без штрафа, а \(\lambda_i\) — крутизна, то минимум суммы со штрафом \(\gamma w_i^2\) находится из равенства нулю производной:
\[ w_i = \frac{\lambda_i}{\lambda_i + \gamma}\, w_i^{*} \]При \(\gamma = 1\): крутое направление \(\lambda = 10\) сохраняет долю 0.91, среднее \(\lambda = 1\) — ровно половину, пологое \(\lambda = 0.1\) — всего 0.09. Это та же картина, что у ridge regression в Applied Statistics: сильнее всего сжимаются направления, вдоль которых данные почти не меняются, — главные компоненты с малой дисперсией.
И ещё одно чтение рис. 4. В точке \(w_{\mathrm{MAP}}\) эллипс ошибки касается круга штрафа. Значит, ту же точку даёт задача с ограничением: минимизировать ошибку на данных при условии \(\sum_q w_q^2 \le C\). Коэффициент \(\gamma\) в ней — множитель Лагранжа: чем больше \(\gamma\), тем меньше круг \(C\).
Ещё одно следствие квадрата. Пусть два входа несут одно и то же, и сети нужно \(w_1 + w_2 = 1\). Вариант \((1, 0)\) стоит \(1^2 + 0^2 = 1\), вариант \((0.5, 0.5)\) — вдвое дешевле: 0.5. L2 предпочитает раздать вес поровну, а не ставить всё на один вход. Конспект называет это distributed representation (распределённое представление).
Смещения \(w_0\) обычно не штрафуют: сдвиг функции вверх-вниз не делает её сложнее. Это практика, а не слайды: на слайде 15 лекции 3 штраф — сумма по всем \(Q\) весам без оговорок, и на экзамене формулу пиши так. А входы перед обучением стандартизуют (z-standardisation из Applied Statistics), иначе штраф зависит от единиц измерения: вес при входе в миллиметрах в тысячу раз меньше, чем при том же входе в метрах, и пружина его почти не заметит.
Откуда квадрат: от MLE к MAP
Пока штраф выглядит как удачный трюк. Теперь покажем, что он следует из одного предположения о весах — так же, как в уроке 15 Sum of Squared Errors следовала из предположения о шуме.
Напоминание. MLE выбирает веса, при которых наблюдаемые данные наиболее вероятны: \(\vb{w}_{\mathrm{MLE}} = \argmax_{\vb{w}} P(D|\vb{w})\). Эта формула с подписью Maximum Likelihood стоит и у профессора (лекция 3, слайд 14), с напоминанием: до сих пор максимизировали именно likelihood данных. При гауссовом шуме это то же, что минимизировать сумму квадратов ошибок. У MLE нет мнения о самих весах: огромные и крошечные для неё равноправны, лишь бы данные объяснялись.
А у тебя такое мнение часто есть. Термометр за окном в июле показывает −5 °C. Ты не поверишь: ещё до измерения известно, какие температуры в июле правдоподобны. Это знание называется prior (априорное распределение). Показание термометра — данные. Разумный вывод лежит между ними, и тем ближе к prior, чем хуже термометр.
Правило Байеса записывает это рассуждение одной строкой.
- \(P(\vb{w}|D)\)
- posterior (апостериорное распределение): что мы думаем о весах после того, как увидели данные
- \(P(D|\vb{w})\)
- likelihood (правдоподобие): то же, что в MLE
- \(P(\vb{w})\)
- prior, на слайде 14 — a-priori distribution параметров: что мы думали о весах до данных
- \(P(D)\)
- evidence: нормировочная константа, от \(\vb{w}\) не зависит
MAP (Maximum A Posteriori, на слайде 14 — Maximum A-Posteriori) — оценка весов, при которой posterior максимален: \(\vb{w}_{\mathrm{MAP}} = \argmax_{\vb{w}} P(\vb{w}|D)\). От MLE она отличается одним множителем — prior.
На слайде 14 этот ход назван Bayesian approach (байесовский подход): он уменьшает «свободу» модели, потому что к данным добавлено предположение об априорном распределении параметров. Это то самое a-priori assumption из определения регуляризации.
Какой prior взять для весов сети? Самый простой, который говорит «веса скорее маленькие»: каждый вес независимо от других распределён нормально вокруг нуля, \(w_q \sim N(0, \sigma_w^2)\). Дисперсия \(\sigma_w^2\) — мера уверенности. Узкий колокол: «веса почти наверняка около нуля». Широкий: «могут быть и большими».
Слайд 14 обосновывает этот выбор одним наблюдением: у сетей с малыми весами обобщение лучше. Сам prior записан там сокращённо: \(P(\vb{w}) \sim N(0, \sigma_w^2)\). Слева стоит распределение, хотя нормально распределён сам вес. Читай запись слайда как \(w_q \sim N(0, \sigma_w^2)\) для каждого из \(Q\) весов независимо: именно это подставлено в произведение на слайде 15.
Сам вывод занимает на слайде 15 лекции 3 четыре строки. Ниже те же строки по порядку, а между ними — шаги, которые слайд пропускает.
-
Строка 1 слайда. Оценка обозначена там \(\hat{\vb{w}}\): это та же \(\vb{w}_{\mathrm{MAP}}\) со слайда 14. Второе равенство — правило Байеса без знаменателя: \(P(D)\) от \(\vb{w}\) не зависит и на положение максимума не влияет.
\[ \begin{aligned} \hat{\vb{w}} &= \argmax_{\vb{w}}\; P(\vb{w}|D) \\ &= \argmax_{\vb{w}}\; P(D|\vb{w})\,P(\vb{w}) \end{aligned} \] -
Likelihood. Модель данных — та же, что в уроке 15: \(t_n = g_n + \epsilon_n\) с шумом \(\epsilon_n \sim N(0, \sigma^2)\); для краткости пишем \(g_n\) вместо \(g(x_n|\vb{w})\). Шумы независимы, поэтому вероятности отдельных примеров перемножаются:
\[ P(D|\vb{w}) = \prod_{n=1}^{N} \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{-\frac{(t_n - g_n)^2}{2\sigma^2}} \] -
Prior. Веса независимы, каждый распределён как \(N(0, \sigma_w^2)\) — тоже произведение, по одному множителю на каждый из \(Q\) весов:
\[ P(\vb{w}) = \prod_{q=1}^{Q} \frac{1}{\sqrt{2\pi}\,\sigma_w}\; e^{-\frac{w_q^2}{2\sigma_w^2}} \] -
Строка 2 слайда: оба произведения подставлены под \(\argmax\).
\[ \begin{aligned} \hat{\vb{w}} = \argmax_{\vb{w}}\; &\prod_{n=1}^{N} \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{-\frac{(t_n - g_n)^2}{2\sigma^2}} \\ {}\cdot{} &\prod_{q=1}^{Q} \frac{1}{\sqrt{2\pi}\,\sigma_w}\; e^{-\frac{w_q^2}{2\sigma_w^2}} \end{aligned} \] -
Логарифм. На слайде этого шага нет, он сделан молча. Логарифм монотонный: максимум остаётся на месте, а произведения превращаются в суммы. Поменяем знак и будем искать минимум. У каждого множителя экспонента даёт квадрат, а нормировка — константу:
\[ \begin{aligned} &-\log P(D|\vb{w}) \\ &\qquad = \sum_{n=1}^{N}\frac{(t_n - g_n)^2}{2\sigma^2} + c_1 \end{aligned} \] \[ \begin{aligned} &-\log P(\vb{w}) \\ &\qquad = \sum_{q=1}^{Q}\frac{w_q^2}{2\sigma_w^2} + c_2 \end{aligned} \]Вот где колокол Гаусса превращается в параболу: \(-\log e^{-w^2/2\sigma_w^2} = w^2 / 2\sigma_w^2\).
-
Строка 3 слайда. Складываем; константы \(c_1\), \(c_2\) не зависят от \(\vb{w}\) и на положение минимума не влияют — отбрасываем:
\[ \begin{aligned} \hat{\vb{w}} = \argmin_{\vb{w}} \Big[ &\sum_{n=1}^{N}\frac{(t_n - g_n)^2}{2\sigma^2} \\ &+ \sum_{q=1}^{Q}\frac{w_q^2}{2\sigma_w^2} \Big] \end{aligned} \] -
Строка 4, последняя. Умножим всё на \(2\sigma^2 \gt 0\): положение минимума от умножения на положительное число не меняется.
\[ \begin{aligned} \hat{\vb{w}} = \argmin_{\vb{w}} \Big[ &\sum_{n=1}^{N}(t_n - g_n)^2 \\ &+ \gamma\sum_{q=1}^{Q} w_q^2 \Big] \end{aligned} \]Это error function с weight decay: первое слагаемое на слайде подписано Fitting, второе — Regularization. Чему равна \(\gamma\), слайд не пишет. Сравни строки 3 и 4: перед штрафом стояло \(\frac{1}{2\sigma_w^2}\), умножение на \(2\sigma^2\) даёт
\[ \gamma = \frac{\sigma^2}{\sigma_w^2} \]
Weight decay — это MAP-оценка весов с Gaussian prior \(N(0, \sigma_w^2)\); коэффициент \(\gamma = \sigma^2 / \sigma_w^2\) — дисперсия шума, делённая на дисперсию prior.
Рядом с последней строкой на слайде 15 стоит выноска: "Here it comes another loss function!!!". В уроке 15 из MLE получились Sum of Squared Errors и crossentropy; MAP дал ещё одну функцию для минимизации. Loss function в этой реплике — то же, что error function.
Прочитай \(\gamma\) как дробь. Числитель \(\sigma^2\) — насколько шумны данные: шумным данным верят меньше, и \(\gamma\) растёт. Знаменатель \(\sigma_w^2\) — насколько широк prior: узкий prior означает сильную уверенность, что веса малы, и \(\gamma\) тоже растёт. Плоский prior, \(\sigma_w \to \infty\), даёт \(\gamma \to 0\) — и MAP превращается в MLE.
А если задача — классификация?
Меняется только likelihood. В уроке 15 для двух классов \(t_n \sim Be(g_n)\), и \(-\log P(D|\vb{w})\) — это Binary Crossentropy. Обозначим её \(E_{\mathrm{CE}}\):
\[ \begin{aligned} E_{\mathrm{CE}}(\vb{w}) = {} & -\sum_{n=1}^{N} \bigl[\, t_n \log g_n \\ & \quad + (1-t_n)\log(1-g_n) \,\bigr] \end{aligned} \]Prior и его логарифм те же, поэтому
\[ \begin{aligned} \vb{w}_{\mathrm{MAP}} = \argmin_{\vb{w}} \Big[ &E_{\mathrm{CE}}(\vb{w}) \\ &+ \frac{1}{2\sigma_w^2}\sum_{q} w_q^2 \Big] \end{aligned} \]Дисперсии шума здесь нет вовсе: силу штрафа задаёт одна \(\sigma_w^2\). Если ошибка — crossentropy, просуммированная по примерам без \(\frac{1}{N}\), то в записи конспекта \(\frac{\gamma}{2}\sum_q w_q^2\) получается \(\gamma = 1/\sigma_w^2\). Это тот случай, когда формула со стр. 167 верна буквально. Смысл прежний: узкий prior — сильный штраф.
Компромисс на одном весе
Посмотри, как это работает для единственного веса. Модель самая простая: \(t_n = w + \epsilon_n\). Наблюдений \(N\), их среднее равно 2, значит \(w_{\mathrm{MLE}} = 2\). Минимум \(\sum_n (t_n - w)^2 + \gamma w^2\) находится приравниванием производной к нулю:
\[ w_{\mathrm{MAP}} = \frac{N}{N + \gamma}\; w_{\mathrm{MLE}} \]Это и есть равновесие двух пружин с рис. 2: жёсткость пружины данных относится к жёсткости пружины prior как \(N\) к \(\gamma\). Какая жёстче, к той стороне вес и ближе.
В формуле видно то, чего не видно в самой \(\gamma\): с ростом \(N\) первое слагаемое ошибки растёт — в нём \(N\) квадратов, — а штраф остаётся прежним. Чем больше данных, тем меньше значит prior.
Prior для всех весов сразу
Весов в сети много, и prior задаётся на весь вектор \(\vb{w}\). Произведение независимых одномерных гауссиан — это многомерная гауссиана с диагональной ковариационной матрицей. Если дисперсии одинаковы, \(\Sigma = \sigma_w^2 I\), линии равной плотности — круги (в многомерном случае сферы), и
\[ -\log P(\vb{w}) = \frac{1}{2\sigma_w^2}\,\vb{w}\T\vb{w} + \text{const} \]То есть штраф зависит только от длины вектора весов — это и есть круги на рис. 4. Конспект (стр. 170–171) разбирает и общий случай.
Как общий случай выглядит формулой?
Для двух весов ковариационная матрица и плотность prior записаны в конспекте так (стр. 170):
\[ \Sigma = \begin{bmatrix} \sigma_1^2 & \rho\,\sigma_1\sigma_2 \\ \rho\,\sigma_1\sigma_2 & \sigma_2^2 \end{bmatrix} \] \[ P(w_1, w_2) = \frac{1}{2\pi\,\abs{\Sigma}^{1/2}}\; e^{-\frac{1}{2}\vb{w}\T \Sigma^{-1} \vb{w}} \]Здесь \(\sigma_1^2\), \(\sigma_2^2\) — дисперсии двух весов, \(\rho\) — их корреляция. При \(\rho = 0\) матрица диагональная, и плотность распадается в произведение двух одномерных гауссиан — шаг 3 вывода. Если к тому же \(\sigma_1 = \sigma_2 = \sigma_w\), получается \(\Sigma = \sigma_w^2 I\).
Почему prior именно гауссов и именно с нулевым средним?
Нулевое среднее: нет причин заранее предпочитать положительные веса отрицательным, а нулевые веса дают самую простую функцию — константу. Гауссова форма: это самый простой колокол, и его логарифм — парабола, с которой удобно работать. Другой prior дал бы другой штраф; пример будет в последнем разделе. Само убеждение «веса должны быть малы» — эмпирическое: сети с малыми весами, как правило, обобщают лучше. На слайде 14 лекции 3 оно так и подано: как наблюдение (observed), а не как теорема.
«MAP — это полноценный байесовский вывод». Нет: MAP берёт у posterior одну точку — вершину. Это по-прежнему один набор весов, как и в MLE, только выбранный с учётом prior. Полный байесовский подход усреднял бы предсказания по всему posterior.
Как выбрать γ
Формула \(\gamma = \sigma^2 / \sigma_w^2\) объясняет смысл \(\gamma\), но числа не даёт: ни дисперсию шума, ни «правильную» ширину prior никто не знает. Поэтому \(\gamma\) — hyperparameter (гиперпараметр), и выбирают её как в уроке 21: по validation set, отложенной части данных.
Почему не по training set? Потому что там ответ известен заранее. В лаборатории \(E_{\mathrm{train}}\) только росла с \(\gamma\), так что «лучшей» всегда окажется \(\gamma = 0\). По той же причине \(\gamma\) нельзя учить градиентным спуском вместе с весами.
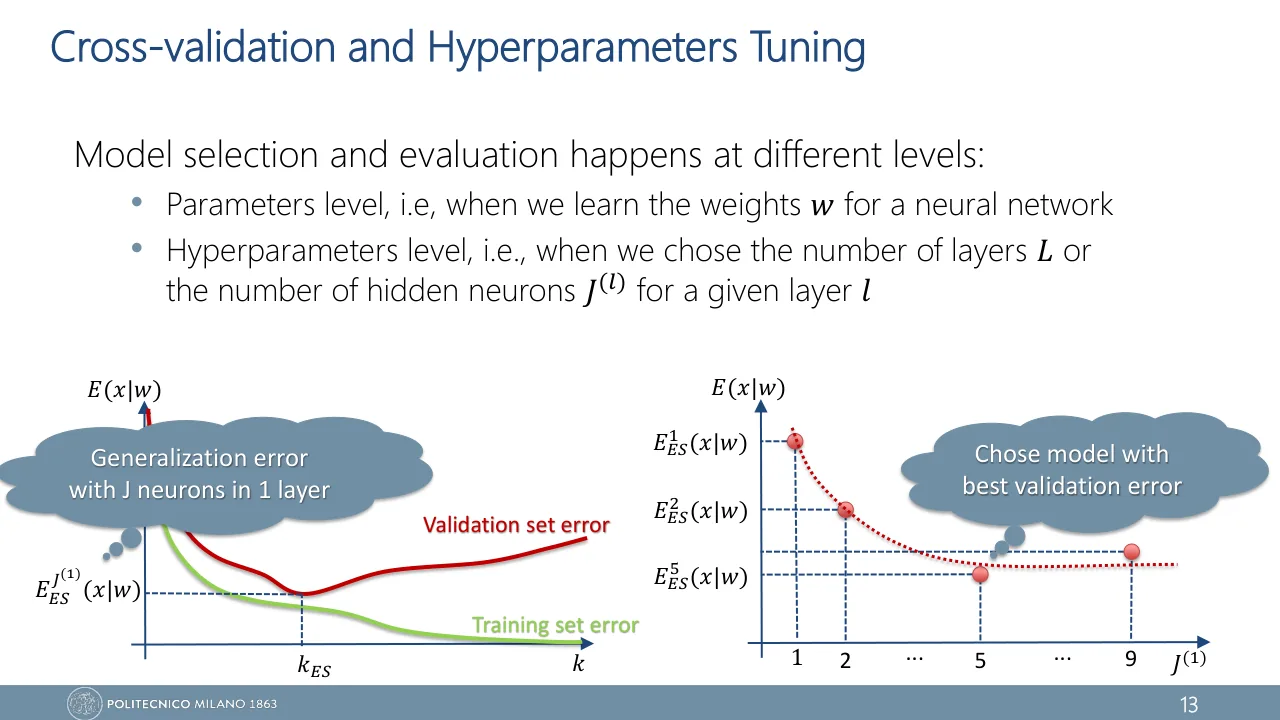
Слайд 16 лекции 3 называет такой выбор cross-validation, а его заголовок начинается со слова Recall: это та же схема, по которой на слайде 13 выбирали число скрытых нейронов. У профессора слово cross-validation шире, чем K-fold: так он называет любое использование имеющихся данных и для обучения, и для оценки ошибки на новых данных, а одна отложенная часть (hold out) — простейший вид такой проверки (лекция 3, слайд 6). Сама процедура на слайде 16 — пять шагов.
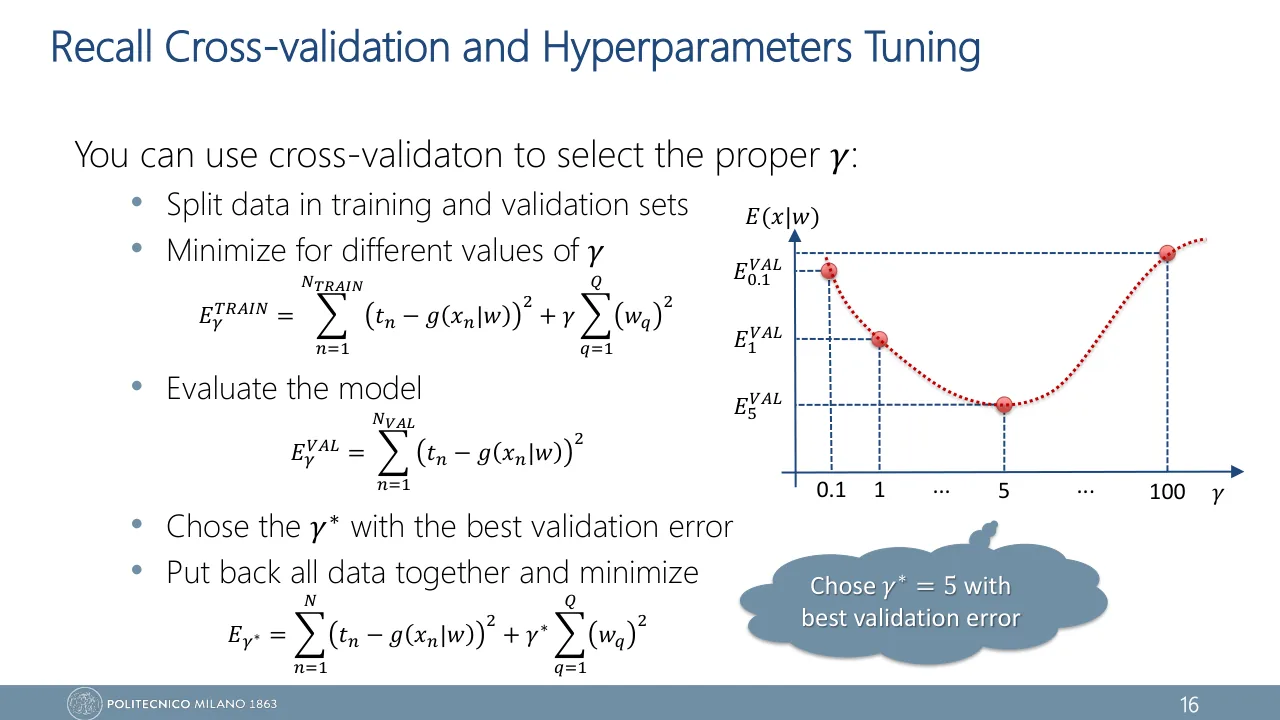
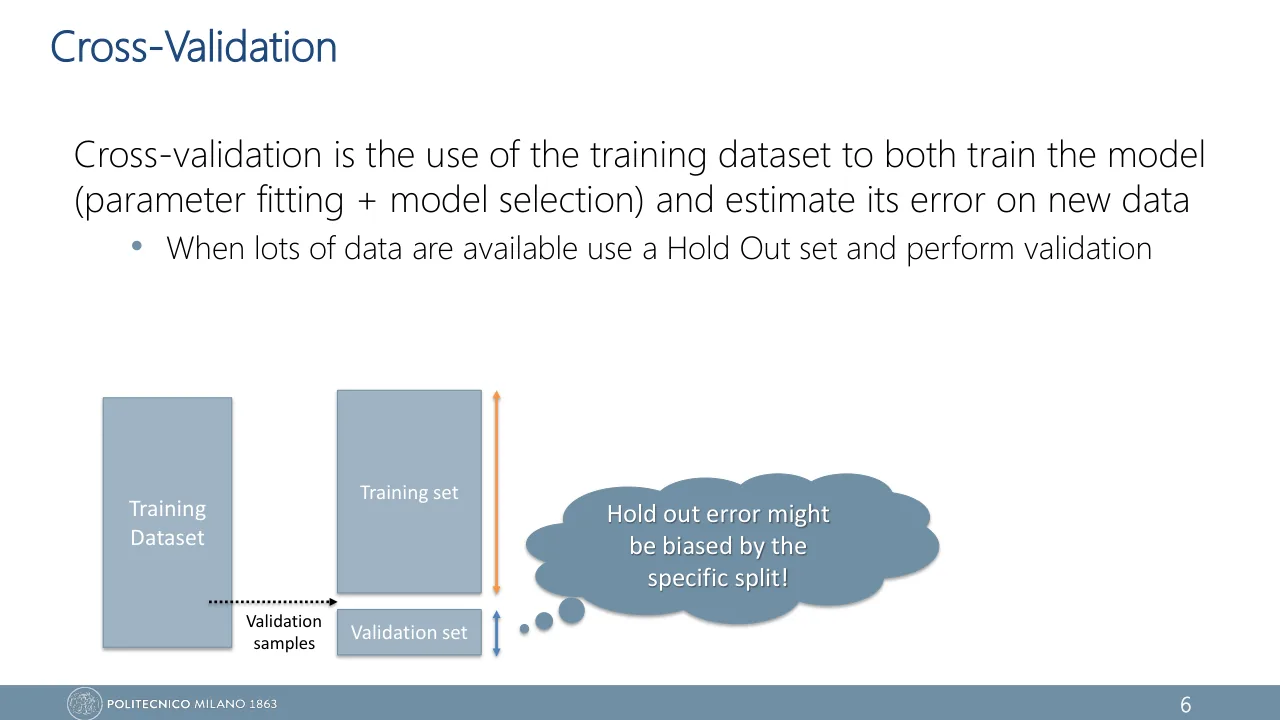
- Раздели данные на training set и validation set: в них \(N_{\mathrm{TRAIN}}\) и \(N_{\mathrm{VAL}}\) примеров. Test set отложен раньше и в выборе не участвует.
- Для нескольких значений \(\gamma\) обучи сеть на training set, минимизируя ошибку со штрафом: \[ \begin{aligned} E_{\gamma}^{\mathrm{TRAIN}} = {} & \sum_{n=1}^{N_{\mathrm{TRAIN}}} \big(t_n - g(x_n|\vb{w})\big)^2 \\ & + \gamma \sum_{q=1}^{Q} w_q^2 \end{aligned} \]
- Оцени каждую обученную сеть на validation set — с весами \(\vb{w}\), найденными в шаге 2, и уже без штрафа: \[ E_{\gamma}^{\mathrm{VAL}} = \sum_{n=1}^{N_{\mathrm{VAL}}} \big(t_n - g(x_n|\vb{w})\big)^2 \]
- Выбери \(\gamma^*\) с лучшей, то есть наименьшей, validation error: \(\gamma^* = \argmin_{\gamma}\, E_{\gamma}^{\mathrm{VAL}}\). Это дно малиновой кривой из лаборатории.
- Собери все данные обратно вместе и минимизируй ошибку с выбранной \(\gamma^*\): \[ \begin{aligned} E_{\gamma^*} = {} & \sum_{n=1}^{N} \big(t_n - g(x_n|\vb{w})\big)^2 \\ & + \gamma^* \sum_{q=1}^{Q} w_q^2 \end{aligned} \] Здесь \(N = N_{\mathrm{TRAIN}} + N_{\mathrm{VAL}}\). Итоговую оценку качества даёт test set.
Осторожно с буквами. На слайде \(E_{\gamma}^{\mathrm{TRAIN}}\) — вся минимизируемая функция, вместе со штрафом. В лаборатории и в конспекте \(E_{\mathrm{train}}\) — только ошибка на данных, так что \(E_{\gamma}^{\mathrm{TRAIN}}\) слайда равна \(E_{\mathrm{train}}\) плюс число «штраф» из лаборатории. А \(E_{\gamma}^{\mathrm{VAL}}\) слайда и \(E_{\mathrm{val}}\) лаборатории — одно и то же.
Справа на слайде 16 нарисован пример. По горизонтали — значения \(\gamma\): 0.1, 1, …, 5, …, 100. По вертикали — их ошибки \(E_{0.1}^{\mathrm{VAL}}\), \(E_{1}^{\mathrm{VAL}}\), \(E_{5}^{\mathrm{VAL}}\). Точки лежат на U-образной кривой с дном при \(\gamma = 5\), и выноска выбирает \(\gamma^* = 5\). Это та же малиновая кривая, что в лаборатории. Две опечатки слайда, чтобы не унести их в ответ: "cross-validaton" в первой строке и "Chose" там, где нужен глагол choose.
Какие значения пробовать, слайд не говорит. Обычно берут логарифмическую сетку: в конспекте (стр. 171) это \(10^{-5}, 10^{-4}, \dots, 1, 10\) — семь значений, семь обучений. Сетка логарифмическая, потому что \(\gamma\) действует как множитель и интересный диапазон занимает несколько порядков: в лаборатории дно гуляло от \(10^{-6}\) до \(10^{-1.5}\), а на слайде значения идут от 0.1 до 100.
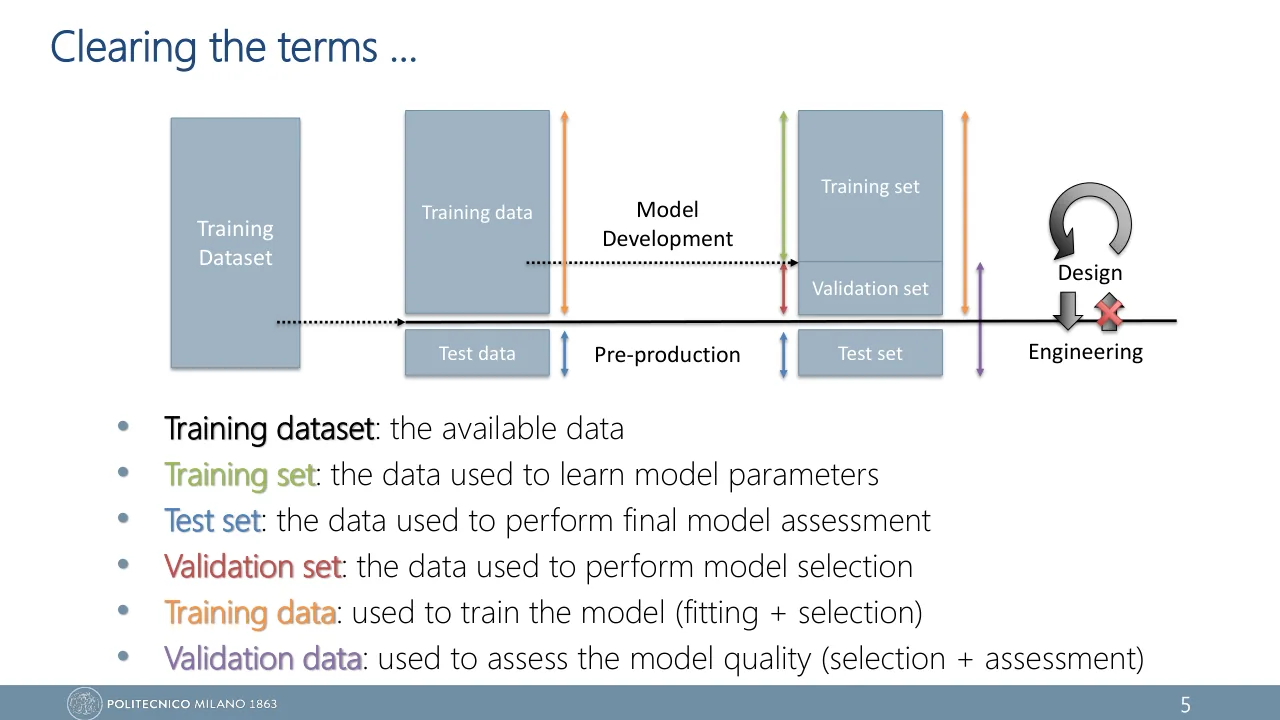
«Retrain on all data — значит на всех данных, включая test set». Нет. «All data» в конспекте (стр. 172) — это training + validation. На слайде 16 лекции 3 то же: "Put back all data together" — возвращают то, что делили в шаге 1, и сумма идёт до \(N\). Test set не участвует ни в обучении, ни в выборе \(\gamma\), иначе честной итоговой оценки не останется: по слайду 5 лекции 3 он служит только для итоговой оценки модели.
Родственники: L1 и early stopping
Квадрат — не единственный возможный штраф. L1 regularization берёт сумму модулей: \(\gamma \sum_q \abs{w_q}\). На слайдах лекции 3 его нет: он здесь для сравнения с L2. Разница в том, как штраф тянет вес к нулю.
| L2 (weight decay) | L1 | |
|---|---|---|
| Штраф | \(\gamma \sum_q w_q^2\) | \(\gamma \sum_q \abs{w_q}\) |
| Тяга к нулю (производная) | \(2\gamma w_q\): пропорциональна весу, у нуля исчезает | \(\pm\gamma\): постоянная, у нуля не слабеет |
| Что получается | все веса уменьшаются, но ровно нулём не становятся | часть весов становится ровно нулём (sparsity, разреженность) |
| Prior | Gaussian | Laplace |
Пружина тянет тем слабее, чем ближе вес к нулю, поэтому до самого нуля она его не дотягивает. У L1 тяга постоянная, как у гири на нитке: вес, за который данные «платят» меньше \(\gamma\), она доводит до нуля ровно. Поэтому L1 берут, когда хочется отобрать немногие важные входы, а L2 — когда нужно просто усмирить веса.
С early stopping связь ещё теснее. Обучение стартует с маленьких весов, и они растут шаг за шагом. Остановиться рано — значит не дать им уйти далеко от нуля. Weight decay держит их маленькими всё время обучения. Конспект (стр. 165) так и сравнивает: первый приём ограничивает время, второй — величину весов, и оба реализуют бритву Оккама. Для ошибки в форме чаши соответствие даже количественное, оно разобрано в уроке 20: \(\tau\) шагов с learning rate \(\eta\) действуют примерно как штраф с \(\gamma\), пропорциональной \(1/(\eta\tau)\). Мало шагов — сильная регуляризация.
Weight decay и L2-штраф — всегда одно и то же?
Для обычного градиентного спуска, в том числе mini-batch, — да: добавить к ошибке \(\gamma \sum_q w_q^2\) и умножать вес на \(1 - 2\eta\gamma\) на каждом шаге — одно и то же, это показано в разделе 3. Для адаптивных оптимизаторов вроде Adam два рецепта расходятся, поэтому существует отдельный вариант AdamW, где усадка применяется напрямую. На экзамене это не понадобится, в лабораторных — может.
Ответ на задачку
Оба вопроса из начала теперь закрыты. Почему запрет на большие числа лечит переобучение? Резкие изгибы, которыми модель заучивает шум, требуют больших весов. Штраф делает их дорогими, и модель оставляет только те веса, за которые данные действительно «платят». В лаборатории это стоило роста \(E_{\mathrm{train}}\) с 0 до 0.56 и дало падение \(E_{\mathrm{val}}\) с 5.99 до 1.33.
Почему именно квадрат? Потому что квадрат — это минус логарифм колокола Гаусса. Предположение «каждый вес распределён как \(N(0, \sigma_w^2)\)» после логарифма даёт ровно \(\gamma \sum_q w_q^2\) с \(\gamma = \sigma^2 / \sigma_w^2\). Пружина оказалась записью убеждения «веса скорее маленькие», а её жёсткость — мерой того, насколько шумным данным мы верим меньше, чем этому убеждению.
В формате экзамена
What is regularization? Write the maximum likelihood and the maximum a-posteriori estimates of the weights of a neural network and explain how the second one limits overfitting. Which a-priori distribution of the weights leads to weight decay, and why is it chosen?
Show model answer
Regularization constrains the freedom of the model, on the basis of an a-priori assumption on the model, in order to reduce overfitting.
Maximum likelihood chooses the weights that make the observed data most probable; nothing is assumed about the weights themselves:
\[ \vb{w}_{\mathrm{MLE}} = \argmax_{\vb{w}}\; P(D|\vb{w}) \]The Bayesian approach reduces the freedom of the model by making an assumption on the a-priori distribution of the parameters, \(P(\vb{w})\), and by maximising the posterior instead of the likelihood (Bayes' rule; \(P(D)\) does not depend on \(\vb{w}\)):
\[ \begin{aligned} \vb{w}_{\mathrm{MAP}} &= \argmax_{\vb{w}}\; P(\vb{w}|D) \\ &= \argmax_{\vb{w}}\; P(D|\vb{w})\,P(\vb{w}) \end{aligned} \]Weights that are improbable under the prior are selected only if the data support them strongly, so the network is no longer free to fit the noise. Weight decay assumes that the weights are small: every weight is independently distributed as \(w_q \sim N(0, \sigma_w^2)\). The motivation is empirical: neural networks with small weights are observed to generalize better.
Это содержание слайда 14 лекции 3, и ответ идёт в его порядке: определение, MLE, MAP, prior. Две типичные недоработки. Определение без слов про априорное предположение: «регуляризация борется с переобучением» называет цель, а не способ. И prior без нулевого среднего: именно ноль в \(N(0, \sigma_w^2)\) означает «веса малы».
Weight decay. (a) Write the error function that is minimised when a regression network is trained with weight decay. (b) Derive it as a Maximum A-Posteriori (MAP) estimate, stating the assumptions. (c) How is \(\gamma\) related to the variances involved? What happens when \(\sigma_w \to \infty\), and when the number of samples \(N\) grows?
Show model answer
(a) With \(\gamma \gt 0\) as the regularisation parameter and \(q = 1, \dots, Q\) indexing all the weights of the network:
\[ \begin{aligned} E(\vb{w}) = {} & \sum_{n=1}^{N} \big(t_n - g(x_n|\vb{w})\big)^2 \\ & + \gamma \sum_{q=1}^{Q} w_q^2 \end{aligned} \]The first term is the fitting term, the second one the regularization term.
(b) Assumptions: \(t_n = g(x_n|\vb{w}) + \epsilon_n\) with independent \(\epsilon_n \sim N(0, \sigma^2)\); independent zero-mean Gaussian prior on every weight, \(w_q \sim N(0, \sigma_w^2)\). Since \(P(D)\) does not depend on \(\vb{w}\):
\[ \begin{aligned} \vb{w}_{\mathrm{MAP}} &= \argmax_{\vb{w}}\; P(\vb{w}|D) \\ &= \argmax_{\vb{w}}\; P(D|\vb{w})\,P(\vb{w}) \end{aligned} \]Both factors are products of Gaussians, one per sample and one per weight. Writing \(g_n\) for \(g(x_n|\vb{w})\):
\[ \begin{aligned} \vb{w}_{\mathrm{MAP}} = \argmax_{\vb{w}}\; &\prod_{n=1}^{N} \frac{1}{\sqrt{2\pi}\,\sigma}\; e^{-\frac{(t_n - g_n)^2}{2\sigma^2}} \\ {}\cdot{} &\prod_{q=1}^{Q} \frac{1}{\sqrt{2\pi}\,\sigma_w}\; e^{-\frac{w_q^2}{2\sigma_w^2}} \end{aligned} \]Taking the negative logarithm (it is monotone: products become sums, the maximum becomes a minimum) and dropping the terms that do not depend on \(\vb{w}\):
\[ \begin{aligned} \vb{w}_{\mathrm{MAP}} = \argmin_{\vb{w}} \Big[ &\sum_{n=1}^{N} \frac{(t_n - g_n)^2}{2\sigma^2} \\ &+ \sum_{q=1}^{Q} \frac{w_q^2}{2\sigma_w^2} \Big] \end{aligned} \]Multiplying by \(2\sigma^2 \gt 0\) gives the error function of (a).
(c) \(\gamma = \sigma^2 / \sigma_w^2\): noise variance over prior variance. Noisier data or a narrower prior give a stronger regularisation. For \(\sigma_w \to \infty\) the prior is flat, \(\gamma \to 0\), and the MAP estimate coincides with the maximum likelihood estimate. \(\gamma\) does not depend on \(N\), but the fitting term is a sum of \(N\) squares while the penalty stays fixed: as \(N\) grows the data dominate the prior and the MAP estimate again approaches the maximum likelihood one.
Вывод в ответе повторяет четыре строки слайда 15 лекции 3. Чему равна \(\gamma\), там не написано: соотношение \(\gamma = \sigma^2 / \sigma_w^2\) надо уметь вывести из двух последних строк. Проверяют три вещи: что названы оба предположения (независимый гауссов шум и независимый Gaussian prior с нулевым средним), что объяснено, почему можно отбросить \(P(D)\) и взять логарифм, и что \(\gamma\) названа отношением дисперсий. Ответ «\(\gamma = 1/\sigma^2\)» из конспекта рискован: без пояснения, чья это дисперсия, он читается как «дисперсия шума в знаменателе», а это неверно.
A network is trained by gradient descent on the regularised error
\[ E_{\mathrm{reg}}(\vb{w}) = E_{\mathrm{train}}(\vb{w}) + \frac{\gamma}{2} \sum_q w_q^2 . \]Write the update rule for one weight and compute its new value after one step, given \(w = 2\), \(\partial E_{\mathrm{train}} / \partial w = 0.5\), \(\eta = 0.1\), \(\gamma = 0.01\).
Show model answer
Each step first shrinks the weight by the factor \(1 - \eta\gamma\), then applies the usual gradient step: hence the name "weight decay".
Здесь штраф записан с \(\frac{\gamma}{2}\), как в конспекте, поэтому множитель равен \(1 - \eta\gamma\). С записью \(\gamma \sum_q w_q^2\), как на слайде 15 лекции 3, получилось бы \(1 - 2\eta\gamma\) и ответ 1.946. Ловушка — применить заученную формулу, не посмотрев на условие.
Describe the procedure used to select \(\gamma\). Is the penalty term included when the validation error is computed? Why can \(\gamma\) not be selected by minimising the training error?
Show model answer
\(\gamma\) is a hyperparameter and is selected by cross-validation on held-out data. Split the data into a training set and a validation set (the test set is kept aside). For different values of \(\gamma\), usually taken on a logarithmic grid such as \(10^{-5}, \dots, 10\), train on the training set by minimising the error with the penalty:
\[ \begin{aligned} E_{\gamma}^{\mathrm{TRAIN}} = {} & \sum_{n=1}^{N_{\mathrm{TRAIN}}} \big(t_n - g(x_n|\vb{w})\big)^2 \\ & + \gamma \sum_{q=1}^{Q} w_q^2 \end{aligned} \]Evaluate each trained model on the validation set with the plain sum of squared errors, without the penalty:
\[ E_{\gamma}^{\mathrm{VAL}} = \sum_{n=1}^{N_{\mathrm{VAL}}} \big(t_n - g(x_n|\vb{w})\big)^2 \]Choose the \(\gamma^*\) with the best (lowest) validation error, put all the data back together (training plus validation, \(N\) samples) and minimise
\[ \begin{aligned} E_{\gamma^*} = {} & \sum_{n=1}^{N} \big(t_n - g(x_n|\vb{w})\big)^2 \\ & + \gamma^* \sum_{q=1}^{Q} w_q^2 \end{aligned} \]The performance of the final model is reported on the test set.
The penalty is a training device, not a measure of prediction quality, so it is not part of the validation error. The training error cannot be used for the selection because it is non-decreasing in \(\gamma\): it would always select \(\gamma = 0\), i.e. no regularisation.
Формулы и порядок шагов — со слайда 16 лекции 3; там же пример, в котором выбрана \(\gamma^* = 5\). Балл легко потерять в двух местах: оставляют штраф в validation error (так написано в конспекте на стр. 171 — это ошибка) и забывают про повторное обучение на объединённых данных. Фраза про test set показывает, что ты различаешь выбор модели и её оценку.
Which of the following statements about L2 weight decay are correct? Select all that apply.
Show model answer
Correct: the first, the third and the fifth. Weight decay is MAP with a Gaussian prior \(N(0, \sigma_w^2)\) and \(\gamma = \sigma^2 / \sigma_w^2\); it keeps all the weights but shrinks them, so the fit to the training data can only get worse as \(\gamma\) grows. Exact zeros are produced by L1, and \(\gamma\) is a hyperparameter chosen on validation data.
В вопросах «select all» каждое утверждение проверяется отдельно. Типичная ошибка — отметить «exactly to zero»: слово exactly превращает верную мысль «веса уменьшаются» в неверную.
A model with a single weight: \(t_n = w + \epsilon_n\), \(\epsilon_n \sim N(0, \sigma^2)\) with \(\sigma^2 = 4\). There are \(N = 4\) observations with sample mean 2. The prior is \(w \sim N(0, \sigma_w^2)\) with \(\sigma_w^2 = 2.25\). Compute \(w_{\mathrm{MAP}}\).
Show model answer
\(\gamma = \sigma^2 / \sigma_w^2 = 4 / 2.25 = 1.778\). Minimising \(\sum_n (t_n - w)^2 + \gamma w^2\):
\[ -2 \sum_n (t_n - w) + 2\gamma w = 0 \] \[ w_{\mathrm{MAP}} = \frac{\sum_n t_n}{N + \gamma} = \frac{8}{4 + 1.778} = 1.385 \]The maximum likelihood estimate is the sample mean, 2; the prior pulls it towards zero.
Это числа с рис. 20 конспекта. Проверяют, что ты умеешь довести MAP до числа: сначала \(\gamma\) как отношение дисперсий, потом производная. Быстрая самопроверка: ответ обязан лежать между 0 и \(w_{\mathrm{MLE}} = 2\).
Проверь себя
Дисперсию prior \(\sigma_w^2\) уменьшили в 4 раза, шум данных не изменился. Что произошло с \(\gamma\)?
Что верно про выбор \(\gamma\)? Отметь все правильные утверждения.
Картинка для памяти: бирюзовая кривая только растёт, у малиновой есть дно.
Штраф записан как \(\gamma \sum_q w_q^2\), \(\eta = 0.1\), \(\gamma = 0.05\). На какое число вес умножается на каждом шаге до вычитания градиента ошибки?
Два входа сети несут одну и ту же информацию, и для ответа нужно \(w_1 + w_2 = 1\). Какой вариант выберет обучение с L2-штрафом?
Ошибка записана как на слайде 15 лекции 3: Sum of Squared Errors плюс \(\gamma \sum_q w_q^2\). Данных стало в 25 раз больше, шум и prior те же. Что изменилось?
Почему L1 делает часть весов ровно нулевыми, а L2 — нет?
Унести с собой
- Regularization ограничивает «свободу» модели априорным предположением о ней, чтобы уменьшить переобучение. Weight decay — её вид с предположением «веса малы»: к ошибке на данных прибавлен штраф \(\gamma \sum_q w_q^2\). Число весов прежнее, уменьшается эффективная ёмкость.
- Шаг градиентного спуска со штрафом — это усадка плюс обычный шаг: вес сначала умножается на \(1 - 2\eta\gamma\). В записи конспекта с \(\frac{\gamma}{2}\) множитель равен \(1 - \eta\gamma\).
- С ростом \(\gamma\) ошибка на training set только растёт, а ошибка на validation set имеет форму U: слишком большая \(\gamma\) — это underfitting.
- Weight decay — это MAP с Gaussian prior \(N(0, \sigma_w^2)\) на веса; \(\gamma = \sigma^2 / \sigma_w^2\). Плоский prior возвращает MLE, много данных делает prior неважным.
- \(\gamma\) — hyperparameter, её выбирают по cross-validation: для разных \(\gamma\) минимизируют \(E_{\gamma}^{\mathrm{TRAIN}}\) со штрафом, сравнивают по \(E_{\gamma}^{\mathrm{VAL}}\) без штрафа, с лучшей \(\gamma^*\) обучают заново на всех данных. Значения \(\gamma\) обычно берут на логарифмической сетке.
- L2 сжимает веса пропорционально и сильнее всего там, где данные их не держат. L1 (Laplace prior) доводит часть весов до нуля.
Что посмотреть и почитать
-
Regularization Part 1: Ridge (L2) Regression
StatQuest
L2-штраф на модели, знакомой по Applied Statistics, — на линейной регрессии. Хороший разгон, если слово «регуляризация» пока звучит абстрактно.
-
TensorFlow Playground
Daniel Smilkov, Shan Carter
Лаборатория этого урока, но на настоящей сети. Возьми трудный датасет, добавь шум, выбери Regularization: L2 и поднимай Regularization rate шаг за шагом, следя за test loss и толщиной связей.
-
Improving the way neural networks learn
Michael Nielsenглава 3, раздел «Overfitting and regularization»
Самое понятное объяснение того, почему маленькие веса обобщают лучше. Осторожно с обозначениями: штраф там записан как \(\frac{\lambda}{2n}\sum w^2\). Сайт открывается только по http.
-
A Probabilistic Interpretation of Regularization
Brian Keng
Тот же вывод MLE → MAP на линейной регрессии: Gaussian prior даёт L2 с коэффициентом «дисперсия шума на дисперсию prior», Laplace prior даёт L1. Читать, когда вывод из раздела 4 уже получился самостоятельно.
-
Dive into Deep Learning, 3.7: Weight Decay
d2l.ai
Если хочется запустить код: кривые training и validation без штрафа и со штрафом, в нескольких строках. Пригодится к лабораторным.