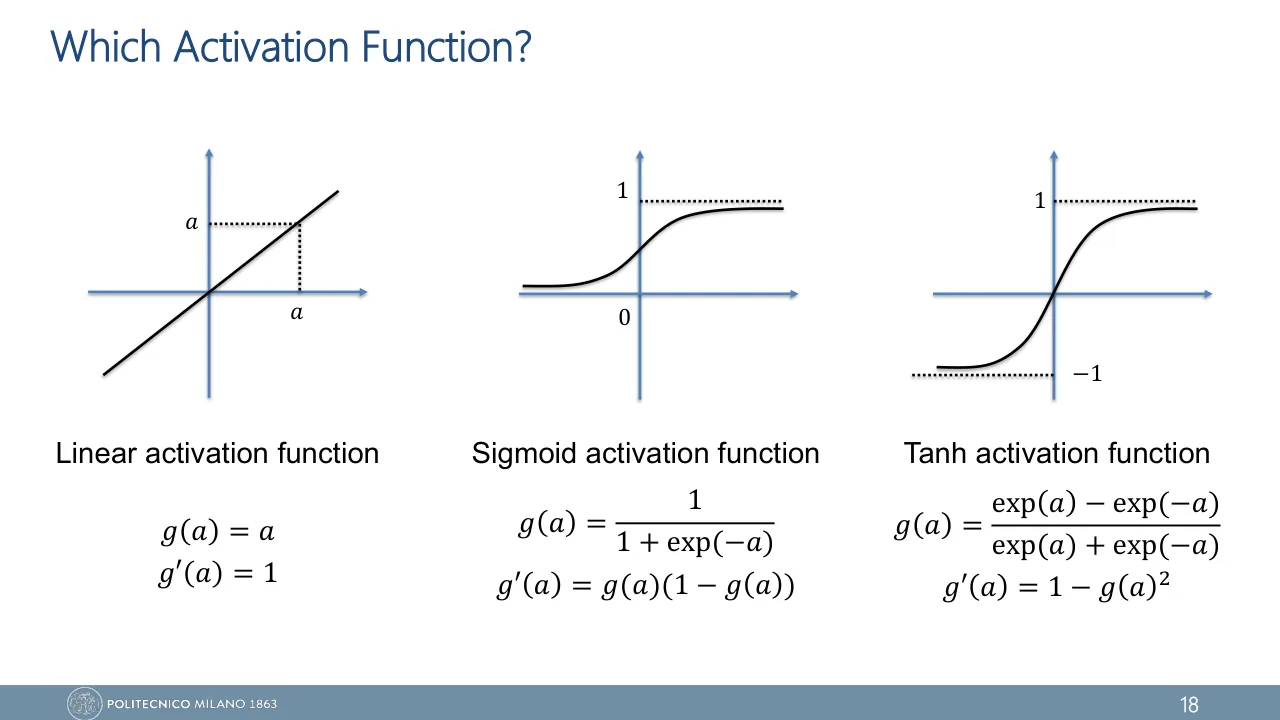
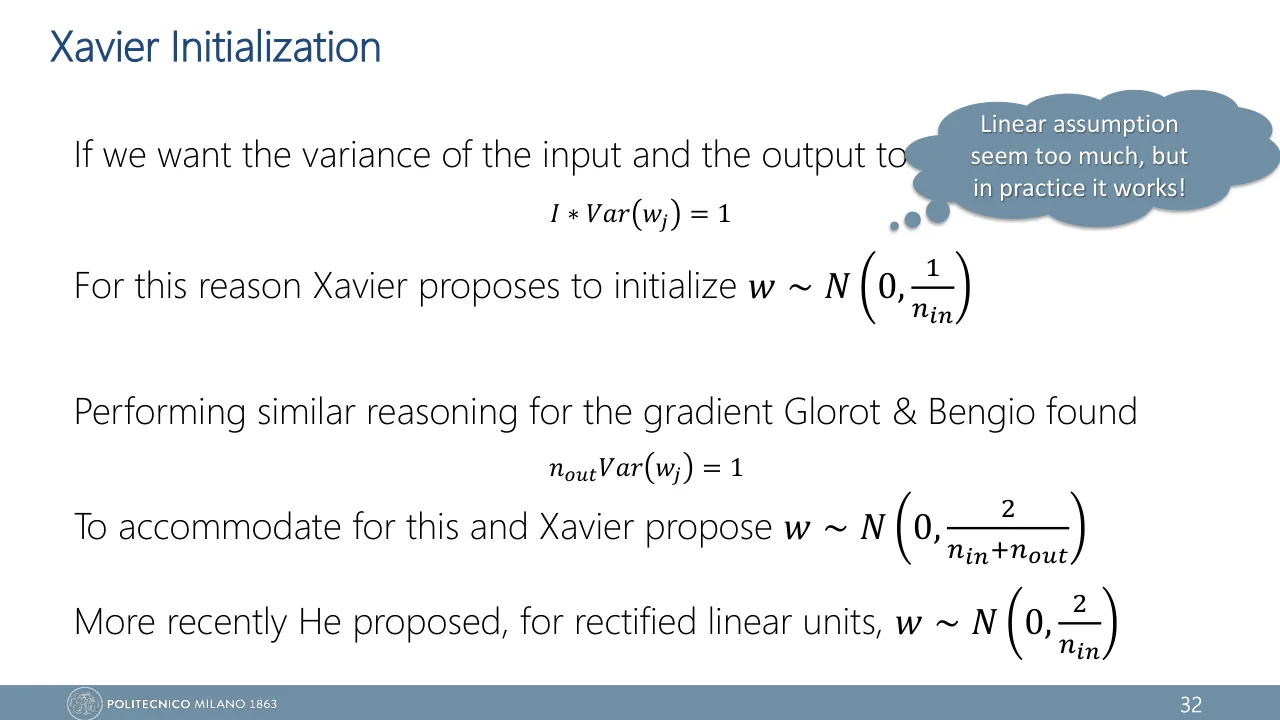
Формулу предложили Xavier Glorot и Yoshua Bengio из Монреальского университета. Отсюда два названия одной и той же инициализации: по имени первого автора (Xavier) и по его фамилии (Glorot). Поэтому "Xavier proposes", "Glorot & Bengio found" и "Xavier propose" на слайде 32 лекции 3 — не три разных автора, а одна статья. В ней есть гистограммы активаций слой за слоем, такие же, как в виджете выше, и наблюдение, что глубокая сеть с sigmoid при случайном старте уходит в насыщение.
Ксерокопия ксерокопии
После этого урока ты выведешь формулы Xavier и He из одной строчки про дисперсию суммы, посчитаешь стартовый разброс весов для любого слоя и объяснишь, почему нули, слишком маленькие и слишком большие веса ломают сеть ещё до первого шага обучения.
Сделай ксерокопию страницы. Потом ксерокопию этой ксерокопии. И так тридцать раз подряд. Если копир каждый раз теряет десятую часть контраста, от текста останется \(0.9^{30} \approx 0.04\): чистый лист. Если каждый раз добавляет десятую часть, получится \(1.1^{30} \approx 17\): чёрный лист. Тридцать копий подряд выдерживает только копир с множителем ровно 1.
Глубокая сеть — такая же цепочка копий. Каждый слой умножает размах сигнала на своё число, и это число задают веса, с которыми сеть стартует, ещё до первого шага обучения.
В 2010 году нашли формулу стартовых весов, при которой множитель равен 1. С tanh она работает. Но стоит заменить tanh на ReLU из прошлого урока, и с той же формулой сигнал к тридцатому слою слабеет в 32 768 раз. Исправление — одна цифра: \(1/n\) превращается в \(2/n\). Статья с этой цифрой вышла 6 февраля 2015 года, и в ней же описан первый результат на ImageNet лучше человеческого: 4.94 % ошибок против 5.1 %. Откуда берётся формула и почему именно двойка?
Сеть как цепочка умножений
В уроке 24 градиент шёл назад через слои и на каждом умножался на свой коэффициент. Произведение тридцати чисел чуть меньше единицы почти равно нулю, чуть больше единицы — огромно. С сигналом, который идёт вперёд, происходит то же самое: каждый слой берёт выходы предыдущего, умножает на веса и складывает. Если после слоя числа в среднем стали мельче, после тридцати слоёв от них ничего не останется.
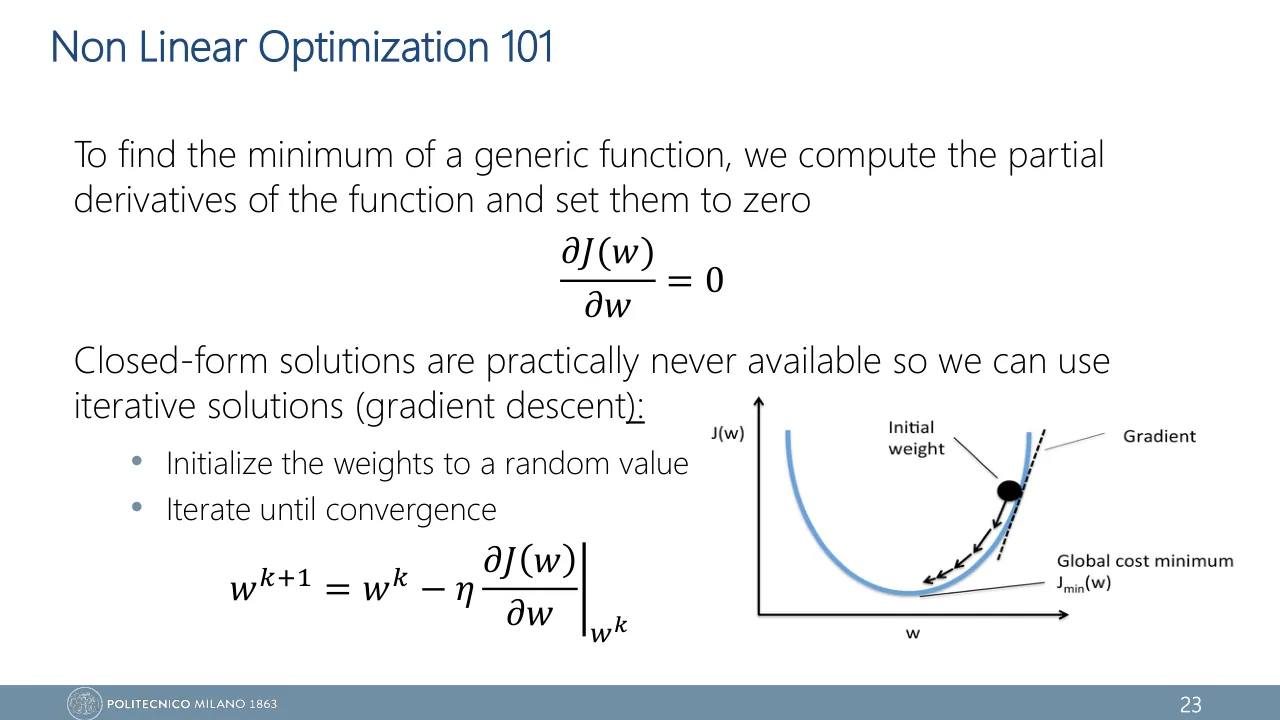
Чем задаётся множитель слоя? Весами. А веса в самом начале обучения откуда-то надо взять: gradient descent умеет только улучшать то, что уже есть. В рецепте спуска из урока 13 первая строка звучит так (лекция 2, слайд 23): "Initialize the weights to a random value". Тогда она пролетела незамеченной. В лекции 3 профессор к ней возвращается: слайд 30 открывается тем, что итог gradient descent зависит ещё и от weight initialization. Сейчас в строке про random value придётся разобраться: почему random и насколько random.
Инициализация весов (weight initialization) — выбор значений всех весов сети до первого шага обучения. Обычно это случайные числа со средним ноль; весь вопрос в том, какой у них разброс, то есть дисперсия (variance) \(\mathrm{Var}(w)\).
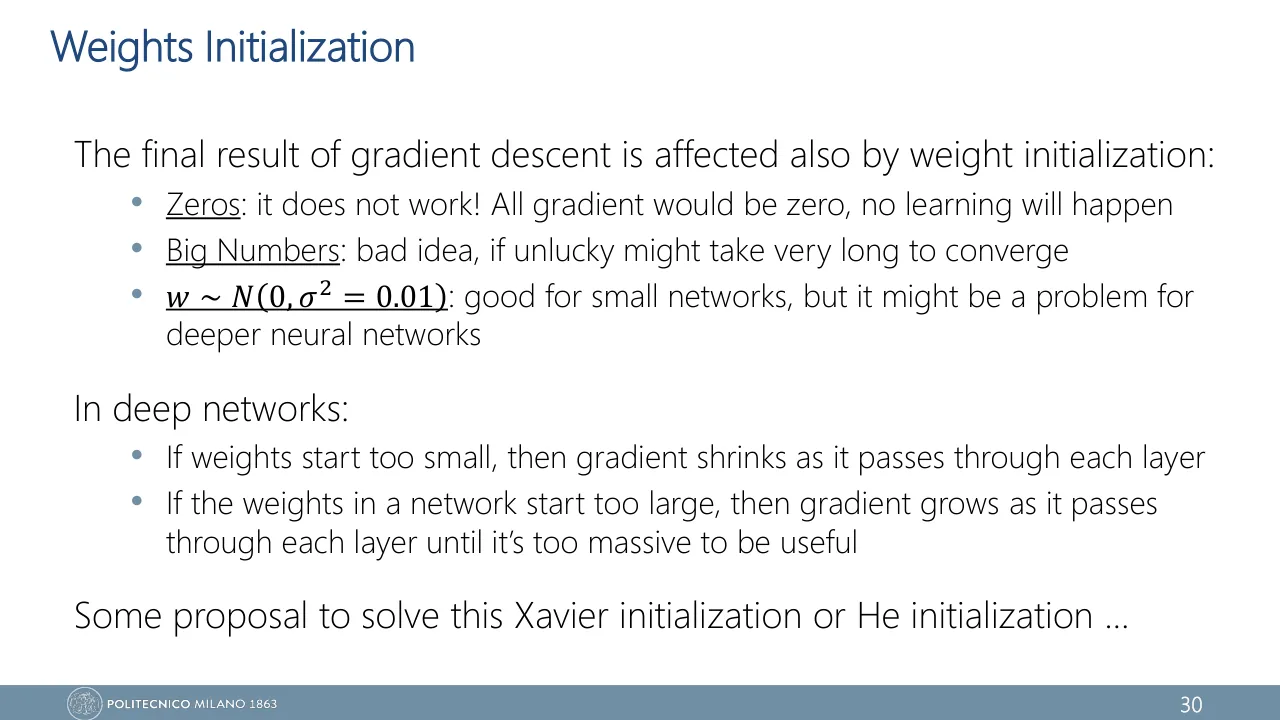
У вопроса три наивных ответа: все нули, маленькие случайные числа, большие случайные числа. Все три плохи, каждый по-своему. Маленькие числа сходят с рук в сети из двух-трёх слоёв и губят глубокую. На слайде 30 лекции 3 те же три ответа стоят списком:
- Zeros: "it does not work! All gradient would be zero, no learning will happen".
- Big Numbers: "bad idea"; если не повезёт ("if unlucky"), сходимости придётся ждать очень долго.
- \(w \sim N(0,\ \sigma^2 = 0.01)\): годится для маленьких сетей ("good for small networks"), но может стать проблемой для более глубоких.
Это три вердикта без причин; причины и есть содержание урока. Первая строка разобрана в следующем разделе, вторая и третья — в разделе про один слой. Внизу слайда названо лекарство: Xavier initialization или He initialization. И сразу запомни запись в третьей строке: второй аргумент \(N(\cdot,\cdot)\) на слайдах — дисперсия \(\sigma^2\), а не стандартное отклонение \(\sigma\). Начнём с нулей.
Нули и одинаковые числа: слой из клонов
Возьмём сеть с двумя скрытыми нейронами и дадим всем весам одно и то же значение, скажем 0.5. Оба нейрона получают одинаковые входы с одинаковыми весами, значит, выдают одинаковый выход: \(h_1 = h_2\). Ошибка возвращается к ним через одинаковые веса, значит, и поправки они получают одинаковые. После шага обучения веса изменились, но у обоих нейронов одинаково. И так на каждом шаге.
Это называют проблемой симметрии: gradient descent не умеет делать разными нейроны, которые начали одинаковыми. Слой из ста клонов считает то же, что слой из одного нейрона, только в сто раз дороже.
С нулями ещё хуже, и виджет это показал. Градиент любого веса — это сигнал ошибки нейрона, умноженный на вход этого веса (урок 14):
\[ \pd{E}{w_{ji}^{(l)}} = \delta_j^{(l)}\, h_i^{(l-1)} \]У tanh и ReLU \(g(0) = 0\), поэтому при нулевых весах все скрытые выходы \(h_i\) равны нулю, и градиенты весов следующего слоя обнуляются. А сам \(\delta\) скрытого слоя приходит назад через веса следующего слоя, которые тоже нули. Все веса стоят на месте; сдвинуться может разве что bias выходного нейрона, потому что его вход всегда равен 1. С sigmoid выходы равны 0.5, а не нулю, и кое-что сдвинется, но опять одинаково у всех нейронов слоя.
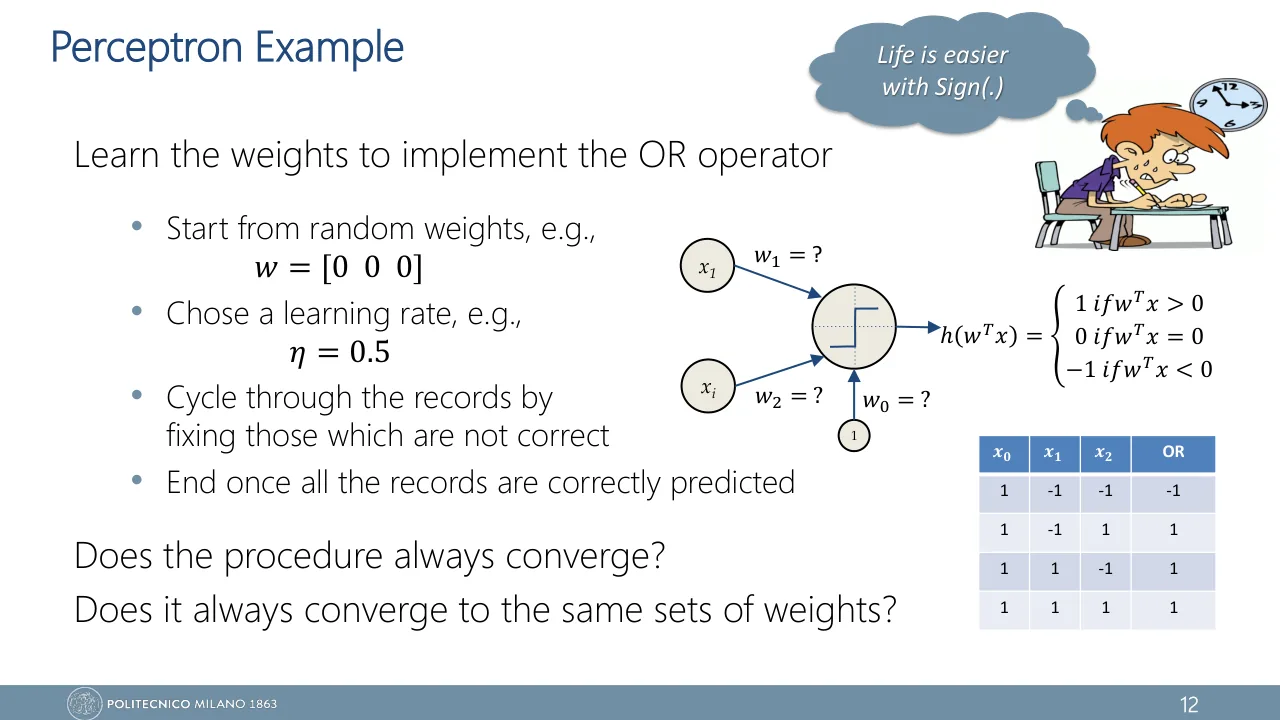
На слайде 30 лекции 3 всё это сжато в первую строку списка: нули не работают, потому что "All gradient would be zero". Для сети со скрытым слоем из tanh или ReLU строка верна почти дословно: нулевой градиент у всех весов, кроме bias выходного нейрона, и сеть выучит разве что константу. С sigmoid слово all уже неточно: градиенты выходных весов там не нулевые, а одинаковые, и учиться мешает не ноль, а симметрия. А одному нейрону без скрытого слоя нули вообще не вредят: в примере с перцептроном (лекция 2, слайд 12) профессор сам стартует с \(\vb{w} = [0\ 0\ 0]\). На экзамене начни с фразы слайда, потом скажи, какие градиенты обнуляются и почему, и добавь одну строку про симметрию.
Вывод: стартовые веса обязаны быть разными. Проще всего взять случайные: случайность ломает симметрию, по-английски symmetry breaking. А вот bias можно спокойно начинать с нуля: нейроны уже отличаются весами.
«Ноль — нейтральный, безопасный старт». Для линейной регрессии из Applied Statistics это правда: у задачи одно дно, и спуск придёт к нему откуда угодно. Для сети со скрытым слоем — нет: из точки «все веса равны» спуск никогда не попадёт туда, где нейроны разные.
Сколько сигнала проходит через один слой
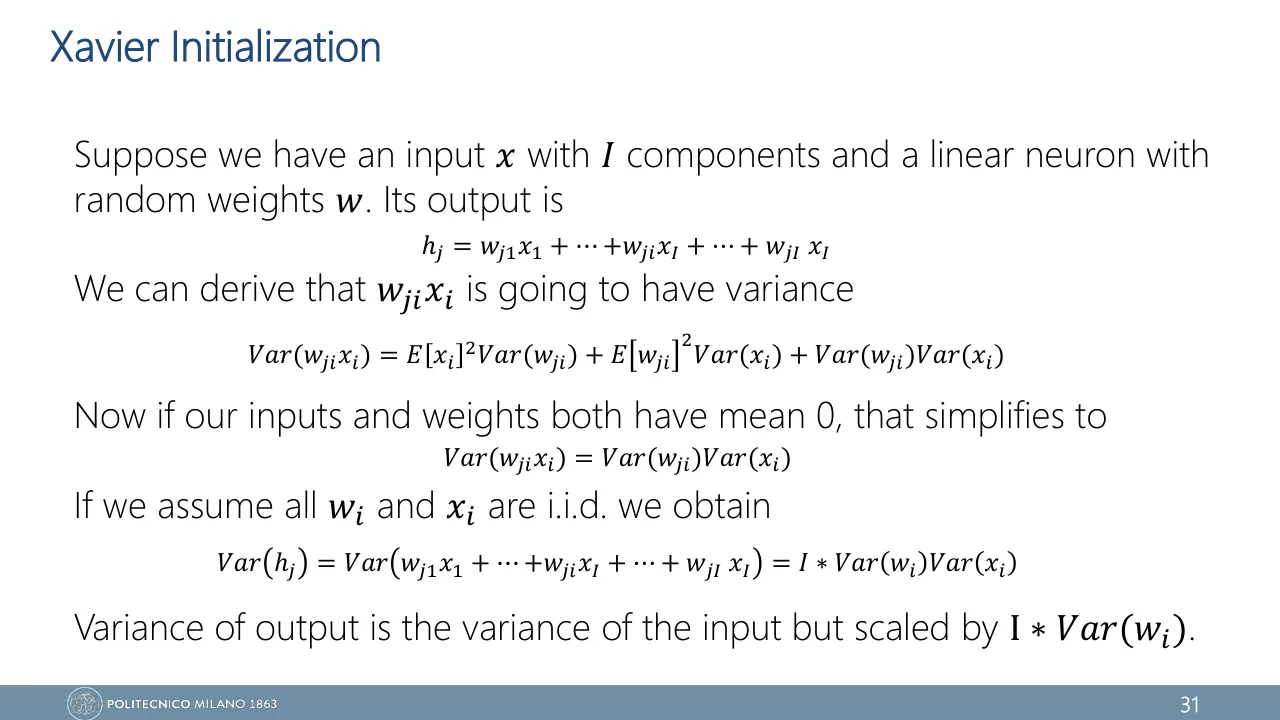
Итак, веса случайные, со средним ноль. Остаётся выбрать разброс. Профессор выводит его на слайдах 31–32 лекции 3 под заголовком "Xavier Initialization" и берёт для этого самый простой нейрон — линейный (linear neuron): его выход равен взвешенной сумме входов, без функции активации. Нейрон складывает столько слагаемых, сколько у него входов. Пойдём по строчкам слайда.
Обозначения тоже со слайда 31: у нейрона \(I\) входов \(x_1, \dots, x_I\), вес \(w_{ji}\) идёт в нейрон \(j\) от входа \(i\), выход нейрона — \(h_j\). В конспекте на стр. 184 тот же вывод записан для нейрона слоя \(l\): его входы — выходы предыдущего слоя \(h_i^{(l-1)}\), их \(n_{l-1}\), вес пишется \(w_{ji}^{(l)}\), а сумма называется \(z_j^{(l)}\). Словарь: \(x_i\) слайда — это \(h_i^{(l-1)}\) конспекта, \(I\) — это \(n_{l-1}\).
У линейного нейрона выход и есть сумма, поэтому слайду хватает одной буквы \(h_j\). С tanh и ReLU их придётся различать: сумму на входе активации (pre-activation) будем писать \(z\), как в конспекте, а выход — \(h = g(z)\). На слайдах и в уроках 14 и 24 аргумент активации обозначен \(a\) (например, \(g(a)\) на слайде 18 лекции 2), а bias — это вес \(w_{j0}\) при входе \(x_0 = 1\); в конспекте вместо них \(z\) и \(b_j\). Букву \(a\) здесь не берём: она понадобится для границы равномерного распределения \(U(-a, a)\).
Главная идея знакома по Applied Statistics: дисперсия суммы некоррелированных величин равна сумме их дисперсий. Сто слагаемых — в сто раз больше дисперсия. Поэтому чем больше у нейрона входов, тем мельче должен быть каждый вес, иначе сумма раздуется. Теперь то же самое аккуратно.
-
Слайд 31 лекции 3 берёт вход \(x\) из \(I\) компонент и "a linear neuron with random weights" \(w\). Выход такого нейрона:
\[ \begin{aligned} h_j &= w_{j1}x_1 + \dots + w_{ji}x_i \\ &\quad {} + \dots + w_{jI}x_I \end{aligned} \]Это взвешенная сумма \(I\) слагаемых; bias на старте равен нулю, поэтому его нет. На слайде в среднем слагаемом опечатка: \(w_{ji}x_I\) вместо \(w_{ji}x_i\).
-
Следующая строка слайда — дисперсия одного слагаемого \(w_{ji}x_i\). Она дана без вывода, со словами "we can derive". Вес выбран случайно, без оглядки на вход, поэтому они независимы. Для произведения независимых величин:
\[ \begin{aligned} \mathrm{Var}(w_{ji}x_i) &= \E[x_i]^2\,\mathrm{Var}(w_{ji}) \\ &\quad {} + \E[w_{ji}]^2\,\mathrm{Var}(x_i) \\ &\quad {} + \mathrm{Var}(w_{ji})\,\mathrm{Var}(x_i) \end{aligned} \] -
Дальше слайд берёт входы и веса с нулевым средним ("both have mean 0"), и от трёх слагаемых остаётся одно: нулевое среднее входа убирает первое, нулевое среднее веса убирает второе.
\[ \mathrm{Var}(w_{ji}x_i) = \mathrm{Var}(w_{ji})\,\mathrm{Var}(x_i) \]Заметь на будущее: если нулевое среднее есть только у веса, остаются первое и третье слагаемые, и вместе они дают \(\mathrm{Var}(w_{ji})\,\E[x_i^2]\). Это средний квадрат входа, а не его дисперсия. Пригодится для ReLU.
-
Последнее допущение слайда 31: все \(w_i\) и \(x_i\) — i.i.d., то есть независимы и одинаково распределены. Дисперсии независимых слагаемых складываются, а слагаемых \(I\), и все одинаковые:
\[ \mathrm{Var}(h_j) = I \cdot \mathrm{Var}(w_i)\,\mathrm{Var}(x_i) \]Слайд 31 подводит итог словами: дисперсия выхода — это дисперсия входа, "scaled by" \(I \ast \mathrm{Var}(w_i)\). Вот он, множитель копира: \(I\,\mathrm{Var}(w)\).
Для сложения дисперсий хватило бы и меньшего. У каждого слагаемого свой вес с нулевым средним, поэтому слагаемые не коррелируют, даже если входы зависят друг от друга.
-
Слайд 32 начинается с требования: дисперсии входа и выхода должны совпадать ("to be the same"). Значит, множитель должен равняться 1. Выход этого нейрона — вход следующего слоя, так что через много слоёв множители перемножаются. Произведение не уходит ни в ноль, ни в бесконечность, только когда каждый равен 1:
\[ I \cdot \mathrm{Var}(w_j) = 1 \] \[ \mathrm{Var}(w) = \frac{1}{I} = \frac{1}{n_{in}} \]Число входов \(I\) на этом же слайде дальше называется \(n_{in}\). Индекс у веса на слайдах гуляет: \(w_{ji}\), \(w_i\), \(w_j\). Это одна и та же величина: все веса распределены одинаково.
\[ w \sim N\Bigl(0,\ \frac{1}{n_{in}}\Bigr) \]
\[ \mathrm{Var}(w) = \frac{1}{n_{in}} = \frac{1}{I} \]
- \(n_{in} = I\)
- число входов нейрона: сколько слагаемых в его сумме; в конспекте \(n_{l-1}\)
- \(N(0,\ \cdot)\)
- второй аргумент на слайдах — дисперсия; стандартное отклонение здесь \(\sigma = 1/\sqrt{n_{in}}\)
- \(n_{in}\,\mathrm{Var}(w)\)
- усиление слоя: во сколько раз меняется дисперсия сигнала за один слой
На слайде 32 эта формула подписана именем: "Xavier proposes to initialize" \(w \sim N(0,\ 1/n_{in})\). Здесь два места, где легко ошибиться. Первое — запись: второй аргумент \(N(\cdot,\cdot)\) на слайдах всегда дисперсия, как в \(N(0,\ \sigma^2 = 0.01)\) на слайде 30, а функции в коде обычно просят \(\sigma\), то есть корень из неё. Второе — имя: Xavier — это не фамилия и не отдельный автор, а имя Xavier Glorot, первого автора статьи Glorot и Bengio 2010 года. Когда тот же слайд строкой ниже пишет "Glorot & Bengio found", речь о той же статье.
Там же, в облачке, профессор оговаривается: линейное допущение (linear assumption) выглядит чрезмерным, "but in practice it works!". Линейный нейрон и правда сильное упрощение: настоящий пропускает сумму через tanh или ReLU. Работает оно потому, что tanh около нуля почти совпадает с прямой \(h = z\), а при весах такого масштаба суммы невелики. Насколько «почти», покажет третье задание виджета. Для ReLU допущение ломается всерьёз; об этом раздел про двойку.
Откуда в шаге 2 три слагаемых?
Слайд говорит только "we can derive". Вывод занимает две строки. Для независимых \(w\) и \(x\) среднее произведения равно произведению средних, и для квадратов тоже:
\[ \begin{aligned} \mathrm{Var}(wx) &= \E[w^2x^2] - \E[wx]^2 \\ &= \E[w^2]\,\E[x^2] - \E[w]^2\,\E[x]^2 \end{aligned} \]Теперь подставь \(\E[w^2] = \mathrm{Var}(w) + \E[w]^2\), то же для \(x\), и раскрой скобки. Произведение \(\E[w]^2\,\E[x]^2\) сократится, останутся три слагаемых слайда. В конспекте от них сразу оставлено одно, \(v_w v_h\).
С трёх слагаемых удобно начинать вывод на экзамене, как это делает слайд 31 лекции 3: потом фраза про нулевое среднее у входов и весов ("both have mean 0"), и остаётся одно. Оба допущения при этом названы явно.
Проверим на числах. Слой из 100 нейронов. Веса со стандартным отклонением (standard deviation) \(\sigma_w = 0.01\): \(\mathrm{Var}(w) = 0.0001\), усиление \(100 \cdot 0.0001 = 0.01\), каждый слой оставляет от дисперсии сотую часть. Веса с \(\sigma_w = 1\): усиление 100. Правильный разброс: \(\mathrm{Var}(w) = 1/100\), то есть \(\sigma_w = 0.1\).
Последнее число — в точности \(N(0,\ \sigma^2 = 0.01)\) из третьей строки слайда 30: для слоя из 100 нейронов рецепт слайда даёт усиление 1. Но только для ста. При 10 входах та же дисперсия даёт усиление \(10 \cdot 0.01 = 0.1\), при 1000 входах — 10. Фиксированное число не знает ширины слоя. В сети из двух-трёх слоёв такой перекос ещё терпим, в глубокой он перемножается слой за слоем. Отсюда вердикт слайда: для маленьких сетей годится, для более глубоких может стать проблемой. Не перепутай со стартовыми весами «малые: N(0, 0.01²)» в виджете ниже: там \(\sigma_w = 0.01\), то есть дисперсия 0.0001, в сто раз меньше, чем на слайде.
В виджете видно всё, что слайд 30 лекции 3 и конспект на стр. 184 говорят двумя пунктами. На слайде, под заголовком "In deep networks", они записаны про градиент: при слишком маленьких весах он на каждом слое уменьшается ("shrinks as it passes through each layer"), при слишком больших растёт, пока не станет "too massive to be useful". Слишком маленькие веса (too small): сигнал усыхает слой за слоем, а вместе с ним и градиент — vanishing gradient. Слишком большие (too large): с линейным нейроном и ReLU взрываются и сигнал, и градиент (exploding gradient), с tanh сигнал упирается в насыщение. Между ними одно значение, при котором линия горизонтальна.
Насыщение объясняет и вторую строку списка со слайда 30, про Big Numbers: плохая идея, потому что сходимость может оказаться очень долгой ("very long to converge"). Причину слайд не называет. Для tanh и sigmoid она такая: у нейрона, прижатого к краю, \(g' \approx 0\), его веса почти не получают градиента, и выбирается он оттуда очень долго. А "if unlucky" — потому что веса случайные: сколько нейронов попадёт в насыщение, зависит от того, какие числа выпали.
Сигнал выживает, когда усиление слоя \(n_{in} \cdot \mathrm{Var}(w)\) равно 1.
«Дисперсия должна быть равна 1». В конспекте на стр. 186 стоит список: Var < 1 — vanishing, Var = 1 — stable, Var > 1 — exploding. На стр. 187 то же состояние названо critical regime (Var = 1). Единице должна равняться не сама дисперсия, а отношение дисперсий соседних слоёв, то есть усиление. Сигнал с дисперсией 0.3 на каждом слое прекрасно себя чувствует; лишь бы она не менялась от слоя к слою. Слайд 32 лекции 3 требует именно этого: чтобы дисперсии входа и выхода были "the same", а не чтобы они равнялись единице.
Назад идёт градиент: fan-in против fan-out
Сохранить сигнал в прямом проходе (forward pass) — половина дела. В обратном проходе (backward pass) по той же сети идёт сигнал ошибки \(\delta\), и он тоже проходит цепочку умножений. Нейрон \(i\) слоя \(l\) собирает \(\delta\) со всех \(n_{l+1}\) нейронов следующего слоя:
\[ \delta_i^{(l)} = g'\bigl(z_i^{(l)}\bigr) \sum_{j=1}^{n_{l+1}} w_{ji}^{(l+1)}\, \delta_j^{(l+1)} \]Сумма устроена так же, как в прямом проходе, только слагаемых теперь \(n_{l+1}\): столько, сколько нейронов этот нейрон «кормит». Те же шаги, что на слайде 31 лекции 3 (дисперсия одного слагаемого, нулевые средние, сумма), дают множитель обратного прохода (веса при этом считаем независимыми от \(\delta\) — приближение, которое делают авторы обеих статей, 2010 и 2015 года):
\[ \frac{\mathrm{Var}\bigl(\delta^{(l)}\bigr)}{\mathrm{Var}\bigl(\delta^{(l+1)}\bigr)} = \E\bigl[g'(z)^2\bigr]\; n_{l+1}\,\mathrm{Var}(w) \]В линейном режиме \(g' = 1\), и требование «множитель равен 1» превращается в \(n_{l+1}\,\mathrm{Var}(w) = 1\) для весов \(w^{(l+1)}\).
На слайде 32 лекции 3 весь обратный вывод умещён в одну строку, без выкладок: "similar reasoning for the gradient" дало Glorot и Bengio условие \(n_{out}\,\mathrm{Var}(w_j) = 1\). Здесь \(n_{out}\) — число слагаемых обратной суммы; для весов \(w^{(l+1)}\) это \(n_{l+1}\).
Теперь посмотрим на одну матрицу весов \(W^{(l)}\). Она соединяет слой \(l-1\), где \(n_{l-1}\) нейронов, со слоем \(l\), где их \(n_l\). У этой матрицы два числа, и для двух проходов важны разные.
Вперёд: важно \(n_{in} = n_{l-1}\)
Назад: важно \(n_{out} = n_l\)
Fan-in \(n_{in}\) — число входов нейрона слоя: сколько связей в него входит. Fan-out \(n_{out}\) — число нейронов, в которые идёт выход. Для матрицы \(W^{(l)}\): \(n_{in} = n_{l-1}\), \(n_{out} = n_l\). На слайде 31 лекции 3 число входов обозначено \(I\), на слайде 32 оно же — \(n_{in}\). Самих слов fan-in и fan-out на слайдах нет, там только буквы.
Прямой проход требует \(n_{in}\,\mathrm{Var}(w) = 1\), обратный — \(n_{out}\,\mathrm{Var}(w) = 1\). Оба условия выполняются разом, только если слой квадратный. Glorot и Bengio предложили компромисс: поставить в знаменатель среднее двух чисел, \((n_{in} + n_{out})/2\). На слайде 32 компромисс подан как уступка обратному проходу ("to accommodate for this"), и за этими словами идёт формула:
\[ w \sim N\Bigl(0,\ \frac{2}{n_{in} + n_{out}}\Bigr) \]
\[ \mathrm{Var}\bigl(w_{ji}^{(l)}\bigr) = \frac{2}{n_{in} + n_{out}} \]
- \(n_{in}\)
- \(n_{l-1}\): нейроны слоя, из которого матрица берёт входы
- \(n_{out}\)
- \(n_l\): нейроны слоя, который она кормит
«Усреднить предыдущий и следующий слой». Так сказано в конспекте на стр. 186, и для матрицы \(W^{(l)}\) это легко прочитать как \(n_{l-1}\) и \(n_{l+1}\). Нет: в формуле (71) стоят \(n_{l-1}\) и \(n_l\) — два слоя, которые эта матрица соединяет. Путаница возникает из-за того, что условие (69) записано для \(W^{(l)}\), а условие (70) — для \(W^{(l+1)}\).
Формула задаёт только дисперсию. Из какого распределения брать числа — отдельный выбор, и вариантов два: нормальное (normal) и равномерное (uniform). На слайдах есть только нормальное, \(N(0,\ \cdot)\). Равномерное — за пределами слайдов: оно из исходной статьи и из фреймворков, поэтому знать его полезно.
\( w \sim N(0,\ \sigma^2) \)
\( \sigma = \sqrt{\dfrac{2}{n_{in} + n_{out}}} \)
\( w \sim U(-a,\ a) \)
\( a = \sqrt{\dfrac{6}{n_{in} + n_{out}}} \)
Шестёрка не случайна. У равномерного распределения на отрезке \([-a, a]\) дисперсия равна \(a^2/3\). Приравняй её к \(2/(n_{in} + n_{out})\), и получится \(a^2 = 6/(n_{in} + n_{out})\).
Посчитаем слой с 300 входами и 100 выходами (он же вернётся в задачах в конце урока):
\[ \mathrm{Var}(w) = \frac{2}{300 + 100} = 0.005 \] \[ \sigma = \sqrt{0.005} \approx 0.071 \] \[ a = \sqrt{6/400} \approx 0.122 \]ReLU выбрасывает половину: откуда двойка
Вывод со слайда 31 лекции 3 начинался с линейного нейрона ("a linear neuron"): его выход равен его сумме, \(h = z\). Для tanh около нуля это допущение честное. Для ReLU нет: положительные \(z\) проходят как есть, а отрицательные заменяются нулём. Третье задание виджета показало результат: с усилением \(n\,\mathrm{Var}(w) = 1\) дисперсия падает вдвое на каждом слое. Почему ровно вдвое?
До ReLU: суммы \(z\)
После ReLU: выходы \(h = \max(0, z)\)
-
Нейрон слоя \(l\) считает сумму \(z^{(l)}\) из \(n_{in}\) слагаемых. Его входы — выходы \(h\) предыдущего слоя; на слайде 31 это были \(x_i\). Возвращаемся к замечанию из шага 3 первого вывода: если нулевое среднее есть только у весов, одно слагаемое даёт \(\mathrm{Var}(w)\,\E[h^2]\). Это верно для любой активации, и слагаемые по-прежнему не коррелируют:
\[ \mathrm{Var}\bigl(z^{(l)}\bigr) = n_{in}\,\mathrm{Var}(w)\,\E[h^2] \] -
Сумма \(z\) симметрична вокруг нуля: веса с равной вероятностью положительны и отрицательны. Значит, средний квадрат \(\E[z^2]\) поровну набирается из положительных и отрицательных значений. ReLU оставляет только положительные:
\[ \E[h^2] = \tfrac12\,\E[z^2] = \tfrac12\,\mathrm{Var}(z) \] -
Подставляем в шаг 1. Множитель слоя теперь вдвое меньше:
\[ \frac{\mathrm{Var}\bigl(z^{(l)}\bigr)}{\mathrm{Var}\bigl(z^{(l-1)}\bigr)} = \tfrac12\, n_{in}\,\mathrm{Var}(w) \] -
Требуем, чтобы множитель равнялся 1:
\[ \tfrac12\, n_{in}\,\mathrm{Var}(w) = 1 \] \[ \mathrm{Var}(w) = \frac{2}{n_{in}} \]
\[ w \sim N\Bigl(0,\ \frac{2}{n_{in}}\Bigr) \]
\[ \mathrm{Var}\bigl(w_{ji}^{(l)}\bigr) = \frac{2}{n_{in}} \]
\[ \text{normal:}\quad \sigma = \sqrt{\frac{2}{n_{in}}} \]
\[ \text{uniform:}\quad a = \sqrt{\frac{6}{n_{in}}} \]
- \(n_{in}\)
- число входов нейрона, в конспекте \(n_{l-1}\); \(n_{out}\) в формулу не входит
- \(N(0,\ \cdot)\)
- первая строка — запись слайда; второй аргумент — дисперсия
- \(a\)
- граница \(U(-a, a)\); равномерного варианта на слайдах нет
На слайде 32 лекции 3 эта формула дана одной строкой, без вывода: её позже предложил He, и предназначена она "for rectified linear units", \(w \sim N(0,\ 2/n_{in})\). Вывод выше взят из конспекта (стр. 186) и исходной статьи. Объяснить двойку одной фразой стоит уметь в любом случае: ReLU обнуляет половину сумм.
Для того же слоя 300 → 100, но с ReLU: \(\mathrm{Var}(w) = 2/300 \approx 0.0067\), \(\sigma \approx 0.082\), граница uniform \(a = \sqrt{6/300} \approx 0.141\).
Вот и разгадка из начала урока. Формула 2010 года выведена для режима \(h \approx z\). ReLU на каждом слое выбрасывает половину среднего квадрата, и при \(n\,\mathrm{Var}(w) = 1\) настоящий множитель равен \(\tfrac12\). За тридцать слоёв это \((1/2)^{30}\) по дисперсии и \((1/\sqrt2)^{30} = 2^{-15} = 1/32\,768\) по размаху. Двойка в числителе возвращает множитель к единице: \(\tfrac12 \cdot n \cdot \tfrac{2}{n} = 1\).
He, Zhang, Ren и Sun из Microsoft Research выложили статью с этим выводом 6 февраля 2015 года. В ней же появилась PReLU из прошлого урока и результат 4.94 % top-5 error на ImageNet, первый ниже человеческих 5.1 %. Через пять дней, 11 февраля, вышла статья про batch normalization — тему следующего урока.
А для обратного прохода двойка та же?
Да. У ReLU \(g'(z)\) равна 1 для половины нейронов и 0 для остальных, поэтому \(\E[g'^2] = \tfrac12\), и условие для градиента выглядит так: \(\tfrac12\,n_{out}\,\mathrm{Var}(w) = 1\), то есть \(\mathrm{Var}(w) = 2/n_{out}\). Авторы статьи показали, что достаточно выполнить любое из двух условий. По умолчанию берут вариант с \(n_{in}\).
Для Leaky ReLU с наклоном \(\alpha\) слева от нуля формула превращается в \(2/\bigl((1 + \alpha^2)\,n_{in}\bigr)\). При \(\alpha = 0.01\) поправка незаметна, поэтому в таблице конспекта Leaky ReLU стоит в одной строке с ReLU.
Что выбрать и чего инициализация не обещает
| Инициализация | Для каких \(g\) | \(\mathrm{Var}(w)\) | normal: \(\sigma\) | uniform: \(a\) |
|---|---|---|---|---|
| Xavier (Glorot) | tanh, sigmoid | \(\dfrac{2}{n_{in} + n_{out}}\) | \(\sqrt{\dfrac{2}{n_{in} + n_{out}}}\) | \(\sqrt{\dfrac{6}{n_{in} + n_{out}}}\) |
| He (Kaiming) | ReLU, Leaky ReLU | \(\dfrac{2}{n_{in}}\) | \(\sqrt{\dfrac{2}{n_{in}}}\) | \(\sqrt{\dfrac{6}{n_{in}}}\) |
| Xavier, только прямой проход (69); она же LeCun | линейный режим | \(\dfrac{1}{n_{in}}\) | \(\sqrt{\dfrac{1}{n_{in}}}\) | \(\sqrt{\dfrac{3}{n_{in}}}\) |
Третья строка — тоже Xavier, и на слайде 32 лекции 3 она идёт первой: именно её профессор выводит и подписывает "Xavier proposes to initialize" \(w \sim N(0,\ 1/n_{in})\). Так же, одним прямым проходом, Xavier объясняют два ресурса из списка в конце урока. Формула с суммой стоит на слайде следом, как поправка на обратный проход; в исходной статье и в конспекте название закреплено за ней. Для квадратного слоя, где \(n_{in} = n_{out}\), обе совпадают. В расчётной задаче не гадай: если даны оба числа, считай по \(2/(n_{in} + n_{out})\), если только число входов — по \(1/n_{in}\), и в любом случае напиши, какую формулу берёшь.
«Xavier — это uniform, а He — это normal». Нет: обе существуют в обоих вариантах, а на слайде 32 лекции 3 обе записаны через \(N(0,\ \cdot)\). Отличает их дисперсия, а не форма распределения.
Почему Xavier советуют и для sigmoid, если вывод сделан для режима \(h \approx z\)?
Вывод опирается на два допущения: выходы в среднем нулевые и нейрон около нуля ведёт себя как линейный с наклоном 1. tanh именно такой. У sigmoid выходы лежат между 0 и 1, среднее около 0.5, наклон в нуле ¼, так что допущения выполняются хуже; слова конспекта о симметричных положительных и отрицательных активациях к sigmoid не подходят.
На экзамене правило «Xavier для sigmoid и tanh, He для ReLU» остаётся правильным ответом: это таблица 4 конспекта и общепринятое практическое правило. Половину про He подтверждает слайд 32 лекции 3: "for rectified linear units". Про то, для каких активаций годится Xavier, слайды молчат: там есть только оговорка про линейное допущение.
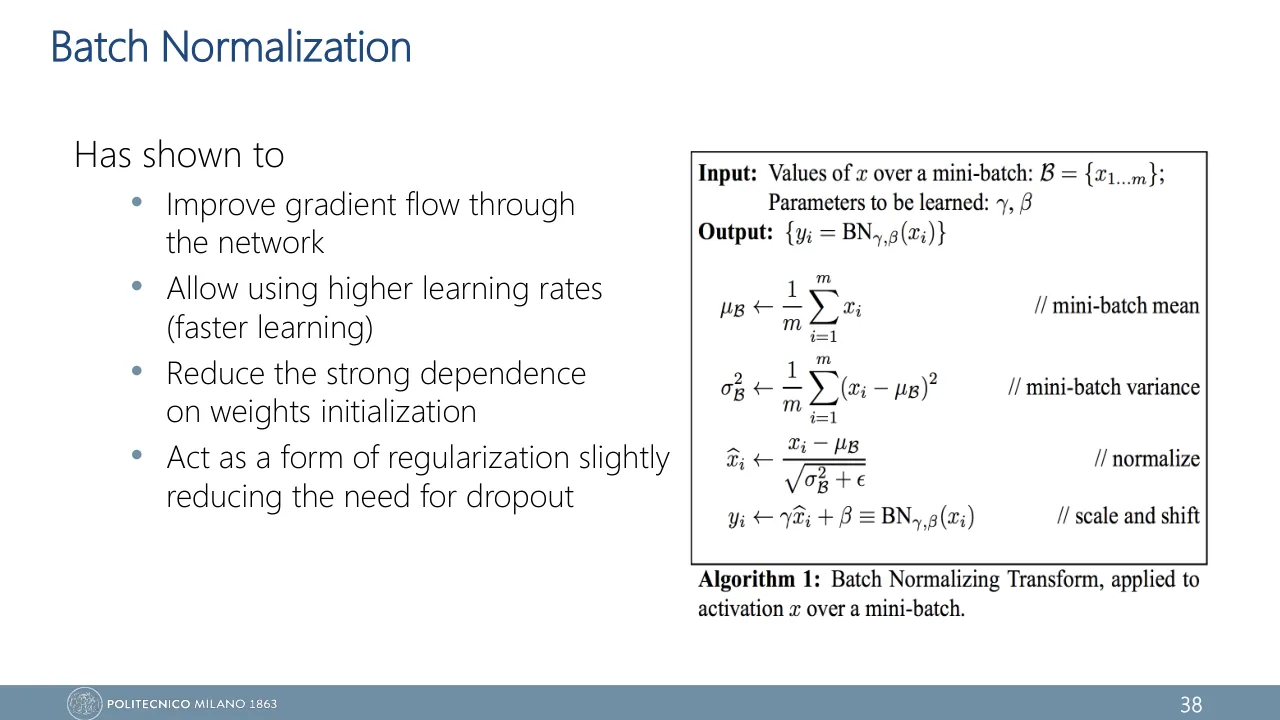
Главное ограничение: Xavier и He настраивают множитель только в момент старта. Как только обучение сдвинет веса, их дисперсия уйдёт от расчётной, и распределения на входах слоёв поплывут. В конспекте на стр. 187 эта фраза выделена жёлтым не зря. Хорошая инициализация даёт сети возможность начать учиться, а не гарантию на всё обучение. Слайды говорят о том же с другой стороны: среди достоинств batch normalization названо то, что она ослабляет сильную зависимость от weights initialization (лекция 3, слайд 37).
В расчётной задаче сначала выпиши \(n_{in}\) и \(n_{out}\) по словам условия («layer with 300 inputs and 100 outputs»), потом выбери формулу по функции активации, и только потом считай. И проверь, что спрашивают: дисперсию, \(\sigma\) или границу \(a\). Между дисперсией и \(\sigma\) стоит корень, между \(\sigma\) и \(a\) — множитель \(\sqrt3\); перепутать их проще всего.
В формате экзамена
Derive the Xavier initialization as seen in class. Start from a linear neuron with \(I\) inputs and random weights, state your assumptions and obtain the condition that keeps the variance of the output equal to the variance of the input. Then give the analogous condition for the gradient and the final formula of Glorot & Bengio.
Show model answer
Consider a linear neuron with \(I\) inputs \(x_1, \dots, x_I\) and random weights; the bias is initialized to zero. Its output is
\[ h_j = w_{j1}x_1 + \dots + w_{jI}x_I \]The weights are drawn independently of the inputs, so the variance of one term is
\[ \begin{aligned} \mathrm{Var}(w_{ji}x_i) &= \E[x_i]^2\,\mathrm{Var}(w_{ji}) \\ &\quad {} + \E[w_{ji}]^2\,\mathrm{Var}(x_i) \\ &\quad {} + \mathrm{Var}(w_{ji})\,\mathrm{Var}(x_i) \end{aligned} \]With zero-mean inputs and zero-mean weights the first two terms vanish:
\[ \mathrm{Var}(w_{ji}x_i) = \mathrm{Var}(w_{ji})\,\mathrm{Var}(x_i) \]Assuming that the weights and the inputs are i.i.d., the \(I\) terms are independent and have the same variance, so
\[ \mathrm{Var}(h_j) = I \cdot \mathrm{Var}(w_i)\,\mathrm{Var}(x_i) \]The output variance is the input variance scaled by \(I \cdot \mathrm{Var}(w_i)\). The output of one layer is the input of the next, so the variance stays the same across layers only if
\[ I \cdot \mathrm{Var}(w) = 1 \]that is \(w \sim N(0,\ 1/n_{in})\) with \(n_{in} = I\); the second argument is the variance. The same reasoning for the gradient, which a linear neuron collects from the \(n_{out}\) units it feeds,
\[ \delta_i = \sum_{j=1}^{n_{out}} w_{ji}\,\delta_j \]gives \(n_{out}\,\mathrm{Var}(w) = 1\). Both conditions hold only if \(n_{in} = n_{out}\), so Glorot & Bengio propose the compromise
\[ w \sim N\Bigl(0,\ \frac{2}{n_{in} + n_{out}}\Bigr) \]The linear neuron is a strong assumption, but tanh is close to linear around zero and in practice the formula works.
Ответ идёт строка за строкой по слайдам 31–32 лекции 3, с теми же буквами: \(I\), \(n_{in}\), \(n_{out}\). Проверяют четыре вещи: допущения названы (линейный нейрон, нулевое среднее у входов и весов, i.i.d.); есть формула с тремя слагаемыми и шаг про сумму; названы оба условия, для выхода и для градиента; итог объяснён как компромисс между ними. Одной итоговой формулы мало: вопрос начинается со слова derive.
A linear neuron has \(I = 400\) inputs, i.i.d. with zero mean and variance 1. Its weights are drawn independently from \(N(0,\ \sigma^2 = 0.01)\). Compute the variance of its output \(h_j\).
Show model answer
\[ \mathrm{Var}(h_j) = I \cdot \mathrm{Var}(w_i)\,\mathrm{Var}(x_i) \]
\[ \mathrm{Var}(h_j) = 400 \cdot 0.01 \cdot 1 = 4 \]
The variance of the output is 4 times the variance of the input. To keep it the same the weights need \(\mathrm{Var}(w) = 1/400 = 0.0025\).
Формула — итог слайда 31 лекции 3. Ловушка в записи \(N(0,\ \cdot)\): на слайдах второй аргумент — дисперсия. Если принять 0.01 за \(\sigma\), получится \(400 \cdot 0.0001 = 0.04\), ошибка в сто раз.
A fully connected layer with tanh activation has 300 inputs and 100 outputs. Its weights are drawn from a normal distribution with the Xavier (Glorot & Bengio) variance that takes both the forward and the backward pass into account. Compute the standard deviation of the weights.
Show model answer
\[ w \sim N\Bigl(0,\ \frac{2}{n_{in} + n_{out}}\Bigr) \]
\[ \mathrm{Var}(w) = \frac{2}{300 + 100} = 0.005 \]
\[ \sigma = \sqrt{0.005} \approx 0.0707 \]
Три типичные потери. Ответить 0.005: это дисперсия, а спрашивают стандартное отклонение. Взять \(2/300\): это формула He. Взять \(1/300\): это первая формула слайда 32 лекции 3, \(N(0,\ 1/n_{in})\), она следит только за прямым проходом, а в вопросе названы оба.
The same layer (300 inputs, 100 outputs) now uses ReLU and He uniform initialization, \(w \sim U(-a, a)\). Compute \(a\).
Show model answer
He: \(\mathrm{Var}(w) = 2/n_{in} = 2/300\). A uniform distribution on \([-a, a]\) has variance \(a^2/3\), therefore
\[ a = \sqrt{\frac{6}{n_{in}}} = \sqrt{0.02} \approx 0.1414 \]Формулу с шестёркой не обязательно помнить: достаточно знать, что у \(U(-a, a)\) дисперсия \(a^2/3\), и приравнять её к \(2/n_{in}\). Число выходов 100 здесь лишнее — его дают, чтобы проверить, не перепутаны ли He и Xavier. Равномерного варианта на слайдах нет, там только \(N(0,\ 2/n_{in})\); задача — на случай, когда распределение задано в условии.
Why can the weights of a Feed Forward Neural Network not all be initialized to zero, or to the same constant?
Show model answer
With identical weights all neurons of a hidden layer compute the same output and receive the same gradient, so after every update they are still identical: the symmetry is never broken and the layer is equivalent to a single neuron.
With all-zero weights it is even worse. With tanh or ReLU hidden units the hidden outputs are \(g(0) = 0\), so the gradients of the next layer's weights, \(\delta_j h_i\), are zero, and the hidden \(\delta\) are zero because they are multiplied by zero weights. All the gradients of the weights are zero and no learning happens: only the output bias can move, so the network learns at most a constant. With sigmoid hidden units \(g(0) = 0.5\), so the gradients are not all zero, but they are identical within a layer, which is again the symmetry problem.
Random initialization breaks the symmetry; its scale must then be chosen so that the variance of activations and gradients is preserved across layers (Xavier, He). Biases can be initialized to zero.
Ключевые слова ответа: same output, same gradient, symmetry. На слайде 30 лекции 3 про нули сказано коротко: "All gradient would be zero", и обучения не будет. Эту фразу стоит привести, но одной её мало: она верна только для нулей, и то не для каждой активации. При ненулевой константе градиенты не нулевые, а одинаковые, и вопрос про константу фраза слайда не закрывает.
All the layers of a Feed Forward Neural Network are initialized with \(w \sim N(0,\ \sigma^2 = 0.01)\), whatever their size. Explain why this is good for small networks but might be a problem for deeper ones. What happens to the gradient if the weights start too small or too large? What do Xavier and He initialization propose instead?
Show model answer
For a linear neuron with \(I\) zero-mean i.i.d. inputs the output variance is the input variance scaled by \(I \cdot \mathrm{Var}(w)\). With a fixed variance the scale factor is \(0.01 \cdot I\): it equals 1 only for \(I = 100\), it is smaller for narrower layers and larger for wider ones.
In a small network a factor different from 1 is applied only a couple of times and training still works. In a deep network it is applied at every layer and compounds exponentially. If the weights start too small, the signal and its gradient shrink at every layer (vanishing gradient). If they start too large, the gradient grows at every layer until it is too large to be useful (exploding gradient); with sigmoid or tanh units the neurons saturate instead, and convergence can take very long.
Xavier and He initialization tie the variance to the size of the layer, so that the factor is 1. Xavier: \(w \sim N(0,\ 1/n_{in})\) or, taking the gradient into account as well, \(w \sim N\bigl(0,\ 2/(n_{in} + n_{out})\bigr)\). He, for rectified linear units: \(w \sim N(0,\ 2/n_{in})\).
Вопрос собран из слайда 30 лекции 3, и ответ идёт по его строкам: вердикт про \(N(0,\ \sigma^2 = 0.01)\), потом фразы "too small" и "too large", потом три формулы слайда 32 лекции 3. Сами вердикты слайда — только половина ответа. Вторая половина — причина: множитель \(I \cdot \mathrm{Var}(w)\) не равен 1 и перемножается по слоям.
A network has ReLU layers of equal width \(n\), zero biases and weights \(w \sim N(0,\ 1/n)\), so that \(n\,\mathrm{Var}(w) = 1\). By what factor is the standard deviation of the pre-activations multiplied after 10 such layers (for instance from layer 1 to layer 11)?
Show model answer
ReLU zeroes the negative half of the pre-activations, so \(\E[h^2] = \tfrac12 \mathrm{Var}(z)\) and each layer multiplies the variance by \(\tfrac12\,n\,\mathrm{Var}(w) = \tfrac12\).
After 10 layers the variance is multiplied by
\[ \left(\tfrac12\right)^{10} = \tfrac{1}{1024} \]and the standard deviation by
\[ \sqrt{\tfrac{1}{1024}} = \tfrac{1}{32} \approx 0.031 \]The signal vanishes; He initialization, \(\mathrm{Var}(w) = 2/n\), restores a factor of 1.
Ловушка в словах standard deviation: множитель ½ относится к дисперсии, для стандартного отклонения это \(1/\sqrt2\) за слой. Ответ 1/1024 — правильная арифметика для не той величины.
Which statements about weight initialization are correct? Select all that apply.
Show model answer
Correct: the first, the third and the fifth statement. The second confuses the variance with the shape of the distribution; the fourth ignores that weights drift away from their initial statistics as soon as training starts.
В вопросах «select all» проверяй каждое утверждение отдельно и отмечай только то, что можешь обосновать одной фразой. Здесь три обоснования: одинаковые поправки, половина среднего квадрата, \(2/(n + n) = 1/n\).
Проверь себя
Какая величина должна равняться 1, чтобы сигнал прошёл через глубокую сеть с tanh, не затухая и не раздуваясь?
В сети с одним скрытым слоем (tanh) все веса, и входящие в скрытые нейроны, и выходящие из них, инициализированы числом 0.5. Что из этого верно?
Картинка для памяти: два человека, которые начали в одной точке и на каждой развилке получают одну и ту же подсказку. Они не разойдутся никогда.
Матрица \(W^{(l)}\) имеет размер 100 × 400: слой из 400 нейронов кормит слой из 100. Чему равна дисперсия Xavier для её весов по формуле, которая учитывает и прямой, и обратный проход?
Откуда двойка в формуле He?
Сеть из 20 слоёв по 100 нейронов, tanh, веса \(N(0, 1)\). Что покажет прямой проход до начала обучения?
Сеть с ReLU инициализирована по формуле He, и на старте дисперсия одинакова на всех слоях. Что можно утверждать после тысячи шагов обучения?
Нейрон получает 50 входов. Веса берут из \(U(-a, a)\) и хотят усиление прямого прохода, равное 1, в линейном режиме. Какое \(a\) нужно?
Унести с собой
- Одинаковые стартовые веса делают нейроны слоя клонами навсегда, а нули с tanh или ReLU обнуляют градиенты всех весов; на слайде 30 лекции 3 это строка про Zeros: "All gradient would be zero". Симметрию ломают случайные веса; bias можно начинать с нуля.
- Сеть — это цепочка умножений: за один слой дисперсия сигнала умножается на \(n_{in}\,\mathrm{Var}(w)\,\kappa\), где \(\kappa = 1\) в линейном режиме и \(\tfrac12\) для ReLU. При слишком маленьких весах сигнал и градиент затухают, при слишком больших — взрыв у ReLU и линейного нейрона, насыщение у tanh. Выживает только множитель 1.
- Xavier (слайды 31–32 лекции 3): у линейного нейрона с \(I = n_{in}\) входами дисперсия выхода равна дисперсии входа, умноженной на \(I\,\mathrm{Var}(w)\). Прямой проход просит \(n_{in}\,\mathrm{Var}(w) = 1\), то есть \(N(0,\ 1/n_{in})\), обратный \(n_{out}\,\mathrm{Var}(w) = 1\), компромисс \(2/(n_{in} + n_{out})\). Для tanh и sigmoid.
- He (слайд 32 лекции 3, там только формула): ReLU оставляет половину среднего квадрата, \(\E[h^2] = \tfrac12\mathrm{Var}(z)\), поэтому \(\mathrm{Var}(w) = 2/n_{in}\). Для ReLU и Leaky ReLU.
- Normal и uniform — два способа получить одну и ту же дисперсию: у \(U(-a, a)\) она равна \(a^2/3\). На слайдах только normal, и второй аргумент \(N(0,\ \cdot)\) там — дисперсия, а не \(\sigma\).
- Всё это верно только на старте обучения; дальше нужна batch normalization.
Что посмотреть и почитать
-
Improving the way neural networks learn, раздел Weight initialization
Michael Nielsen, Neural Networks and Deep Learning, гл. 3
Мягкий вход в тему: почему веса нужно уменьшать, когда у нейрона много входов. Сайт открывается только по http, браузер покажет пометку «не защищено».
-
AI Notes: Initializing neural networks
Kian Katanforoosh, Daniel Kunin · deeplearning.ai
Два интерактива: маленькая сеть учится с нулевыми, слишком малыми, подходящими и слишком большими весами. Вывод там сделан только для прямого прохода, поэтому Xavier записана как \(1/n_{in}\): это первая формула слайда 32 лекции 3 и третья строка нашей таблицы.
-
Lecture 6 | Training Neural Networks I
Stanford CS231n, Spring 2017
Те же гистограммы активаций слой за слоем для слишком малых, слишком больших весов, Xavier и He, плюс ReLU и batch normalization в одной лекции. Хорошо связывает уроки 24–26.
-
Understanding the difficulty of training deep feedforward neural networks
Xavier Glorot, Yoshua Bengio · AISTATS 2010
Источник формулы (71). Смотри рисунки с гистограммами активаций и раздел, где условия прямого и обратного прохода сводятся в одну формулу.
-
Delving Deep into Rectifiers
He, Zhang, Ren, Sun · 2015
Источник формулы (72). Достаточно раздела 2.2: это вывод из нашего второго степпера, записанный авторами.