Почему именно 2012 год
После этого урока ты назовёшь три ингредиента, которые сошлись в 2012 году, правильно прочитаешь цифру «top-5 error 15.3 %» и объяснишь, когда deep learning не нужен и почему ChatGPT — тоже он.
Осенью 2012 года нейросеть AlexNet выиграла конкурс по распознаванию изображений ImageNet: её показатель ошибки (top-5 error, о нём ниже) — 15.3 % против 26.2 % у второго места. Обучали её не в дата-центре. Обычный настольный компьютер с двумя игровыми видеокартами пять-шесть дней работал в спальне Алекса Крижевского, в доме его родителей.
Странно здесь другое. Искусственный нейрон описан в 1943 году. Способ обучать многослойные сети — в 1986-м. Сети для изображений — к 1998-му. Чертёж лежал в ящике десятилетиями.
Чего не хватало всё это время? И почему в итоге хватило двух видеокарт из магазина?
Три дорожки и одна точка встречи
В прошлом уроке deep learning получил определение: сеть сама учит и признаки (learned features), и классификатор, от сырых данных до ответа. Идея красивая, но она гораздо старше 2012 года. Поэтому вопрос этого урока — не «что это такое», а «почему это заработало именно тогда».
Представь ракету. Чтобы она взлетела, нужны три вещи сразу: чертёж, двигатель и топливо. Мощный двигатель с пустыми баками не оторвётся от земли. Полные баки с маленьким двигателем — тоже. А чертёж без того и другого просто лежит в ящике.
У deep learning эти три вещи называются так: алгоритмы (чертёж: как устроена сеть и как её учить), вычисления (двигатель: на чём считать) и данные (топливо: на чём учиться). В виджете каждая из них — отдельная дорожка на шкале времени.
Что показала шкала. Чертёж был готов раньше всех: backpropagation — в 1986 году, convolutional networks — к 1998-му. Оба слова ещё встретятся (backpropagation — в уроке 14). Сейчас важно одно: к 1998 году было известно, как построить такую сеть. Не было того, на чём её учить и чем считать.
Топливо: данные
В 1936 году хороший набор данных — это Iris: 150 цветков. В 2012-м конкурс ILSVRC даёт 1.2 миллиона размеченных изображений в 1000 классах. Между этими числами — интернет и огромный ручной труд: весь ImageNet (больше 14 миллионов изображений, больше 20 тысяч категорий) почти два года размечали 49 тысяч человек из 167 стран.
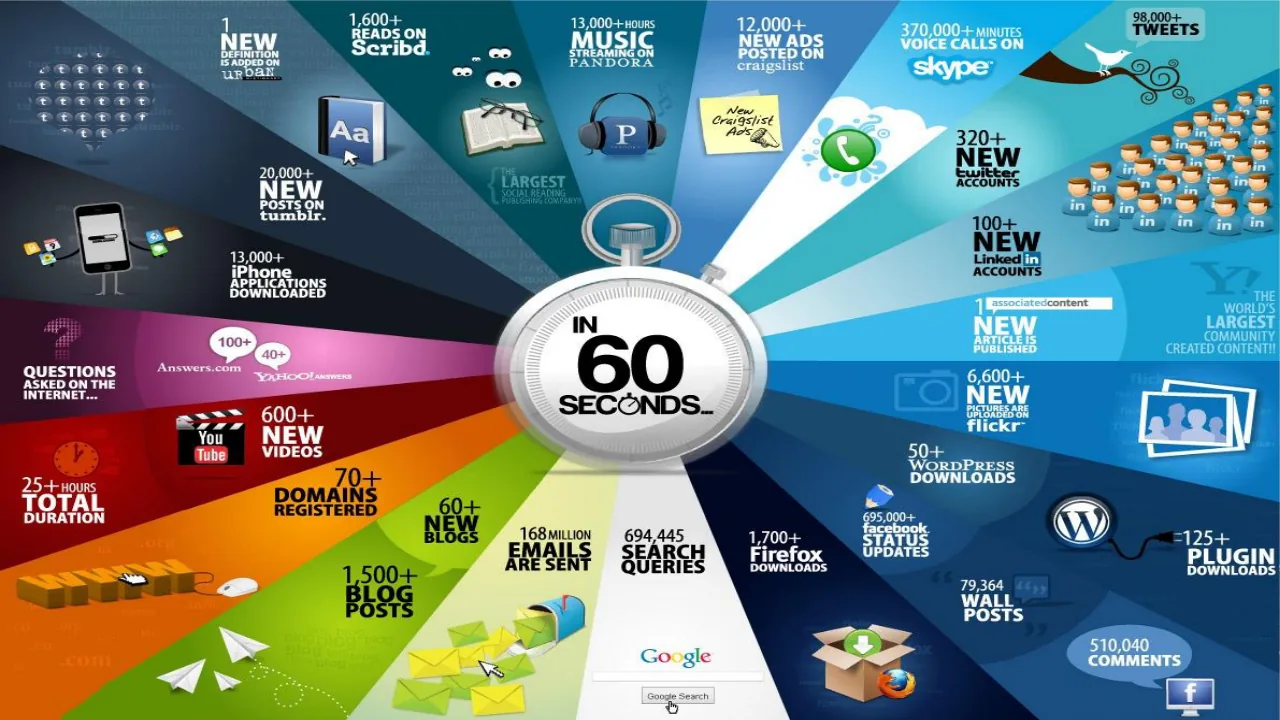
Слайд 27 лекции 1 показывает, откуда берётся сырьё: каждую минуту в интернете появляются больше ста миллионов писем, сотни тысяч поисковых запросов, сотни новых видео. Но сырьё — ещё не топливо. Для supervised learning нужны пары «вход и target», то есть \(\langle x_n, t_n \rangle\). Дорого стоила именно разметка \(t_n\).
Двигатель: вычисления
Обучение сети — это миллионы одинаковых умножений и сложений. Видеокарта (GPU) создана как раз для однотипных операций над большими массивами чисел. 2012 год даёт наглядное сравнение. Команда Google и Stanford учила свою сеть три дня на 1000 машин с 16 000 процессорных ядер. AlexNet обошлась двумя игровыми видеокартами и пятью-шестью днями. Задачи у этих сетей разные, но масштаб железа показателен.
Чертёж: что дорисовали в последний момент
Чертёж тоже не остался прежним. В статье про AlexNet есть три свежие детали: функция активации ReLU (в опыте авторов сеть с ней училась примерно в шесть раз быстрее, чем с tanh), dropout и data augmentation. Первые две ждут в уроках 24 и 23. Так что точная формулировка — не «алгоритмы были готовы», а «основа была готова, несколько важных деталей появились в последний момент».
AlexNet в цифрах и что считает top-5 error
Теперь сама точка встречи: сеть Krizhevsky, Sutskever и Hinton, 2012 год. Её цифры стоит знать: по ним видно, что значит «глубокая сеть на больших данных».
| Что | Сколько |
|---|---|
| Обучаемых слоёв | 8: пять convolutional и три fully connected |
| Параметров (весов) | около 60 млн |
| Нейронов | 650 000 |
| Выход | softmax на 1000 классов |
| Данные | 1.2 млн изображений, 1000 классов (ILSVRC-2012) |
| Обучение | 5–6 дней на двух GPU GTX 580 по 3 ГБ |
| Результат | top-5 error 15.3 % против 26.2 % у второго места |
Два числа отсюда полезно получить самому. Первое: 60 млн параметров на 1.2 млн картинок — это \(60 / 1.2 = 50\) параметров на каждую обучающую картинку. У модели гораздо больше «ручек», чем примеров, и она легко могла бы просто запомнить обучающую выборку. Это overfitting, ему посвящён урок 17. Поэтому авторам и понадобились dropout и data augmentation.
Второе число — насколько AlexNet обогнала соперника. Второе место заняла классическая система из прошлого урока: признаки, придуманные человеком (SIFT и родственные ему), и обученные поверх них классификаторы.
Ошибок на 41.6 % меньше, чем у лучшей классической системы того же конкурса, причём без единого признака, придуманного человеком. Осталось понять, что именно здесь называется ошибкой.
Одна догадка или пять
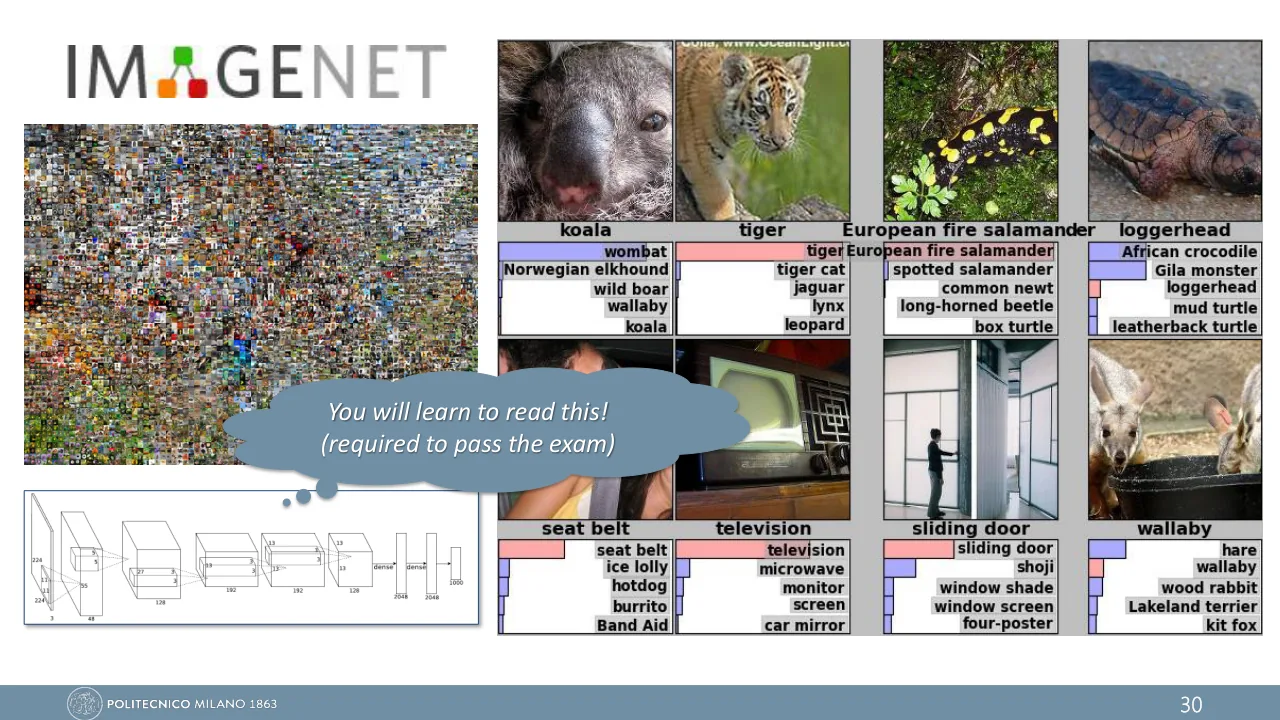
В конкурсе ILSVRC 1000 классов, и многие из них похожи: сеть должна отличить коалу от вомбата, а один вид черепах — от другого. К тому же на фотографии часто несколько предметов сразу. Поэтому на конкурсе модели разрешено назвать пять вариантов. Ответ засчитывается, если правильный класс есть среди этих пяти.
Слайд 30 лекции 1 показывает восемь тестовых картинок и пять самых вероятных ответов AlexNet на каждую. Вот одна из них: на фото морская черепаха loggerhead.
Top-1: засчитывается одна догадка
Top-5: засчитываются пять догадок
Top-k error — доля тестовых примеров, у которых правильного класса нет среди \(k\) классов с наибольшим выходом сети. Top-1 error — обычная доля ошибок: засчитывается только самый вероятный ответ. Результаты на ImageNet принято сообщать как top-5 error.
- \(N\)
- число тестовых примеров
- \(x_n\)
- вход: \(n\)-я картинка
- \(t_n\)
- target: её правильный класс
- \(\mathrm{top}_k(x_n)\)
- \(k\) классов с самыми большими выходами сети \(g_c(x_n \mid w)\), \(c = 1, \dots, K\)
- \([\,\cdot\,]\)
- 1, если условие в скобках выполнено, иначе 0
Формула просто считает промахи и делит на число примеров. Проверь её на тех самых восьми картинках.
Что стало возможным
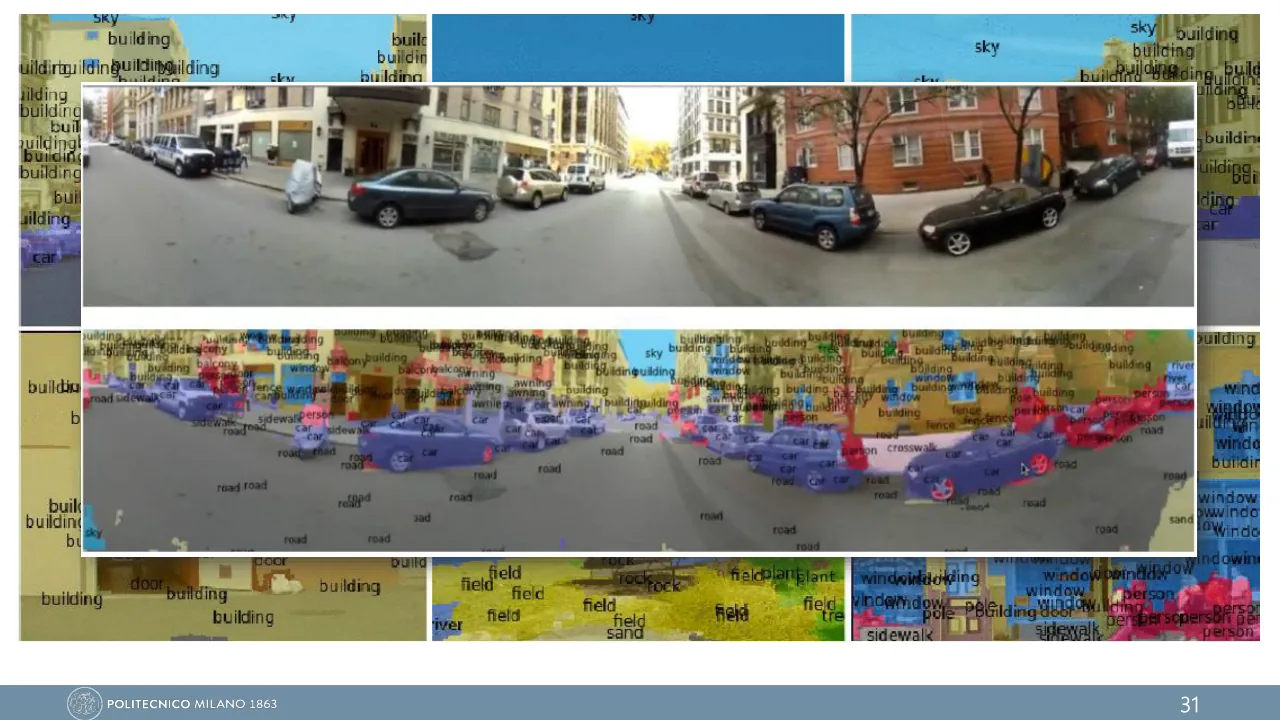
Выученные признаки пригодились не только для классификации. На слайдах 31–35 те же сети подписывают каждый пиксель сцены: дорога, небо, машина (semantic segmentation). Выделяют каждый объект отдельно (instance segmentation). Переносят манеру художника на фотографию (style transfer). Дорисовывают детали в размытом снимке (super-resolution). Рисуют картинку по текстовому описанию (text-to-image). Заучивать список не нужно. Нужно видеть общее: ни в одной из пяти задач признаки не придуманы человеком.
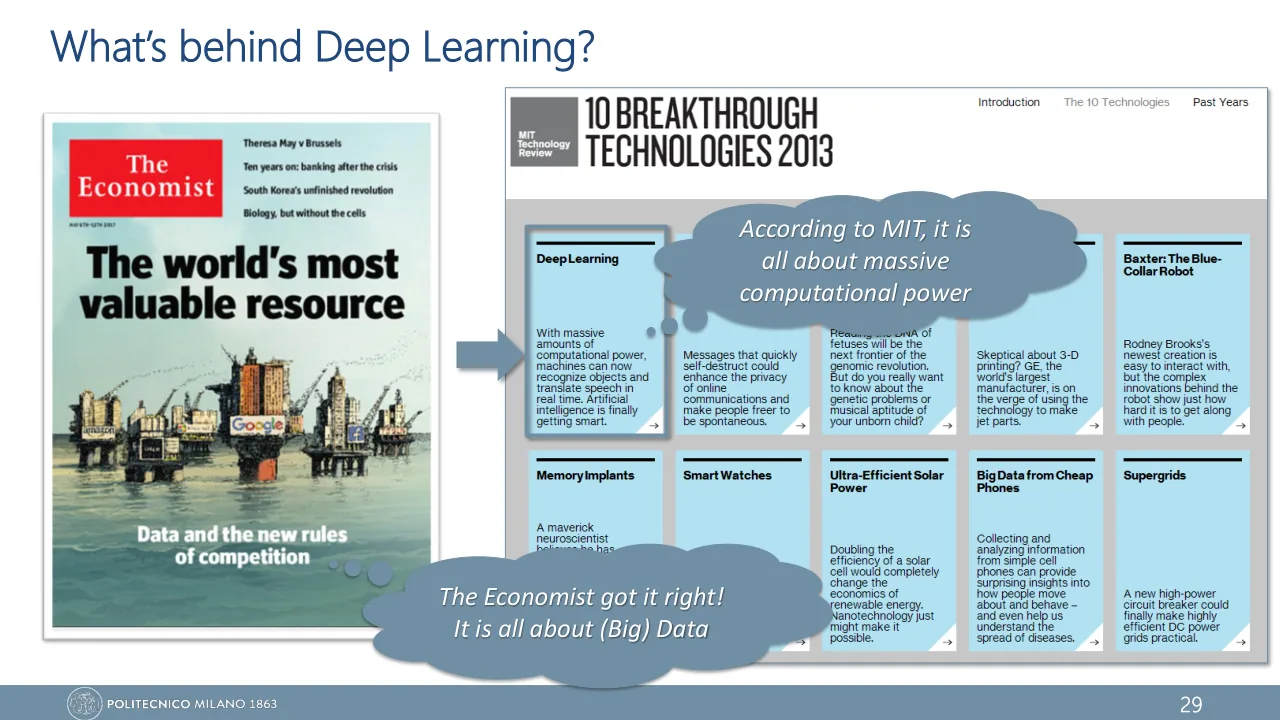
MIT против The Economist: что писать на экзамене
На слайде 29 лекции 1 рядом лежат две журнальные страницы. Каждая отвечает на вопрос «что стоит за deep learning» по-своему.
Список «10 Breakthrough Technologies 2013». Заметка о deep learning объясняет успех огромной вычислительной мощностью.
Ингредиент: вычисления.
Обложка о том, что самый ценный ресурс в мире теперь не нефть, а данные.
Ингредиент: данные.
Страницу MIT профессор показывает трижды. Первый раз — на слайде 17, рядом со стеной логотипов компаний под штампом «OUTDATED»: список игроков устаревает быстрее, чем слайды. На слайдах 28–29 к ней добавлена подпись: по версии MIT всё дело в massive computational power.
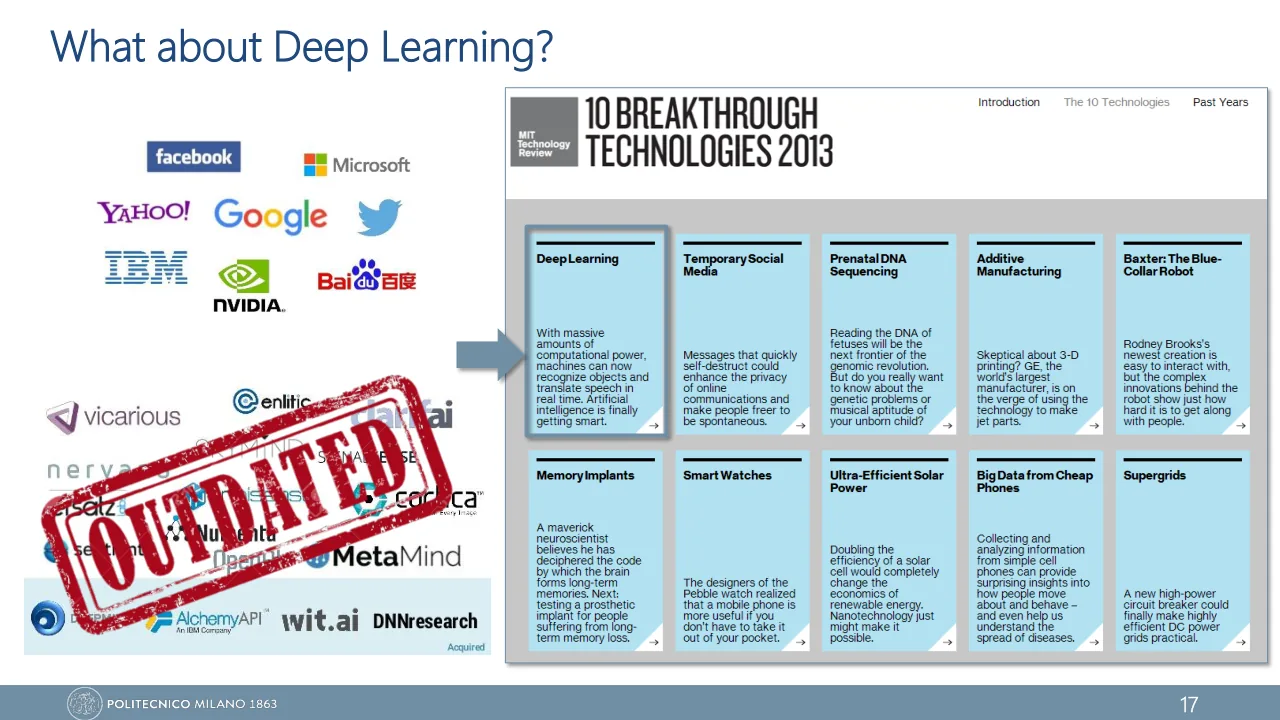
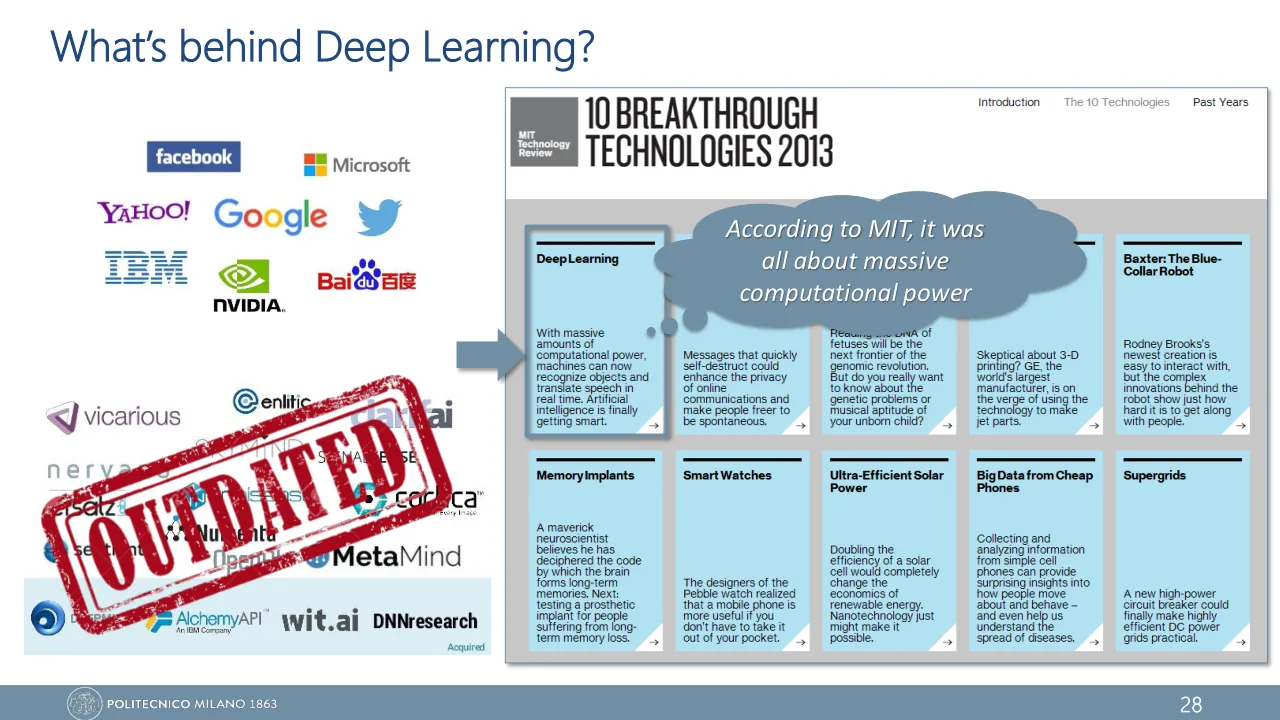
Ничью профессор не объявляет. Вторая подпись на слайде 29: прав The Economist, «it is all about (Big) Data». А вопрос, которым лекция заканчивается, — «But which data?» — превращается в план всего курса.
На вопрос «что стоит за deep learning» сначала называй данные (так на слайде), затем вычисления и доработки алгоритмов.
Почему акцент именно на данных? Вспомни 50 параметров на картинку. Сеть с миллионами весов можно обсчитать и на медленном железе: это вопрос терпения. Но обучить её с нуля на 150 примерах нельзя ничем: она их запомнит и ничего не обобщит. Вычисления определяют, сколько времени займёт обучение. Данные определяют, получится ли оно вообще.
Когда deep learning не нужен
Из истории 2012 года легко сделать неверный вывод: раз deep learning победил, им надо решать всё. Возьми два случая. Первый: 300 записей с датчиков промышленного станка, нужно предсказать поломку. Второй: миллион фотографий с подписями. В первом случае сеть с миллионами весов запомнит все 300 записей и ошибётся на новых. Во втором она на своём месте.
Конспект (стр. 28) называет три условия, при которых deep learning — лучший инструмент: много разнообразных данных, много вычислений и задача на восприятие или распознавание закономерностей (perception, pattern recognition). Если условия не выполнены, классические методы могут оказаться проще, быстрее и не хуже.
Дальше конспект (стр. 28–29) перечисляет семь причин выбрать что-то другое. Причины верные, но несколько формулировок слишком категоричны. Ниже — причины вместе с поправками.
- Нужно много данных. Миллионы весов на сотнях примеров дают overfitting. Ориентир из учебника курса (Goodfellow и соавторы, «Deep Learning», 2016): около 5000 размеченных примеров на класс для приемлемого качества и от 10 млн, чтобы сравняться с человеком. Поправка: «только на огромных размеченных наборах» — слишком сильно. Transfer learning, data augmentation и self-supervised pre-training позволяют обойтись малым числом меток.
- Нужны вычисления. GPU, время, электричество; классические методы работают на ноутбуке. Поправка: «недели на GPU» — не правило. AlexNet училась 5–6 дней, маленькие сети учатся за минуты.
- Чёрный ящик. Трудно объяснить, почему сеть решила именно так. В медицине, праве и финансах объяснение бывает обязательным.
- Трудно обучать и настраивать. Много hyperparameters (урок 21), обучение может расходиться или застревать (урок 24). Поправка: learning rate и dropout конспект относит к «архитектуре», но это настройки обучения и регуляризации.
- Не тот тип задачи. Таблицы: деревья (XGBoost, random forest) часто не хуже или лучше. Логический вывод по правилам. Причинность: вопрос «что будет, если мы сделаем X», а не «что обычно бывает при X».
- Нужны хорошие данные. Ошибки разметки, перекосы в выборке, сдвиг между данными обучения и применения: garbage in, garbage out. Поправка: «классические методы устойчивее к шуму» — правило большого пальца, а не установленный факт.
- Распознавание — не понимание. Сеть находит закономерности, но не обязана «знать», что такое кошка. Отсюда исследования гибридных систем, где сеть соединяют с логическим выводом (neuro-symbolic AI). Поправка: «не понимает» — философская позиция, а не измеренный результат. На экзамене подавай её как мнение.
Пункт про таблицы знаком по Applied Statistics. В таблице каждый столбец — уже осмысленный признак: масса, радиус, период. Учить представление там незачем, его дало само измерение. Поэтому PCA, регрессия и деревья справляются на сотнях строк, а глубокой сети негде развернуться. Есть и прямое подтверждение: на 45 табличных наборах среднего размера (порядка 10 тысяч строк) ансамбли деревьев остались впереди нейросетей (Grinsztajn и соавторы, 2022).
Три вопроса перед тем, как брать deep learning. Сколько у меня размеченных примеров: сотни или сотни тысяч? Данные сырые или это таблица с готовыми признаками? Придётся ли объяснять каждое решение? Ответы «сотни», «таблица», «да» — три довода за классический метод. Они же — готовый ответ на экзаменационный вопрос «When would you not use deep learning?».
ChatGPT — это тоже deep learning
Может показаться, что ChatGPT, LLaMA, Gemini или Claude — уже что-то другое, «после» deep learning. Нет. Все они — Large Language Models (LLM, большие языковые модели): глубокие сети с архитектурой Transformer, которую в 2017 году описали Vaswani и соавторы в статье «Attention Is All You Need». Сверим это с определением из прошлого урока.
Сырые данные — текст. Признаки никто не задаёт: сеть сама учит, каким вектором чисел представить каждое слово (embedding) и как слой за слоем уточнять его с учётом соседей. Последний слой — классификатор: он раздаёт вероятности всем словам словаря, и по ним выбирается следующее слово. Правил грамматики модели никто не сообщает. Определение выполнено по всем пунктам.
Масштаб для ориентира. GPT-2 small, маленькая по нынешним меркам модель, — это 12 Transformer-блоков, 124 млн параметров, а каждый token внутри представлен вектором из 768 чисел. А вот цифру конспекта «100+ слоёв в GPT-4» (стр. 30) проверить нельзя: архитектура GPT-4 не опубликована.
Чему именно учат LLM
Задача звучит почти по-детски: угадай следующее слово. Точнее — следующий token: слово, часть слова или знак препинания. Клавиатура телефона занята тем же, когда подсказывает продолжение фразы.
Начнём с самой простой модели такого рода. Она помнит только одно последнее слово и знает, что обычно идёт после него. Называется bigram model, и «обучить» её можно подсчётом на пальцах.
От игрушки до настоящей модели один шаг. LLM смотрит не на одно последнее слово, а на весь текст до него:
- \(w_t\)
- token на позиции \(t\): его модель и угадывает
- \(w_1, \dots, w_{t-1}\)
- контекст: всё, что было раньше
- \(P\)
- вероятности, которые модель раздаёт всем словам словаря; в сумме 1
Запоминать такие длинные контексты в таблице невозможно. Уже для игрушечного словаря из 11 слов и контекста в три слова понадобилась бы \(11^3 = 1331\) строка, а в настоящем словаре десятки тысяч токенов. Поэтому таблицу заменяют сетью: она не хранит все контексты, а учит представление, по которому можно предсказывать и для контекстов, которых в данных не было.
Посмотри, откуда взялись ответы. Никто ничего не размечал: target для каждой позиции — следующее слово самого текста. Такое обучение называют self-supervised learning: метки есть, но их поставляют сами данные. Конспект (стр. 30) считает его разновидностью unsupervised learning: человек ничего не размечал. При этом функция ошибки у него та же, что у обычной classification. Вот вывод.
Функция ошибки для следующего слова
-
Чего мы хотим от модели с параметрами \(\theta\): чтобы настоящий текст \(w_1, \dots, w_T\) казался ей вероятным.
\[ P_\theta(w_1, \dots, w_T) \to \max \] -
Вероятность целого текста раскладывается в произведение по правилу умножения вероятностей (chain rule). Это тождество, приближений нет. Запись \(w_{\lt t}\) — сокращение для \(w_1, \dots, w_{t-1}\).
\[ P_\theta(w_1, \dots, w_T) = \prod_{t=1}^{T} P_\theta(w_t \mid w_{\lt t}) \] -
Произведение тысяч чисел меньше единицы неудобно, поэтому берём логарифм: произведение становится суммой. Тот же приём, что в maximum likelihood (урок 15).
\[ \ln P_\theta = \sum_{t=1}^{T} \ln P_\theta(w_t \mid w_{\lt t}) \] -
Максимизировать сумму — то же, что минимизировать её с обратным знаком. Получается error function:
\[ E(\theta) = -\sum_{t=1}^{T} \ln P_\theta(w_t \mid w_{\lt t}) \]Каждое слагаемое — тот самый loss из виджета: \(-\ln\) вероятности, которую модель дала настоящему следующему слову.
-
Узнай в слагаемом знакомую задачу. Пронумеруем позиции текста буквой \(n\), чтобы номер позиции \(t\) не путался с target \(t_n\). Вход \(x_n\) — контекст \(w_{\lt t}\). Target \(t_n\) — следующее слово, записанное как one-hot вектор. Классов \(K\) столько, сколько слов в словаре. Выход сети \(g(x_n \mid \theta)\) — softmax по словарю.
\[ E(\theta) = -\sum_{n} t_n\T \ln g(x_n \mid \theta) \]Это cross-entropy для многоклассовой classification из урока 11.
Итог: обучение LLM — это classification, повторённая на каждой позиции текста. Тот же softmax, та же cross-entropy, тот же backpropagation. Меняется масштаб: по словам конспекта (стр. 31), сотни миллиардов параметров и триллионы слов.
Чем LLM отличаются от прежних сетей. Раньше под каждый тип данных строили свою архитектуру. Механизм attention позволяет каждому токену напрямую учитывать все токены контекста, а не только соседние. Одну обученную модель потом донастраивают под перевод, пересказ или код. Отсюда название foundation models. Способности, которые проявляются только на таком масштабе (связный текст, перевод, арифметика), конспект называет emergent behaviors. Способ обучения при этом прежний: предсказание по закономерностям в данных. Есть ли за этим «понимание» — вопрос открытый. Конспект отвечает «нет» (стр. 31), и это мнение, а не измеренный факт.
Разгадка и карта курса
Вернёмся к загадке из начала урока. Чего не хватало с 1986 года? Ответ в одну строку:
Deep learning взлетел в 2012 году, когда к старому чертежу (backpropagation, convolutional networks) добавились большие размеченные данные, GPU и несколько новых деталей (ReLU, dropout).
А почему хватило двух видеокарт из магазина? Потому что железо оказалось самым дешёвым из трёх ингредиентов. Видеокарта делает параллельно те самые однотипные умножения, из которых состоит обучение сети, и купить её можно было в магазине. Миллионы размеченных картинок купить было нельзя: ImageNet почти два года размечали вручную 49 тысяч человек. С этим согласуется и выбор профессора: слово «data» у него первое.
Итог главы 1
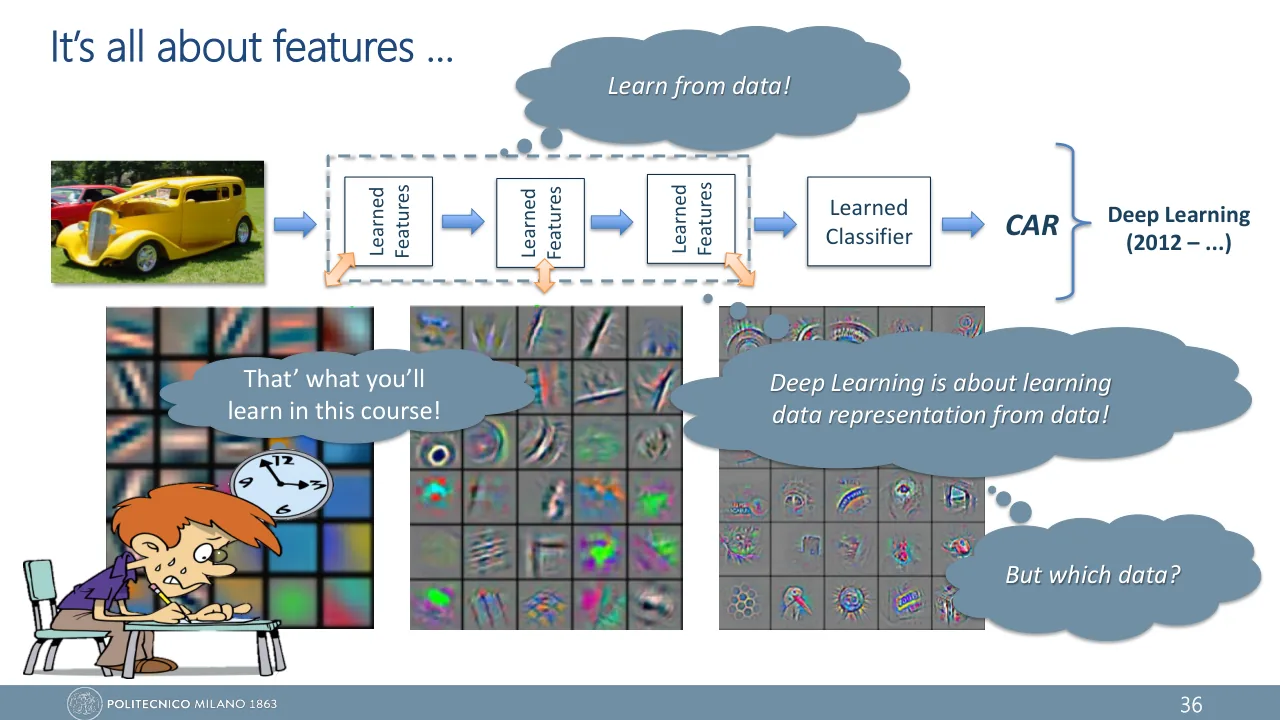
Вся первая глава — про одну мысль: качество машинного обучения ограничено качеством представления данных. В классическом ML представление придумывает человек (hand-crafted features). В deep learning его учит сама сеть, слой за слоем и вместе с классификатором. Формула профессора: Deep Learning is about learning data representation from data. На слайде 36 лекции 1 такой конвейер из выученных признаков и выученного классификатора подписан «Deep Learning (2012 – ...)»: тот самый год из названия урока.
Deep learning — не конкретная архитектура (CNN, RNN, Transformer) и не отдельный алгоритм. Это подход с четырьмя приметами:
- вход — сырые данные: пиксели, звук, текст;
- модель — много нелинейных слоёв, каждый учит своё представление;
- выход — нужный ответ;
- обучение — end-to-end: все слои настраиваются вместе, одной функцией ошибки.
«Deep learning — четвёртая парадигма обучения». Нет. Парадигм три: supervised, unsupervised и reinforcement learning, а deep learning применяется внутри каждой. Конспект сам себе противоречит: на стр. 23 пишет, что это не новая парадигма, а на стр. 34 называет его «the paradigm where…». Читай второе как «подход». И стрелку «Success of ML ⇒ Success of its feature representation» со стр. 34 читай не как «успех ML приводит к хорошему представлению», а как «успех ML требует хорошего представления»: оно — необходимое условие успеха, а не его следствие.
But which data?
Последний слайд лекции спрашивает: какие именно данные? И сам отвечает: этому и учит курс. У каждого типа данных своя структура: в картинке важны соседние пиксели, в тексте — порядок слов. Архитектура сети заранее «зашивает» такое предположение, поэтому под разные данные строят разные сети.
| Данные | Архитектура | Где в курсе |
|---|---|---|
| Таблицы, числовые признаки | Perceptron, Feed Forward Neural Networks | эта тетрадь, модули 2 и 3 |
| Изображения | Convolutional Neural Networks (CNN) | вторая половина курса, проф. Boracchi |
| Последовательности: текст, временные ряды | Recurrent Neural Networks, LSTM, Transformer | лекции проф. Matteucci после глав 1–3 |
| Данные без меток | Autoencoders, word embeddings | там же |
Модуль 1 закончен. Теперь известно, что такое deep learning и почему он заработал. Осталось самое интересное: как. Модуль 2 начинает с самой маленькой детали чертежа — одного нейрона.
В формате экзамена
Artificial neurons date back to the 1940s and backpropagation to 1986. Explain why deep learning took off only around 2012. Support your answer with the facts of the ImageNet 2012 result.
Show model answer
The core algorithms existed, but two ingredients were missing. (1) Data: deep networks have millions of parameters and need very large labelled datasets; these became available with the Internet and ImageNet (ILSVRC-2012: 1.2M labelled images, 1000 classes). This is the main point of the slides: it is all about (big) data. (2) Computational power: GPUs made it feasible to train such networks in days. In addition, a few algorithmic improvements (ReLU, dropout, data augmentation) completed the picture.
Evidence: AlexNet (Krizhevsky, Sutskever, Hinton, 2012), 8 learned layers and about 60M parameters, trained for 5–6 days on two GPUs, reached 15.3% top-5 error on ILSVRC-2012 against 26.2% for the second-best entry, which used hand-crafted features.
В полном ответе три вещи: названы данные (и названы первыми, как на слайде 29 лекции 1), названы вычисления, и есть хотя бы один факт про AlexNet с правильным словом «top-5». Ответ «появились GPU» без данных неполон: на слайде главным ингредиентом названы именно данные.
A classifier is tested on 10 images. For each image, the rank of the true class in the list of classes sorted by decreasing predicted probability is: 5, 1, 1, 3, 1, 1, 1, 2, 7, 12. Compute the top-5 error (in %).
Show model answer
An image is a top-5 error only if the rank of its true class is greater than 5. This happens for ranks 7 and 12.
\[ \mathrm{err}_5 = \frac{2}{10} = 20\,\% \]For comparison, the top-1 error counts every rank greater than 1: \(5/10 = 50\,\%\).
Ловушка — посчитать «не первые места» (5 из 10) и ответить 50. Картинка с рангом 5 в top-5 засчитывается: окно включает пятое место.
Which statements about the top-5 error of a 1000-class classifier are correct? Select all that apply.
Show model answer
Correct: the definition, the inequality top-5 error ≤ top-1 error, and the random baseline \(1 - 5/1000 = 99.5\,\%\). A top-5 error says nothing exact about the first guess, and it does not constrain the number of outputs.
Случайный уровень полезно уметь считать: он показывает, что 15.3 % на 1000 классах — это очень далеко от угадывания.
Give a one-sentence definition of deep learning and describe three situations in which you would not use it. Justify each.
Show model answer
Deep learning is about learning data representation from data: a hierarchy of features and the final classifier are learned jointly, end-to-end, from raw inputs, instead of hand-crafting the features.
I would not use it (i) with little data, e.g. a few hundred samples: a model with millions of parameters overfits; (ii) on tabular data whose columns are already meaningful features, where tree ensembles or linear models perform as well or better and train on a laptop; (iii) when each decision must be explained (medicine, finance, law), because deep networks are hard to interpret. A limited computational budget is a fourth reason.
В вопросе стоит «justify each»: нужен не список, а обоснование каждого пункта. «Мало данных» без слова overfitting и «таблицы» без «признаки уже готовы» выглядят заученными.
Large Language Models such as ChatGPT are pre-trained to predict the next token. (a) Write the quantity the model estimates and the error function minimised on a text \(w_1, \dots, w_T\). (b) Why is this called self-supervised learning? (c) Why are LLMs still deep learning?
Show model answer
(a) The model estimates \(P(w_t \mid w_1, \dots, w_{t-1})\). Training minimises the negative log-likelihood of the text, i.e. a cross-entropy over the vocabulary at every position:
\[ E(\theta) = -\sum_{t=1}^{T} \ln P_\theta(w_t \mid w_1, \dots, w_{t-1}) \](b) The target at each position is the next token of the text itself, so no human labelling is needed: the supervision comes from the data.
(c) They are deep neural networks (Transformers) that learn the representation (embeddings refined by many layers) and the final classifier (the next-token predictor) jointly from raw text, with no hand-crafted linguistic features.
В пункте (c) нужна связка с определением: learned features плюс learned classifier из сырых данных. Просто «потому что там нейросеть» — неполный ответ. Тема LLM есть только в конспекте, на слайдах лекции её нет.
A bigram model is estimated by counting on a small corpus. The word "the" is followed by "network" 3 times, by "classifier" 2 times and by "features" once. Compute the loss \(-\ln P(\text{features} \mid \text{the})\).
Show model answer
Две типичные ошибки: поделить на 3 (число разных продолжений) вместо 6 (число случаев) и взять десятичный логарифм вместо натурального.
Проверь себя
У сети на тестовом наборе top-5 error равен 15.3 %. Что можно утверждать про её top-1 error?
Что из перечисленного уже существовало до победы AlexNet в 2012 году?
Картинка для памяти: шкала из первого виджета. Всё, что правее 2012 года, — следствия, а не причины.
Сеть AlexNet и видеокарты оставили прежними, но для обучения дали 10 000 картинок вместо 1.2 млн. Что произойдёт вероятнее всего?
Есть таблица: 300 строк, в каждой показания датчиков станка и отметка, сломался ли он. Что разумнее попробовать первым?
Почему обучение предсказанию следующего слова называют self-supervised?
В тексте после слова X идёт A три раза и B один раз. Модель обучена подсчётом. Какой loss она получит на примере «после X идёт B»?
Какие утверждения о deep learning верны?
Унести с собой
- В 2012 году сошлись три ингредиента: данные (ImageNet, 1.2 млн размеченных картинок), вычисления (GPU) и доработанные алгоритмы (ReLU и dropout поверх backpropagation и CNN). На слайде профессора главный из них — данные.
- AlexNet: 8 обучаемых слоёв, около 60 млн параметров, две GPU, 5–6 дней. Top-5 error 15.3 % против 26.2 %: ошибок меньше на 41.6 %.
- Top-k error — доля примеров, у которых правильного класса нет среди \(k\) самых вероятных. Top-5 error никогда не больше top-1 error.
- Deep learning не нужен, когда примеров сотни, когда данные — таблица с готовыми признаками, когда решение надо объяснять или когда нет вычислительного бюджета.
- LLM — это deep learning: Transformer, выученные embeddings и классификатор следующего токена. Обучение self-supervised, функция ошибки — cross-entropy по словарю.
- Deep learning — не архитектура и не четвёртая парадигма, а подход: сырые данные, много нелинейных слоёв, обучение end-to-end. Архитектуру выбирают по типу данных.
Что посмотреть и почитать
-
The moment we stopped understanding AI [AlexNet]
Welch Labs, 2024
Экскурсия внутрь AlexNet: фильтры первого слоя, похожие на детекторы краёв, и более глубокие слои, которые откликаются на лица, хотя метки «лицо» в данных не было. Хорошо связывает прошлый урок с этим.
-
Large Language Models explained briefly
3Blue1Brown, 20247–8 мин
Формула \(P(w_t \mid w_1, \dots, w_{t-1})\) в картинках: LLM как функция, которая выдаёт вероятность каждого следующего слова. Смотри перед разделом про ChatGPT.
-
Transformer Explainer
Georgia Tech Polo Club
Настоящий GPT-2 small прямо в браузере. Набери начало фразы и посмотри на столбики вероятностей следующего токена: это взрослая версия виджета с bigram. Внутренности пока не разбирай, хватит верхнего уровня.
-
ImageNet Classification with Deep Convolutional Neural Networks
Krizhevsky, Sutskever, Hinton, NIPS 2012
Первоисточник всех цифр этого урока и той самой схемы архитектуры со слайда 30 лекции 1. Учти: в аннотации на странице стоят результаты ILSVRC-2010, они отличаются от конкурсных 15.3 % — не смешивай.
-
Why do tree-based models still outperform deep learning on tabular data?
Grinsztajn, Oyallon, Varoquaux, NeurIPS 2022
Доказательная база для пункта «таблицы». Достаточно аннотации, первого рисунка и выводов: 45 наборов данных, деревья впереди.