Фрэнк Розенблатт предложил перцептрон в 1957 году. В машине Mark I Perceptron каждый настраиваемый вес был потенциометром — той самой ручкой диммера, — и во время обучения ручки поворачивали электромоторы. Плавными были веса, но не выход: нейрон отвечал щелчком. Чтобы учить сети из нескольких слоёв, плавным пришлось сделать и его.
Диммеры вместо выключателей
После этого урока ты запишешь по памяти linear, sigmoid и tanh вместе с производными, посчитаешь производную по одному только выходу нейрона и объяснишь, почему в глубокой сети сигнал об ошибке тает по дороге назад.
Две лампы. Одна на обычном выключателе: щёлк — горит, щёлк — нет. Вторая на диммере с круглой ручкой. Задание: с закрытыми глазами сделать свет чуть ярче, поворачивая ручку по миллиметру и каждый раз спрашивая «стало лучше?». С диммером каждый миллиметр даёт ответ. С выключателем ответ почти всегда один: «ничего не изменилось».
Перцептрон из уроков 6–8 был выключателем. Поэтому сеть из таких нейронов не могла понять, в какую сторону крутить свои веса. В этом уроке выключатель меняют на диммер, и диммеров будет два: sigmoid и tanh.
А вот загадка. Эти два диммера — одна и та же кривая: tanh получается из сигмоиды растяжением и сдвигом. Но пусти сигнал об ошибке назад через десять слоёв с единичными весами, и после десяти сигмоид от него в лучшем случае останется меньше одной миллионной, а после десяти tanh в лучшем случае дойдёт весь. Откуда у одной кривой разница в миллион раз? И почему tanh всё равно не спасает глубокие сети?
Выключатель молчит, диммер подсказывает
В уроке 9 нейроны собрались в сеть. Каждый нейрон делает два действия: считает взвешенную сумму входов, а потом пропускает её через функцию активации (activation function).
\[ a = \sum_{i=0}^{I} w_i x_i = \vb{w}\T\vb{x} \]
\[ h = g(a) \]
- \(a\)
- взвешенная сумма (net input, в конспекте ещё activation potential)
- \(w_0\)
- смещение (bias): вес при постоянном входе \(x_0 = 1\)
- \(g\)
- функция активации
- \(h\)
- выход нейрона; у скрытого нейрона номер \(j\) на слайдах это \(h_j\)
У перцептрона \(g\) была ступенькой (step function): 0, пока \(a \le 0\), и 1 после. Учить сеть мы будем градиентным спуском (уроки 13 и 14), а ему от каждого нейрона нужен ответ на один вопрос: если чуть-чуть изменить \(a\), насколько изменится выход? Это и есть производная \(g'(a)\).
До: выключатель (step)
После: диммер (sigmoid)
У ступеньки наклон равен нулю всюду, кроме самой точки скачка, а там производной нет вовсе. Нейрон-выключатель на вопрос «куда крутить?» всегда отвечает «всё равно». У плавной S-образной кривой наклон есть везде, и он тем больше, чем ближе нейрон к середине перехода.
Зачем сети этот наклон, видно из одной строки. Градиентный спуск сдвигает вес \(w_i\) пропорционально производной ошибки \(E\) по этому весу. Распишем её по правилу производной сложной функции (подробный вывод будет в уроке 14):
\[ \pd{E}{w_i} = \pd{E}{h} \cdot g'(a) \cdot x_i \]
- \(\pd{E}{h}\)
- насколько ошибка \(E\) зависит от выхода этого нейрона
- \(g'(a)\)
- насколько выход зависит от net input
- \(x_i\)
- насколько net input зависит от веса: это просто вход на этой связи
Средний множитель стоит в производной по каждому весу нейрона. Если \(g'(a) = 0\), произведение обнуляется, и вес не сдвинется, как бы велика ни была ошибка.
Функция активации обязана быть дифференцируемой: её производная — множитель, через который до весов доходит сигнал об ошибке.
«Ступенька не годится, потому что она линейная». Нет: ступенька нелинейна, и сеть из ступенчатых нейронов умеет XOR, если веса подобрать руками. Ей не хватает другого — производной, по которой веса подбираются автоматически. Нелинейность нужна сети для выразительности (урок 9), дифференцируемость — для обучения. Это два разных требования, и на экзамене их стоит называть по отдельности.
Три функции с одного слайда
На слайде 18 лекции 2 у профессора ровно три функции активации, и каждая записана сразу со своей производной. Сначала познакомимся с ними как с картинками, а производные выведем в следующем разделе.
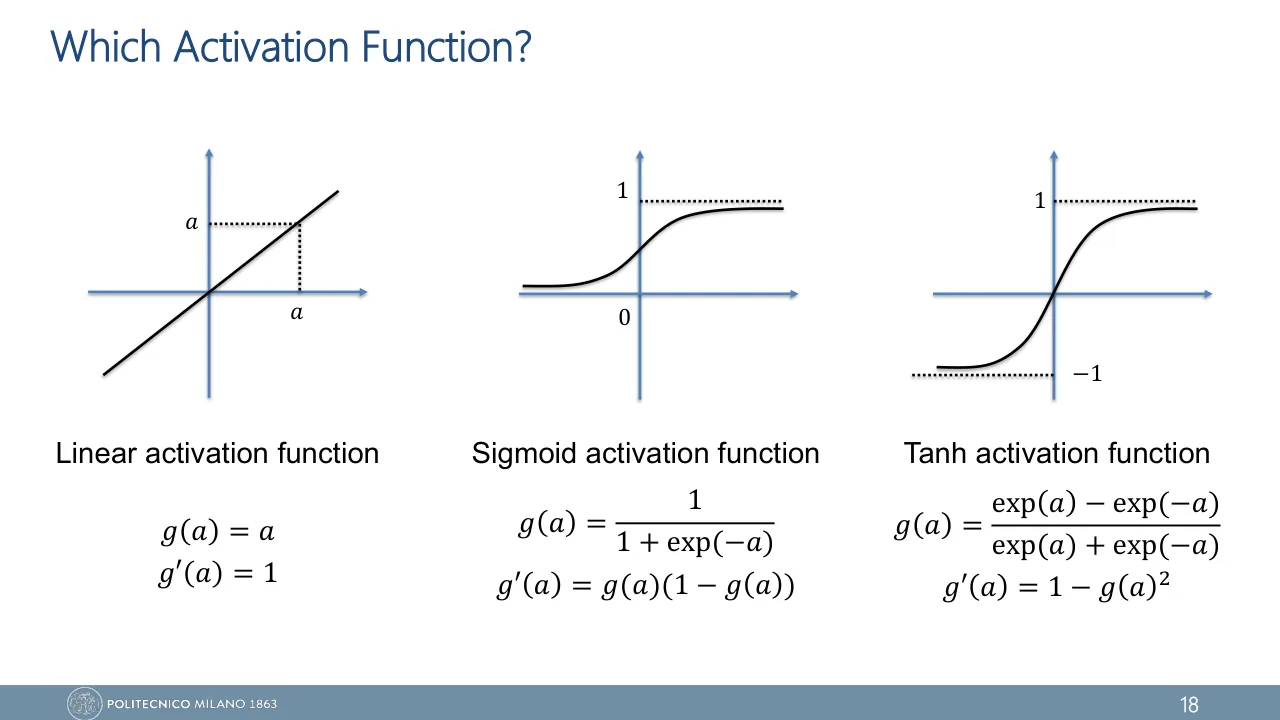
Linear: \(g(a) = a\). Выход равен net input, ничего не сжимается, диапазон — вся числовая прямая. В скрытых слоях такая функция бесполезна: сеть из линейных слоёв схлопывается в один слой (это показано в уроке 9). Зато она незаменима на выходе, когда сеть предсказывает число.
Sigmoid, она же логистическая функция, сжимает (squashes) любое число в интервал от 0 до 1. Большой положительный \(a\) даёт почти 1, большой отрицательный — почти 0, а при \(a = 0\) выходит ровно 0.5. Это ступенька со сглаженными углами: выход читается как «сила срабатывания» нейрона.
Tanh, гиперболический тангенс, имеет ту же S-образную форму, но живёт в интервале от −1 до 1 и проходит через ноль: \(\tanh(0) = 0\).
| Linear | Sigmoid | Tanh | |
|---|---|---|---|
| \(g(a)\) | \(a\) | \(\dfrac{1}{1 + e^{-a}}\) | \(\dfrac{e^{a} - e^{-a}}{e^{a} + e^{-a}}\) |
| Диапазон | \(\R\) | \((0, 1)\) | \((-1, 1)\) |
| \(g'(a)\) | \(1\) | \(g\,(1 - g)\) | \(1 - g^2\) |
| \(g(0)\) | 0 | 0.5 | 0 |
| \(g'(0)\) | 1 | 0.25 | 1 |
На слайдах все три функции называются \(g(a)\). Там, где их надо различать, в этом уроке сигмоида обозначена \(\sigma(a)\). Скобки у диапазонов круглые не случайно: сигмоида никогда не выдаёт ровно 0 или 1, tanh никогда не выдаёт ровно ±1. Они только подходят к этим значениям всё ближе.
У обеих S-образных функций в виджете видны узкая живая зона вокруг перехода и два плато по бокам. Состояние, когда нейрон стоит на плато, называется насыщением (saturation).
Насыщение (saturation) — состояние нейрона, при котором \(\abs{a}\) настолько велик, что выход почти достиг границы диапазона, а производная \(g'(a)\) почти равна нулю. Выход перестаёт реагировать на изменения \(a\).
«Насыщенный нейрон — значит ошибающийся». Нет. Он может быть совершенно прав: уверенное «да» и есть выход около 1. Плохо другое: если он не прав, исправить его почти невозможно, потому что сигнал об ошибке умножается на \(g'(a) \approx 0\).
У живой зоны есть и своя особенность. Совсем рядом с \(a = 0\) обе кривые почти прямые: касательная в виджете там сливается с кривой. Для малых \(\abs{a}\)
\[ \sigma(a) \approx 0.5 + \frac{a}{4}, \quad \tanh(a) \approx a \]Коэффициенты при \(a\) — это наклоны в центре из таблицы: 0.25 и 1. Нейрон с маленькими весами работает на этом прямом участке и ведёт себя почти как линейный; гнуться его кривая начинает, когда веса вырастают. К этому наблюдению вернётся урок 20.
Производная из собственного выхода
На слайде 18 лекции 2 производные записаны не через \(a\), а через сам выход \(g(a)\). Это не украшение. После прямого прохода выход каждого нейрона уже посчитан и лежит в памяти, и производная получается из него одним умножением, без новых экспонент. Выведем обе формулы: на экзамене вывод могут попросить целиком.
Sigmoid: \(\sigma' = \sigma\,(1 - \sigma)\)
-
Запишем сигмоиду как степень, чтобы применить правило производной сложной функции:
\[ \sigma(a) = \left(1 + e^{-a}\right)^{-1} \] -
Степень \(-1\) даёт множитель \(-(\dots)^{-2}\), внутренняя функция \(1 + e^{-a}\) даёт \(-e^{-a}\). Два минуса гасят друг друга:
\[ \sigma'(a) = \frac{e^{-a}}{\left(1 + e^{-a}\right)^{2}} \] -
Разобьём дробь на произведение двух дробей с одним и тем же знаменателем:
\[ \sigma'(a) = \frac{1}{1 + e^{-a}} \cdot \frac{e^{-a}}{1 + e^{-a}} \] -
Первая дробь — это сама \(\sigma(a)\). Во второй прибавим и вычтем единицу в числителе:
\[ \frac{e^{-a}}{1 + e^{-a}} = \frac{\left(1 + e^{-a}\right) - 1}{1 + e^{-a}} \] \[ = 1 - \sigma(a) \] -
Собираем. Экспонент в ответе не осталось, только выход:
\[ \sigma'(a) = \sigma(a)\,\bigl(1 - \sigma(a)\bigr) \] -
Где максимум? Обозначим \(p = \sigma(a)\), это число между 0 и 1. Функция \(p\,(1 - p)\) — парабола ветвями вниз с вершиной в \(p = 0.5\), а \(\sigma(a) = 0.5\) ровно при \(a = 0\):
\[ \max_a \sigma'(a) = 0.5 \cdot 0.5 = 0.25 \]
Проверка числом: \(\sigma(1) = 0.731\), значит \(\sigma'(1) = 0.731 \cdot 0.269 = 0.197\).
Tanh: \(\tanh' = 1 - \tanh^2\)
-
Назовём числитель и знаменатель отдельными буквами:
\[ \tanh(a) = \frac{u}{v} \] \[ u = e^{a} - e^{-a}, \quad v = e^{a} + e^{-a} \] -
При дифференцировании они меняются местами, потому что \(\left(e^{-a}\right)' = -e^{-a}\):
\[ u' = e^{a} + e^{-a} = v \] \[ v' = e^{a} - e^{-a} = u \] -
Применим правило производной частного и подставим \(u' = v\), \(v' = u\):
\[ \tanh'(a) = \frac{u'v - uv'}{v^2} = \frac{v^2 - u^2}{v^2} \] -
Поделим почленно. Снова остался только выход:
\[ \tanh'(a) = 1 - \left(\frac{u}{v}\right)^{2} \] \[ = 1 - \tanh^2(a) \]Максимум там, где \(\tanh(a) = 0\), то есть при \(a = 0\): \(\tanh'(0) = 1\).
Проверка числом: \(\tanh(1) = 0.7616\), значит \(\tanh'(1) = 1 - 0.58 = 0.42\).
У сигмоиды и tanh производная считается из собственного выхода: \(g\,(1 - g)\) и \(1 - g^2\).
На экзамене производную считают из выхода, и значение \(a\) для этого не нужно. Нейрон sigmoid выдал \(h = 0.8\): \(g' = 0.8 \cdot 0.2 = 0.16\). Нейрон tanh выдал \(h = 0.8\): \(g' = 1 - 0.64 = 0.36\).
| \(a\) | \(\sigma(a)\) | \(\sigma'(a)\) | \(\tanh(a)\) | \(\tanh'(a)\) |
|---|---|---|---|---|
| 0 | 0.5 | 0.25 | 0 | 1 |
| 1 | 0.731 | 0.197 | 0.762 | 0.420 |
| 2 | 0.881 | 0.105 | 0.964 | 0.071 |
| 3 | 0.953 | 0.045 | 0.995 | 0.0099 |
| 5 | 0.9933 | 0.0066 | 0.9999 | 0.00018 |
Сравни третью и пятую колонки. В центре производная tanh вчетверо больше. Но уже при \(a = 2\) она меньше, чем у сигмоиды, а при \(a = 5\) меньше в 37 раз. Запомни этот перекрёсток: он — половина разгадки.
Tanh — та же сигмоида в другом масштабе
Конспект называет tanh «a scaled version of the sigmoid», но не говорит, как именно она масштабирована. Точная связь умещается в одну строку и объясняет всё, чем tanh отличается от сигмоиды.
\[ \tanh(a) = 2\,\sigma(2a) - 1 \]
Читается это как три действия с графиком сигмоиды: сжать вдвое по горизонтали (\(2a\) внутри), растянуть вдвое по вертикали (двойка снаружи) и опустить на единицу.
До: \(\sigma(a)\)
После: \(2\,\sigma(2a) - 1 = \tanh(a)\)
-
Начнём с правой части и подставим определение сигмоиды в точке \(2a\):
\[ 2\,\sigma(2a) - 1 = \frac{2}{1 + e^{-2a}} - 1 \] -
Приведём к общему знаменателю:
\[ \frac{2 - \left(1 + e^{-2a}\right)}{1 + e^{-2a}} = \frac{1 - e^{-2a}}{1 + e^{-2a}} \] -
Умножим числитель и знаменатель на \(e^{a}\). Получилось определение tanh:
\[ \frac{e^{a} - e^{-a}}{e^{a} + e^{-a}} = \tanh(a) \] -
Теперь продифференцируем обе части равенства \(\tanh(a) = 2\,\sigma(2a) - 1\). Двойка снаружи и двойка изнутри вместе дают четвёрку:
\[ \tanh'(a) = 4\,\sigma'(2a) \]
Последняя строка — ключ к загадке. Колокол производной tanh — это колокол сигмоиды, вытянутый вверх вчетверо и сжатый по горизонтали вдвое. Отсюда сразу два факта. В центре \(\tanh'(0) = 4 \cdot 0.25 = 1\). А по горизонтали у tanh всё происходит вдвое быстрее: к \(a = 2\) она прошла 98 % своего диапазона, а сигмоида доходит до той же доли только к \(a = 4\).
Что даёт центр в нуле
Выходы сигмоиды всегда положительны. Выходы tanh бывают обоих знаков, и если net input распределён вокруг нуля, то и выходы в среднем лежат около нуля. Про такую функцию говорят zero-centred — «с центром в нуле» (в конспекте американское написание, zero-centered). Почему это важно для обучения?
Вернёмся к формуле из первого раздела. Для одного нейрона и одного обучающего примера два первых множителя можно собрать в одно число \(\delta\) (в уроке 14 оно получит имя error signal):
\[ \pd{E}{w_i} = \delta \cdot x_i \]
\[ \delta = \pd{E}{h} \cdot g'(a) \]
Число \(\delta\) у всех весов этого нейрона общее. Производные различаются только множителем \(x_i\), а это выход нейрона из предыдущего слоя. Если предыдущий слой состоит из сигмоид, все \(x_i \gt 0\), и у всех производных один знак — знак \(\delta\). Градиентный спуск сдвигает каждый вес против его производной, поэтому за один шаг все веса нейрона либо вместе растут, либо вместе убывают.
А если один вес нужно увеличить, а другой уменьшить? Напрямик нельзя, приходится идти зигзагом. С tanh входы бывают обоих знаков, и шаг может смотреть в любую сторону.
До: все входы положительны (sigmoid)
После: входы обоих знаков (tanh)
Знакомый приём из Applied Statistics — z-стандартизация признаков: вычесть среднее и поделить на стандартное отклонение. Входы сети перед обучением центрируют так же, и довод тот же, что на рис. 3: если все числа на входе нейрона одного знака, его веса могут двигаться только вместе. Tanh продолжает эту работу внутри сети: каждый следующий слой снова получает числа обоих знаков. Поэтому конспект на стр. 69 советует tanh для скрытых слоёв прежде всего тогда, когда входные данные нормализованы к нулевому среднему.
Сам довод со знаками взят из статьи Лекуна с соавторами «Efficient BackProp» (1998); конспект пересказывает его в рамке на той же странице.
Шёпот назад: первый взгляд на vanishing gradient
Теперь выстроим нейроны в цепочку, по одному на слой. Ошибка считается на выходе сети, а поправки нужны всем слоям, включая самые первые. Сигнал об ошибке идёт назад слой за слоем и в каждом нейроне умножается на его \(g'(a)\). Ещё он умножается на вес связи, но веса пока будем считать равными 1, чтобы следить только за функцией активации.
Это игра в «испорченный телефон», только назад: каждый передаёт соседу то, что услышал, но тише.
У сигмоиды \(g'(a) \le 0.25\). Значит, после \(L\) слоёв от сигнала остаётся не больше \(0.25^L\), и это лучший случай, когда каждый нейрон стоит точно в середине перехода:
\[ 0.25^{2} = 0.0625, \quad 0.25^{5} \approx 0.001 \] \[ 0.25^{10} \approx 9.5 \cdot 10^{-7} \]Vanishing gradient (затухающий градиент) — явление в глубоких сетях: градиент ошибки по весам первых слоёв получается произведением многих множителей меньше единицы и становится таким маленьким, что эти слои почти перестают учиться.
На стр. 70 конспект пишет, что tanh страдает от затухания «for very large or very small input values». Под very small там имеются в виду очень отрицательные числа, а не близкие к нулю: возле нуля производная как раз наибольшая, \(\tanh'(0) = 1\). На экзамене пиши однозначно: for inputs of large magnitude или \(\abs{a} \gg 0\).
«Градиент затухает только из-за насыщения». Не только. Даже если ни один сигмоидный нейрон не насыщен, каждый слой умножает сигнал самое большее на 0.25, и глубина съедает его сама. Насыщение делает то же самое ещё быстрее.
Глубина превращает множитель одного слоя в степень: десять сигмоид подряд — это уже меньше одной миллионной сигнала.
А если веса больше единицы — они не вернут сигнал?
Могут. Настоящий множитель слоя равен \(w \cdot g'(a)\), и при \(\abs{w} \gt 4\) сигмоидный слой в точке \(a = 0\) сигнал даже усиливает. Но большие веса дают большие \(\abs{a}\) и загоняют нейрон на плато, где \(g'(a)\) почти ноль: первый виджет, второй опыт. А если произведение всё же окажется больше единицы во многих слоях подряд, сигнал начнёт расти без меры. Обе беды и равновесие между ними разобраны в уроке 24.
У linear производная равна 1. Почему не поставить её во все скрытые слои?
Сигнал назад действительно пройдёт без потерь: каждый слой умножит его на \(g'(a) = 1\). Но сеть из линейных слоёв — это один линейный слой, сколько их ни складывай (урок 9), и учить в ней нечего, кроме прямой. Нужна функция, которая нелинейна и при этом не глушит сигнал. Сигмоида и tanh выполняют первое условие и проваливают второе; функцию, которая выполняет оба, покажет урок 24.
Здесь это только первый взгляд. Полная история — с ролью весов, взрывающимися градиентами и лекарством по имени ReLU — ждёт в уроке 24.
Разгадка: откуда миллион и что выбирать
Вернёмся к загадке из начала урока. В ней было два вопроса.
Откуда разница в миллион раз. Tanh и сигмоида — одна кривая, но их производные связаны как \(\tanh'(a) = 4\,\sigma'(2a)\). В лучшей точке \(a = 0\) слой tanh пропускает назад в 4 раза больше сигнала, чем слой сигмоид. Десять слоёв подряд дают \(4^{10} = 1\,048\,576\). Миллион возник не из новой формы кривой, а из четвёрки, возведённой в степень глубины.
Почему tanh всё равно не спасает. Потому что множитель 1 достигается в одной-единственной точке. Стоит нейронам отойти от \(a = 0\), и каждый слой снова умножает сигнал на число меньше единицы. А при \(\abs{a} \gt 1.66\) tanh пропускает даже меньше сигмоиды: его колокол вчетверо выше, но вдвое уже.
Итог честный: tanh смягчает затухание, но не отменяет его. Отменить его можно, только сменив саму форму функции, и этим займётся урок 24. А пока — обе функции рядом, как их спрашивают на экзамене.
Диапазон (0, 1), выход всегда положителен.
\(g' = g\,(1 - g)\), не больше 0.25.
Выход читается как вероятность: хороша для выходного нейрона.
Не zero-centred: поправки к весам следующего нейрона одного знака.
Диапазон (−1, 1), нечётная функция.
\(g' = 1 - g^2\), не больше 1.
Zero-centred и с наклоном 1 в центре: обычно учится быстрее.
Насыщается вдвое раньше сигмоиды.
Общее у обеих: гладкие, ограниченные, требуют вычислить экспоненту и насыщаются при больших \(\abs{a}\).
Что куда ставить
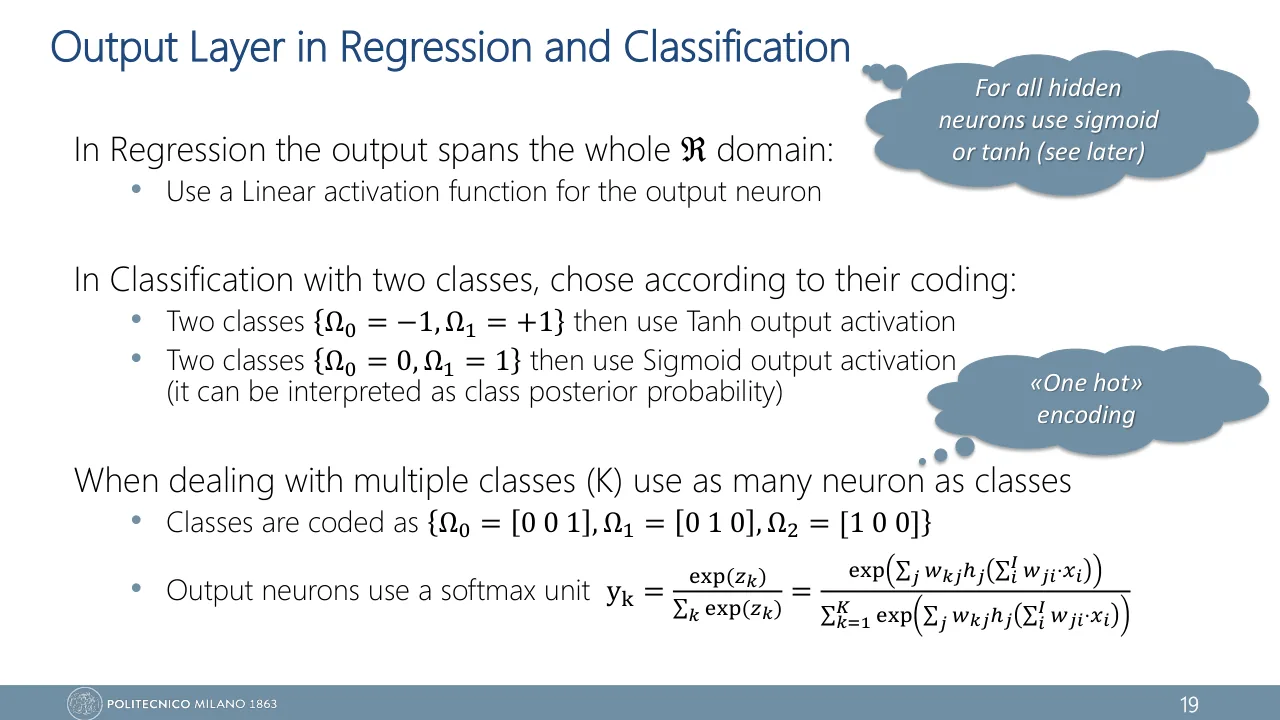
Слайд 19 лекции 2 отвечает на этот вопрос коротко. Скрытым нейронам — S-образная функция: «For all hidden neurons use sigmoid or tanh (see later)». Выходному нейрону — та, чей диапазон совпадает с тем, как закодированы targets \(t_n\).
| Где стоит нейрон | Функция | Почему |
|---|---|---|
| Скрытый слой | sigmoid или tanh | нелинейны и дифференцируемы; tanh обычно учится быстрее: центр в нуле и наклон 1 |
| Выход, regression | linear | ответ должен пробегать всю числовую прямую |
| Выход, два класса с кодами 0 и 1 | sigmoid | диапазон (0, 1); выход читается как class posterior probability |
| Выход, два класса с кодами −1 и +1 | tanh | диапазон (−1, 1) совпадает с кодировкой |
Приписка «see later» на слайде стоит не зря. Конспект на стр. 66 и 70 добавляет, что в глубоких сетях сигмоиду и tanh в скрытых слоях сегодня чаще заменяют функцией ReLU, как раз из-за насыщения. Она появится в уроке 24; на выходе сети sigmoid при этом остаётся.
Про выходной слой, включая случай многих классов, — весь следующий урок.
В формате экзамена
Write the sigmoid activation function and derive its derivative as a function of its own output \(g(a)\). For which value of \(a\) is the derivative maximal, and what is the maximum?
Show model answer
\[ g(a) = \frac{1}{1 + e^{-a}} \]
\[ g'(a) = \frac{e^{-a}}{(1 + e^{-a})^{2}} = \frac{1}{1 + e^{-a}} \cdot \frac{e^{-a}}{1 + e^{-a}} \]
The first factor is \(g(a)\). The second one is
\[ \frac{e^{-a}}{1 + e^{-a}} = \frac{(1 + e^{-a}) - 1}{1 + e^{-a}} = 1 - g(a) \]Therefore \(g'(a) = g(a)\,(1 - g(a))\).
The product \(p\,(1 - p)\) with \(p = g(a) \in (0, 1)\) is maximal at \(p = 0.5\), i.e. at \(a = 0\), where \(g'(0) = 0.25\). For large \(\abs{a}\) the derivative tends to 0 (saturation).
Проверяют три вещи: саму формулу, промежуточный шаг с разбиением дроби (готовый результат со слайда 18 лекции 2 без вывода — неполный ответ) и максимум 0.25 при \(a = 0\). Слово saturation в конце — бесплатный плюс.
A hidden neuron with sigmoid activation has bias \(w_0 = -1\) and weights \(w_1 = 2\), \(w_2 = -1\). The input is \(\vb{x} = (1, -1)\). Compute the derivative \(g'(a)\) of the activation function at this input (three decimal places).
Show model answer
\[ a = -1 + 2 \cdot 1 + (-1) \cdot (-1) = 2 \]
\[ g(2) = \frac{1}{1 + e^{-2}} = \frac{1}{1.1353} = 0.881 \]
\[ g'(2) = 0.881 \cdot (1 - 0.881) = 0.105 \]
Три места, где теряют балл: забыть \(w_0\) в сумме, потерять знак в произведении \((-1) \cdot (-1)\) и остановиться на \(g(a)\), не дойдя до производной. Производную считай из выхода, второй раз экспонента не нужна.
An error signal is propagated backwards through a chain of 5 sigmoid neurons, one per layer. All connecting weights are equal to 1 and every neuron operates at \(a = 0\). By what factor is the signal multiplied in total? Give a decimal number or a fraction.
Show model answer
Each neuron multiplies the signal by \(g'(0) = 0.25\), so the total factor is
\[ 0.25^{5} = \frac{1}{1024} \approx 9.8 \cdot 10^{-4} \]This is the best case: for any \(a \ne 0\) every factor is smaller than 0.25.
Множители по слоям перемножаются, а не складываются: ответ \(5 \cdot 0.25\) — самая частая ошибка. Фраза про лучший случай показывает, что ты понимаешь 0.25 как верхнюю границу.
Which of the following statements about the sigmoid \(\sigma\) and tanh are true? Select all that apply.
Show model answer
True: the first, the second and the fifth statement. Tanh saturates as well (even sooner than the sigmoid), and its derivative exceeds the sigmoid's only in the central region \(\abs{a} \lt 1.66\).
Ловушка — третий вариант: он вырастает из неверной причины в конспекте на стр. 67. В вопросах «select all» каждое утверждение проверяй отдельно, числом или формулой.
Compare the sigmoid and tanh as activation functions for hidden neurons. Why is tanh usually preferred? Does it solve the vanishing gradient problem?
Show model answer
Sigmoid: range \((0, 1)\), \(g' = g\,(1 - g) \le 0.25\), outputs always positive. Tanh: range \((-1, 1)\), \(g' = 1 - g^2 \le 1\), an odd function with zero-centred outputs. They are the same curve up to scaling: \(\tanh(a) = 2\,\sigma(2a) - 1\).
Tanh is preferred for two reasons. (i) Its slope at the origin is 1, so a neuron working near \(a = 0\) does not attenuate the back-propagated signal, whereas a sigmoid multiplies it by at most 0.25. (ii) Its outputs have both signs. With sigmoid hidden units all inputs \(x_i\) of the next neuron are positive, so all components \(\partial E / \partial w_i = \delta\,x_i\) share the sign of \(\delta\): the weights of that neuron can only increase together or decrease together, which gives zig-zag, slow convergence.
It does not solve the vanishing gradient problem. Tanh also saturates for large \(\abs{a}\), even sooner than the sigmoid, and there \(g'(a) \approx 0\). The gradient of the early layers is a product of many such factors and still vanishes in deep networks.
Балл теряют на последнем вопросе: ответ «yes, because it is zero-centred» неверен. Нужны слова saturates и product of derivatives. Формула \(\partial E / \partial w_i = \delta\,x_i\) превращает довод про знаки из общих слов в аргумент.
A two-class problem has targets coded as \(t_n \in \{-1, +1\}\). According to the course slides, which activation function should the output neuron use?
Show model answer
Tanh: its range \((-1, 1)\) matches the coding \(\{\Omega_0 = -1, \Omega_1 = +1\}\). With the coding \(\{0, 1\}\) the answer would be the sigmoid, whose output can be interpreted as the class posterior probability.
Правило профессора: выходную функцию выбирают по кодировке классов. Вопрос часто задают в обе стороны, поэтому помни обе пары.
Проверь себя
Нейрон с sigmoid выдал \(h = 0.9\). Чему равна производная \(g'(a)\)?
У сигмоидного нейрона с одним входом вес \(w_1\) увеличили с 1 до 5, смещение \(w_0 = 0\). Что произошло с наибольшим значением \(g'(a)\) и с шириной зоны по \(x\), где нейрон чувствителен?
Что верно про насыщенный (saturated) нейрон?
Картинка для памяти: ручка диммера упёрлась в ограничитель. Крутить дальше можно, свет от этого не меняется.
Почему ступенчатую функцию нельзя оставить в скрытых слоях, если сеть учат градиентным спуском?
Все входы нейрона — выходы сигмоидных нейронов предыдущего слоя. Что можно сказать о производных \(\partial E / \partial w_i\) по его весам на одном обучающем примере?
Нейрон tanh при некотором \(a\) выдал 0.6. Что выдаст сигмоида в точке \(2a\)?
Унести с собой
- Функция активации должна быть дифференцируемой: \(g'(a)\) — множитель, через который до весов доходит сигнал об ошибке. У ступеньки он равен нулю, поэтому её заменили плавной кривой.
- На слайде 18 лекции 2 три функции: linear (\(g' = 1\), диапазон \(\R\)), sigmoid (диапазон (0, 1), \(g' = g(1 - g) \le 0.25\)) и tanh (диапазон (−1, 1), \(g' = 1 - g^2 \le 1\)). Производные считаются из уже известного выхода нейрона, без новых экспонент.
- Tanh — та же сигмоида: \(\tanh(a) = 2\sigma(2a) - 1\). Её производная вчетверо выше и вдвое уже: \(\tanh'(a) = 4\sigma'(2a)\).
- Tanh zero-centred: входы следующего слоя бывают обоих знаков, и поправки к весам нейрона не обязаны иметь один знак.
- Обе функции насыщаются. В глубокой сети сигнал назад — произведение \(g'(a)\) по слоям, у сигмоид не больше \(0.25^L\): это vanishing gradient. Tanh его смягчает, но не решает.
- Скрытым нейронам — sigmoid или tanh; выходному — функция, чей диапазон совпадает с кодировкой targets.
Что посмотреть и почитать
-
But what is a neural network?
3Blue1Brown18 мин
Картинка «нейрон — число от 0 до 1» и сигмоида как способ сжать взвешенную сумму в этот интервал. Хорошо ложится перед первым разделом.
-
A Neural Network Playground
Daniel Smilkov, Shan Carter
Возьми набор Circle, один скрытый слой и переключай Activation между Sigmoid и Tanh при одном и том же learning rate: видно, кто сходится быстрее. Потом поставь Linear и убедись, что слои перестали помогать.
-
Neural Networks Part 1: Setting up the Architecture
Stanford CS231n
Раздел про функции активации на двух экранах: сигмоида насыщается и не центрирована в нуле, tanh центрирована. То же, что в уроке, словами другого курса и с продолжением про ReLU.
-
Neural Networks and Deep Learning, chapter 1
Michael Nielsen
Раздел «Sigmoid neurons» подходит к первой половине урока с другой стороны: почему малое изменение веса должно давать малое изменение выхода и как сигмоида это обеспечивает. Сайт открывается только по http.