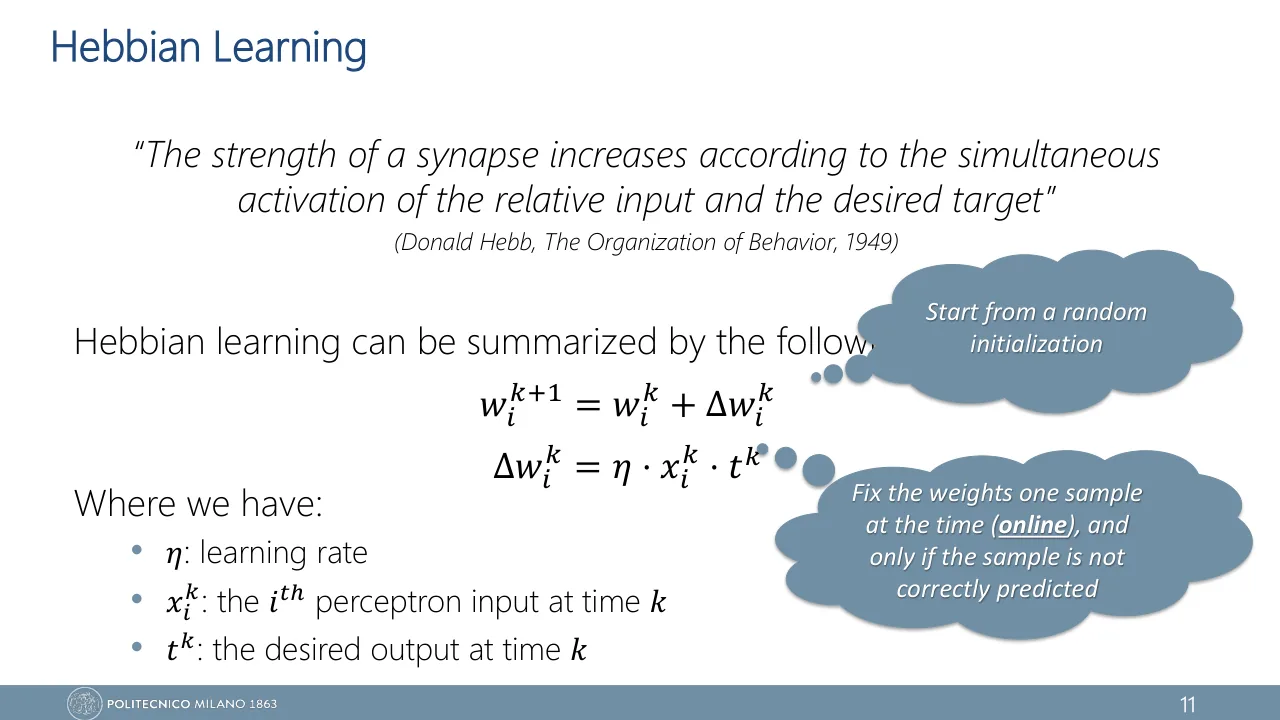
Хебб был психологом и свою идею сформулировал словами, без формулы. Знаменитый лозунг про нейроны, которые «fire together, wire together», в его книге не встречается: это более поздний пересказ. Есть и вторая тонкость. Формулой идею Хебба записывают так: \(\Delta w = \eta\, x\, y\), где \(y\) — собственный выход нейрона, а не цель. Учителя в ней нет, и условия «только на ошибке» тоже. Процедуру с целью \(t\) и этим условием в большинстве учебников называют perceptron learning rule. На экзамене называй её так, как на слайдах: Hebbian learning.
Учиться только на ошибках
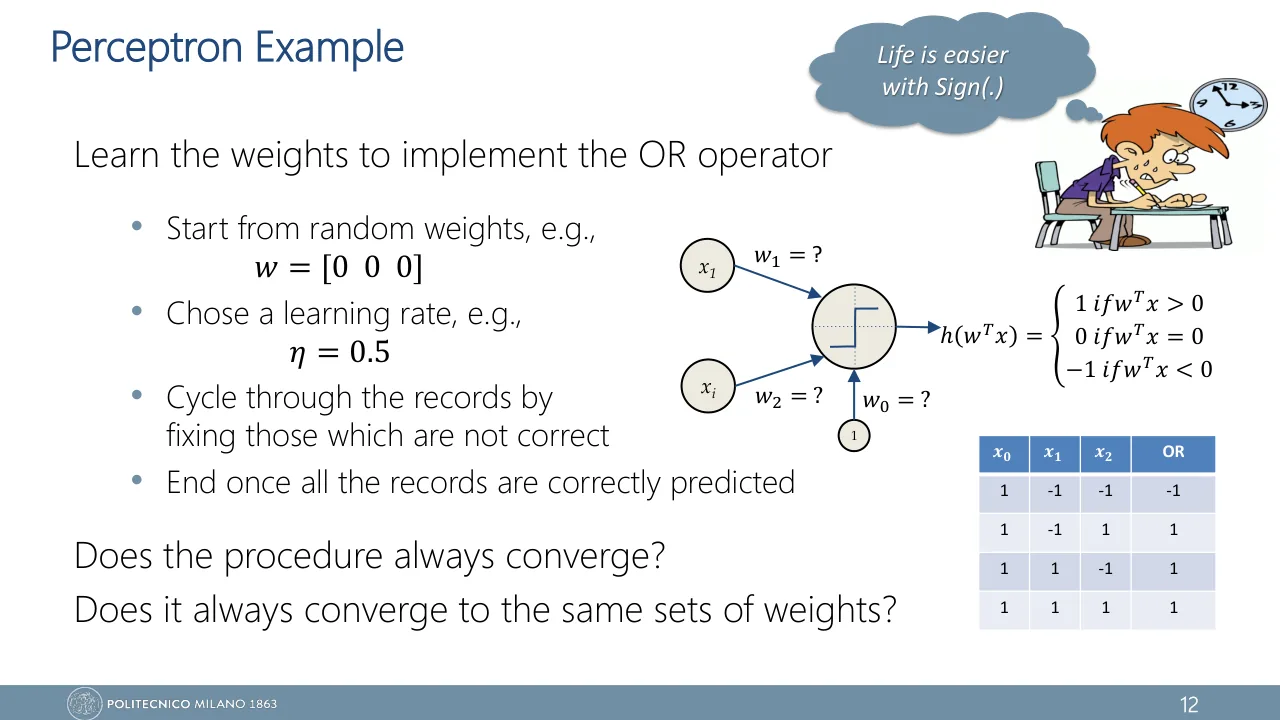
После этого урока ты руками проведёшь Hebbian learning для четырёх точек со слайда 12 лекции 2 и объяснишь, когда процедура остановится и почему итоговые веса у двух студентов могут не совпасть.
В машине Mark I — перцептроне Розенблатта, собранном в железе, — веса были не числами в памяти, а ручками потенциометров. Обучение выполняли электромоторы: они подкручивали ручки на небольшой угол. Каким должно быть итоговое положение каждой ручки, машине никто не сообщал.
Правило, которое решает, куда и насколько крутить, помещается в одну строчку. И срабатывает оно в единственном случае: когда машина ошиблась. На слайде 12 лекции 2 профессор просит выполнить его руками для четырёх точек и оставляет два вопроса без ответа. Всегда ли такая процедура остановится? И если остановится, то всегда ли на одних и тех же весах?
Запиши свои два «да» или «нет» сейчас. К концу урока проверишь их руками: в одной задаче ручки замрут после трёх поворотов, в другой будут ходить по кругу без конца.
Правило в одну строчку
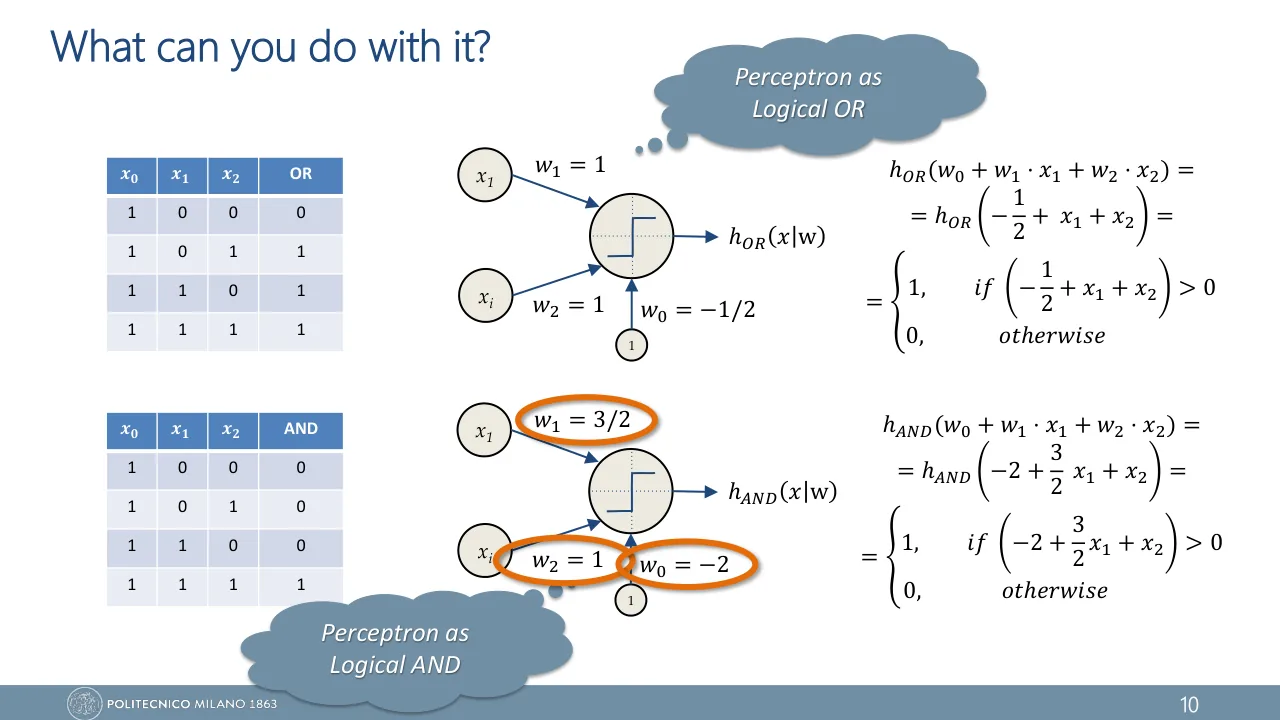
В прошлом уроке веса для OR и AND подбирались руками: четыре точки, одна прямая, три числа. Для ста входов прямую глазами не проведёшь. Нужна процедура, которая находит веса сама.
Идея пришла из психологии. В 1949 году Дональд Хебб в книге The Organization of Behavior предположил, что связь от нейрона A к нейрону B усиливается, когда A раз за разом участвует в возбуждении B. На слайде 11 лекции 2 эта мысль пересказана уже для перцептрона: синапс усиливается при одновременной активности входа и желаемого выхода, desired target. Запомни слово «желаемого»: вход сопоставляют не с тем, что нейрон ответил, а с тем, что он должен был ответить.
Сначала на людях
Представь совет из трёх человек с разным весом голоса: \(w_0\), \(w_1\), \(w_2\). Первый всегда голосует «за» (\(x_0 = 1\)). Двое других голосуют «за» (\(+1\)) или «против» (\(-1\)). Решение совета — знак взвешенной суммы голосов.
Совет ошибся: решил «за», а правильно было «против». Как поправить веса? Разумно так: кто голосовал так же, как правильный ответ, получает прибавку к весу, а кто голосовал наоборот, теряет столько же. Размер прибавки для всех один, назовём его \(\eta\).
«Голосовал так же, как правильный ответ» значит, что голос \(x_i\) и правильный ответ \(t\) одного знака: \(x_i \cdot t = +1\). «Наоборот» — это \(x_i \cdot t = -1\). Выходит, поправка к весу равна \(\eta \cdot x_i \cdot t\). Это и есть всё правило.
\[ w_i^{k+1} = w_i^{k} + \Delta w_i^{k} \]
\[ \Delta w_i^{k} = \eta \cdot x_i^{k} \cdot t^{k} \]
- \(w_i^{k}\)
- вес \(i\)-го входа перед шагом \(k\); индекс \(i\) идёт от 0 до \(I\)
- \(x_i^{k}\)
- \(i\)-й вход перцептрона на шаге \(k\); \(x_0 = 1\) всегда
- \(t^{k}\)
- target: желаемый выход для этого примера, \(+1\) или \(-1\)
- \(\eta\)
- learning rate: размер одной поправки, положительное число
Все веса сразу удобно записать одним вектором: \(\vb{w} \leftarrow \vb{w} + \eta\, t\, \vb{x}\). Стрелка читается «заменить на».
В самой формуле не видно двух условий, без которых она не работает. На слайде 11 они вынесены в облачка, а слайд 12 добавляет, когда пора закончить.
Hebbian learning в этом курсе — процедура обучения одного перцептрона из четырёх пунктов. Начать со случайных весов. Показывать примеры по одному — online. Менять веса по правилу \(\Delta w_i = \eta\, x_i\, t\) только если пример предсказан неверно. Ходить по примерам по кругу и закончить, когда все предсказаны верно.
Один полный проход по всем примерам называют эпохой (epoch). Значит, условие остановки звучит так: эпоха без единого исправления.
Отдельного правила для bias не нужно. Bias — это вес \(w_0\) при постоянном входе \(x_0 = 1\) (трюк из урока 5). Подставь \(x_0 = 1\) в правило, и получится \(\Delta w_0 = \eta \cdot t\). После ошибки bias растёт, если нужно было ответить \(+1\), и падает, если нужно было \(-1\).
Перцептрон учится только на ошибках: верно предсказанный пример не меняет ни одного веса.
«Веса обновляют после каждого примера». После каждого примера делают проверку. Обновление — только после ошибки. Если прибавлять \(\eta\, t\, \vb{x}\) всегда, веса будут расти и тогда, когда всё уже предсказано верно, и процедура никогда не закончится.
Почему цели — это −1 и +1
На слайде 10 лекции 2 входы и выходы были нулями и единицами. На слайде 12, где начинается обучение, таблица OR переписана через \(-1\) и \(+1\), а в облачке пометка: с функцией Sign жить проще. Вместе с кодировкой меняется и функция активации. Вместо ступеньки 0/1 теперь знак суммы с тремя значениями.
\[ h(\vb{w}\T\vb{x}) = \begin{cases} +1, & \vb{w}\T\vb{x} \gt 0 \\ \phantom{+}0, & \vb{w}\T\vb{x} = 0 \\ -1, & \vb{w}\T\vb{x} \lt 0 \end{cases} \]
Ноль на самой границе — честное «не знаю». Он не равен ни \(+1\), ни \(-1\), поэтому такой ответ всегда считается ошибкой.
Зачем понадобилась замена? Посмотри, что правило делает с весом при каждом сочетании знаков.
| вход \(x_i\) | цель \(t\) | \(x_i \cdot t\) | \(\Delta w_i\) | на языке совета |
|---|---|---|---|---|
| +1 | +1 | +1 | \(+\eta\) | голосовал «за», и надо было «за» |
| −1 | −1 | +1 | \(+\eta\) | голосовал «против», и надо было «против» |
| +1 | −1 | −1 | \(-\eta\) | голосовал «за», а надо было «против» |
| −1 | +1 | −1 | \(-\eta\) | голосовал «против», а надо было «за» |
Вход и цель совпали по знаку — связь усиливается. Разошлись — ослабевает. Все четыре строки что-то делают с весом.
Теперь те же строки с нулями. При цели \(t = 0\) поправка равна \(\eta \cdot x_i \cdot 0 = 0\) для любого входа. Правило молчит именно тогда, когда перцептрон ответил 1 вместо 0, то есть когда веса нужно уменьшить. С входами и целями 0/1 веса умеют только расти.
Проверка на AND в кодировке 0/1: старт с нулевых весов, \(\eta = 0.5\), выход 1 при \(a \gt 0\). Первые три записи имеют \(t = 0\) и выход 0 — верно. Четвёртая, \((1, 1)\) с \(t = 1\), даёт \(a = 0\) и выход 0: ошибка, веса становятся \((0.5,\ 0.5,\ 0.5)\). С ними перцептрон отвечает 1 на все четыре входа. Три ответа из четырёх неверны, но у всех трёх \(t = 0\), и поправка нулевая. Процедура застряла навсегда. В кодировке \(\pm 1\) та же задача решается за одно исправление: это видно в виджете ниже.
У кодировки \(\pm 1\) есть и второе удобство. Проверка «предсказано ли верно» записывается одним неравенством, где \(a = \vb{w}\T\vb{x}\) — взвешенная сумма:
\[ t \cdot a \gt 0 \]При \(t = +1\) оно требует \(a \gt 0\), при \(t = -1\) требует \(a \lt 0\). Это неравенство ещё пригодится, когда будем выяснять, почему исправление помогает.
А если на экзамене дадут таблицу в 0/1?
Сначала посмотри, не задана ли кодировка в условии. Если выбор за тобой, перекодируй таблицу в \(\pm 1\): нули во входах и целях замени на \(-1\), и правило со слайда заработает. Одной строкой напиши, что так сделано. Найденные веса относятся к входам \(\pm 1\); обратно в 0/1 они пересчитываются по последней строке шпаргалки в конце урока.
Второй путь — запись того же правила для целей 0/1: \(\Delta w_i = \eta\,(t - h)\,x_i\), где \(h\) — выход перцептрона. При верном ответе \(t - h = 0\), при ошибке \(t - h = \pm 1\), то есть ровно та «цель со знаком», которой не хватало. На слайдах 11–12 лекции 2 этой записи нет, но в учебниках она встречается часто.
Пример со слайда 12 лекции 2: OR за три исправления
Условие со слайда: научить перцептрон оператору OR. Старт \(\vb{w} = [0\ 0\ 0]\), то есть \(w_0 = w_1 = w_2 = 0\): слайд приводит нули как пример «случайных» начальных весов. Learning rate \(\eta = 0.5\). Обучающие примеры — четыре строки таблицы истинности; слайд называет их records, дальше это «записи». Идут они в порядке таблицы.
| запись | \(x_0\) | \(x_1\) | \(x_2\) | цель \(t\) |
|---|---|---|---|---|
| 1 | 1 | −1 | −1 | −1 |
| 2 | 1 | −1 | +1 | +1 |
| 3 | 1 | +1 | −1 | +1 |
| 4 | 1 | +1 | +1 | +1 |
На каждой записи три действия. Посчитать сумму \(a = \vb{w}\T\vb{x}\). Взять её знак. Сравнить с \(t\). Если не совпало, прибавить к весам \(\eta\, t\, \vb{x}\). Открывай шаги по одному и перед каждым прикидывай, будет ли исправление.
-
Запись 1: \(\vb{x} = (1, -1, -1)\), \(t = -1\). Веса нулевые, поэтому сумма тоже ноль:
\[ a = 0 \cdot 1 + 0 \cdot (-1) + 0 \cdot (-1) = 0 \]Sign(0) = 0, а нужно \(-1\). Ошибка. Прибавляем \(\eta\, t\, \vb{x} = 0.5 \cdot (-1) \cdot \vb{x}\):
\[ \Delta\vb{w} = (-0.5,\ +0.5,\ +0.5) \] \[ \vb{w} = (-0.5,\ 0.5,\ 0.5) \] -
Запись 2: \(\vb{x} = (1, -1, +1)\), \(t = +1\). Считаем с новыми весами:
\[ a = -0.5 - 0.5 + 0.5 = -0.5 \]Выход \(-1\), а нужно \(+1\). Ошибка. Прибавляем \(0.5 \cdot (+1) \cdot \vb{x}\):
\[ \Delta\vb{w} = (+0.5,\ -0.5,\ +0.5) \] \[ \vb{w} = (0,\ 0,\ 1) \] -
Запись 3: \(\vb{x} = (1, +1, -1)\), \(t = +1\). Работает только \(w_2 = 1\):
\[ a = 0 + 0 + 1 \cdot (-1) = -1 \]Выход \(-1\), а нужно \(+1\). Третья ошибка подряд:
\[ \Delta\vb{w} = (+0.5,\ +0.5,\ -0.5) \] \[ \vb{w} = (0.5,\ 0.5,\ 0.5) \] -
Запись 4: \(\vb{x} = (1, +1, +1)\), \(t = +1\).
\[ a = 0.5 + 0.5 + 0.5 = 1.5 \]Выход \(+1\) — верно. Веса не трогаем. Первая эпоха закончилась: три исправления.
-
Вторая эпоха. Останавливаться рано: исправления могли испортить прежние записи. Проверяем все четыре с весами \((0.5,\ 0.5,\ 0.5)\):
\[ a = -0.5,\quad 0.5,\quad 0.5,\quad 1.5 \]Выходы \(-1, +1, +1, +1\) совпали с целями. Эпоха без единого исправления — стоп.
За числами стоит простая геометрия. Тройка весов — это прямая \(w_0 + w_1 x_1 + w_2 x_2 = 0\) (урок 6), и каждое исправление её двигает. Вот что произошло на записи 2.
До: \(\vb{w} = (-0.5,\ 0.5,\ 0.5)\)
После: \(\vb{w} = (0,\ 0,\ 1)\)
На экзамене такой расчёт удобно вести таблицей: одна строка — одна запись, в каждой строке сумма считается с весами из предыдущей.
| эпоха | запись | \((x_0, x_1, x_2)\) | \(t\) | \(a = \vb{w}\T\vb{x}\) | выход | \(\Delta\vb{w} = \eta\, t\, \vb{x}\) | \(\vb{w}\) после |
|---|---|---|---|---|---|---|---|
| 1 | 1 | (1, −1, −1) | −1 | 0 | 0 | (−0.5, +0.5, +0.5) | (−0.5, 0.5, 0.5) |
| 1 | 2 | (1, −1, +1) | +1 | −0.5 | −1 | (+0.5, −0.5, +0.5) | (0, 0, 1) |
| 1 | 3 | (1, +1, −1) | +1 | −1 | −1 | (+0.5, +0.5, −0.5) | (0.5, 0.5, 0.5) |
| 1 | 4 | (1, +1, +1) | +1 | 1.5 | +1 | верно | (0.5, 0.5, 0.5) |
| 2 | 1 | (1, −1, −1) | −1 | −0.5 | −1 | верно | (0.5, 0.5, 0.5) |
| 2 | 2 | (1, −1, +1) | +1 | 0.5 | +1 | верно | (0.5, 0.5, 0.5) |
| 2 | 3 | (1, +1, −1) | +1 | 0.5 | +1 | верно | (0.5, 0.5, 0.5) |
| 2 | 4 | (1, +1, +1) | +1 | 1.5 | +1 | верно, стоп | (0.5, 0.5, 0.5) |
Итог: \(\vb{w} = (0.5,\ 0.5,\ 0.5)\). Граница \(0.5 + 0.5x_1 + 0.5x_2 = 0\), то есть \(x_2 = -x_1 - 1\). Она отрезает угол \((-1, -1)\) от трёх остальных, как и положено OR.
Теперь замкнём круг с прошлым уроком. Там OR был задан в кодировке 0/1 весами \(w_0 = -\tfrac{1}{2}\), \(w_1 = 1\), \(w_2 = 1\). Перейдём к тем же координатам подстановкой \(x = 2x' - 1\):
\[ \begin{aligned} &0.5 + 0.5\,(2x_1' - 1) + 0.5\,(2x_2' - 1) \\ &\qquad = -0.5 + x_1' + x_2' \end{aligned} \]Получились те самые веса со слайда 10 лекции 2. Процедура за три исправления нашла то, что раньше приходилось подбирать глазами.
Теперь по шагам, своими руками
В виджете та же процедура, запись за записью. Главное, что здесь нужно увидеть: веса меняются только на ошибке, и процедура сама замирает, как только прямая отделила точки. А если отделить нельзя, она ходит по кругу.
Тот же OR в конспекте: читаем с красной ручкой
В конспекте (стр. 49, Example 3) учат тот же OR, но в других условиях: входы и цели 0/1, bias выброшен «для простоты», \(\eta = 0.1\), старт \(w_1 = w_2 = 0\). Расчёт там верный, если читать его с одной поправкой: выход равен 1 только при \(a \gt 0\).
| запись \((x_1, x_2)\) | \(t\) | \(a\) | выход | \(\Delta\vb{w}\) | \(\vb{w}\) после |
|---|---|---|---|---|---|
| (0, 0) | 0 | 0 | 0 | верно | (0, 0) |
| (0, 1) | 1 | 0 | 0 | (0, +0.1) | (0, 0.1) |
| (1, 0) | 1 | 0 | 0 | (+0.1, 0) | (0.1, 0.1) |
| (1, 1) | 1 | 0.2 | 1 | верно | (0.1, 0.1) |
Вторая эпоха: \(a = 0,\ 0.1,\ 0.1,\ 0.2\), выходы 0, 1, 1, 1. Ошибок нет, процедура закончена. Два исправления, итог \((w_1, w_2) = (0.1,\ 0.1)\).
Почему пример вообще сработал с целями 0/1, хотя выше правило с ними ломалось? У OR единственная запись с \(t = 0\) — это \((0, 0)\), а там сумма без bias равна нулю при любых весах. Ложному срабатыванию негде случиться. С AND такой удачи нет.
И про выброшенный bias. Без него граница обязана проходить через начало координат: здесь это прямая \(x_1 + x_2 = 0\), и точка \((0, 0)\) лежит прямо на ней. Верный ответ для неё получается только за счёт договорённости «на границе выход 0». А AND в кодировке 0/1 без bias не решается вовсе: нужно \(w_1 \le 0\), \(w_2 \le 0\) и одновременно \(w_1 + w_2 \gt 0\).
Почему исправление двигает в нужную сторону
Пока правило выглядит как удачная догадка про совет и голоса. У него есть обоснование в пять строк. Следить будем за одной величиной: \(t \cdot a\). Запись предсказана верно, когда \(t \cdot a \gt 0\). При одних и тех же весах чем это число больше, тем дальше точка от границы на своей стороне.
-
Пусть запись \((\vb{x}, t)\) предсказана неверно. Знак суммы не совпал с целью:
\[ t \cdot a_{\text{old}} \le 0, \qquad a_{\text{old}} = \vb{w}\T\vb{x} \] -
Правило прибавляет к весам \(\eta\, t\, \vb{x}\):
\[ \vb{w}_{\text{new}} = \vb{w} + \eta\, t\, \vb{x} \] -
Считаем сумму для той же записи с новыми весами. Скобки раскрываются как обычно, а \(\vb{x}\T\vb{x}\) — это квадрат длины вектора:
\[ \begin{aligned} a_{\text{new}} &= (\vb{w} + \eta\, t\, \vb{x})\T\vb{x} \\ &= a_{\text{old}} + \eta\, t\, \norm{\vb{x}}^2 \end{aligned} \] -
Умножим обе части на \(t\). Цель равна \(\pm 1\), поэтому \(t^2 = 1\):
\[ t\, a_{\text{new}} = t\, a_{\text{old}} + \eta\, \norm{\vb{x}}^2 \] -
Числа из примера: у каждой записи \(\norm{\vb{x}}^2 = 1 + 1 + 1 = 3\), а \(\eta = 0.5\). Одно исправление поднимает \(t \cdot a\) ровно на 1.5. Проверь по записи 2: было \(-0.5\), стало \(+1\).
\[ -0.5 + 0.5 \cdot 3 = 1 \]
Прибавка \(\eta \norm{\vb{x}}^2\) всегда положительна: каждое исправление тянет свою запись на правильную сторону. В картинке виджета это выглядит так: стрелка \(\vb{w}\) поворачивается к точке, если её цель \(+1\), и отворачивается от неё, если цель \(-1\). Отсюда два следствия.
Первое: одного исправления может не хватить. Со старта \((1, -1, 0.5)\) у записи 1 было \(t \cdot a = -1.5\). После исправления стало ровно 0: выход 0, всё ещё ошибка.
Второе: исправление для одной записи меняет сумму у всех остальных и может сломать то, что уже было верным. Пример из виджета: AND со старта \((1, -1, 0.5)\). Во второй эпохе исправление записи 2 портит сразу две записи, 3 и 4: их суммы были \(-0.5\) и \(0.5\), а стали 0, и счётчик ошибок вырастает с 1 до 2. Поэтому одного прохода мало, и процедура ходит по кругу, пока не случится круг без исправлений.
Два вопроса профессора
Теперь можно вернуться к вопросам со слайда 12 лекции 2.
Всегда ли процедура остановится?
Нет. Но известно точно, когда да, а когда нет. Нужно одно понятие. Данные линейно разделимы (linearly separable), если существует прямая — при большем числе входов гиперплоскость, — по одну сторону которой лежат все примеры с \(t = +1\), а по другую все с \(t = -1\).
Если обучающие примеры линейно разделимы, Hebbian learning делает конечное число исправлений и останавливается на весах, которые предсказывают все примеры верно. Если не разделимы, процедура не остановится никогда.
Вторая половина почти очевидна. Остановка — это эпоха без ошибок, то есть веса, которые делят классы прямой. Нет такой прямой — нет и остановки. Содержательна первая половина: если решение существует, исправления не могут продолжаться бесконечно. Доказательства на слайдах нет, и на экзамене нужна только формулировка.
OR и AND разделимы: три исправления и одно. А вот что делает правило с XOR, у которого цели \(-1, +1, +1, -1\).
Первые три шага совпадают с OR: у XOR на первых трёх записях те же цели. На четвёртой записи \((1, 1, 1)\) сумма равна 1.5, а цель \(-1\). Ошибка, и исправление возвращает веса в \((0, 0, 0)\). Вторая эпоха начинается с того же места и повторяет первую шаг в шаг. Почему для XOR разделяющей прямой нет и что из этого следует, разберём в следующем уроке.
Сколько исправлений может понадобиться?
У теоремы есть количественная часть (Novikoff, 1962): при старте с нуля исправлений не больше \((R/\gamma)^2\). Оба числа считаются для векторов вместе с постоянным входом, \(\vb{x} = (1, x_1, x_2)\). \(R\) — длина самого длинного из них. \(\gamma\) — зазор лучшего решения: берём вектор весов \(\vb{u}\) единичной длины и смотрим на наименьшее \(t \cdot \vb{u}\T\vb{x}\) по всем записям; лучший \(\vb{u}\) тот, у которого это число самое большое.
Для нашего OR \(R^2 = 1 + 1 + 1 = 3\). Лучший вектор — \(\vb{u} = (1, 1, 1)/\sqrt{3}\), его зазор \(\gamma = 1/\sqrt{3}\), то есть \(\gamma^2 = \tfrac{1}{3}\). Оценка даёт \(R^2/\gamma^2 = 9\), а на деле хватило трёх. На слайдах этой оценки нет. Полезен её смысл: чем уже зазор между классами, тем больше исправлений может понадобиться.
Всегда ли на одних и тех же весах?
Тоже нет. Разделяющих прямых бесконечно много, а процедура останавливается на первой, до которой дошла. Какой она окажется, зависит от трёх вещей. Все три примера ниже — для OR, и все можно воспроизвести в виджете.
- Начальные веса. Со старта \((0, 0, 0)\) получается \((0.5,\ 0.5,\ 0.5)\), со старта \((1, -1, 0.5)\) — \((1,\ 1,\ 0.5)\).
- Порядок записей. Со старта \((0.5, -1.5, 1)\) в порядке таблицы получается \((1,\ 1,\ 0.5)\), в обратном — \((1,\ 1,\ 1.5)\).
- \(\eta\), если старт не с нуля. Со старта \((1, -1, 0.5)\) при \(\eta = 0.5\) получается \((1,\ 1,\ 0.5)\), при \(\eta = 0.6\) — \((0.4,\ 0.8,\ 1.1)\).
При старте с нуля \(\eta\) ничего не решает: все веса просто умножаются на одно число. При \(\eta = 0.1\) пример со слайда даёт \((0.1,\ 0.1,\ 0.1)\) — ту же прямую за те же три исправления. И ещё одно: процедуре всё равно, хороша ли прямая, проходит ли она посередине между классами или впритык к точкам. Нет ошибок — нет исправлений.
«Маленький \(\eta\) надёжнее, а большой может разойтись». Так бывает в gradient descent на гладкой функции ошибки (урок 13), и конспект на стр. 48 сравнивает \(\eta\) с ограничением скорости. Для Hebbian learning это сравнение не работает: на линейно разделимых данных процедура останавливается при любом \(\eta \gt 0\). Конспект советует \(\eta = 0.01\), слайд 12 лекции 2 берёт \(\eta = 0.5\). В задаче используй число из условия.
Процедура останавливается тогда и только тогда, когда данные линейно разделимы, а на каких именно весах — зависит от старта, порядка записей и \(\eta\).
Вот и ответы на загадку из начала урока: «не всегда» и «не всегда». Ручки Mark I замирают за конечное число поворотов, если задачу вообще можно решить одной прямой. А у двух студентов с разными стартовыми весами они замрут в разных положениях, и оба ответа будут верными.
Остался последний вопрос: почему поправка именно \(\eta\, t\, \vb{x}\), а не какая-нибудь другая? В уроке 16 окажется, что Hebbian learning — это stochastic gradient descent для функции ошибки \(D(\vb{w}, w_0)\), которая с точностью до множителя складывает расстояния от неверно предсказанных точек до границы. Пока достаточно знать, что такая функция есть и что каждое исправление — шаг против её градиента, посчитанного по одной ошибочной записи. Отсюда и слово online: одна запись — один шаг.
В формате экзамена
State the learning rule used in the course to train a single perceptron (Hebbian learning). Define every symbol, say when the rule is applied and when the procedure ends.
Show model answer
For every weight \(w_i\), \(i = 0, \dots, I\):
\[ w_i^{k+1} = w_i^{k} + \Delta w_i^{k}, \qquad \Delta w_i^{k} = \eta\, x_i^{k}\, t^{k} \]\(\eta\) is the learning rate, \(x_i^{k}\) is the \(i\)-th input of the sample presented at step \(k\) (with \(x_0 = 1\), so the bias \(w_0\) changes by \(\eta\, t^{k}\)), and \(t^{k} \in \{-1, +1\}\) is the desired output. The weights start from a random initialisation. Samples are presented one at a time (online), and the weights are changed only if the sample is not correctly predicted, i.e. \(\mathrm{Sign}(\vb{w}\T\vb{x}) \ne t\). The records are cycled until a whole pass produces no error.
Проверяют четыре вещи: формулу, слово online, условие «только если предсказано неверно» и критерий остановки. Чаще всего теряют третье, а без него это другой алгоритм.
A perceptron with inputs \(x_1, x_2 \in \{-1, +1\}\), bias input \(x_0 = 1\) and activation Sign (the output is 0 when \(\vb{w}\T\vb{x} = 0\)) has to learn the OR operator by Hebbian learning. Initial weights \(\vb{w} = [0\ 0\ 0]\), learning rate \(\eta = 0.5\), records in truth-table order: \((-1,-1)\), \((-1,+1)\), \((+1,-1)\), \((+1,+1)\). How many weight updates are performed before the procedure ends?
Show model answer
Weights as \((w_0, w_1, w_2)\). Record 1: \(a = 0\), output 0, target \(-1\): update to \((-0.5,\ 0.5,\ 0.5)\). Record 2: \(a = -0.5\), wrong: update to \((0,\ 0,\ 1)\). Record 3: \(a = -1\), wrong: update to \((0.5,\ 0.5,\ 0.5)\). Record 4: \(a = 1.5\), correct. Second pass: \(a = -0.5,\ 0.5,\ 0.5,\ 1.5\), all correct, stop.
3 updates. Final boundary: \(x_2 = -x_1 - 1\).
Это упражнение со слайда 12 лекции 2 почти дословно. Две ловушки: Sign(0) = 0 считается ошибкой (иначе первая запись «уже верна»), и нельзя останавливаться после четвёртой записи без контрольного прохода.
The current weights of a perceptron are \((w_0, w_1, w_2) = (0.2,\ -0.4,\ 0.1)\) and the learning rate is \(\eta = 0.3\). The sample \((x_1, x_2) = (1, -1)\) with target \(t = +1\) is presented (bias input \(x_0 = 1\), Sign activation). Apply one step of Hebbian learning. What is the value of \(w_1\) after this step?
Show model answer
\(a = 0.2 - 0.4 - 0.1 = -0.3 \lt 0\), so the output is \(-1 \ne t\): the sample is misclassified and the weights are updated.
\[ \begin{aligned} \Delta\vb{w} &= 0.3 \cdot (+1) \cdot (1,\ 1,\ -1) \\ &= (0.3,\ 0.3,\ -0.3) \end{aligned} \]New weights: \((0.5,\ -0.1,\ -0.2)\), so \(w_1 = -0.1\). Check: the new sum is \(0.5 - 0.1 + 0.2 = 0.6 \gt 0\), the sample is now correct.
Сначала проверка, потом исправление: если бы сумма была положительной, веса не менялись бы и ответом было бы −0.4. Вторая частая потеря — знак \(x_2 = -1\) в сумме. Контроль: сумма должна вырасти на \(\eta \norm{\vb{x}}^2 = 0.9\).
Does Hebbian learning of a perceptron always terminate? When it terminates, is the final weight vector always the same? Justify both answers.
Show model answer
It terminates after a finite number of updates if and only if the training set is linearly separable (perceptron convergence theorem). If it is not, e.g. XOR, some sample is always misclassified, so the updates never stop and the weights cycle: for XOR from \(\vb{w} = [0\ 0\ 0]\) they are back at \([0\ 0\ 0]\) after every epoch.
The solution is not unique. Infinitely many hyperplanes separate a separable set and the procedure stops at the first one it reaches; which one depends on the initial weights, on the order of the samples and, for non-zero initial weights, on \(\eta\).
Это два вопроса со слайда 12 лекции 2. Полный балл дают за «if and only if linearly separable» и за перечисление того, от чего зависит результат. Пример с XOR добавляет убедительности и стоит одной строки.
Which statements about Hebbian learning of a perceptron, as presented in the course, are correct? Select all that apply.
Show model answer
Correct: the first, the second and the fifth statements.
В вопросах «select all» каждое утверждение проверяется отдельно. Третье и четвёртое — самые частые заблуждения про это правило.
The rule \(\Delta w_i = \eta\, x_i\, t\) is used with targets in \(\{-1, +1\}\). Explain what goes wrong if the targets are coded as \(\{0, 1\}\).
Show model answer
With \(t = 0\) the update \(\eta\, x_i\, t\) is zero for every weight, so a sample with target 0 that is wrongly predicted as 1 can never be corrected: with 0/1 inputs the weights can only grow. Example: AND with 0/1 coding, zero initial weights, \(\eta = 0.5\). The only update, from record \((1, 1)\), gives \((0.5,\ 0.5,\ 0.5)\), which outputs 1 for all four records; the three wrong records have \(t = 0\), so the procedure is stuck.
With \(\pm 1\) targets a negative target gives a negative update, and correctness is the single test \(t \cdot \vb{w}\T\vb{x} \gt 0\).
Достаточно первой фразы и одного примера. Вопрос проверяет, что смена кодировки на слайде 12 лекции 2 понята, а не просто замечена.
Проверь себя
Перцептрон получил запись и предсказал её верно. Что делает Hebbian learning?
Запись \((x_0, x_1, x_2) = (1, -1, +1)\) с целью \(t = -1\) предсказана неверно, \(\eta = 0.5\). Какая поправка \(\Delta\vb{w}\)?
Данные линейно разделимы. От чего зависят веса, на которых процедура остановится?
Разделяющих прямых бесконечно много, и правило берёт первую, до которой дошло.
XOR, старт \((0, 0, 0)\), \(\eta = 0.5\). После первой эпохи веса снова \((0, 0, 0)\). Что из этого следует?
До исправления у записи было \(t \cdot a = -0.5\). Запись \(\vb{x} = (1, -1, +1)\), \(\eta = 0.5\). Чему равно \(t \cdot a\) для неё сразу после исправления?
Почему правило \(\Delta w_i = \eta\, x_i\, t\) ломается с целями 0/1?
Унести с собой
- Hebbian learning в курсе: \(w_i^{k+1} = w_i^{k} + \eta\, x_i^{k}\, t^{k}\), по одной записи (online) и только если запись предсказана неверно. Bias — обычный вес при входе \(x_0 = 1\), его поправка \(\Delta w_0 = \eta\, t\).
- Правило рассчитано на цели \(\pm 1\) и Sign с тремя значениями. При целях 0/1 поправка для \(t = 0\) обнуляется, и ответ 1 вместо 0 исправить нечем.
- Каждое исправление увеличивает \(t \cdot a\) своей записи на \(\eta \norm{\vb{x}}^2\). Этого может не хватить, и оно может сломать другие записи — поэтому нужны повторные эпохи.
- Остановка — эпоха без исправлений. Она наступит тогда и только тогда, когда данные линейно разделимы; на XOR веса ходят по кругу.
- Решение не единственно: оно зависит от начальных весов, порядка записей и, при ненулевом старте, от \(\eta\).
- Пример со слайда 12 лекции 2: OR, \(\vb{w} = [0\ 0\ 0]\), \(\eta = 0.5\) — три исправления, итог \((0.5,\ 0.5,\ 0.5)\), граница \(x_2 = -x_1 - 1\).
Что посмотреть и почитать
-
ChatGPT is made from 100 million of these [The Perceptron]
Welch Labsоколо 24 мин
История перцептрона Розенблатта и машины Mark I: видно, как правило подкручивает веса только после ошибки. Хороший разгон перед расчётом руками.
-
Perceptron Visualizer
Jason Hand
Те же шаги на своих точках: расставь точки двух классов щелчками, иди по обучению шаг за шагом и следи, что прямая прыгает только на ошибках. Потом расставь четыре точки как XOR и убедись, что прямая не успокаивается.
-
Lecture note: The Perceptron
Kilian Weinberger, Cornell CS4780
Доказательство теоремы о сходимости в несколько строк и оценка числа исправлений. Обозначения другие: метки \(y \in \{-1, +1\}\) вместо \(t\), и нет \(\eta\) — там он равен 1. Оценка там записана как \(1/\gamma^2\): это тот же результат для входов, заранее сжатых до \(R = 1\).
-
Hebbian theory
Wikipedia
Что на самом деле постулировал Хебб и чем его правило без учителя отличается от нашего. Мостик к Applied Statistics: нормированная версия правила Хебба (правило Oja) сходится к первой главной компоненте, той самой PC1 из PCA.