Забор со стрелкой
После этого урока ты посчитаешь расстояние от точки до гиперплоскости со знаком, выведешь правило обучения перцептрона как stochastic gradient descent на функции \(D(\vb{w}, w_0)\) и скажешь, когда оно остановится, а когда нет.
В перцептроне Розенблатта веса хранились в потенциометрах, а при обучении их подкручивали электромоторы. Правило, по которому они крутились, знакомо по уроку 7: \(\Delta w_i = \eta\, x_i\, t\), и только если точка классифицирована неверно. Ни одной производной.
Три последних урока строили другой рецепт: выбрать error function, найти её градиент, шагнуть против него. А последний слайд лекции 2 заявляет, что это одно и то же: «Hebbian learning implements Stochastic Gradient Descent».
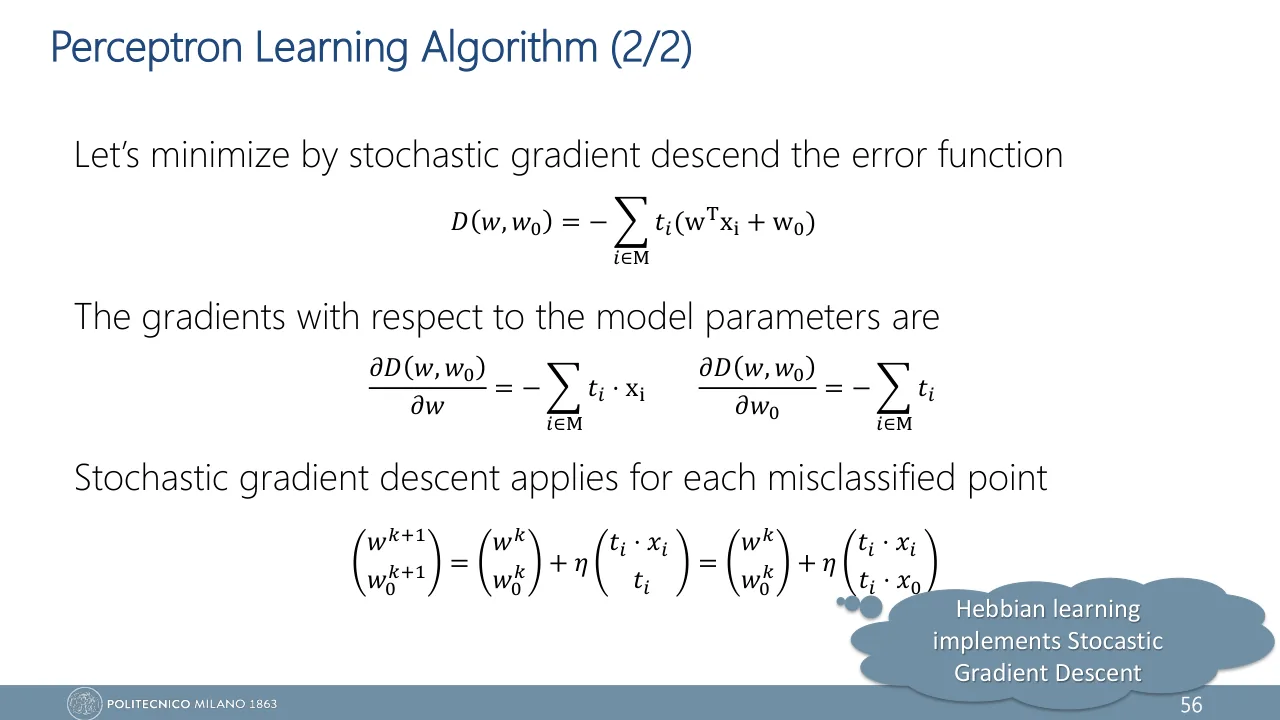
Но спуск по какой функции? Число ошибок не годится: оно меняется скачками, наклона у него нет. Значит, моторы уменьшали что-то другое, и никто им об этом не говорил. Найдём эту функцию.
Забор, стрелка и расстояние со знаком
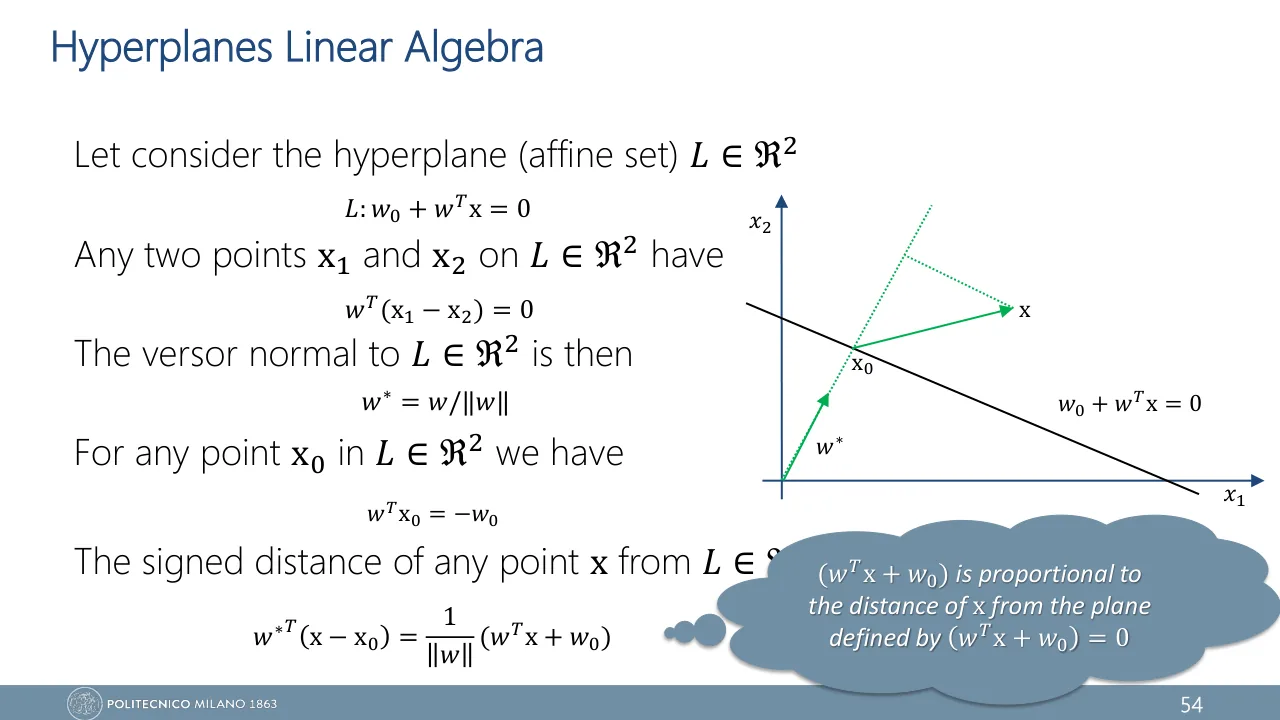
В уроке 6 перцептрон делил плоскость прямой. В общем случае границу называют гиперплоскостью (hyperplane): это все точки \(\vb{x}\), для которых \(\vb{w}\T\vb{x} + w_0 = 0\). При двух входах это прямая, при трёх — плоскость, дальше воображение отказывает, а формула остаётся той же.
Картинка на весь урок: гиперплоскость — это забор, а к забору прибита стрелка \(\vb{w}\). Стрелка торчит перпендикулярно забору и показывает сторону, где перцептрон отвечает \(+1\). Число \(w_0\) двигает забор параллельно самому себе.
Чтобы превратить картинку в формулу, хватает одной идеи: расстояние до забора — это проекция на направление стрелки. Вывод со слайда «Hyperplanes Linear Algebra» занимает пять шагов, и это экзаменационный материал.
-
Возьмём две любые точки \(\vb{u}\) и \(\vb{v}\) на заборе (на слайде они названы \(\vb{x}_1\) и \(\vb{x}_2\)). Обе обнуляют выражение:
\[ w_0 + \vb{w}\T\vb{u} = 0 \] \[ w_0 + \vb{w}\T\vb{v} = 0 \] -
Вычтем одно из другого, \(w_0\) сократится:
\[ \vb{w}\T(\vb{u} - \vb{v}) = 0 \]Вектор \(\vb{u} - \vb{v}\) лежит вдоль забора, а его скалярное произведение с \(\vb{w}\) равно нулю. Значит, \(\vb{w}\) перпендикулярен забору: это нормаль (normal vector).
-
Длина \(\vb{w}\) может быть любой, а мерить расстояния нужно стрелкой единичной длины (на слайде — «versor»):
\[ \vb{w}^{*} = \frac{\vb{w}}{\norm{\vb{w}}} \] -
Возьмём любую точку \(\vb{x}_0\) на заборе. Для неё уравнение забора даёт
\[ \vb{w}\T\vb{x}_0 = -w_0 \] -
Расстояние от \(\vb{x}\) до забора — проекция вектора \(\vb{x} - \vb{x}_0\) на единичную нормаль. Подставим шаги 3 и 4:
\[ \begin{aligned} \vb{w}^{*\mathsf{T}}(\vb{x} - \vb{x}_0) &= \frac{\vb{w}\T\vb{x} - \vb{w}\T\vb{x}_0}{\norm{\vb{w}}} \\[4pt] &= \frac{\vb{w}\T\vb{x} + w_0}{\norm{\vb{w}}} \end{aligned} \]Точка \(\vb{x}_0\) исчезла: какую ни возьми, ответ один.
- \(d(\vb{x})\)
- расстояние со знаком (signed distance); в конспекте — \(d(x, \Pi)\)
- \(\vb{w}\T\vb{x} + w_0\)
- активация \(a\): то, что нейрон считает до порога; в конспекте (стр. 116) ещё net input и algebraic distance
- \(\norm{\vb{w}}\)
- длина стрелки, \(\sqrt{w_1^2 + \dots + w_I^2}\)
- \(w_0\)
- bias; в ранних разделах конспекта он обозначен \(b\)
Знак \(d\) говорит, по какую сторону забора стоит точка, а модуль — как далеко она от него.
Проверим на числах, которые в этом уроке встретятся ещё дважды. Забор \(x_1 - x_2 = 0\), то есть \(\vb{w} = (1, -1)\) и \(w_0 = 0\). Точка \(\vb{x} = (1, 2)\):
\[ a = 1 \cdot 1 + (-1) \cdot 2 + 0 = -1 \] \[ d = \frac{-1}{\sqrt{1^2 + (-1)^2}} = -\frac{1}{\sqrt{2}} \approx -0.71 \]Точка стоит в 0.71 от забора, на стороне, противоположной стрелке. В виджете ниже это стартовое положение.
«\(\vb{w}\T\vb{x} + w_0\) — это расстояние до границы». Только если \(\norm{\vb{w}} = 1\). В общем случае это расстояние, умноженное на длину стрелки. Знак у обоих чисел всегда одинаковый, так что для вопроса «по какую сторону?» хватает активации, а для вопроса «как далеко?» нужно поделить.
Один тест на правильность: знак произведения t·a
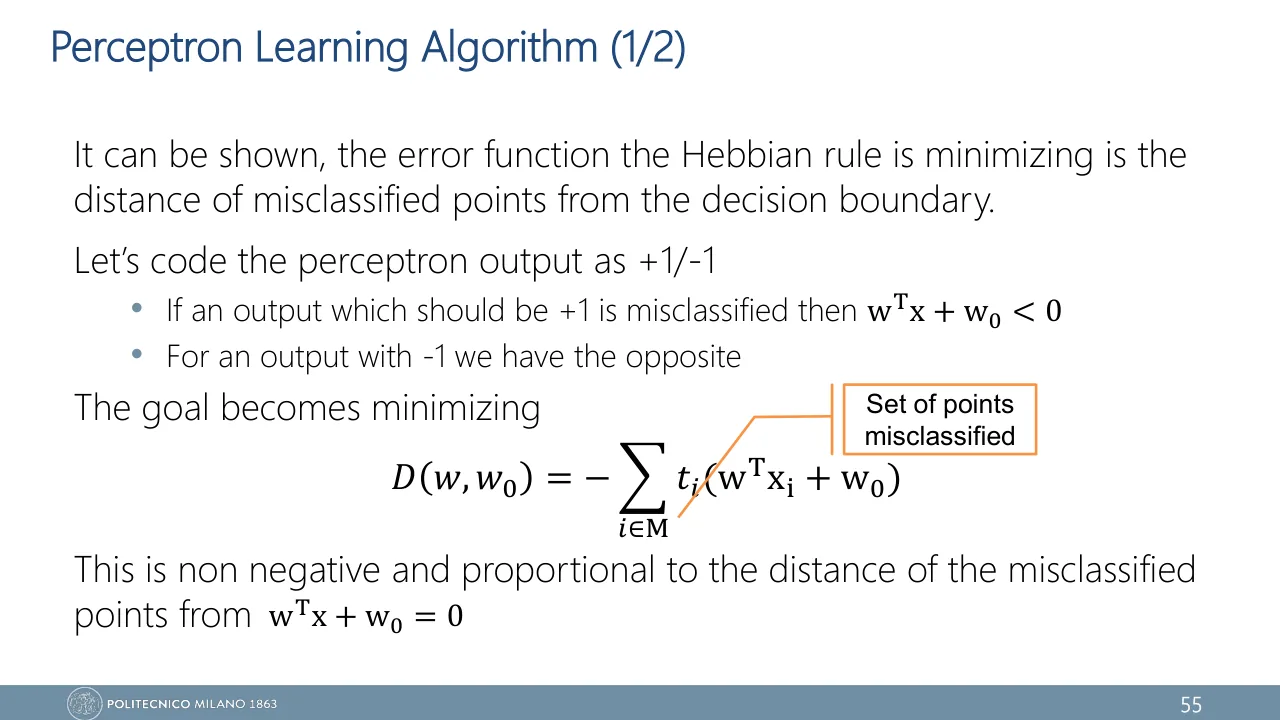
Стрелка задаёт сторону «плюс». Теперь добавим данные: у каждой точки \(\vb{x}_i\) есть target \(t_i\). Слайд 54 лекции 2 кодирует классы как \(+1\) и \(-1\) («Let's code the perceptron output as +1/-1»). Перцептрон считает активацию \(a_i = \vb{w}\T\vb{x}_i + w_0\) и отвечает её знаком, \(\sign(a_i)\); в конспекте этот ответ обозначен \(\hat y_i\).
Зачем \(\pm 1\), а не 0 и 1? Чтобы правильность ответа проверялась одним умножением. Перебери четыре случая.
| target \(t_i\) | где стоит точка | \(t_i\,a_i\) | вердикт |
|---|---|---|---|
| +1 | на стороне стрелки, \(a_i \gt 0\) | \(\gt 0\) | верно |
| +1 | за забором, \(a_i \lt 0\) | \(\lt 0\) | ошибка |
| −1 | за забором, \(a_i \lt 0\) | \(\gt 0\) | верно |
| −1 | на стороне стрелки, \(a_i \gt 0\) | \(\lt 0\) | ошибка |
Слайд 54 говорит то же двумя строчками: «If an output which should be +1 is misclassified then \(\vb{w}\T\vb{x} + w_0 \lt 0\)» и «For an output with -1 we have the opposite». Это вторая и четвёртая строки таблицы.
Точка классифицирована верно тогда и только тогда, когда \(t_i\,a_i \gt 0\).
Множество ошибочных точек \(M\) (set of misclassified points) — все точки, которые сейчас стоят не на своей стороне забора: \(M = \{\, i : t_i(\vb{w}\T\vb{x}_i + w_0) \lt 0 \,\}\). Оно зависит от весов: сдвинешь забор — изменится и \(M\).
Строго или нестрого? На стр. 116 множество \(M\) определено через «\(\lt 0\)», а алгоритм на стр. 121 проверяет «\(\le 0\)». Для обучения нужен второй вариант. Слайд 12 лекции 2 стартует с \(\vb{w} = [0\ 0\ 0]\): тогда все \(a_i = 0\), и строгий тест не нашёл бы ни одной ошибки. На слайде это спрятано в функцию Sign: при \(\vb{w}\T\vb{x} = 0\) выход равен 0, а он не совпадает ни с одним target.
Чем измерить ошибку: функция D
Теперь нужна error function: одно число, которое говорит, насколько плохо стоит забор, и которое можно уменьшать по градиенту.
Первая мысль — посчитать ошибочные точки. Представь, что забор сдвинули на волосок. Счётчик не шелохнулся. Он стоит, пока забор не перешагнёт через какую-нибудь точку, и тогда прыгает сразу на единицу. Это функция из плоских площадок (она нарисована ниже, на рис. 3): её градиент почти всюду равен нулю, и спускаться по ней некуда. Та же беда, что у ступеньки в уроке 10.
Вторая мысль — спросить у каждой ошибочной точки не «ты ошиблась?», а «далеко ли тебе до своей стороны?». Расстояние меняется плавно. Для ошибочной точки \(t_i\,a_i \lt 0\), значит \(-t_i\,a_i\) — положительное число, пропорциональное её расстоянию до забора. Сложим такие числа по всем ошибочным точкам.
- \(D\)
- error function перцептрона
- \(M\)
- множество ошибочных точек («Set of points misclassified»)
- \(t_i\)
- target точки \(i\): \(+1\) или \(-1\)
- \(\vb{w}\T\vb{x}_i + w_0\)
- активация \(a_i\): расстояние со знаком, умноженное на \(\norm{\vb{w}}\)
Слайд 54 лекции 2 с этого и начинает: «the error function the Hebbian rule is minimizing is the distance of misclassified points from the decision boundary». А про саму \(D\) говорит коротко: «non negative and proportional to the distance of the misclassified points». Если развернуть эту фразу, получатся три свойства (в конспекте они на стр. 117).
- \(D \ge 0\): каждое слагаемое \(-t_i\,a_i\) положительно.
- \(D = 0\), когда ошибочных точек нет: сумма пуста.
- \(D\) тем больше, чем больше ошибочных точек и чем дальше они забрались на чужую сторону.
Теперь сравним обоих кандидатов на одном опыте. Возьмём забор с рис. 2 и будем двигать его параллельно самому себе: стрелка \(\vb{w} = (1, 1)\) прежняя, меняется только \(w_0\). Для каждого положения посчитаем и число ошибочных точек, и \(D\).
Число ошибочных точек
\(D(\vb{w}, w_0)\)
«\(D\) — это число ошибочных точек». Нет: \(D\) складывает их расстояния до забора, умноженные на \(\norm{\vb{w}}\). Две ошибочные точки вплотную к забору дают меньший \(D\), чем одна, ушедшая далеко. Именно поэтому у \(D\) есть наклон, а у счётчика ошибок его нет.
Почему в D нет деления на длину стрелки?
Конспект (стр. 117) говорит, что это «only scales the error, not its direction». Аккуратнее так: \(D(\alpha\vb{w}, \alpha w_0) = \alpha\,D(\vb{w}, w_0)\), то есть \(D\) можно уменьшить, просто сжав все веса и не сдвинув забор ни на миллиметр. Алгоритму это не мешает, потому что он останавливается не тогда, когда \(D\) мало, а тогда, когда \(M\) пусто. Зато без деления градиент получается в одну строку. Безопасная формулировка для экзамена — та, что на слайде: \(D\) неотрицательна и пропорциональна расстоянию ошибочных точек.
Градиент D — это и есть правило Хебба
Дальше та же механика, что в уроке 13: взять производные и шагнуть против них. Разница одна: \(D\) устроена так просто, что градиент пишется сразу, без backpropagation.
-
Функция ошибки. Множество \(M\) считаем замороженным: оно посчитано для текущих весов.
\[ D = -\sum_{i \in M} t_i\,(\vb{w}\T\vb{x}_i + w_0) \] -
Производная по \(\vb{w}\). В скобке от \(\vb{w}\) зависит только \(\vb{w}\T\vb{x}_i\), и его производная равна \(\vb{x}_i\):
\[ \pd{D}{\vb{w}} = -\sum_{i \in M} t_i\,\vb{x}_i \] -
Производная по \(w_0\) ещё проще: производная скобки равна 1.
\[ \pd{D}{w_0} = -\sum_{i \in M} t_i \] -
Gradient descent: шаг против градиента. Два минуса дают плюс:
\[ \vb{w} \leftarrow \vb{w} + \eta \sum_{i \in M} t_i\,\vb{x}_i \] \[ w_0 \leftarrow w_0 + \eta \sum_{i \in M} t_i \]Это batch-версия: один шаг учитывает все ошибочные точки сразу. Он толкает их в нужную сторону, но не обещает, что все они перейдут забор за один раз (конспект на стр. 118 здесь оптимистичнее, чем следует).
-
Stochastic gradient descent берёт из суммы одно слагаемое — одну ошибочную точку \(i\) — и шагает сразу:
\[ \begin{pmatrix} \vb{w}^{k+1} \\ w_0^{k+1} \end{pmatrix} = \begin{pmatrix} \vb{w}^{k} \\ w_0^{k} \end{pmatrix} + \eta \begin{pmatrix} t_i\,\vb{x}_i \\ t_i \end{pmatrix} \] -
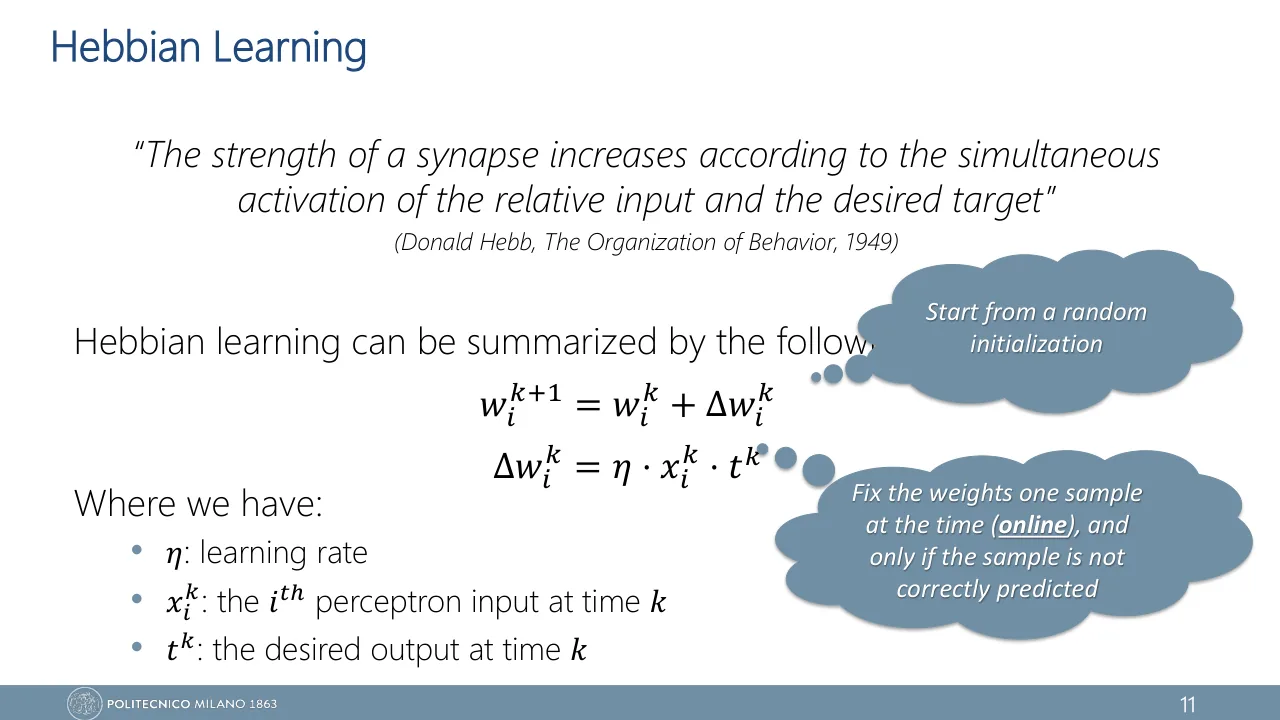
Вспомним bias trick: \(w_0\) — это вес при входе \(x_0 = 1\). На слайде это второе равенство: в нижней строке вместо \(t_i\) написано \(t_i \cdot x_0\). Тогда нижняя строка — то же правило, что и верхняя, и для каждого веса \(w_j\), включая \(w_0\):
\[ \Delta w_j = \eta\, x_j\, t \]Это Hebbian learning со слайда 11 лекции 2 (там индекс входа — \(i\), а \(k\) — номер шага), применённое только к ошибочным точкам.
- \(\vb{x}_i,\ t_i\)
- одна ошибочная точка и её target
- \(\eta\)
- learning rate, положительное число
- условие
- шаг делается, только если \(t_i\,a_i \le 0\); верные точки веса не трогают
Правило Hebbian learning — это stochastic gradient descent на функции \(D(\vb{w}, w_0)\): одна ошибочная точка, один шаг.
Можно ли дифференцировать D, если M само зависит от весов?
Можно. Перепиши сумму без множества: \(D = \sum_n \max(0,\ -t_n a_n)\). Пока забор не пересекает ни одной точки, состав \(M\) не меняется, и \(D\) — обычная линейная функция весов. В момент, когда точка оказывается на заборе, её слагаемое равно нулю с обеих сторон, так что \(D\) непрерывна. Получается кусочно-линейная поверхность без разрывов: по ней можно идти вниз, считая градиент внутри текущего куска.
Что делает один шаг
Вернёмся к забору \(x_1 - x_2 = 0\) и точке \(\vb{x} = (1, 2)\). Пусть её \(t = +1\). Активация \(a = -1\), значит \(t\,a = -1 \le 0\): ошибка. Шаг с \(\eta = 0.5\):
\[ \vb{w} \leftarrow (1, -1) + 0.5 \cdot (1, 2) = (1.5,\ 0) \] \[ w_0 \leftarrow 0 + 0.5 = 0.5 \]Новая активация положительна, точка перешла на свою сторону:
\[ a = 1.5 \cdot 1 + 0 \cdot 2 + 0.5 = 2 \]До: \(t\,a = -1\)
После: \(t\,a = +2\)
Точка с \(t = +1\) тянет стрелку к себе, точка с \(t = -1\) отталкивает её от себя. В обоих случаях произведение \(t_i\,a_i\) этой точки растёт, и легко посчитать, на сколько:
\[ t_i\,a_i^{\text{new}} = t_i\,a_i + \eta\,(\norm{\vb{x}_i}^2 + 1) \]В примере: \(-1 + 0.5 \cdot (1^2 + 2^2 + 1) = 2\). Прибавка всегда положительна, но её может не хватить, чтобы перейти через ноль. К тому же шаг ради одной точки может вытолкнуть на чужую сторону другие. Поэтому по данным ходят кругами, пока за целый проход не случится ни одного исправления.
К этому месту в конспекте приложен рис. 14 (стр. 120): линейная регрессия, по осям два её параметра. Batch gradient descent идёт к минимуму гладкой линией, SGD — ломаной вокруг неё. Подпись обещает «faster but noisier convergence». Точнее так: один шаг SGD стоит одного примера вместо \(N\), поэтому на единицу вычислений он продвигается дальше. Зато каждый шаг шумный, и при постоянном \(\eta\) траектория продолжает дрожать около минимума. Подробности — в уроке 13.
Весь алгоритм целиком — это Listing 1 со стр. 121, с двумя уточнениями: стартовать можно и с нулей, а проверка нестрогая.
w, w0 ← старт (слайд 12: нули)
выбрать η > 0
повторять проходы по данным:
  для каждой пары (x_i, t_i):
    a_i ← wᵀx_i + w0
    если t_i · a_i ≤ 0:
      w  ← w  + η · t_i · x_i
      w0 ← w0 + η · t_i
стоп: проход без исправлений
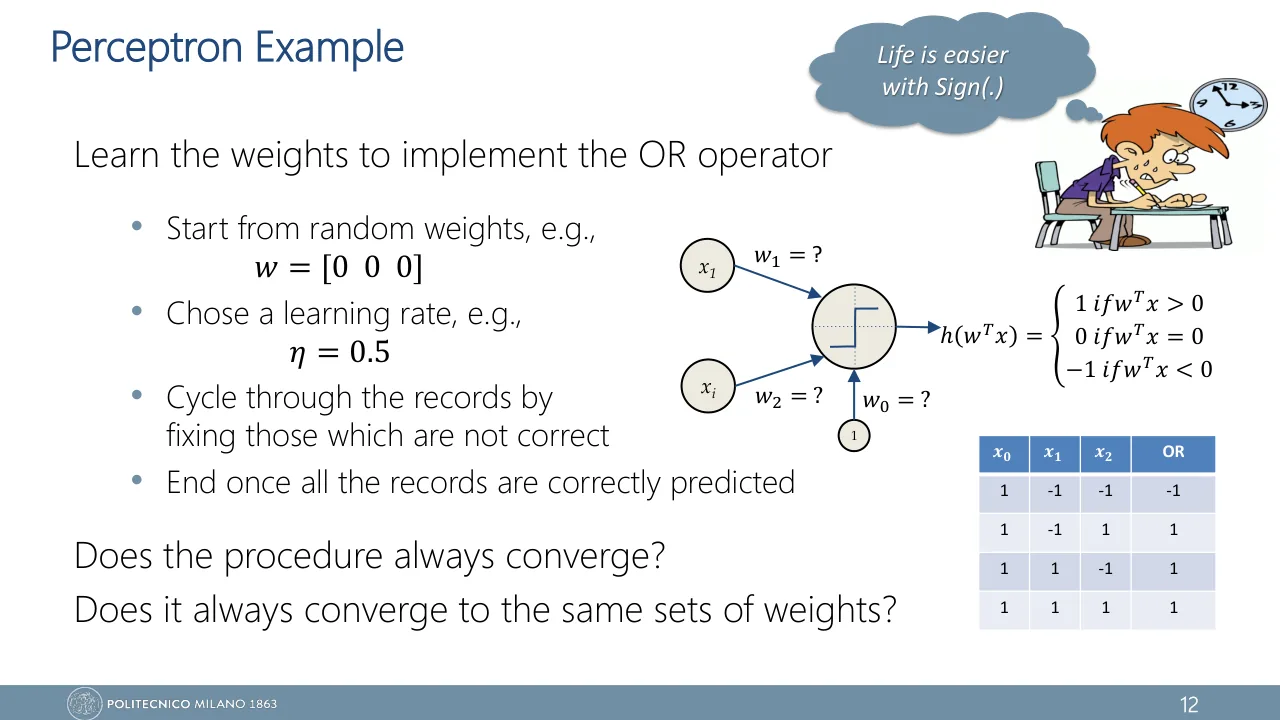
«Стартовые веса должны быть случайными, чтобы сломать симметрию» (так на стр. 121). Симметрию ломают между несколькими скрытыми нейронами, которые иначе остались бы одинаковыми; об этом урок 25. Одному перцептрону ломать нечего, и слайд 12 лекции 2 спокойно стартует с \(\vb{w} = [0\ 0\ 0]\).
Когда забор перестаёт качаться
В тренажёре были оба исхода: на двух облаках забор замер, на XOR и с перебежчиком в чужом облаке — нет. Это не особенность примеров, а теорема.
Если обучающие данные linearly separable, алгоритм находит разделяющую гиперплоскость за конечное число исправлений. Если данные не разделимы, исправления не прекращаются никогда.
Теорема уже встречалась в уроке 7, вместе с двумя вопросами со слайда 12 лекции 2. Теперь на них можно ответить на языке множества \(M\) и функции \(D\). Возьмём оттуда же OR в кодировке \(\pm 1\), старт \(\vb{w} = [0\ 0\ 0]\), \(\eta = 0.5\), и допишем к знакомой таблице столбец \(D\).
| \((x_1, x_2)\) | \(t\) | \(a\) | \(t\,a\) | веса после | \(D\) после |
|---|---|---|---|---|---|
| (−1, −1) | −1 | 0 | 0 | (−0.5, 0.5, 0.5) | 1 |
| (−1, 1) | +1 | −0.5 | −0.5 | (0, 0, 1) | 1 |
| (1, −1) | +1 | −1 | −1 | (0.5, 0.5, 0.5) | 0 |
| (1, 1) | +1 | 1.5 | 1.5 | без изменений | 0 |
«Does the procedure always converge?» Нет: только на разделимых данных. Остановка означает, что за целый проход ни одна точка не дала \(t_i\,a_i \le 0\), то есть \(M\) пусто. OR разделим — три исправления, и второй проход идёт уже без ошибок. На XOR разделяющего забора нет, и \(M\) не пустеет никогда: четыре исправления возвращают веса в \([0\ 0\ 0]\), и всё повторяется по кругу.
«Does it always converge to the same sets of weights?» Тоже нет. Разделяющих заборов бесконечно много, у каждого \(D = 0\), и алгоритм останавливается на первом, который ему попался. Тот же OR со старта \((1, -1, 0.5)\) заканчивается в \((1, 1, 0.5)\), а не в \((0.5, 0.5, 0.5)\). А если начать с нулей и показать точки в обратном порядке, хватит одного исправления вместо трёх. В тренажёре то же видно по кнопке «Случайный старт»: забор каждый раз замирает в новом положении.
Чего теорема не обещает
- Лучший забор. Алгоритм не знает слова «отступ» (margin): забор может встать вплотную к точкам.
- Быстрый ответ. «Конечное число» бывает большим, если классы почти соприкасаются.
- Разумное поведение на неразделимых данных. Не «забор с наименьшим числом ошибок», а вечное качание. На практике число проходов ограничивают.
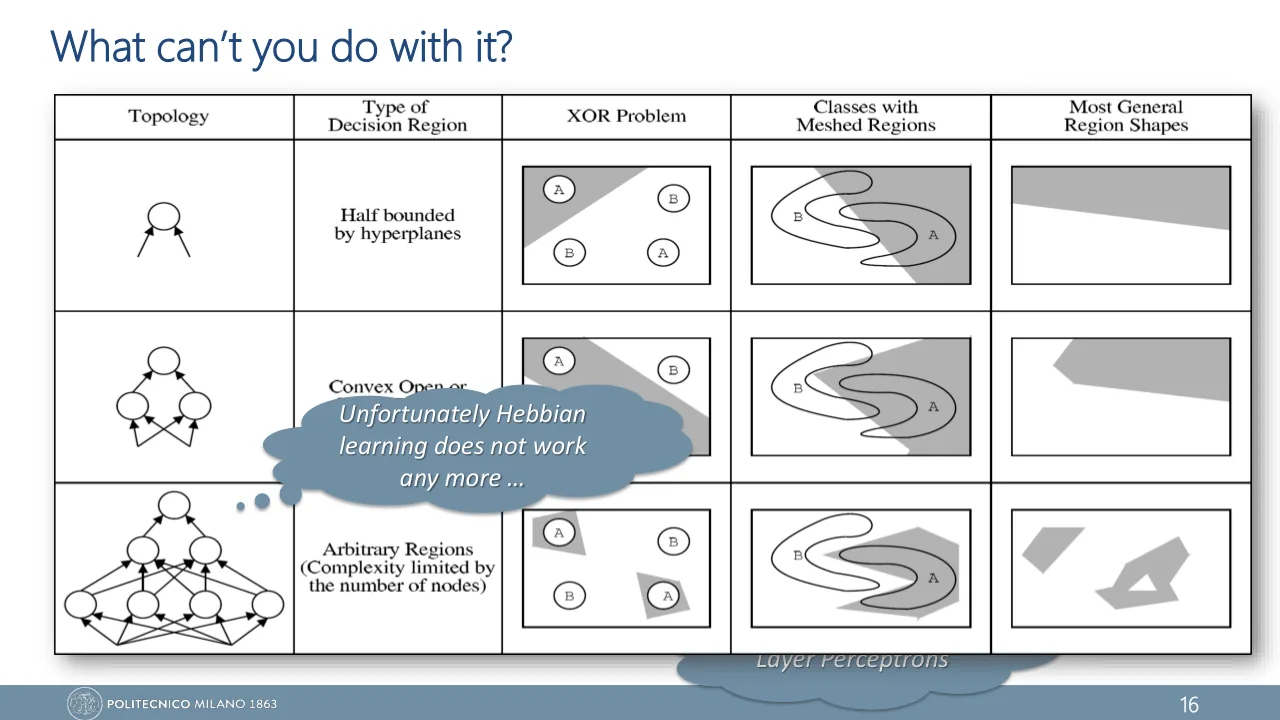
- Скрытые слои. У скрытого нейрона нет своего target, а у ступеньки нет наклона. Слайд 16 лекции 2 говорит об этом прямо: «Unfortunately Hebbian learning does not work any more». Отсюда гладкие активации и backpropagation. Поэтому фразу конспекта со стр. 114, что backpropagation — «a generalization of the Perceptron rule», не стоит понимать буквально: общая у них идея шага против градиента, а само правило перцептрона на скрытые слои не переносится.
«Маленький \(\eta\) делает перцептрон точнее». При старте с нулей \(\eta\) только масштабирует веса. С \(\eta = 0.1\) тот же OR даёт \((0.1, 0.1, 0.1)\) вместо \((0.5, 0.5, 0.5)\): заборы на каждом шаге те же, исправлений столько же.
Сколько именно исправлений? Оценка Novikoff
Этого нет ни в конспекте, ни на слайдах, и на экзамене не спросят; оценка уже мелькала в уроке 7. Запишем каждую точку и веса вместе с входом-единицей: \(\tilde{\vb{x}} = (1, x_1, x_2)\), \(\tilde{\vb{w}} = (w_0, w_1, w_2)\). Пусть \(R\) — длина самого длинного \(\tilde{\vb{x}}_i\). Зазор \(\gamma\) — это наименьшее \(t_i\,\tilde{\vb{w}}\T\tilde{\vb{x}}_i\) для лучшего из разделяющих векторов единичной длины. Тогда при старте с нулей число исправлений не больше \((R / \gamma)^2\) (Novikoff, 1962).
Для OR со слайда 12 лекции 2 \(R^2 = 3\), лучший вектор — \((1, 1, 1) / \sqrt 3\), \(\gamma^2 = 1/3\). Оценка даёт 9; на деле хватило трёх. Это потолок, а не прогноз, но зависимость настоящая: чем уже зазор между классами, тем больше исправлений может понадобиться. В тренажёре придвинь обведённую точку к оранжевым почти вплотную, например к \((-0.7,\ 0)\), нажми «Сбросить» и «Обучать»: вместо шести исправлений понадобятся десятки, а при совсем узком зазоре не хватит и лимита в 150 шагов.
Разгадка
Вернёмся к моторам из начала урока. Они не считали производных и всё же спускались по градиенту. Функция, по которой они спускались, — это \(D(\vb{w}, w_0)\): сумма расстояний ошибочных точек до забора, умноженная на \(\norm{\vb{w}}\). Её градиент по одной точке равен \(-t_i\,\vb{x}_i\): выражение настолько простое, что его исполняет мотор с потенциометром. Отдельный шаг может \(D\) и увеличить, как любой шаг SGD; но на разделимых данных вся цепочка шагов приводит к \(D = 0\). Правило из урока 7 и рецепт из уроков 13–15 — одно и то же: выбрать функцию ошибки, взять градиент, шагнуть против него.
Карта главы 2
Глава началась с одного нейрона и закончилась им же. В ней двенадцать уроков, и они складываются в три акта.
Акт первый: один нейрон проводит одну прямую и учится на ошибках, но XOR ему не по силам. Акт второй: нейроны собираются в Feed Forward Neural Network с гладкими активациями, и такая сеть способна приблизить любую непрерывную функцию. Акт третий: как найти веса. Он сводится к трём вопросам, и на каждый у перцептрона уже был свой игрушечный ответ.
| Вопрос | Feed Forward Neural Network | Перцептрон |
|---|---|---|
| Что минимизировать? | \(E(\vb{w})\): Sum of Squared Errors или cross-entropy, из maximum likelihood (уроки 11, 15) | \(D(\vb{w}, w_0)\): расстояния ошибочных точек |
| Как узнать наклон? | backpropagation: chain rule, forward pass и backward pass (урок 14) | в одну строку: \(-t_i\,\vb{x}_i\) |
| Как шагать? | \(\vb{w} \leftarrow \vb{w} - \eta\,\pd{E}{\vb{w}}\): batch, SGD или mini-batch (урок 13) | \(\vb{w} \leftarrow \vb{w} + \eta\,t_i\,\vb{x}_i\) по одной ошибочной точке |
Конспект на стр. 114 объясняет, зачем после всего этого возвращаться в 1957 год: в перцептроне уже были три идеи, на которых стоит обучение любой современной сети. Решение из взвешенной суммы входов. Исправление весов по ошибке на примере. Постепенное улучшение за много проходов по данным.
| Урок | Вопрос | Ответ в одну строку |
|---|---|---|
| 5 | Что считает нейрон? | \(h(\vb{w}\T\vb{x})\): взвешенная сумма и порог; bias \(w_0\) — вес при \(x_0 = 1\) |
| 6 | Что он умеет? | проводит одну прямую \(w_0 + w_1 x_1 + w_2 x_2 = 0\): AND, OR |
| 7 | Как он учится? | Hebbian learning: \(\Delta w_i = \eta\,x_i\,t\), online и только на ошибках |
| 8 | Чего он не может? | XOR: данные не linearly separable, одной прямой мало |
| 9 | Как собрать сеть? | слои и веса \(w_{ji}^{(l)}\); без нелинейности сто слоёв равны одному |
| 10 | Чем заменить ступеньку? | sigmoid и tanh: гладкие, с простой производной |
| 11 | Что на выходе? | linear, sigmoid (tanh при \(\pm 1\)) или softmax — по задаче, и своя error function |
| 12 | Насколько сеть мощна? | один скрытый слой приближает любую непрерывную функцию; как найти веса, теорема не говорит |
| 13 | Как искать веса? | gradient descent: \(w^{k+1} = w^k - \eta\,\partial E / \partial w\) |
| 14 | Откуда градиент? | backpropagation: chain rule за два прохода |
| 15 | Откуда error function? | maximum likelihood: гауссов шум даёт SSE, Бернулли — cross-entropy |
| 16 | Почему работало правило урока 7? | это SGD на \(D(\vb{w}, w_0)\) |
В формате экзамена
Consider the hyperplane \(L:\ w_0 + \vb{w}\T\vb{x} = 0\). Show that \(\vb{w}\) is orthogonal to \(L\) and that \(\vb{w}\T\vb{x} + w_0\) is proportional to the signed distance of a point \(\vb{x}\) from \(L\).
Show model answer
Take any two points \(\vb{x}_1, \vb{x}_2\) on \(L\). Both satisfy the equation, so subtracting gives \(\vb{w}\T(\vb{x}_1 - \vb{x}_2) = 0\): \(\vb{w}\) is orthogonal to every direction lying in \(L\). The unit normal is \(\vb{w}^{*} = \vb{w} / \norm{\vb{w}}\).
For any point \(\vb{x}_0\) on \(L\) we have \(\vb{w}\T\vb{x}_0 = -w_0\). The signed distance of \(\vb{x}\) is the projection of \(\vb{x} - \vb{x}_0\) on the unit normal:
\[ \vb{w}^{*\mathsf{T}}(\vb{x} - \vb{x}_0) = \frac{\vb{w}\T\vb{x} + w_0}{\norm{\vb{w}}} \]Hence \(\vb{w}\T\vb{x} + w_0\) equals the signed distance times \(\norm{\vb{w}}\); it is positive on the side \(\vb{w}\) points to.
Проверяют три шага: ортогональность через разность двух точек, единичную нормаль и подстановку \(\vb{w}\T\vb{x}_0 = -w_0\). Слово «proportional» важно: без деления на \(\norm{\vb{w}}\) это не расстояние.
A perceptron has weights \(\vb{w} = (1, -1)\) and bias \(w_0 = 0\). Compute the signed distance of the point \(\vb{x} = (1, 2)\) from its decision boundary (two decimals).
Show model answer
The point lies at distance 0.71 on the negative side (the side opposite to \(\vb{w}\)).
Две типичные потери: забыть поделить на \(\norm{\vb{w}} = \sqrt 2\) (ответ \(-1\)) и потерять знак. Раз спрашивают signed distance, минус — часть ответа.
Derive the perceptron learning rule as stochastic gradient descent on a suitable error function. Which learning rule seen earlier in the course do you obtain?
Show model answer
Code the targets as \(t_i \in \{+1, -1\}\). A point is misclassified iff \(t_i(\vb{w}\T\vb{x}_i + w_0) \lt 0\). Let \(M\) be the set of misclassified points. The error function is
\[ D(\vb{w}, w_0) = -\sum_{i \in M} t_i\,(\vb{w}\T\vb{x}_i + w_0) \]It is non-negative and proportional to the distance of the misclassified points from the decision boundary. Its gradients are
\[ \pd{D}{\vb{w}} = -\sum_{i \in M} t_i\,\vb{x}_i, \qquad \pd{D}{w_0} = -\sum_{i \in M} t_i \]Stochastic gradient descent uses one misclassified point at a time:
\[ \vb{w}^{k+1} = \vb{w}^{k} + \eta\,t_i\,\vb{x}_i, \qquad w_0^{k+1} = w_0^{k} + \eta\,t_i \]With \(x_0 = 1\) the bias follows the same rule, so every weight changes by \(\Delta w_j = \eta\,x_j\,t\), applied only to wrongly predicted samples. This is the Hebbian learning rule: Hebbian learning implements stochastic gradient descent.
Полный балл — это четыре вещи: кодировка \(\pm 1\) и условие ошибки, формула \(D\) с множеством \(M\), оба градиента, шаг по одной точке с выводом «это Hebbian learning». Чаще всего теряют знак: в \(D\) минус, в градиенте минус, в правиле плюс.
A perceptron is trained on the OR function with inputs and targets coded as \(\pm 1\): \((-1,-1) \to -1\), \((-1,1) \to +1\), \((1,-1) \to +1\), \((1,1) \to +1\). After the first update its weights are \((w_0, w_1, w_2) = (-0.5,\ 0.5,\ 0.5)\). Compute the value of the error function \(D(\vb{w}, w_0)\).
Show model answer
Activations \(a = -0.5 + 0.5x_1 + 0.5x_2\) for the four points: \(-1.5,\ -0.5,\ -0.5,\ 0.5\). Products \(t\,a\): \(1.5,\ -0.5,\ -0.5,\ 0.5\). The second and the third point are misclassified, so
\[ D = -(-0.5) - (-0.5) = 1 \]Проверяют, что в сумму идут только точки с \(t\,a \lt 0\). Если сложить все четыре произведения со знаком минус, получится \(-1\): отрицательный \(D\) — верный признак, что в сумму попали лишние точки.
The Hebbian rule is run by cycling through the records and fixing those which are not correctly predicted. (a) Does the procedure always converge? (b) Does it always converge to the same set of weights? Justify both answers.
Show model answer
(a) No. It converges in a finite number of updates if and only if the data are linearly separable (perceptron convergence theorem). Otherwise the set of misclassified points is never empty and the weights keep changing forever: for XOR with \(\vb{w} = [0\ 0\ 0]\) and \(\eta = 0.5\) the weights return to zero after four updates and the cycle repeats.
(b) No. Every separating hyperplane is a valid stopping point, and the one reached depends on the initial weights and on the order of the records (and on \(\eta\) when the initial weights are not zero). For OR with \(\pm 1\) coding and \(\eta = 0.5\): starting from \((0, 0, 0)\) gives \((0.5, 0.5, 0.5)\), starting from \((1, -1, 0.5)\) gives \((1, 1, 0.5)\). The rule has no notion of margin: it stops at the first hyperplane with no mistakes.
Это два вопроса со слайда 12 лекции 2, на которые профессор на слайде не отвечает. Ждут слова linearly separable, контрпример (XOR) и причину неединственности. Одного «нет» без обоснования мало.
Consider the perceptron learning algorithm and its error function
\[ D(\vb{w}, w_0) = -\sum_{i \in M} t_i\,(\vb{w}\T\vb{x}_i + w_0) \]Select all correct statements.
Show model answer
Correct: the first, the third and the fifth. \(D\) sums the (unnormalised) distances of the misclassified points only; its gradient is \(-\sum_{i \in M} t_i \vb{x}_i\); one SGD step is the Hebbian update. The algorithm never stops on non-separable data.
В таких вопросах ловят на двух подменах: «расстояние» на «число точек» и «не сходится» на «сходится к лучшему».
Проверь себя
Точка с \(t = -1\) классифицирована неверно. Что про неё верно?
Все веса умножили на 2: \((\vb{w}, w_0) \to (2\vb{w}, 2w_0)\). Что изменится? Отметь всё верное.
Отсюда видно, что само значение \(D\) мало что значит: важен его ноль и направление, в котором оно убывает.
Почему в качестве error function не берут просто число ошибочных точек?
Сделан один шаг \(\vb{w} \leftarrow \vb{w} + \eta\,t_i\,\vb{x}_i\), \(w_0 \leftarrow w_0 + \eta\,t_i\) для ошибочной точки \(i\). Что гарантировано?
Перцептрон дважды обучили с нулевых весов на одних и тех же данных в одном порядке: с \(\eta = 0.5\) и с \(\eta = 0.1\). Чем отличаются результаты?
Что верно про сходимость алгоритма? Отметь всё верное.
Почему тем же правилом нельзя обучить скрытый слой сети?
Унести с собой
- Гиперплоскость \(\vb{w}\T\vb{x} + w_0 = 0\) — забор; \(\vb{w}\) — нормаль к нему, смотрит на сторону ответа \(+1\); \(w_0\) двигает забор параллельно.
- Расстояние со знаком равно \((\vb{w}\T\vb{x} + w_0) / \norm{\vb{w}}\). Сама активация только пропорциональна расстоянию.
- При \(t \in \{+1, -1\}\) точка классифицирована верно тогда и только тогда, когда \(t\,a \gt 0\).
- \(D(\vb{w}, w_0)\) складывает ненормированные расстояния ошибочных точек: она неотрицательна и равна нулю, когда ошибок нет. Это не счётчик ошибок.
- SGD на \(D\) по одной ошибочной точке даёт \(\vb{w} \leftarrow \vb{w} + \eta\,t_i\,\vb{x}_i\), \(w_0 \leftarrow w_0 + \eta\,t_i\). Это Hebbian learning: «Hebbian learning implements Stochastic Gradient Descent».
- Алгоритм сходится за конечное число исправлений только на linearly separable данных; решение не единственно; на XOR он зацикливается.
- Глава 2 целиком: что минимизировать (maximum likelihood даёт \(E(\vb{w})\)), как узнать наклон (backpropagation), как шагать (gradient descent). Перцептрон — тот же рецепт в миниатюре.
Что посмотреть и почитать
-
Perceptron Visualizer
Jason Hand
Тот же тренажёр, но точки ставишь сам. Три задания: два чистых облака (посчитай исправления), те же облака вплотную друг к другу (исправлений обычно больше), четыре угла XOR (прямая не успокоится).
-
The Perceptron
Kilian Weinberger, Cornell CS4780
Доказательство теоремы сходимости в две строки и оценка числа исправлений. Там метки обозначены \(y\), а learning rate равен 1; на сходимость это не влияет.
-
Hebbian theory
Wikipedia
Что Хебб постулировал на самом деле. В учебниках «Hebbian learning» из этого курса называют perceptron learning rule, а настоящее правило Хебба работает без учителя; в варианте Оя оно сходится к первой главной компоненте из PCA. На экзамене пользуйся названием профессора.
-
ChatGPT is made from 100 million of these [The Perceptron]
Welch Labs≈ 24 мин
Машина Розенблатта, её правило обучения и путь от него к backpropagation. Хорошо смотрится именно сейчас, как фильм по всей главе.
-
MIT Introduction to Deep Learning (2025), 6.S191
Alexander Amini≈ 1 ч 10 мин
Вся глава 2 за одну лекцию: перцептрон, сеть, функции ошибки, gradient descent, backpropagation. Повторение перед экзаменом на языке экзамена.