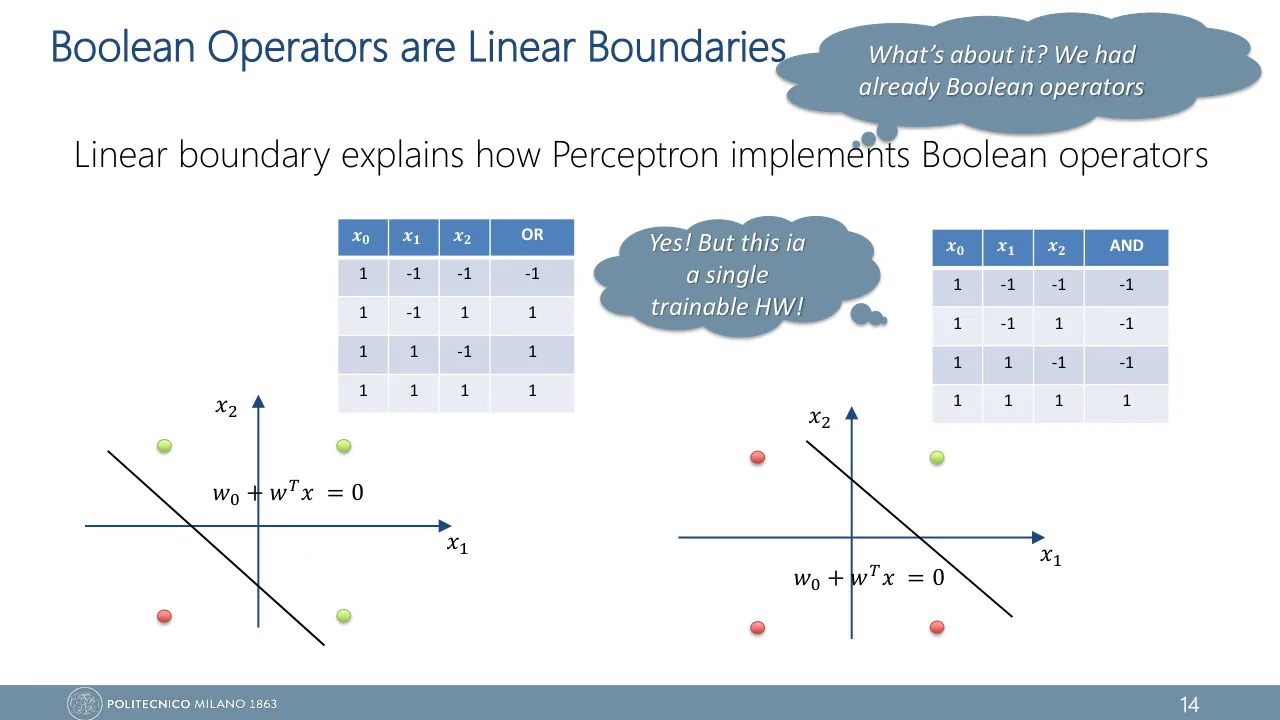
На слайде 14 лекции 2 у профессора спор в двух облачках. Первое: ну и что, булевы операторы у нас и так были. Второе: да, но теперь это одна обучаемая железка — a single trainable HW, то есть hardware. Суть не в том, что нейрон умеет AND. Суть в том, что одно и то же устройство становится AND, OR или NAND, если поменять три числа. А числа можно подбирать автоматически — этим займётся следующий урок.
Один нейрон — одна прямая
После этого урока ты по трём числам \(w_0, w_1, w_2\) нарисуешь прямую, которой нейрон делит плоскость, подберёшь веса под AND, OR и NOT и скажешь, что на этой картинке делает каждый вес.
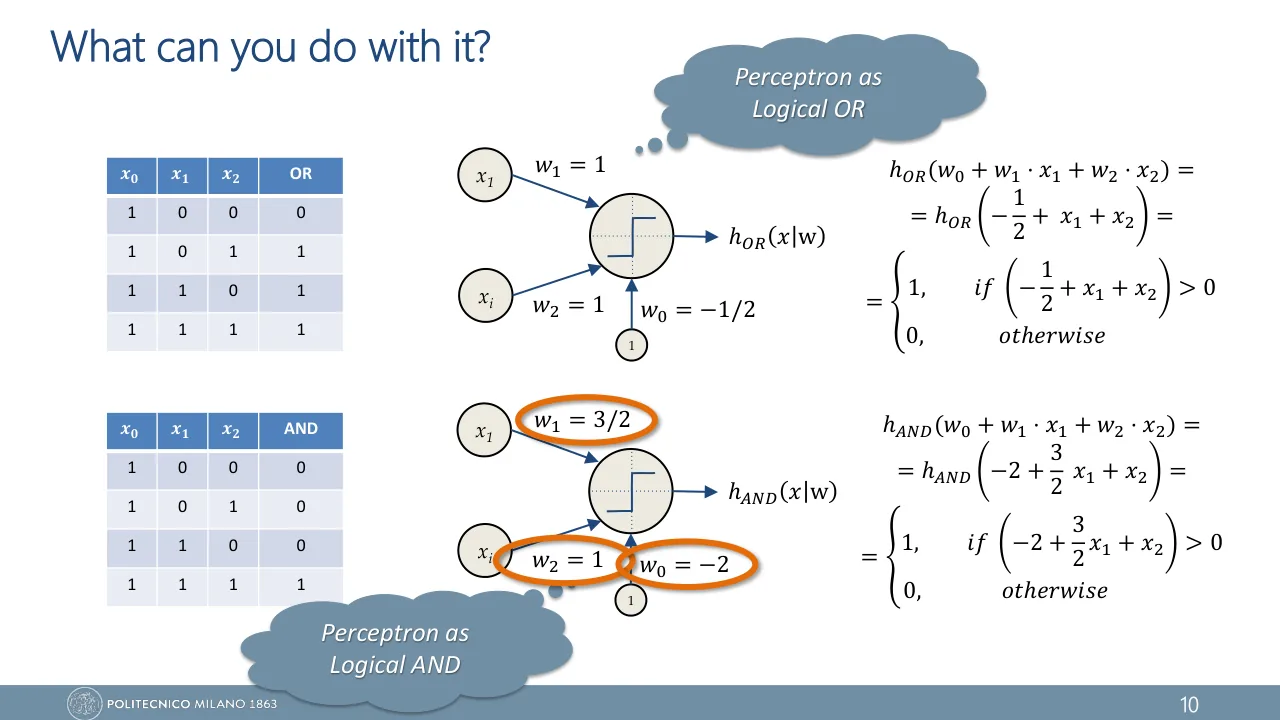
На слайде 10 лекции 2 профессор делает из одного нейрона логический AND и обводит оранжевым три числа: \(w_0 = -2\), \(w_1 = 3/2\), \(w_2 = 1\). В конспекте на стр. 45 для того же AND записано другое: \(w_1 = 1\), \(w_2 = 1\), \(b = -1.5\). На следующей странице там же третий вариант: \(1.5\), \(1.5\) и \(-2.0\).
Три разных ответа на один вопрос. Кто ошибся?
Никто. Правильных ответов здесь бесконечно много, и это не небрежность, а главное свойство нейрона. Чтобы его увидеть, нужно перестать читать веса как три отдельных числа и начать читать их как одну прямую на плоскости.
Три числа и ступенька
В прошлом уроке нейрон собрался из трёх деталей: взвешенная сумма входов, порог и решение «сработать или нет». Порог потом спрятали внутрь суммы: с обратным знаком он стал весом \(w_0\) при входе, который всегда равен 1. Перцептрон (perceptron) — это один такой нейрон и больше ничего. Самая маленькая нейронная сеть из возможных.
Посмотри на него в работе. На рис. 1 нейрон со слайда 10 лекции 2, на вход подали пару \((x_1, x_2) = (1, 0)\).
Действий два. Сначала нейрон считает взвешенную сумму \(a\): её называют activation. Потом смотрит на знак: сумма больше нуля — на выходе 1, иначе 0. На рисунке получилось так:
\[ a = -2 + \tfrac{3}{2}\cdot 1 + 1 \cdot 0 = -0.5 \]Перцептрон (perceptron) — один нейрон: взвешенная сумма входов вместе с bias \(w_0\), пропущенная через пороговую функцию (step function). Его параметры — веса \(w_1, \dots, w_I\) и \(w_0\).
\[ a = w_0 + w_1 x_1 + \dots + w_I x_I \]
\[ h(\vb{x} \mid \vb{w}) = \begin{cases} 1, & a \gt 0 \\ 0, & \text{иначе} \end{cases} \]
- \(x_i\)
- входы, \(i = 1, \dots, I\)
- \(w_i\)
- веса: сколько «голосов» у входа \(i\)
- \(w_0\)
- bias (смещение): вес постоянного входа \(x_0 = 1\)
- \(a\)
- activation: число до ступеньки; дальше в конспекте оно же названо net input. Коротко \(a = \vb{w}\T\vb{x}\), если дописать к входам \(x_0 = 1\)
- \(h(\vb{x} \mid \vb{w})\)
- выход перцептрона. Сама ступенька \(h\) называется activation function
Одни и те же вещи в двух источниках названы по-разному. Конспект пишет \(a = \vb{w}\T\vb{x} + b\) и выход \(y\). Профессор пишет \(w_0\) вместо \(b\) и \(h(\vb{x} \mid \vb{w})\) вместо \(y\). Буква \(t\) у него занята под target: это правильный ответ из таблицы, а не то, что выдал нейрон. В курсе везде запись профессора — её ты увидишь на экзамене.
Перцептрон — это взвешенная сумма и ступенька; всё, что в нём можно настроить, — числа \(w_0, w_1, \dots, w_I\).
Один нейрон, разные вентили
Что умеет такой нейрон? Проще всего проверить на логических функциях. Входы 0 или 1, ответ 0 или 1, разных входов всего четыре — всё помещается в таблицу, и сразу видно, справился нейрон или нет.
Представь совет из двух человек. У каждого один голос: \(w_1 = w_2 = 1\). Решение принято, если голосов «за» больше кворума. Кворум 0.5 — хватит одного голоса: получился OR. Кворум 1.5 — нужны оба: получился AND. Совет тот же, поменялся только кворум. Кворум с обратным знаком — это и есть \(w_0\).
Профессор на слайде 10 лекции 2 берёт для OR именно такой совет, а для AND — кривой: у первого входа полтора голоса. Именно эти три числа у него обведены.
| \(x_1\) | \(x_2\) | OR: \(-\tfrac12 + x_1 + x_2\) | AND: \(-2 + \tfrac32 x_1 + x_2\) |
|---|---|---|---|
| 0 | 0 | \(-0.5 \Rightarrow 0\) | \(-2 \Rightarrow 0\) |
| 0 | 1 | \(+0.5 \Rightarrow 1\) | \(-1 \Rightarrow 0\) |
| 1 | 0 | \(+0.5 \Rightarrow 1\) | \(-0.5 \Rightarrow 0\) |
| 1 | 1 | \(+1.5 \Rightarrow 1\) | \(+0.5 \Rightarrow 1\) |
«Красивые» одинаковые веса необязательны. Важно одно: в каждой строке сумма оказалась по нужную сторону от нуля. Отсюда рецепт, которого в конспекте нет, а на экзамене он экономит время.
Как подобрать веса без подсказки: строка таблицы — одно неравенство
-
Выход равен 1 только при \(a \gt 0\). Значит, для строки с ответом 1 нужна положительная сумма, для строки с ответом 0 — сумма не больше нуля.
\[ a = w_0 + w_1 x_1 + w_2 x_2 \] -
Четыре строки AND дают четыре неравенства на веса:
\[ \begin{aligned} (0,0):&\quad w_0 \le 0 \\ (0,1):&\quad w_0 + w_2 \le 0 \\ (1,0):&\quad w_0 + w_1 \le 0 \\ (1,1):&\quad w_0 + w_1 + w_2 \gt 0 \end{aligned} \] -
Веса входов назначь любые положительные, например \(w_1 = w_2 = 1\). Вторая и третья строки дают \(w_0 \le -1\), четвёртая — \(w_0 \gt -2\):
\[ -2 \lt w_0 \le -1 \] -
Годится любое число из промежутка. Конспект берёт середину, \(w_0 = -1.5\): тогда ни одна сумма не окажется ровно на нуле.
\[ a = -1.5,\ \ {-0.5},\ \ {-0.5},\ \ {+0.5} \] -
Тот же приём для весов профессора \(w_1 = \tfrac32\), \(w_2 = 1\): третья строка даёт \(w_0 \le -\tfrac32\), четвёртая — \(w_0 \gt -\tfrac52\). Он взял \(-2\): снова середину.
\[ -\tfrac{5}{2} \lt w_0 \le -\tfrac{3}{2} \]
Остальные вентили получаются так же. NOT — вентиль с одним входом: \(w_1 = -1\), \(w_0 = 0.5\). Вход 0 даёт \(a = 0.5\) и выход 1, вход 1 даёт \(a = -0.5\) и выход 0. Отрицательный вес — это голос «против».
NAND получается из AND, если поменять знак у всех трёх весов: \((w_0, w_1, w_2) = (1.5, -1, -1)\). Суммы станут \(1.5,\ 0.5,\ 0.5,\ {-0.5}\), и все четыре ответа перевернутся. Трюк работает, пока ни одна сумма не равна нулю.
А какие веса дадут NOR — «ни один вход не включён»? Сначала реши без подсказки.
Проверить себя
Переверни OR со слайда: \((w_0, w_1, w_2) = (0.5, -1, -1)\). Суммы \(0.5,\ {-0.5},\ {-0.5},\ {-1.5}\) — единица только на входе (0, 0).
Из таблицы — на плоскость
Теперь та же таблица, но картинкой. Два входа — две координаты. Четыре строки — четыре точки в углах квадрата. Угол, где нейрон отвечает 1, рисуем синим кружком, где 0 — оранжевым крестиком.
До: \(w_0 = -0.5\) — OR
После: \(w_0 = -1.5\) — AND
Между кружками и крестиками каждый раз проходит прямая. Это не украшение. Прямая — это все входы, на которых нейрон стоит ровно на грани: \(a = 0\).
Decision boundary (разделяющая граница) — множество входов, на которых activation равна нулю: \(w_0 + w_1x_1 + \dots + w_Ix_I = 0\). По одну сторону от неё \(a \gt 0\) и выход 1, по другую \(a \lt 0\) и выход 0.
Для двух входов граница — прямая, для трёх — плоскость, для одного — точка на числовой оси. Общее слово — hyperplane (гиперплоскость): плоская граница, которая делит пространство входов на две половины. Модель, которая решает по тому, с какой стороны от гиперплоскости лежит точка, называется linear classifier. Перцептрон — именно такая модель.
Сравни с линейной регрессией из Applied Statistics. Там выражение \(w_0 + w_1x_1 + \dots\) и есть ответ модели. Здесь от того же выражения берут только знак. Поэтому слово linear относится к границе, а не к выходу: выход у перцептрона — ступенька.
Отсюда же ограничение, которым конспект заканчивает свою таблицу на стр. 52: перцептрон справляется только с данными, которые делятся одной гиперплоскостью (linearly separable). Что бывает, когда так разделить нельзя, — в уроке 8.
Как нарисовать прямую по трём числам
-
Граница там, где сумма равна нулю. Для двух входов:
\[ w_0 + w_1 x_1 + w_2 x_2 = 0 \] -
Оставим слева только слагаемое с \(x_2\):
\[ w_2 x_2 = -w_0 - w_1 x_1 \] -
Разделим на \(w_2\) (если \(w_2 \ne 0\)). Получилась школьная прямая «сдвиг плюс наклон на икс»:
\[ x_2 = -\frac{w_0}{w_2} - \frac{w_1}{w_2}\,x_1 \]Наклон \(-w_1/w_2\) зависит только от весов входов. \(w_0\) в наклон не входит.
-
Рисовать быстрее всего по двум точкам на осях. Подставь \(x_1 = 0\), потом \(x_2 = 0\):
\[ x_2 = -\frac{w_0}{w_2}, \qquad x_1 = -\frac{w_0}{w_1} \] -
AND со слайда 10 лекции 2: \(w_0 = -2\), \(w_1 = \tfrac32\), \(w_2 = 1\). Точки на осях — \((0,\ 2)\) и \((\tfrac43,\ 0)\), сама прямая:
\[ x_2 = 2 - \tfrac{3}{2}\,x_1 \]
Прямая нарисована — осталось понять, с какой стороны ответ 1. Подставь начало координат: \(a(0, 0) = w_0\). Если \(w_0 \lt 0\), точка (0, 0) лежит на стороне ответа 0, и единицы — по другую сторону. Если \(w_0 \gt 0\) — наоборот. При \(w_0 = 0\) прямая проходит через само начало координат: возьми для проверки любую другую точку.
При \(w_2 = 0\) формула для \(x_2\) не работает: тогда граница вертикальная, \(x_1 = -w_0/w_1\).
Пример из конспекта (стр. 52–53): \(w_1 = w_2 = 1\), \(w_0 = -1.2\). Прямая \(x_2 = 1.2 - x_1\), на осях точки (0, 1.2) и (1.2, 0). Для точки (1, 1) сумма равна \(0.8 \gt 0\), выход 1. Для (0.5, 0.5) сумма \(-0.2\), выход 0. Для (0.6, 0.6) сумма ровно 0: точка лежит на границе. На рис. 3 конспекта цвета обратные нашим: класс 1 там оранжевый, класс 0 синий.
Почему границей называют \(a = 0\), если при \(a = 0\) нейрон отвечает 0?
Потому что это два разных вопроса. Геометрически прямая \(a = 0\) — место, где ответ переключается: она не принадлежит ни одной из половин. Но выдать что-то нужно и там, поэтому формула со слайда 10 лекции 2 назначает границе ответ 0. Это соглашение на случай ничьей (tie-breaking), а не свойство геометрии. У функции Sign со слайда 12 лекции 2 соглашение другое: ровно на границе она возвращает 0 — «не определился».
Поменять числа, не поменяв вентиль, можно двумя разными способами. Оба проверяются в виджете.
Умножить все три веса на одно положительное число. \((-1.5, 1, 1)\) и \((-3, 2, 2)\) — это одно уравнение границы, умноженное на 2.
Прямая та же, знаки всех сумм те же, ответы те же. Меняются только сами суммы: они тоже удваиваются.
Взять другую прямую, которая делит четыре точки так же. \((-1.5, 1, 1)\) и \((-2, \tfrac32, 1)\) — прямые с разным наклоном.
Обе отделяют угол (1, 1) от трёх остальных — этого достаточно.
«Нужно найти те самые правильные веса». Таких нет. Каждому вентилю подходит целая область троек \((w_0, w_1, w_2)\). Если на экзамене просят привести веса для AND, годится любая тройка из этой области. Если дают готовые веса, не сравнивай их с заученными: посчитай четыре суммы и посмотри на знаки.
Что делает стрелка w и что делает w₀
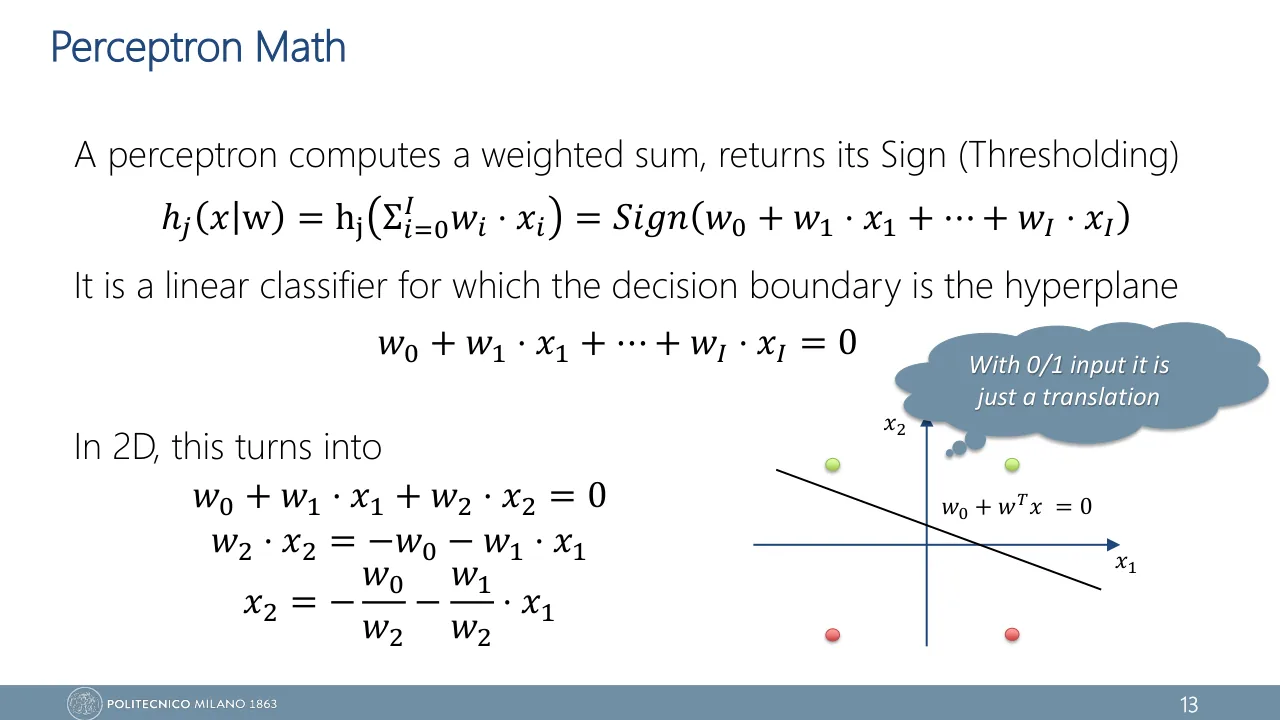
До сих пор три веса были равноправны. На картинке у них разные роли. Чтобы их увидеть, вынем \(w_0\) из вектора обратно: дальше \(\vb{w} = (w_1, w_2)\) — стрелка на плоскости, а \(w_0\) — отдельное число. Профессор на слайде 13 лекции 2 делает так же и подписывает границу \(w_0 + \vb{w}\T\vb{x} = 0\).
Возьми \(\vb{w} = (1, 1)\) и посчитай в разных точках плоскости сумму \(\vb{w}\T\vb{x} = x_1 + x_2\). Точки с одинаковой суммой выстраиваются в прямую. Разным значениям суммы отвечают параллельные прямые — получается лесенка.
На рис. 4 видно сразу две вещи. Стрелка \(\vb{w}\) идёт поперёк лесенки, в сторону, где сумма растёт. А \(w_0\) только выбирает, какая из ступенек станет границей: та, где \(\vb{w}\T\vb{x} = -w_0\). Лесенка при этом не поворачивается — её направление целиком задал \(\vb{w}\).
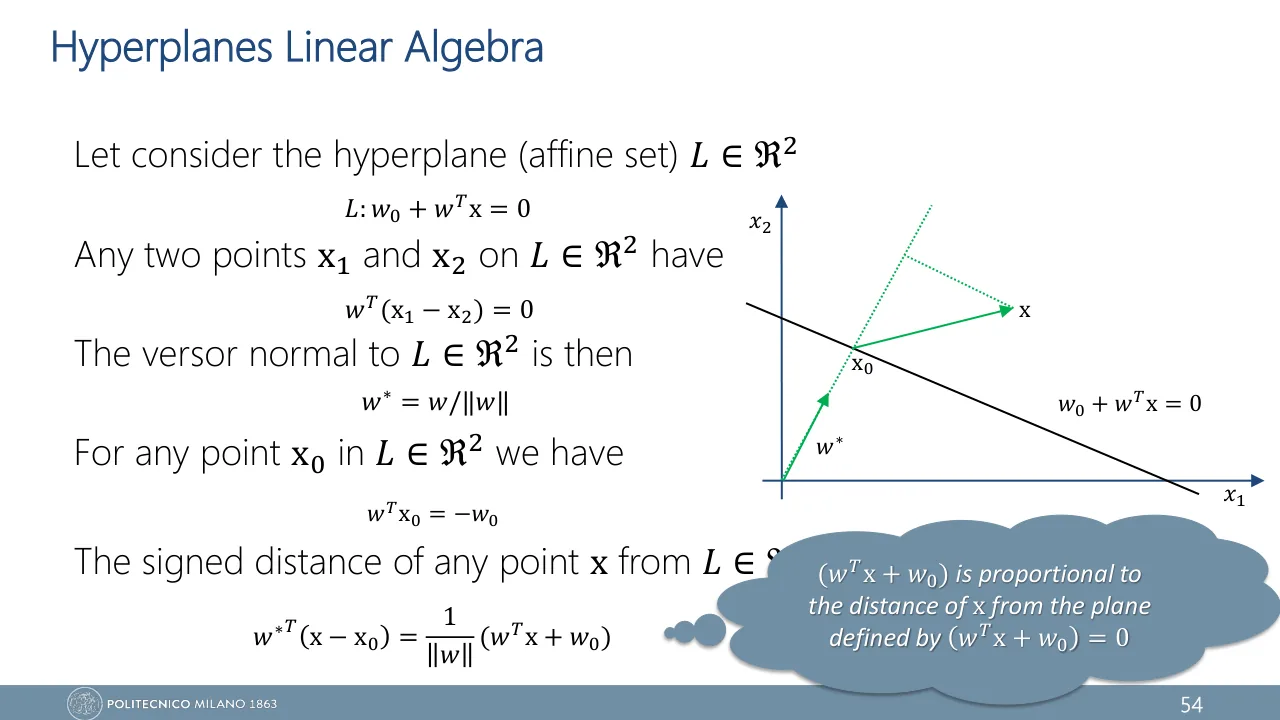
Теперь то же самое аккуратно, для любого \(\vb{w}\). Первые два шага — это слайд профессора про гиперплоскости (Hyperplanes Linear Algebra, в конце лекции 2); остальные три достраивают картину.
-
Возьмём две любые точки \(\vb{u}\) и \(\vb{v}\) на границе. Обе обнуляют сумму:
\[ \begin{aligned} w_0 + \vb{w}\T\vb{u} &= 0 \\ w_0 + \vb{w}\T\vb{v} &= 0 \end{aligned} \] -
Вычтем одно из другого — \(w_0\) сокращается:
\[ \vb{w}\T(\vb{u} - \vb{v}) = 0 \]Вектор \(\vb{u} - \vb{v}\) лежит вдоль границы. Скалярное произведение равно нулю, значит, \(\vb{w}\) перпендикулярен границе.
-
В какую из двух сторон он смотрит? Шагнём с границы вдоль \(\vb{w}\) на маленькое \(\varepsilon \gt 0\) и посчитаем сумму в новой точке:
\[ \begin{aligned} a &= w_0 + \vb{w}\T(\vb{u} + \varepsilon\vb{w}) \\ &= \underbrace{w_0 + \vb{w}\T\vb{u}}_{=\,0} + \varepsilon\,\vb{w}\T\vb{w} \\ &= \varepsilon\,\norm{\vb{w}}^2 \gt 0 \end{aligned} \]Сумма стала положительной: \(\vb{w}\) показывает на сторону ответа 1.
-
Где стоит граница? Пойдём из начала координат вдоль \(\vb{w}\): точка \(\vb{x} = s\,\vb{w}/\norm{\vb{w}}\) удалена от начала на \(s\) (при \(s \lt 0\) — в сторону, обратную стрелке), и для неё \(\vb{w}\T\vb{x} = s\,\norm{\vb{w}}\). Подставим в уравнение границы:
\[ w_0 + s\,\norm{\vb{w}} = 0 \quad\Rightarrow\quad s = -\frac{w_0}{\norm{\vb{w}}} \] -
Итог: \(\vb{w}\) задаёт ориентацию границы, а число \(-w_0/\norm{\vb{w}}\) — её сдвиг от начала координат вдоль \(\vb{w}\). Для примера из конспекта, \(\vb{w} = (1, 1)\) и \(w_0 = -1.2\):
\[ s = \frac{1.2}{\sqrt{2}} \approx 0.85 \]
Удобно представлять границу забором, к которому прибит указатель \(\vb{w}\). Указатель всегда торчит из забора под прямым углом и показывает на поле «да». \(w_0\) решает, как далеко забор отнесён от начала координат, — и больше ничего.
«Вектор \(\vb{w}\) направлен вдоль границы». Нет, поперёк. В таблице на стр. 52 конспекта сказано, что \(\vb{w}\) задаёт direction гиперплоскости, — читай это как «ориентацию»: сам вектор в границе не лежит. Там же написано, что вдоль \(\vb{w}\) растёт выход. Растёт сумма \(a\); выход — ступенька, он только перескакивает с 0 на 1.
Умножение всех весов на \(c \gt 0\) не меняет ни границу, ни ответы; на \(c \lt 0\) — оставляет границу на месте и меняет ответы по обе стороны от неё на противоположные.
0/1 или −1/+1: та же картинка, другие подписи
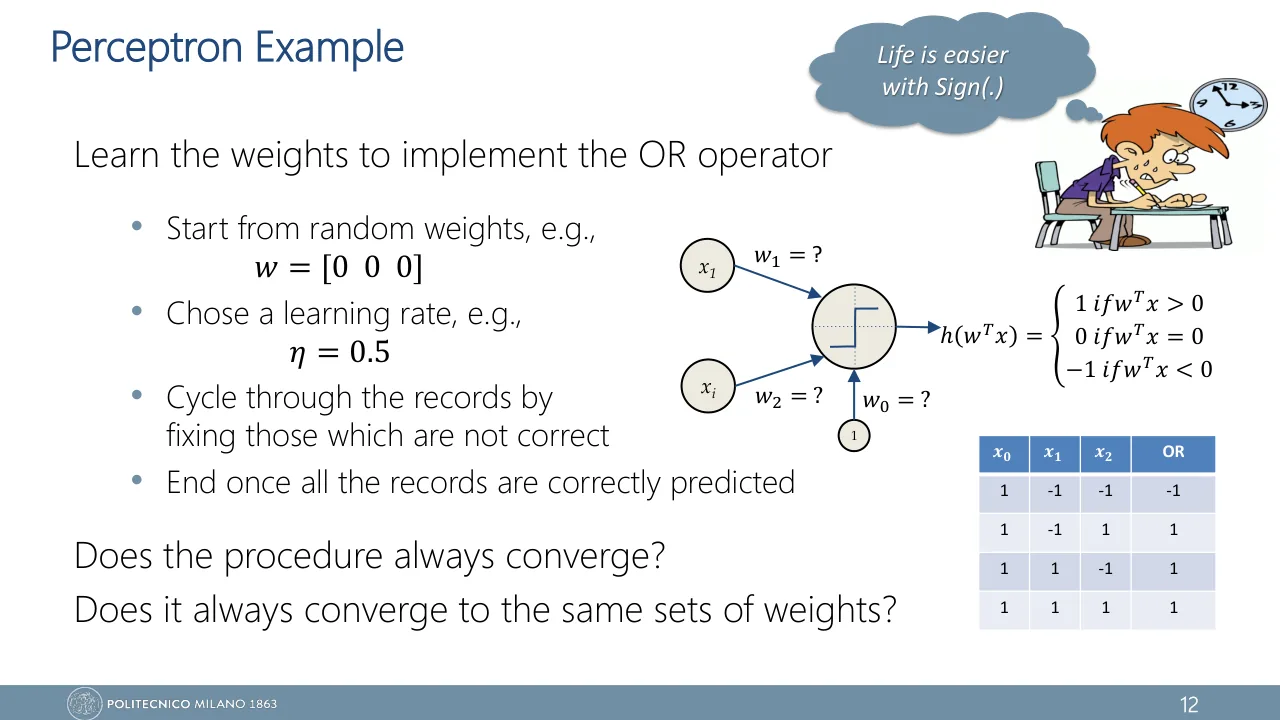
На слайде 10 лекции 2 входы и ответы — нули и единицы. Со слайда 12 профессор пишет те же таблицы через \(-1\) и \(+1\): «ложь» стала \(-1\), «истина» \(+1\). Вместе с кодировкой меняется и ступенька.
Входы и target равны 0 или 1.
\(h = 1\) при \(a \gt 0\), иначе \(h = 0\). Ничья \(a = 0\) отдана нулю.
Входы и target равны \(-1\) или \(+1\).
\(h = \operatorname{Sign}(a)\): \(+1\) при \(a \gt 0\), \(-1\) при \(a \lt 0\) и \(0\) при \(a = 0\).
У Sign на слайде три значения. Ноль выпадает только ровно на границе и означает «не определился»: он не равен ни одному из двух target.
0/1: начало координат в углу
−1/+1: начало координат в центре
Геометрически ничего не произошло. Замена \(x = 2x' - 1\) (штрихом помечены старые входы 0/1) растягивает квадрат вдвое и ставит его центром в начало координат. Профессор на слайде 13 говорит об этом одной фразой: с входами 0/1 это just a translation. Из Applied Statistics это знакомо как стандартизация столбца: вычесть среднее 0.5, поделить на стандартное отклонение 0.5. Числа меняются, взаимное расположение точек — нет.
А вот сами веса под новую кодировку нужно пересчитать.
-
Нейрон работает с входами \(\pm 1\) и считает сумму
\[ a = w_0 + w_1 x_1 + w_2 x_2 \] -
Подставим \(x_i = 2x'_i - 1\), чтобы выразить ту же сумму через входы 0/1:
\[ \begin{aligned} a = w_0 &+ w_1(2x'_1 - 1) \\ &+ w_2(2x'_2 - 1) \end{aligned} \] -
Раскроем скобки и соберём отдельно числа и слагаемые с входами:
\[ \begin{aligned} a = (w_0 &- w_1 - w_2) \\ &+ 2w_1 x'_1 + 2w_2 x'_2 \end{aligned} \] -
Это снова перцептрон, только с другими весами:
\[ w'_i = 2w_i, \qquad w'_0 = w_0 - \sum_i w_i \] -
Проверка. В кодировке \(\pm 1\) OR задают веса \((w_0, w_1, w_2) = (0.5, 0.5, 0.5)\): суммы \(-0.5,\ 0.5,\ 0.5,\ 1.5\). Пересчитаем: \(w'_1 = w'_2 = 1\), \(w'_0 = 0.5 - 1 = -0.5\). Получился ровно OR со слайда 10.
\[ (0.5,\ 0.5,\ 0.5) \;\longrightarrow\; (-0.5,\ 1,\ 1) \]
Теперь AND. На входах \(\pm 1\) его задаёт, например, тройка \((-0.5,\ 0.5,\ 0.5)\) в том же порядке \(w_0, w_1, w_2\): суммы \(-1.5,\ {-0.5},\ {-0.5},\ 0.5\). Их прямая \(x_1 + x_2 = 1\) отрезает угол \((+1, +1)\) — так AND нарисован на слайде 14. Во что эти веса превратятся на входах 0/1? Сначала пересчитай по формуле из четвёртого шага.
Проверить себя
\(w'_1 = w'_2 = 2 \cdot 0.5 = 1\), \(w'_0 = -0.5 - 0.5 - 0.5 = -1.5\). Получилась тройка \((-1.5,\ 1,\ 1)\) — AND из конспекта со стр. 45.
«Веса от кодировки не зависят». Зависят. \((0.5, 0.5, 0.5)\) — это OR на входах \(\pm 1\). На входах 0/1 те же числа дают суммы \(0.5,\ 1,\ 1,\ 1.5\), и нейрон отвечает 1 всегда. Прежде чем проверять веса на экзамене, посмотри, в какой кодировке дана таблица.
Зачем вообще понадобились −1 и +1?
Для рисования вентилей разницы нет. Разница появится в уроке 7: правило обучения умножает поправку к весу на target, и при target, равном нулю, поправка обнулялась бы. На слайде 12 лекции 2 это сказано так: с Sign жить проще.
Так кто прав про AND
Вернёмся к трём ответам из начала урока. Нарисуй каждую тройку по рецепту с двумя точками на осях — получатся три прямые.
| Откуда | \((w_0, w_1, w_2)\) | Граница | На осях |
|---|---|---|---|
| стр. 45 | \((-1.5,\ 1,\ 1)\) | \(x_1 + x_2 = 1.5\) | 1.5 и 1.5 |
| стр. 46 | \((-2,\ 1.5,\ 1.5)\) | \(x_1 + x_2 = \tfrac43\) | \(\tfrac43\) и \(\tfrac43\) |
| слайд 10 лекции 2 | \((-2,\ \tfrac32,\ 1)\) | \(\tfrac32 x_1 + x_2 = 2\) | \(\tfrac43\) и 2 |
Прямые разные: у двух одинаковый наклон и разный сдвиг, у третьей другой наклон. Но все три лежат в зазоре между углом (1, 1) и тремя остальными углами, и у всех трёх стрелка \(\vb{w}\) смотрит на (1, 1). Для четырёх точек AND этого достаточно.
Вентиль — это не тройка чисел, а положение прямой относительно точек. Подходящих прямых в зазоре бесконечно много, и каждую можно записать бесконечным числом троек, умножая уравнение на положительное число. Поэтому никто не ошибся: и профессор, и конспект просто выбрали по одной точке из огромной области подходящих весов.
Из этого следует вещь поважнее. Раз подходящих весов целая область, их необязательно угадывать. Можно начать с любых и двигать прямую, пока все точки не окажутся на своих сторонах.
В формате экзамена
A perceptron has two inputs in \(\{0, 1\}\) and the step activation function \(h(a) = 1\) if \(a \gt 0\), \(0\) otherwise. (a) Give weights \((w_0, w_1, w_2)\) that implement the logical OR and the logical AND, and verify them. (b) Are these weights unique? Explain why.
Show model answer
(a) OR: \(w_0 = -\tfrac12,\ w_1 = 1,\ w_2 = 1\). On (0,0), (0,1), (1,0), (1,1) the weighted sum is \(-0.5,\ 0.5,\ 0.5,\ 1.5\), so the output is 0, 1, 1, 1.
AND: \(w_0 = -2,\ w_1 = \tfrac32,\ w_2 = 1\). The sums are \(-2,\ {-1},\ {-0.5},\ 0.5\), so the output is 0, 0, 0, 1.
(b) No. The output depends only on the side of the decision boundary \(w_0 + w_1x_1 + w_2x_2 = 0\) on which each of the four points lies. Multiplying all three weights by any \(c \gt 0\) gives the same boundary and the same outputs. Moreover, any other line that separates the same points works as well, e.g. AND is also implemented by \((-1.5, 1, 1)\).
В полном ответе две вещи: посчитаны все четыре строки и названы обе причины неединственности — масштаб и другая разделяющая прямая. Фраза «потому что есть много решений» без объяснения ничего не доказывает.
A perceptron has weights \(w_0 = -2\), \(w_1 = 3/2\), \(w_2 = 1\). At which value of \(x_1\) does its decision boundary cross the \(x_1\) axis?
Show model answer
On the \(x_1\) axis \(x_2 = 0\), so the boundary equation becomes
\[ -2 + \tfrac{3}{2}x_1 = 0 \] \[ x_1 = -\frac{w_0}{w_1} = \frac{4}{3} \approx 1.33 \]Типичные ошибки: поделить на \(w_2\) вместо \(w_1\) (получится 2 — это точка на другой оси) или потерять минус.
Inputs are in \(\{0, 1\}\), the output is 1 if and only if \(a = w_0 + w_1x_1 + w_2x_2 \gt 0\). Which weight vectors \((w_0, w_1, w_2)\) implement the logical AND? Select all that apply.
Show model answer
The first three. For each candidate compute \(a\) on the four inputs and compare its sign with the AND table. \((-4.5, 3, 3) = 3 \cdot (-1.5, 1, 1)\) defines the same boundary. \((1.5, -1, -1)\) is NAND, \((-0.5, 1, 1)\) is OR, and \((-2, 1, 1)\) gives \(a = 0\) on (1,1), which is not \(\gt 0\).
Ловушка — последний вариант: при \(a = 0\) выход равен 0. Строгое неравенство в условии написано не для красоты.
For the perceptron with \(\vb{w} = [1,\ 1]\) and \(w_0 = -1.2\), compute the distance of the decision boundary from the origin.
Show model answer
The boundary is \(x_1 + x_2 = 1.2\). The point of the boundary closest to the origin lies along \(\vb{w}\) at
\[ s = -\frac{w_0}{\lVert \vb{w} \rVert} = \frac{1.2}{\sqrt{2}} \approx 0.85 \](the point \((0.6,\ 0.6)\)).
Ответ 1.2 — это точка на оси, а не расстояние: забыли поделить на \(\norm{\vb{w}} = \sqrt2\).
Explain why a perceptron is called a linear classifier. What are the geometric roles of the weight vector \(\vb{w}\) and of the bias \(w_0\)? What happens to the decision boundary and to the outputs if all the weights, bias included, are multiplied by \(-1\)?
Show model answer
The output depends only on the sign of \(a = w_0 + \vb{w}\T\vb{x}\), i.e. on which side of the hyperplane \(w_0 + \vb{w}\T\vb{x} = 0\) the input lies. The boundary is linear (a line in 2D: \(x_2 = -\tfrac{w_0}{w_2} - \tfrac{w_1}{w_2}x_1\)), although the output itself is a step.
\(\vb{w}\) is normal to the boundary: for two boundary points \(\vb{w}\T(\vb{u} - \vb{v}) = 0\); it points towards the region where \(a \gt 0\). The bias translates the boundary parallel to itself: its offset from the origin along \(\vb{w}\) is \(-w_0/\lVert\vb{w}\rVert\); it does not change the slope.
Multiplying everything by \(-1\) leaves the equation \(a = 0\), hence the boundary, unchanged, but flips the sign of \(a\) everywhere: the two regions swap (AND becomes NAND).
Вопрос типа «explain why». В полном ответе три пункта: линейна граница, а не выход; \(\vb{w}\) перпендикулярен и смотрит на сторону 1; \(w_0\) сдвигает, но не поворачивает. Формула в 2D и пример AND → NAND показывают, что это понимание, а не пересказ.
A perceptron with inputs in \(\{-1, +1\}\) and weights \((w_0, w_1, w_2) = (0.5,\ 0.5,\ 0.5)\) implements OR. The inputs are recoded as \(x'_i \in \{0, 1\}\), with \(x_i = 2x'_i - 1\), and the weighted sum \(a\) must stay the same for every input. What is the bias \(w'_0\) of the recoded perceptron?
Show model answer
Substitute \(x_i = 2x'_i - 1\):
\[ a = (w_0 - w_1 - w_2) + 2w_1x'_1 + 2w_2x'_2 \]so \(w'_1 = w'_2 = 1\) and \(w'_0 = 0.5 - 0.5 - 0.5 = -0.5\): the OR perceptron of the slides.
Ловушка — перенести веса между кодировками как есть и ответить 0.5. Быстрая самопроверка: у OR на входе (0, 0) должно получиться \(a = w'_0 \le 0\).
Проверь себя
У нейрона \(w_1 = w_2 = 1\). Смещение \(w_0\) уменьшили с \(-0.5\) до \(-1.5\). Что произошло?
Что верно про вектор \(\vb{w} = (w_1, w_2)\)? Отметь все верные утверждения.
Картинка для памяти: указатель, который торчит из забора под прямым углом и смотрит на поле «да».
Тройки \((-2, \tfrac32, 1)\) со слайда 10 лекции 2 и \((-1.5, 1, 1)\) из конспекта обе дают AND. Как они связаны?
\(w_0 = -0.5\), \(w_1 = 1\), \(w_2 = 0\). Как выглядит граница?
\(\vb{w} = (1, -1)\). Смещение \(w_0\) уменьшают от 0 до \(-1.2\). Куда едет граница?
Веса \((w_0, w_1, w_2) = (0.5, 0.5, 0.5)\) реализуют OR на входах \(\pm 1\). Что они вычислят на входах 0/1 со ступенькой «1 при \(a \gt 0\)»?
Нейрон AND со слайда на входе (1, 1) даёт \(a = 0.5\). Все три веса умножили на 10. Что изменилось?
Унести с собой
- Перцептрон считает сумму \(a = w_0 + w_1x_1 + \dots + w_Ix_I\) и пропускает её через ступеньку: 1 при \(a \gt 0\), иначе 0. Сумма \(a\) — это activation, ступенька — activation function.
- Граница \(a = 0\) — гиперплоскость, в двух измерениях прямая. Её рисуют по двум точкам на осях: \(-w_0/w_1\) и \(-w_0/w_2\).
- Булев вентиль — это положение прямой относительно четырёх углов квадрата. OR отрезает угол (0, 0), AND — угол (1, 1), NAND и NOR — те же прямые с перевёрнутыми знаками весов.
- Веса не единственны по двум причинам: уравнение можно умножить на положительное число, и разделяющую прямую можно провести по-другому.
- Вектор \(\vb{w}\) перпендикулярен границе и смотрит на сторону ответа 1. Bias \(w_0\) сдвигает границу вдоль \(\vb{w}\) на \(-w_0/\norm{\vb{w}}\) и не поворачивает её.
- Умножение всех весов на \(-1\) оставляет прямую на месте и меняет ответы на противоположные.
- Кодировки 0/1 и \(\pm 1\) дают одну и ту же картинку с разными осями; веса при переходе пересчитываются.
Что посмотреть и почитать
-
ChatGPT is made from 100 million of these [The Perceptron]
Welch Labsоколо 24 мин
Перцептрон Розенблатта как один прямой разрез пространства входов. Хороший разгон перед уроком: видно, что именно этот блок стоит внутри современных моделей.
-
A Neural Network Playground
Daniel Smilkov, Shan Carter
Выбери набор данных Gaussian, убери все скрытые слои, оставь входы \(x_1\) и \(x_2\). Один нейрон за секунду находит прямую границу — то же, что в Neuron Lab, только веса подбирает машина.
-
Neural networks [1.3]: Capacity of single neuron
Hugo Larochelle8 мин
Что один нейрон может отделить, а что нет, — на таких же картинках с точками и прямой. У Larochelle профессор берёт иллюстрации для слайда про universal approximation, так что стиль ещё встретится.
-
Neural Networks and Deep Learning, chapter 1
Michael Nielsen
Раздел Perceptrons: веса как «вес доводов», порог против bias и перцептрон в роли NAND. Читай после урока, чтобы увидеть те же идеи в другой записи (у Нильсена bias обозначен \(b\)).
-
CS231n: Neural Networks Part 1
Stanford
Короткий раздел «Single neuron as a linear classifier»: как из одного нейрона получается линейный классификатор. Пригодится, когда дойдёшь до сигмоиды в уроке 10.