Первую модель нейрона написали нейрофизиолог, которому было за сорок, и логик-самоучка лет двадцати, одно время живший без дома. Статья называлась «A Logical Calculus of the Ideas Immanent in Nervous Activity», и получилось у них именно логическое устройство: из пороговых элементов собирались AND, OR и NOT. Учиться оно не умело — веса задавались раз и навсегда.
Машина, которая сама крутит ручки
После этого урока ты запишешь модель искусственного нейрона, посчитаешь его ответ руками, превратишь порог в вес \(w_0\), не ошибившись в знаке, и скажешь, кто что придумал между 1943 и 1991 годом.
Июль 1958 года. Военно-морской флот США показывает журналистам пятитонный компьютер IBM 704. В него загружают перфокарты: у одних метка слева, у других справа. Правило «если метка слева, то…» никто не писал. Примерно через 50 попыток машина начинает отличать левые карты от правых сама. На следующий день New York Times пересказывает ожидания флота: такая машина научится ходить, говорить, видеть, писать, воспроизводить себя и осознавать собственное существование.
Вопрос на весь урок: если правило никто не программировал, что именно изменилось в машине за эти 50 попыток? Подсказка — в названии урока. Ответ уместится в одну строчку формулы, и к концу ты сможешь посчитать её руками.
Чего не умел компьютер 1940-х
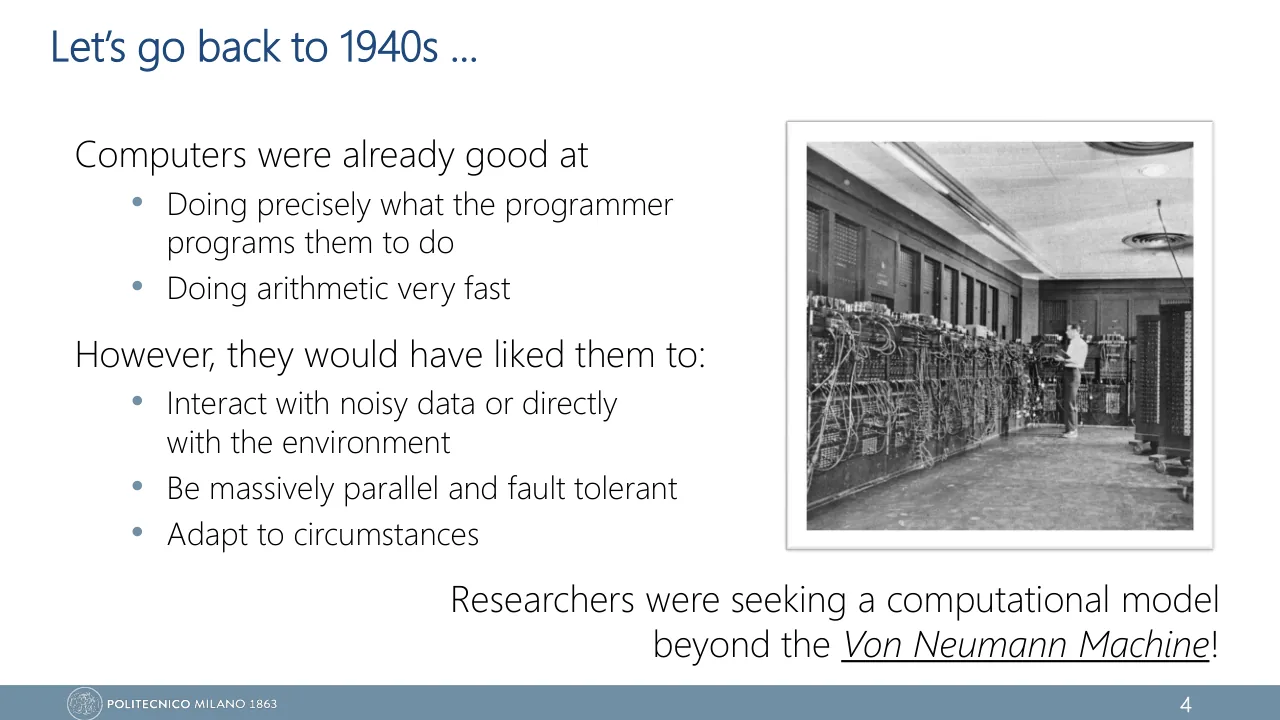
Отмотаем от той демонстрации ещё лет на пятнадцать назад. В 1940-х компьютеры уже есть и уже впечатляют. Слайд 4 лекции 2 называет две вещи, которые им удавались: делать в точности то, что написал программист, и очень быстро считать.
Так устроена машина фон Неймана (Von Neumann machine): процессор достаёт из памяти одну инструкцию за другой и выполняет их по порядку. Память и вычисление разделены, всё идёт последовательно и точно. Для длинных точных расчётов это идеально.
Для задачи «узнать знакомого на зернистой фотографии» — нет. Исследователям не хватало трёх умений. Этот список — готовый ответ на экзаменационное «why»:
- работать с зашумлёнными данными или напрямую с окружающей средой (noisy data, the environment);
- быть массово параллельной и устойчивой к отказам (massively parallel, fault tolerant);
- приспосабливаться к обстоятельствам (adapt to circumstances).
Поэтому на слайде и сказано, что искали вычислительную модель за пределами машины фон Неймана — a computational model beyond the Von Neumann machine. Нужен был не более быстрый процессор, а другой способ считать.
Машина фон Неймана: по очереди
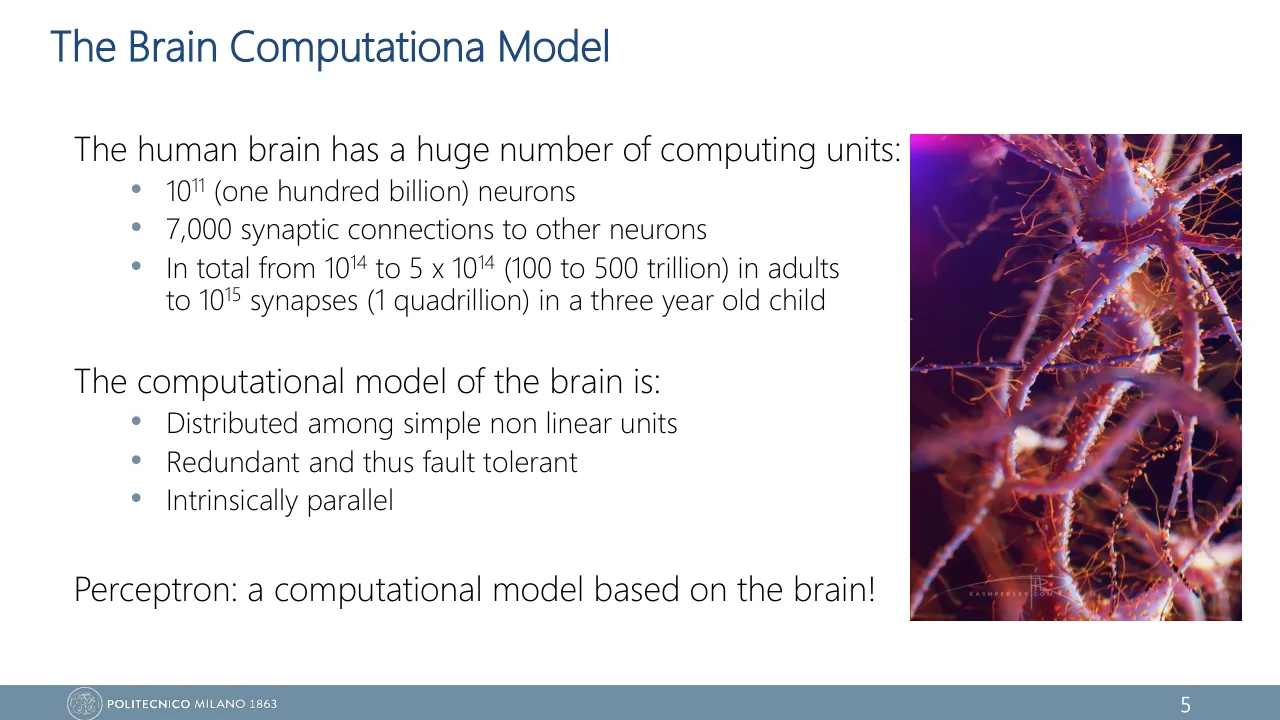
Модель мозга: параллельно и с запасом
Правая картинка нарисована не из головы. Работающий образец такой машины у исследователей был — у каждого свой.
Мозг считает иначе
Числа со слайда 5 лекции 2 входят в экзаменационный материал, поэтому вот они одной таблицей.
| Что считаем | Сколько |
|---|---|
| Нейронов | \(10^{11}\) — сто миллиардов |
| Синаптических связей у одного нейрона | около 7000 |
| Синапсов у взрослого | от \(10^{14}\) до \(5 \times 10^{14}\) |
| Синапсов у трёхлетнего ребёнка | \(10^{15}\) |
Удивляет здесь другое. Нейрон — медленный элемент: он переключается за миллисекунды, а современная цифровая логика — за наносекунды, то есть в миллион раз быстрее. И всё же знакомое лицо мозг узнаёт без труда, а компьютеру 1940-х эта задача не по силам вовсе. Значит, дело не в скорости одного элемента.
Слайд описывает вычислительную модель мозга тремя свойствами:
- Distributed among simple non linear units — вычисление распределено между простыми нелинейными элементами. Центрального процессора нет.
- Redundant and thus fault tolerant — модель избыточна и потому переносит отказы. Понятие хранится не в одном нейроне, и гибель нескольких его не стирает.
- Intrinsically parallel — параллельна по своей природе: тысячи операций идут одновременно.
Конспект добавляет четвёртое свойство — адаптивность: сила синапсов меняется с опытом. Это и есть обучение, и к нему мы вернёмся в конце урока.
Теперь положи рядом два списка: чего хотели от машины и что есть у мозга. На вопрос «why the brain?» отвечает именно эта пара, а не каждый список по отдельности.
| Чего хотели от машины | Что есть у мозга |
|---|---|
| noisy data, the environment | мозг узнаёт знакомое лицо и на зернистом фото: он всё время работает с шумными сигналами прямо из среды |
| massively parallel | intrinsically parallel |
| fault tolerant | redundant and thus fault tolerant |
| adapt to circumstances | сила синапсов меняется с опытом (конспект, стр. 37) |
Оставшееся свойство — distributed among simple non linear units — говорит, из чего такая машина собрана: из множества простых элементов вместо одного сложного. Слайд 5 так и заканчивается: Perceptron: a computational model based on the brain. Оставалось понять, как считает один такой элемент.
Мозг выигрывает не скоростью элемента, а числом элементов, которые работают одновременно.
От живого нейрона к формуле
От биологии слайд 7 лекции 2 оставляет две фразы. Дендриты (dendrites) собирают заряд от синапсов (synapses) — возбуждающих (excitatory) и тормозящих (inhibitory). Когда накопленный заряд переходит порог (threshold), нейрон «срабатывает» (fires): посылает сигнал по аксону дальше.
Получается четыре шага: собрать → сложить → сравнить с порогом → сработать. На рисунке каждому шагу достаётся своя буква.
Биологический нейрон
Искусственный нейрон (слайд 7 лекции 2)
| В биологии | В модели | Буква |
|---|---|---|
| сигналы, приходящие на дендриты | входы | \(x_i\) |
| сила синапса: возбуждающий или тормозящий | вес: положительный или отрицательный | \(w_i\) |
| сома копит заряд | взвешенная сумма | \(\sum w_i x_i\) |
| порог срабатывания | порог | \(b\) |
| сработал или молчит | функция активации | \(h_j(\cdot)\) |
Сначала на примере
Пусть такой нейрон решает за тебя, идти ли завтра на лекцию к 8:15. У него три входа, каждый равен 1 («да») или 0 («нет»), и у каждого свой вес:
- \(x_1\): лекцию не записывают — вес \(w_1 = 2\), сильный довод «за»;
- \(x_2\): друг тоже идёт — вес \(w_2 = 1\), довод послабее;
- \(x_3\): идёт дождь — вес \(w_3 = -1\), довод «против».
Порог \(b = 1.5\): идти, только если доводы в сумме перевешивают полтора. Посчитаем четыре разных утра.
| Утро | \((x_1, x_2, x_3)\) | Взвешенная сумма | Больше 1.5? | Выход |
|---|---|---|---|---|
| не записывают | (1, 0, 0) | \(2\) | да | 1 |
| только друг | (0, 1, 0) | \(1\) | нет | 0 |
| не записывают, но дождь | (1, 0, 1) | \(2 - 1 = 1\) | нет | 0 |
| всё сразу | (1, 1, 1) | \(2 + 1 - 1 = 2\) | да | 1 |
Вес отвечает на вопрос «насколько этот довод важен и в какую сторону он тянет». Порог — на вопрос «сколько доводов нужно, чтобы встать с кровати». Отрицательный вес — это и есть тормозящий синапс.
Теперь формулой
\[ h_j(\vb{x} \mid \vb{w}, b) = h_j\Big(\sum_{i=1}^{I} w_i x_i - b\Big) \]
\[ h_j(a) = \begin{cases} 1, & a \gt 0 \\ 0, & \text{иначе} \end{cases} \]
- \(x_i\)
- входы, их \(I\) штук
- \(w_i\)
- веса (weights): сила и знак каждой связи
- \(b\)
- порог (threshold): планка, которую должна перейти сумма
- \(a\)
- то, что попадает в ступеньку: сумма за вычетом порога
- \(h_j\)
- функция активации (activation function) и заодно выход нейрона номер \(j\)
- \(\mid\)
- черта читается «при данных»: слева от неё вход, справа настройки нейрона
Искусственный нейрон (artificial neuron) — вычислительный элемент, который делает три шага: считает взвешенную сумму входов (integration), вычитает порог (thresholding) и пропускает результат через функцию активации (firing decision).
Ступенька \(h_j\) носит имя Heaviside step function. Вся нелинейность нейрона живёт в ней одной.
Взвешенная сумма знакома по Applied Statistics: это та же линейная комбинация \(\beta_1 x_1 + \dots + \beta_p x_p\), что в линейной регрессии. Удвоишь входы — удвоится сумма. Ступенька так себя не ведёт: она отвечает скачком. Нейрон — это линейная часть плюс нелинейная ступенька. Без ступеньки от него осталась бы обычная линейная модель, та же формула, что у регрессии.
«Искусственный нейрон моделирует настоящий». Нет: от биологии в нём остались только взвешенное суммирование и порог. Импульсов, времени и химии в модели нет. Слово «нейрон» здесь — название математического элемента, а не обещание.
Теперь собери всё руками. Главное, что должно стать очевидным из этого виджета: порог \(b\) и вес \(w_0\) — одна и та же ручка, подписанная с двух сторон с разными знаками.
Порог — тоже ручка
В третьем опыте порог превратился в вес, а нейрон этого «не заметил»: все ответы остались прежними. Разберёмся почему — это самое экзаменационное место урока.
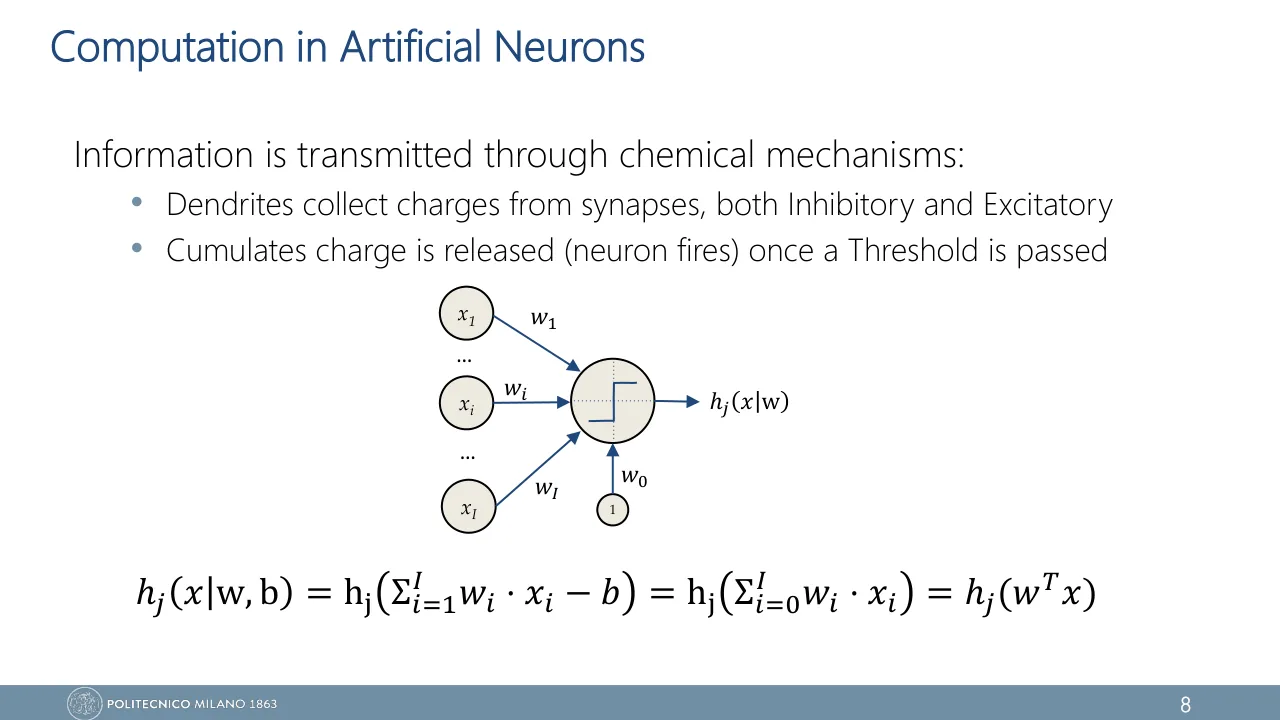
У нейрона пока два вида настроек. Веса стоят при входах, а порог живёт отдельно, внутри сравнения. Для обучения это неудобно: понадобятся два правила — как менять веса и как менять порог. В 1960 году Bernard Widrow в модели ADALINE записал порог как ещё один вес. На слайдах это переход от схемы 7 к схеме 8.
До: порог вычитает отдельный узел (слайд 7 лекции 2)
После: порог — вес при входе «1» (слайд 8 лекции 2)
Вывод по шагам
-
Начнём с того, что нейрон делает буквально: срабатывает, когда взвешенная сумма входов больше порога.
\[ \sum_{i=1}^{I} w_i x_i \gt b \] -
Перенесём порог налево. Неравенство то же самое, но сравниваем теперь с нулём — с числом, которое не надо настраивать.
\[ \sum_{i=1}^{I} w_i x_i - b \gt 0 \] -
Запишем \(-b\) как произведение на единицу. Пока это выглядит бессмысленно.
\[ \sum_{i=1}^{I} w_i x_i + (-b) \cdot 1 \gt 0 \] -
Дадим множителям имена. Единица — это ещё один вход \(x_0\), который включён всегда. Число \(-b\) — его вес \(w_0\).
\[ x_0 \equiv 1, \qquad w_0 \equiv -b \] -
Слагаемое \(w_0 x_0\) устроено так же, как остальные: вес, умноженный на вход. Значит, его можно внести под знак суммы и начать счёт с нуля.
\[ \sum_{i=0}^{I} w_i x_i \gt 0 \] -
Сумма произведений — это скалярное произведение. В обоих векторах теперь по \(I + 1\) компоненте: \(\vb{x} = (1, x_1, \dots, x_I)\) и \(\vb{w} = (w_0, w_1, \dots, w_I)\).
\[ \vb{w}\T\vb{x} \gt 0 \]Проверка на утре «всё сразу»: было \(2 + 1 - 1 = 2 \gt 1.5\), стало \(-1.5 + 2 + 1 - 1 = 0.5 \gt 0\). Оба неравенства верны одновременно.
Целиком это одна строка со слайда 7 лекции 2. Её стоит уметь написать по памяти, со всеми тремя знаками равенства.
\[ h_j(\vb{x} \mid \vb{w}, b) = h_j\Big(\sum_{i=1}^{I} w_i x_i - b\Big) \]
\[ = h_j\Big(\sum_{i=0}^{I} w_i x_i\Big) = h_j(\vb{w}\T\vb{x}) \]
- \(x_0\)
- постоянный вход, всегда равен 1
- \(w_0\)
- bias, равен \(-b\)
- \(\vb{w}\T\vb{x}\)
- скалярное произведение векторов из \(I + 1\) компоненты
Bias (смещение) — вес \(w_0\) постоянного входа \(x_0 = 1\). Он равен порогу с обратным знаком, \(w_0 = -b\), и задаёт склонность нейрона срабатывать «по умолчанию», когда остальные входы равны нулю. Приём с лишним входом называют bias trick.
Знак: порог и bias смотрят в разные стороны
Срабатывает, если \(\sum_{i=1}^{I} w_i x_i \gt b\).
Больше \(b\) — планка выше, сработать труднее.
Срабатывает, если \(\sum_{i=1}^{I} w_i x_i + w_0 \gt 0\).
Больше \(w_0\) — планка ниже, сработать легче.
Определение из конспекта (Definition 2, стр. 40) говорит то же словами. A large positive bias — нейрон срабатывает даже при слабых входах. A large negative bias — ему нужны сильные доводы. И ещё: bias сдвигает ступеньку по горизонтали. На шкале виджета (в схеме слайда 7) это фиолетовая черта: чем больше \(w_0\), тем левее она стоит.
Отсюда правило чтения чужих формул. На слайдах \(b\) — порог, а bias — это \(w_0 = -b\). В конспекте начиная со стр. 40, как и в большинстве учебников, буквой \(b\) называют уже сам bias и пишут \(a = \vb{w}\T\vb{x} + b\). Буква одна, а знаки противоположные.
Увидев \(b\), смотри на знак перед ним. Минус (\(\dots - b\)) — это порог: больше \(b\), труднее сработать. Плюс (\(\dots + b\)) — это bias, то есть наше \(w_0\): больше \(b\), легче сработать.
Зачем вообще прятать порог в вес?
Причин три. Все настройки нейрона оказываются в одном векторе \(\vb{w}\), и сравнение всегда идёт с нулём. Правило обучения становится одно на всех: то же действие, которое меняет \(w_1\), меняет и \(w_0\) — это пригодится в уроке 7. И наконец, выражение \(\vb{w}\T\vb{x}\) удобно дифференцировать. ADALINE этим и пользовалась: она измеряла ошибку по самой сумме, до ступеньки, а сумма, в отличие от ступеньки, меняется плавно. Отсюда прямая дорога к gradient descent (урок 13).
Кто что придумал: 1943–1991
Формула у тебя есть. Теперь разложим по годам, кто какую её часть добавил, — и заодно проверим, правда ли нейросети изобрели недавно. Главное, что должно стать очевидным из шкалы: почти каждая веха закрывает одну дыру, оставленную предыдущими.
Для экзамена из этой шкалы прежде всего нужны три имени со слайда 9 лекции 2 — и то, что нового внёс каждый:
- 1943, Warren McCulloch и Walter Pitts — Threshold Logic Unit (на слайде также Linear Unit). Активация — пороговый элемент, эквивалентный Heaviside step function. По сути это формула из третьего раздела с весами, заданными раз и навсегда. Это модель: обучения в ней нет.
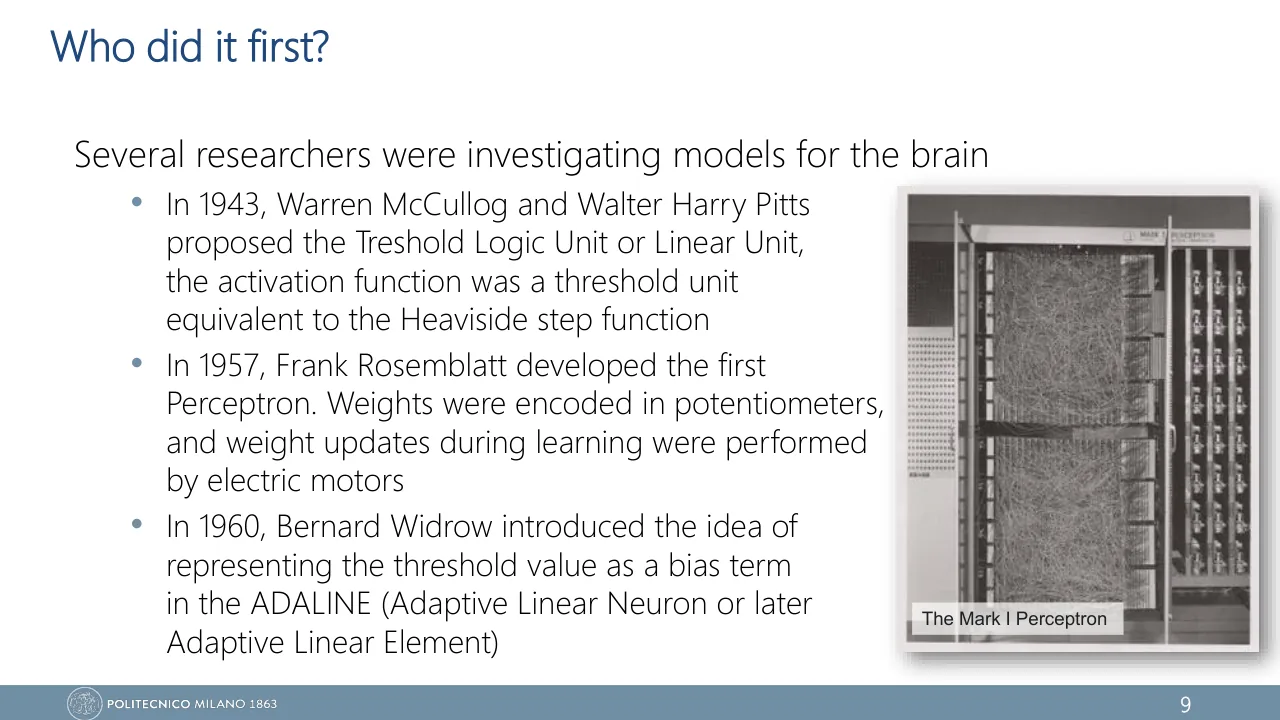
- 1957, Frank Rosenblatt — первый Perceptron. Веса хранятся в потенциометрах, обновляют их электромоторы. Это обучение.
- 1960, Bernard Widrow — ADALINE (Adaptive Linear Neuron, позже Adaptive Linear Element). Порог записан как bias. Это удобная запись — те самые шесть шагов из прошлого раздела. Позже из нескольких таких элементов собрана MADALINE (Multiple ADALINE).
Нейросети — ровесники AI
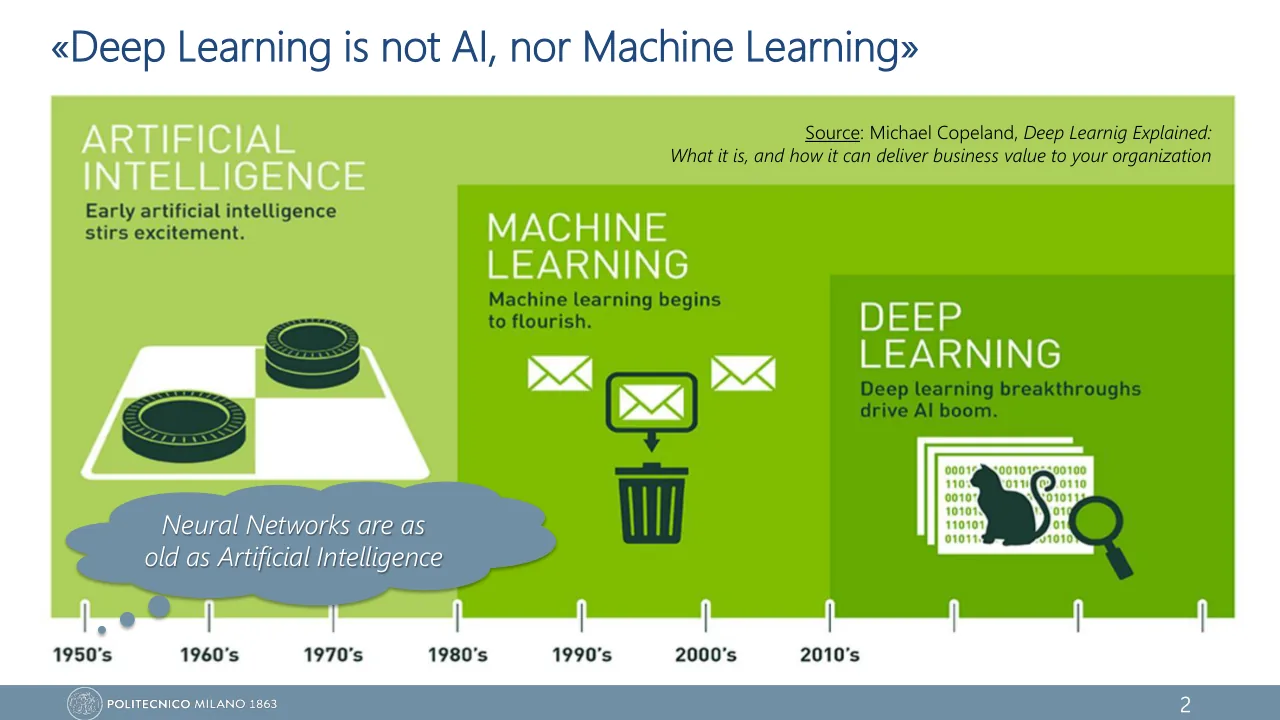
Слайд 2 озаглавлен провокационно: «Deep Learning is not AI, nor Machine Learning». Он не отрицает родство, а напоминает, что это три разных слова. Deep learning — семейство методов внутри machine learning, а machine learning — часть artificial intelligence.
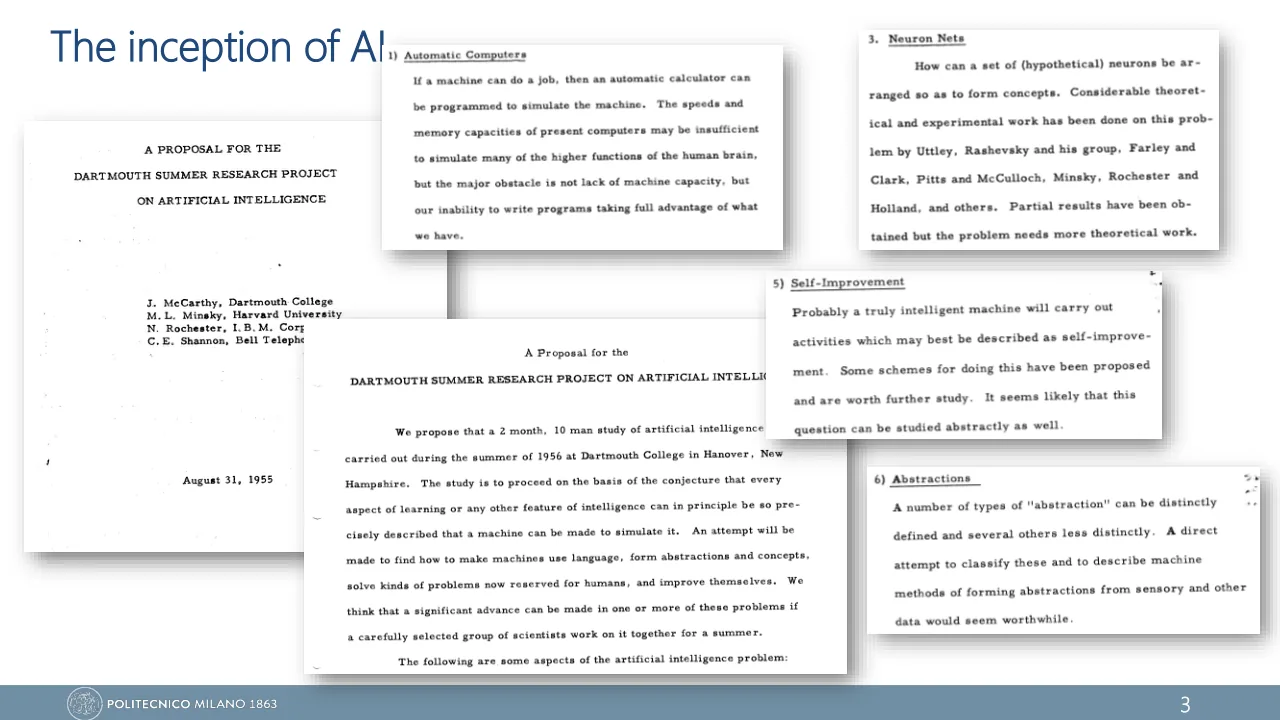
Доказательство — на слайде 3. Заявку на Дартмутский летний проект подали в 1955 году John McCarthy, Marvin Minsky, Nathaniel Rochester и Claude Shannon; с неё отсчитывают историю AI как области. В списке тем под номером три стоит Neuron Nets: как соединить нейроны, чтобы они формировали понятия.
Дальше, по конспекту, идея разошлась на две традиции. Символьная (symbolic) делала ставку на явные правила, логику и представления, придуманные человеком. Коннекционистская (connectionist) — на сети простых элементов, которые учатся на данных. Вторая долго оставалась в тени и вернулась под именем deep learning; почему именно в 2012-м — тема урока 4.
Нейронная сеть (neural network) — набор искусственных нейронов, соединённых взвешенными связями. Она преобразует вход в выход и учится, меняя веса.
«Нейросети изобрели в 2010-х». Нет: модель — 1943, принцип обучения — 1949, обучаемая машина — 1957. В 2010-х появились не нейросети, а данные и вычислительная мощность, которых им не хватало.
Что менялось в машине за 50 попыток
Вернёмся к пятитонному компьютеру 1958 года. Теперь на вопрос из начала урока можно ответить точно. Внутри считался перцептрон: взвешенная сумма и порог. Сама процедура «сложить и сравнить» за 50 попыток не изменилась ни на шаг. Менялись числа \(w_0, w_1, \dots, w_I\).
В аппаратной версии, Mark I Perceptron, эти числа можно было потрогать. «Сетчатка» из 400 фотоэлементов (20 × 20), 512 промежуточных элементов, 8 выходных. Каждый настраиваемый вес — потенциометр, обычная ручка вроде регулятора громкости. Во время обучения ручки поворачивали электромоторы. Отсюда и название урока: машина, которая сама крутит ручки.
Сколько ручек у нейрона с \(I\) входами? Ровно \(I + 1\): по одной на вход и ещё одна — bias. Порог оказался такой же ручкой, как остальные, и это ровно то, что записал Widrow.
Обучение не переписывает программу. Оно меняет числа \(w_0, \dots, w_I\) — и больше ничего.
А что с обещаниями газеты? Формула показывает их цену. Один такой нейрон умеет одно: сравнить одну взвешенную сумму с одним порогом. Отличить «метка слева» от «метка справа» этого хватает. Что это значит на картинке и где у такого элемента предел — в уроке 6 и уроке 8. А по какому правилу моторы решали, куда крутить ручку, — в уроке 7.
В формате экзамена
Write the mathematical model of an artificial neuron with a firing threshold \(b\). Then show how the threshold can be represented as a weight and say why this is convenient.
Show model answer
The neuron computes a weighted sum of its \(I\) inputs, subtracts the threshold and applies an activation function \(h_j\) (a step: 1 if its argument is positive, 0 otherwise):
\[ h_j(\vb{x} \mid \vb{w}, b) = h_j\Big(\sum_{i=1}^{I} w_i x_i - b\Big) \]Add a constant input \(x_0 = 1\) with weight \(w_0 = -b\). Then \(-b = w_0 x_0\) is simply the \(i = 0\) term of the sum:
\[ h_j\Big(\sum_{i=0}^{I} w_i x_i\Big) = h_j(\vb{w}\T\vb{x}) \]with \(\vb{x} = (1, x_1, \dots, x_I)\) and \(\vb{w} = (w_0, w_1, \dots, w_I)\). The weight \(w_0\) is the bias. It is convenient because all \(I + 1\) parameters sit in one vector, the sum is always compared with zero, and the same learning rule updates the bias like any other weight.
В полном ответе три вещи: строка с тремя равенствами, явные слова «\(x_0 = 1\), \(w_0 = -b\)» (без них второе равенство неверно) и знак. Фраза «the bias is the threshold» без минуса — ошибка: это два числа с противоположными знаками.
In the 1940s researchers were seeking a computational model beyond the Von Neumann machine. What were computers already good at, what was missing, and which properties of the brain made it an attractive alternative?
Show model answer
Computers were good at doing exactly what they were programmed to do and at very fast arithmetic. Researchers also wanted machines that could (i) interact with noisy data or directly with the environment, (ii) be massively parallel and fault tolerant, (iii) adapt to circumstances.
The brain does all three. It has about \(10^{11}\) neurons, each with about 7,000 synaptic connections (\(10^{14}\) to \(5 \times 10^{14}\) synapses in adults). Its computational model is distributed among simple non-linear units, redundant and therefore fault tolerant, and intrinsically parallel; synaptic strengths change with experience, which gives adaptation. A single neuron is slow (milliseconds), so the power comes from parallelism, not from the speed of the unit.
Вопрос на «why», поэтому мало перечислить свойства мозга — нужно связать их с тремя желаниями. Числа \(10^{11}\) и 7000 добавляют ответу веса; ms против ns показывает, что ты понимаешь, откуда берётся сила модели.
A neuron has three binary inputs with weights \(w_1 = 1.5\), \(w_2 = -1\), \(w_3 = 2\) and a firing threshold \(b = 2\). The threshold is represented as a bias weight \(w_0\) on a constant input \(x_0 = 1\). For the input \((x_1, x_2, x_3) = (1, 1, 1)\) compute \(\vb{w}\T\vb{x}\), the argument of the activation function.
Show model answer
\(w_0 = -b = -2\), so
\[ \vb{w}\T\vb{x} = -2 + 1.5 - 1 + 2 = 0.5 \]Since \(0.5 \gt 0\), the neuron fires (output 1).
Две ловушки: забыть слагаемое \(w_0 x_0\) (получится 2.5) и взять \(w_0 = +2\) (получится 4.5). Эти числа можно выставить в виджете и проверить себя.
A neuron fires when \(0.6 + 0.8\,x_1 - 0.4\,x_2 \gt 0\). Rewritten in the form \(w_1 x_1 + w_2 x_2 \gt b\), what is its firing threshold \(b\)?
Show model answer
Here \(w_0 = 0.6\). Moving it to the right-hand side gives \(0.8\,x_1 - 0.4\,x_2 \gt -0.6\), so
\[ b = -w_0 = -0.6 \]The threshold is negative: the neuron fires even when both inputs are zero.
Вся задача — про знак. Ответ 0.6 — типичная ошибка: порог и bias всегда противоположны по знаку.
Which of the following historical statements are correct? Select all that apply.
Show model answer
Correct: the 1943, 1957 and 1960 statements. McCulloch and Pitts proposed a model with fixed weights and no learning. Neural networks are as old as AI itself: "Neuron Nets" is one of the topics of the 1955 Dartmouth proposal.
Формула для памяти: 1943 — модель, 1957 — обучение, 1960 — порог как bias. Если спросят «what was new?», отвечай именно этим словом.
Which component makes the artificial neuron a non-linear unit?
Show model answer
The activation function. The weighted sum \(\vb{w}\T\vb{x}\) is linear in the inputs; the step applied to it is not. Example: with weights \((1, 1)\) and threshold 1.5 each input alone gives output 0, but both together give 1, so the output for a sum of inputs is not the sum of the outputs.
Короткий вопрос, на котором легко ответить «the weights». Контрпример в одну строку делает ответ неуязвимым.
Проверь себя
Нейрон из примера про лекцию: веса \((2, 1, -1)\), порог \(b = 1.5\). На входе \((1, 0, 1)\). Что на выходе?
У нейрона \(w_0\) увеличили с \(-2\) до \(+1\), веса при входах не трогали. Что произошло?
Порог \(b\) спрятали в вес \(w_0\). Что при этом произошло? Отметь всё верное.
Картинка для памяти: узел «−» со слайда 7 лекции 2 исчезает, а единица получает собственную стрелку с весом \(w_0\).
Нейрон переключается за миллисекунды, электронный логический элемент — за наносекунды. Почему же за образец вычислительной модели взяли мозг?
Что нового было в перцептроне Rosenblatt (1957) по сравнению с элементом McCulloch и Pitts (1943)?
Нейрон первого поколения считает \(h_j(\vb{w}\T\vb{x})\) со ступенькой \(h_j\). Какая часть этой формулы нелинейна?
Заголовок слайда 2 лекции 2: «Deep Learning is not AI, nor Machine Learning». Что из этого следует? Отметь всё верное.
Унести с собой
- В 1940-х искали вычислительную модель за пределами машины фон Неймана: чтобы она работала с шумом, была параллельной и отказоустойчивой и умела приспосабливаться.
- Образцом стал мозг: \(10^{11}\) нейронов, около 7000 связей у каждого; модель распределённая, избыточная и параллельная по природе.
- Искусственный нейрон делает три шага: взвешенная сумма, вычитание порога, ступенька. Нелинейность — только в ступеньке.
- Bias trick: добавь вход \(x_0 = 1\) с весом \(w_0 = -b\), и нейрон запишется как \(h_j(\vb{w}\T\vb{x})\). Порог и bias отличаются знаком.
- 1943 — модель (McCulloch, Pitts), 1949 — принцип обучения (Hebb), 1957 — обучаемый перцептрон (Rosenblatt), 1960 — порог как bias (Widrow), 1969 — предел одного слоя (Minsky, Papert), 1986 — backpropagation, 1991 — теорема Hornik.
- Нейросети — ровесники AI: «Neuron Nets» стоят уже в заявке Dartmouth 1955 года.
- Обучение меняет только числа \(w_0, \dots, w_I\). У нейрона с \(I\) входами их \(I + 1\).
Что посмотреть и почитать
-
ChatGPT is made from 100 million of these [The Perceptron]
Welch Labs≈ 24 мин
Лучший разогрев ко всей главе: перцептрон Rosenblatt и машина Mark I показаны как прямой предок сегодняшних моделей.
-
The Man Who Tried to Redeem the World with Logic
Amanda Gefter, Nautilus, 2015
Человеческая история за 1943 годом: кто такие McCulloch и Pitts и почему первый нейрон был логическим устройством без обучения.
-
Using neural nets to recognize handwritten digits
Michael Nielsenраздел «Perceptrons»
Тот же сюжет на другом бытовом примере: нейрон взвешивает доводы и сравнивает их с порогом. Хорошо читать рядом с виджетом «Нейрон руками».
-
Professor's perceptron paved the way for AI – 60 years too soon
Cornell Chronicle, 2019
Откуда взята загадка из начала урока: демонстрация 1958 года, газетные ожидания и что было на самом деле.
-
Bernard Widrow demonstrates ADALINE
Chatbots Decoded Interview
Для любопытства: автор идеи «порог как bias» сам показывает своё устройство.