Одна и та же архитектура нейросети с одними и теми же настройками научилась играть в 49 игр Atari; для каждой игры её обучали заново. На вход она получала только пиксели экрана, а вместо правильных ходов — счёт игры в роли reward. Работа вышла в журнале Nature под названием «Human-level control through deep reinforcement learning».
Учиться без ответов
После этого урока ты назовёшь число, которое улучшает алгоритм без правильных ответов, вручную прогонишь K-means, прочитаешь дендрограмму и посчитаешь discounted return агента.
В 2012 году команда из Google и Стэнфорда три дня показывала нейросети кадры из YouTube: 10 миллионов картинок 200×200 пикселей, тысяча машин, 16 000 процессорных ядер. Подписи не было ни у одного кадра. Никто не сообщал сети, что на свете бывают кошки. После обучения в ней нашёлся нейрон, который срабатывал именно на кошачьи морды.
В уроке 1 «учиться» значило: мера качества \(P\) растёт с опытом \(E\). Там \(P\) считали, сверяя ответы модели с правильными ответами \(t_n\). Здесь правильных ответов нет вообще.
Вопрос урока: какое число тогда улучшается? И кто решает, сколько групп должно получиться — машина или ты?
Данные без столбца \(t\)
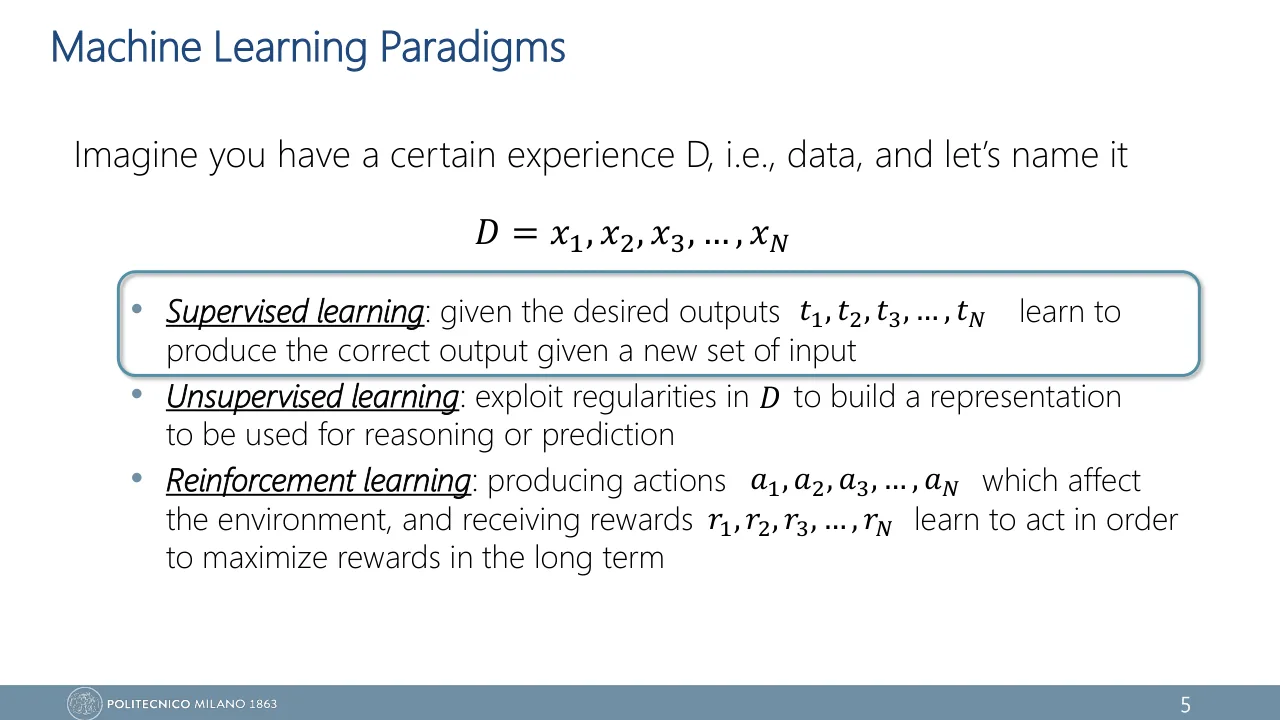
В supervised learning опыт состоит из пар: вход и правильный ответ. На слайде 5 лекции 1 профессор записывает это так: есть данные \(D = x_1, x_2, \dots, x_N\), и к ним приложены desired outputs \(t_1, \dots, t_N\). Убери второй список — останется unsupervised learning, обучение без учителя.
Unsupervised learning — в опыте есть только входы \(D = x_1, \dots, x_N\). Задача по слайду 5 лекции 1: exploit regularities in \(D\) to build a representation to be used for reasoning or prediction. То есть найти в данных закономерности и построить по ним представление, которым потом можно пользоваться.
Главное слово здесь — representation. Цель не «посмотреть на данные», а получить новое, более удобное описание каждого объекта. Самое простое описание — номер группы, в которую объект попал. Это clustering (кластеризация): разбить точки так, чтобы внутри группы они были похожи, а между группами нет. «Похожи» значит «близко по выбранному расстоянию», обычно евклидову, как в Applied Statistics.
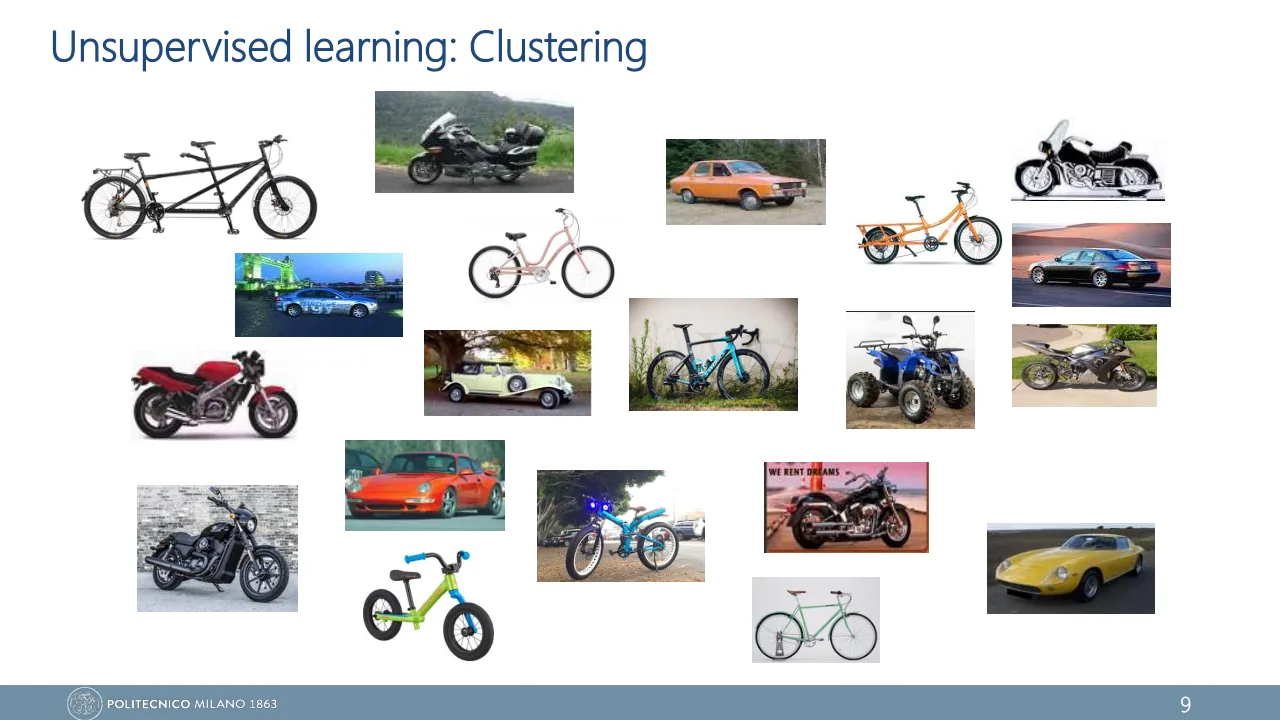
Профессор показывает это на таких же фотографиях транспорта, как в уроке 1, только подписей и цен у них нет. На слайдах 9–15 куча из двух десятков снимков постепенно раскрашивается: мотоциклы, велосипеды, автомобили. И остаётся один квадроцикл, которому достаётся собственный цвет.
До: опыт \(D = x_1, \dots, x_N\), подписей нет
После: четыре группы, имён у них нет
На этой картинке две вещи важнее самих групп. Первая: у групп нет имён. Алгоритм выдаёт «группа 2», а не «мотоцикл»; кластер — это не класс. Вторая: квадроцикл. Его никто не предусматривал, и классификатор «машина или мотоцикл» из урока 1 никогда бы его не выделил: такого ответа в его списке нет. Структуру подсказали сами данные.
Теперь примерим определение Митчелла. Задача \(T\) — найти структуру: группы или low-dimensional embedding вроде PCA. Опыт \(E\) — одни только \(x_n\). А вот про \(P\) конспект честно пишет, что она «less obvious». Варианта два. Internal measure считается по самим данным: насколько группы компактны или какую долю дисперсии сохраняет PCA. Extrinsic measure смотрит, помогло ли представление в следующей задаче. Запомни первую: через несколько абзацев она станет формулой.
«Unsupervised — значит без целевой функции». Нет. Нет target, то есть \(t_n\). А число, которое алгоритм делает меньше, есть всегда.
K-means: три пиццерии и одно число
В новом районе открылись три пиццерии. Правила простые. Каждый житель ходит в ближайшую. Каждая пиццерия, увидев, откуда приходят её клиенты, переезжает в середину между ними. После переезда кому-то стала ближе другая пиццерия, и всё повторяется, пока никто не захочет ничего менять.
Это и есть K-means. Жители — точки \(\vb{x}_n\). Пиццерии — centroids \(\boldsymbol{\mu}_k\). Число пиццерий \(K\) выбираешь ты, а не алгоритм. Два правила называются assignment step и update step.
\[ c_n = \argmin_{k}\, \norm{\vb{x}_n - \boldsymbol{\mu}_k}^2 \]
\[ \boldsymbol{\mu}_k = \frac{1}{\abs{C_k}} \sum_{n \in C_k} \vb{x}_n \]
- \(c_n\)
- номер кластера точки \(n\): первая строка, assignment
- \(\boldsymbol{\mu}_k\)
- центроид кластера \(k\): вторая строка, update
- \(C_k\)
- множество точек, попавших в кластер \(k\); \(\abs{C_k}\) — сколько их
А что при этом улучшается? Сумма квадратов расстояний от каждого жителя до его пиццерии:
\[ J = \sum_{k=1}^{K} \sum_{n \in C_k} \norm{\vb{x}_n - \boldsymbol{\mu}_k}^2 \]
Это within-cluster sum of squares, знакомая по Applied Statistics. Вот она, мера \(P\) для задачи без ответов: чем меньше \(J\), тем компактнее группы. Правильные ответы для неё не нужны, хватает самих \(\vb{x}_n\).
Прогон руками
Шесть точек на прямой: 1, 2, 3, 10, 11, 12. Берём \(K = 2\) и нарочно неудачный старт: центроиды в точках 1 и 2. Каждая строка рисунка — один ход.
Проверь одну строку на калькуляторе. Ход 2: во втором кластере точки 2, 3, 10, 11, 12, их среднее \(38 / 5 = 7.6\). Первый кластер состоит из одной точки, она совпадает со своим центроидом и даёт ноль. Остаётся:
\[ \begin{aligned} J &= 5.6^2 + 4.6^2 + 2.4^2 + 3.4^2 + 4.4^2 \\ &= 89.2 \end{aligned} \]Пятый ход, снова assignment, уже ничего не меняет: каждая точка и так у ближайшего центроида. Алгоритм остановился.
Почему \(J\) не может вырасти
Запишем \(J\) так, чтобы были видны обе группы неизвестных: номера \(c_n\) и центроиды \(\boldsymbol{\mu}_k\).
\[ J = \sum_{n=1}^{N} \norm{\vb{x}_n - \boldsymbol{\mu}_{c_n}}^2 \]Это та же двойная сумма: каждая точка посчитана один раз, со своим центроидом.
Assignment step: центроиды заморожены. Слагаемое точки \(n\) зависит только от её собственного \(c_n\), поэтому каждое можно уменьшать отдельно — выбрать ближайший центроид.
\[ c_n = \argmin_{k}\, \norm{\vb{x}_n - \boldsymbol{\mu}_k}^2 \]Ни одно слагаемое не выросло, значит, не выросла и сумма.
Update step: заморожены номера. Теперь \(J\) распадается на \(K\) независимых кусков, по одному на центроид. В минимуме куска \(k\) производная по \(\boldsymbol{\mu}_k\) равна нулю.
\[ \pd{J}{\boldsymbol{\mu}_k} = -2 \sum_{n \in C_k} (\vb{x}_n - \boldsymbol{\mu}_k) = 0 \]Решаем это уравнение.
\[ \boldsymbol{\mu}_k = \frac{1}{\abs{C_k}} \sum_{n \in C_k} \vb{x}_n \]Получилось среднее. Не «так принято», а единственная точка, в которой сумма квадратов расстояний минимальна.
Ход, который что-то меняет, делает \(J\) строго меньше, поэтому вернуться к уже пройденному разбиению нельзя. (Одна оговорка: точку, которая стоит ровно посередине между двумя центроидами, оставляют в её кластере.) А способов разбить \(N\) точек на \(K\) групп конечное число. Значит, ходы обязаны закончиться.
Чего здесь нет: утверждения, что конец пути — лучшее разбиение. Доказано только, что ни один из двух ходов больше не помогает. Это local minimum, и какой именно, зависит от старта.
K-means по очереди минимизирует одно и то же число J: сначала по номерам кластеров, потом по центроидам.
Теперь то же самое на двумерных данных, устроенных как в конспекте: три облака с теми же центрами и стартовые центроиды со стр. 17. В конспекте точек 300, здесь 150, по 50 в облаке, и сами точки сгенерированы заново.
У профессора для этой беды есть готовые реплики, они прозвучат в лекции про gradient descent (урок 13): «It depends on where we start from» и рецепт «Use multiple restarts». Там число будет называться \(E(\vb{w})\), но сюжет тот же: шаг за шагом уменьшаем функцию и останавливаемся в минимуме, который зависит от старта.
И про сам старт. Конспект пишет, что центроиды «are randomly placed in the feature space». На практике их берут из самих данных: \(K\) случайных точек выборки (так работает кнопка «Случайный старт») или более аккуратный выбор k-means++, который старается разнести стартовые центроиды подальше друг от друга. Центроид, брошенный далеко от всех точек, может не получить ни одной из них и останется пустым кластером.
Дендрограмма: все разбиения сразу
K-means требует назвать \(K\) до начала. Hierarchical clustering откладывает этот выбор. В варианте agglomerative (снизу вверх) сначала каждая точка — свой кластер. На каждом шаге два ближайших кластера сливаются в один, и так до тех пор, пока не останется единственный. Вариант divisive идёт сверху вниз: начинает с одного кластера и делит.
Протокол всех слияний рисуют деревом. Это dendrogram. Листья внизу — точки. Каждая горизонтальная перекладина — одно слияние, её высота показывает, «на каком расстоянии» оно случилось. Горизонтальный разрез на высоте \(h\) отменяет все слияния выше него. Сколько вертикальных веток пересёк разрез, столько кластеров и получилось.
Ниже данные, устроенные как на рисунке 1 конспекта (стр. 16): 50 точек, три облака по 17, 17 и 16. Центры облаков измерены по тому рисунку, сами точки сгенерированы заново.
Последний опыт показывает, что слова «расстояние между кластерами» надо уточнять. Правило, по которому его считают, называется linkage.
| Linkage | Расстояние от \(A\) до \(B\) | Высоты |
|---|---|---|
| single | между двумя ближайшими точками | 7.7 и 12.6 |
| complete | между двумя самыми далёкими точками | 12.5 и 18.6 |
| average | среднее по всем парам точек | 9.9 и 15.6 |
| Ward | цена слияния: рост \(J\) | 40.7 и 69.1 |
Рисунок в конспекте построен с Ward linkage. Его высота считается так:
\[ d_{\text{Ward}} = \sqrt{\frac{2\abs{A}\abs{B}}{\abs{A} + \abs{B}}}\,\norm{\vb{c}_A - \vb{c}_B} \]
- \(\abs{A}, \abs{B}\)
- число точек в кластерах
- \(\vb{c}_A, \vb{c}_B\)
- их центроиды
Проверим на двух облаках по 17 точек, между центроидами которых 9.86. Сначала множитель, потом высота:
\[ \sqrt{\frac{2 \cdot 17 \cdot 17}{34}} = \sqrt{17} \approx 4.123 \] \[ d_{\text{Ward}} \approx 4.123 \cdot 9.86 \approx 40.7 \]Там и стоит перекладина: в виджете на 40.7, на рисунке конспекта чуть выше 40. Смысл множителя: \(d_{\text{Ward}}^2 = 2\,\Delta J\), где \(\Delta J\) — на сколько вырастет \(J\) из прошлого раздела, если эти два кластера объединить. Чем больше кластеры, тем дороже их слияние.
Число кластеров по дендрограмме выбирают глазами: ищут самый длинный вертикальный участок без перекладин и режут внутри него. И ещё мелочь для экзамена: слово пишется dendrogram. В тексте конспекта стоит «dendogram», это опечатка.
Reinforcement learning: оценка вместо ответа
Ты в миланском баре и не знаешь итальянского. Говоришь бармену слово наугад и смотришь, что принесли. Никто не скажет: «правильно было бы попросить macchiato». Ты узнаёшь только, насколько тебе понравилась чашка, и только для того слова, которое прозвучало. Завтра можно повторить удачное слово или рискнуть новым.
Это третья парадигма, reinforcement learning (обучение с подкреплением, RL). На слайде 5 лекции 1 она описана одной фразой: producing actions \(a_1, \dots, a_N\) which affect the environment, and receiving rewards \(r_1, \dots, r_N\) learn to act in order to maximize rewards in the long term. В ней три новости сразу.
- Ученик действует. Его actions меняют среду, а значит, и то, какие данные он увидит дальше.
- Вместо ответа приходит reward. Это число-оценка: хорошо вышло или плохо. Какое действие было правильным, оно не говорит.
- In the long term. Важна не ближайшая награда, а сумма за всё время.
На каждом шаге \(t\) агент наблюдает state \(s_t\), выбирает action \(a_t\) и получает reward \(r_t\) вместе с новым состоянием \(s_{t+1}\). Правило выбора называется policy и записывается как распределение вероятностей:
\[ \pi(a \mid s) = \Pr(a_t = a \mid s_t = s) \]
- \(\pi(a \mid s)\)
- с какой вероятностью агент в состоянии \(s\) выберет действие \(a\)
Agent — всё, что воспринимает среду через сенсоры (sensors) и действует на неё через исполнительные устройства (actuators), чтобы достичь цели. В RL агент улучшает своё поведение по обратной связи от среды.
В конспекте это разобрано на роботе в лабиринте (Example 7). Положим рядом робота и бар:
| Термин | Робот в лабиринте | Ты в баре |
|---|---|---|
| agent | робот | ты |
| environment | лабиринт | бар и бармен |
| state \(s_t\) | где робот сейчас | что уже заказано и выпито |
| action \(a_t\) | шаг влево, вправо, вперёд, назад | слово, сказанное бармену |
| reward \(r_t\) | плюс за выход, минус за удар о стену | насколько понравилась чашка |
| policy \(\pi\) | правило «в этой клетке иду туда» | привычка, что заказывать |
Примерим Митчелла и сюда, как это делает конспект на стр. 21. \(T\): выучить policy, то есть какое действие выбирать в каждом состоянии. \(E\): цепочки состояний, действий и наград, которые агент сам добыл, взаимодействуя со средой. \(P\): ожидаемая сумма наград — до неё дойдём в следующем разделе.
Математическая модель такой задачи называется MDP. Здесь конспект ошибается, поэтому определение — в рамке.
Markov Decision Process — пятёрка \((\mathcal{S}, \mathcal{A}, P, R, \gamma)\): множество состояний, множество действий, вероятности переходов \(P(s' \mid s, a)\), функция награды \(R(s, a)\) и discount factor \(\gamma\). К ней прилагается Markov property: следующее состояние зависит только от текущего состояния и действия, а не от всей истории.
\[ \begin{aligned} &\Pr(s_{t+1} \mid s_t, a_t, s_{t-1}, a_{t-1}, \dots) \\ &\qquad = \Pr(s_{t+1} \mid s_t, a_t) \end{aligned} \]Буква \(P\) в пятёрке — вероятности переходов. С мерой качества \(P\) из определения Митчелла её роднит только написание.
Сколько стоит будущее: discount factor
Слова «maximize rewards in the long term» надо превратить в одно число. Просто сложить все награды? Тогда 10 евро сегодня и 10 евро через год равноценны. А если шаги не кончаются, сумма может оказаться бесконечной. Поэтому будущее уценивают: награда через \(t\) шагов входит в сумму с весом \(\gamma^t\).
\[ G = \sum_{t=0}^{\infty} \gamma^{t} r_t \]
\[ G = r_0 + \gamma\, r_1 + \gamma^2 r_2 + \dots \]
- \(G\)
- discounted return: сумма наград с уценкой
- \(\gamma\)
- discount factor, число от 0 до 1
- \(r_t\)
- награда на шаге \(t\)
В конспекте у этой суммы нет своей буквы: она стоит прямо в формуле \(P = \E\bigl[\sum_t \gamma^t r_t\bigr]\). Знак \(\E\) нужен потому, что и среда, и policy случайны: мера качества — expected return, среднее по многим попыткам. Цель обучения — policy с наибольшим ожидаемым \(G\):
\[ \pi^{*} = \argmax_{\pi}\; \E_{\pi}[\,G\,] \]Посчитаем на лабиринте. Робот делает четыре шага и за каждый получает −1, а на пятом выходит и получает +10. При \(\gamma = 0.9\):
\[ \begin{aligned} G &= -(1 + 0.9 + 0.81 + 0.729) \\ &\phantom{=}\; {} + 10 \cdot 0.6561 \\ &= -3.439 + 6.561 = 3.122 \end{aligned} \]Последний опыт — причина, по которой в бесконечных задачах берут \(\gamma\) строго меньше единицы. Вот короткое доказательство.
Пусть награды ограничены: ни одна по модулю не больше \(R_{\max}\).
\[ \abs{r_t} \le R_{\max} \]Модуль суммы не больше суммы модулей, а каждый модуль не больше \(R_{\max}\).
\[ \begin{aligned} \abs{G} &\le \sum_{t=0}^{\infty} \gamma^{t} \abs{r_t} \\ &\le R_{\max} \sum_{t=0}^{\infty} \gamma^{t} \end{aligned} \]Осталась геометрическая прогрессия \(S = 1 + \gamma + \gamma^2 + \dots\) Вынесем \(\gamma\) из всех слагаемых, кроме первого: \(S = 1 + \gamma S\).
\[ S = \frac{1}{1 - \gamma} \]Это верно только при \(\gamma \lt 1\): иначе слагаемые не убывают и у суммы нет предела.
Собираем.
\[ \abs{G} \le \frac{R_{\max}}{1 - \gamma} \]При \(\gamma \lt 1\) return любой стратегии — конечное число, и стратегии можно сравнивать.
При \(\gamma = 1\) граница превращается в деление на ноль, и не зря: поток наград \(r_t = 1\) даёт сумму \(1 + 1 + 1 + \dots\) Значит, \(\gamma = 1\) допустим только там, где эпизод гарантированно кончается.
Зачем уценивать будущее, если эпизод и так конечный?
Причин ещё две. Будущее ненадёжно: чем дальше награда, тем больше шансов, что её не будет. И обычное предпочтение: то же самое лучше получить раньше. Обе знакомы по евро сегодня и евро через год.
Три трудности, которых нет в supervised learning
Sparse reward и dense reward. Награда бывает редкой: в игре число приходит только в конце, за победу или поражение. И бывает частой: в симуляторе вождения маленький плюс за каждый момент на дороге и минус за съезд. Учиться по редкой награде трудно, потому что почти все шаги не дают никакой информации.
Sparse reward: число только на выходе
Dense reward: число в каждой клетке
Delayed reward. Награда может прийти намного позже действия, которое её заслужило. Шахматный ход ничего не даёт сразу, а через двадцать ходов приводит к победе. Кому из двадцати ходов приписать успех? Это называется credit assignment problem. В виджете задержка была видна по-своему: от награды +10, отодвинутой на 20 шагов, на старте остаётся столбик высотой 1.2.
Exploration vs. exploitation. Вернёмся в бар. Можно каждый день повторять слово, после которого принесли неплохой кофе: это exploitation, использование известного. Можно пробовать новые слова: это exploration, разведка. Только повторять — значит, возможно, никогда не узнать про лучший напиток. Только пробовать — значит не пить хороший кофе, который уже найден. Нужны оба, и в этом дилемма.
Конспект называет ещё две беды: sample inefficiency (нужны миллионы попыток) и неустойчивость обучения, когда policy задаёт нейросеть.
Три вида опыта, и почему курс выбирает один
Сложим всё рядом. Три парадигмы различаются тем, что лежит в одной записи опыта.
Самая частая ошибка — считать reward разновидностью label. Различий три.
- Label — инструкция: вот правильный ответ, и он не зависит от того, что ответила модель. Reward — оценка: насколько хорошо было то действие, которое агент совершил. Про остальные действия она молчит.
- Label приложен к каждому примеру. Reward может прийти поздно и редко.
- В supervised learning набор данных фиксирован: ответы модели не меняют того, что она увидит дальше. В RL данные порождает сам агент, поэтому они зависят от текущей policy: это уже не независимая выборка из одного распределения (не i.i.d.). Отсюда и нужда в exploration, которой в supervised learning нет.
| Supervised | Unsupervised | Reinforcement | |
|---|---|---|---|
| Что в опыте | \(x_n\) и \(t_n\) | только \(x_n\) | \(s_t, a_t, r_t\) |
| Обратная связь | правильный ответ на каждый пример | нет | оценка действия, часто поздняя и редкая |
| Откуда данные | даны заранее | даны заранее | их добывает сам агент |
| Какое число улучшается | ошибка между выходом и \(t_n\) | внутренняя мера, например \(J\) | ожидаемый return \(\E[G]\) |
| Примеры методов | regression, SVM | K-means, PCA | Q-learning, policy gradients, actor-critic |
«Нейросети — это метод supervised learning». Так выходит из таблицы на стр. 22 конспекта, где Neural Nets записаны в столбец supervised. На деле нейросеть — способ задать функцию, и им пользуются во всех трёх парадигмах. Сеть из начала урока училась без ответов, а в RL сетью задают саму policy.
Ответ на задачку
Какое число улучшается, когда правильных ответов нет? Теперь у тебя есть три примера. У K-means это \(J\): он считается по одним только \(\vb{x}_n\) и падает на каждом ходу. У агента это ожидаемый return. У сети с кадрами YouTube это была ошибка восстановления собственного входа: она училась как можно точнее воспроизводить картинку, которую ей показали, причём так, чтобы на каждую картинку откликалась лишь малая часть нейронов. Такие сети называются autoencoders (эта была sparse autoencoder), они будут в курсе позже. Нейрон, реагирующий на кошек, оказался побочным продуктом — тем самым representation со слайда профессора.
А кто решает, сколько групп? Ты. В K-means это число \(K\), в дендрограмме — высота разреза. Данные только подсказывают: длинным пустым промежутком в дереве или одиноким квадроциклом.
«Без ответов» не значит «без цели»: меняется не наличие целевой функции, а то, из чего она считается.
Почему дальше — почти только supervised
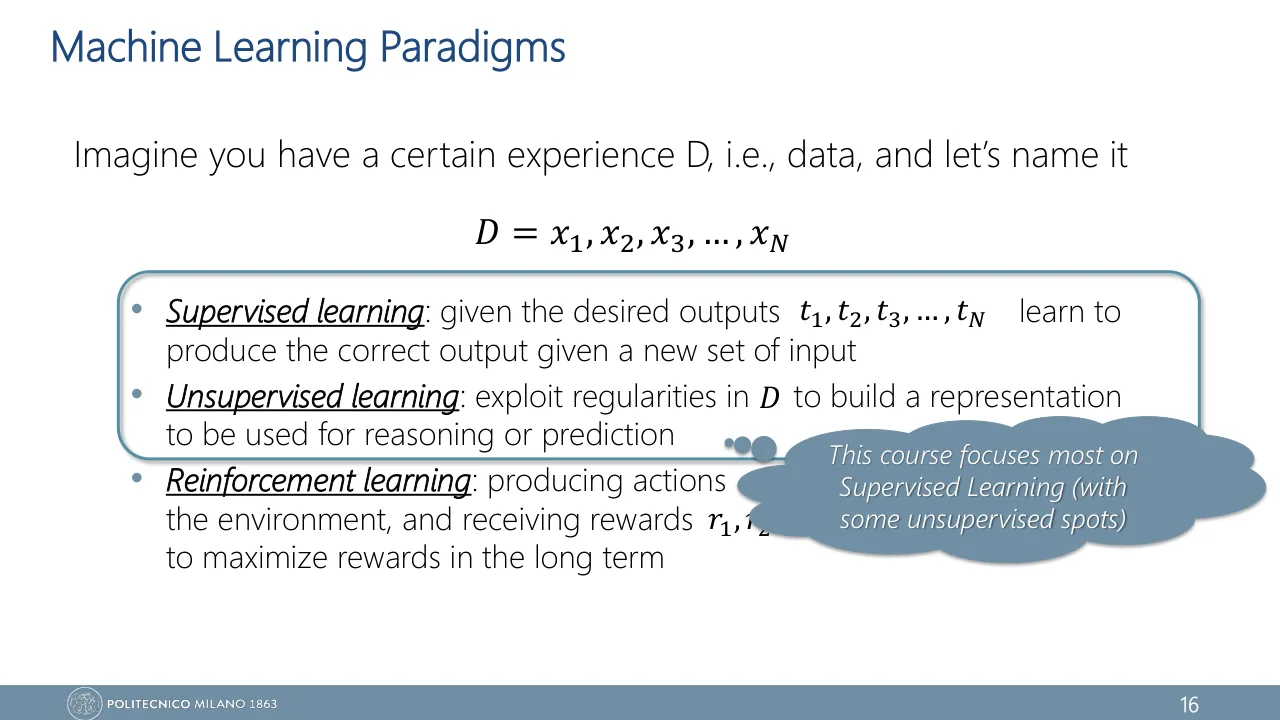
На слайде 16 лекции 1 профессор обводит рамкой две первые парадигмы и пишет: «This course focuses most on Supervised Learning (with some unsupervised spots)». Причину слайд не называет, но она видна из программы курса: почти во всех следующих лекциях есть пары \((x_n, t_n)\) и error function, которая сравнивает выход сети с \(t_n\). Под «unsupervised spots» естественно понимать, например, autoencoders: они стоят в программе курса. От RL на слайдах осталась одна фраза; всё остальное в этом уроке — из конспекта.
Что из этого урока нести на экзамен в первую очередь: формулировки трёх парадигм со слайда 5 и умение объяснить разницу между ними. А K-means вернётся уже в следующем уроке, как деталь систем распознавания, которые были до deep learning.
В формате экзамена
Using the notation \(D = x_1, \dots, x_N\), state what the experience contains in supervised, unsupervised and reinforcement learning. Then explain why a reward is not the same thing as a label.
Show model answer
Supervised: the data \(D\) come with the desired outputs \(t_1, \dots, t_N\); the learner must produce the correct output for a new input. Unsupervised: only \(D\) is given; the learner exploits regularities in \(D\) to build a representation to be used for reasoning or prediction (e.g. clusters). Reinforcement: the learner produces actions \(a_1, \dots, a_N\) that affect the environment and receives rewards \(r_1, \dots, r_N\); it learns to act so as to maximise rewards in the long term.
A label is instructive feedback: it states the correct output for an input, whatever the learner answered. A reward is evaluative feedback: it only scores the action that was actually taken, says nothing about the other actions, and may arrive many steps later. Moreover, in reinforcement learning the data depend on the learner's own behaviour, while a supervised data set is fixed.
В ответе должны быть две вещи: формулировки слайда 5 лекции 1 (обозначения \(t_n\), \(a_n\), \(r_n\) и слова «in the long term») и различие между оценкой и инструкцией. Ответ «reward is a kind of label» вторую часть не закрывает.
K-means with \(K = 2\) is run on the one-dimensional points 1, 2, 3, 10, 11, 12, starting from the centroids \(\mu_1 = 1\) and \(\mu_2 = 2\). Compute the within-cluster sum of squared distances \(J\) right after the first update step.
Show model answer
Assignment: point 1 goes to \(\mu_1\); points 2, 3, 10, 11, 12 are closer to \(\mu_2\) (here \(J = 246\)). Update: \(\mu_1 = 1\), \(\mu_2 = 38 / 5 = 7.6\).
\[ \begin{aligned} J &= 5.6^2 + 4.6^2 + 2.4^2 + 3.4^2 + 4.4^2 \\ &= 89.2 \end{aligned} \]The run continues: clusters {1, 2, 3} and {10, 11, 12} (\(J = 41.68\)), centroids 2 and 11 (\(J = 4\)), and the next assignment changes nothing.
Типичные потери: посчитать \(J\) до update (246) или забыть, что точка 1 даёт вклад 0. Калькулятора хватает; порядок ходов «assignment, потом update» надо держать твёрдо.
Which statements about K-means are correct? Select all that apply.
Show model answer
Correct: A, C and E. K-means is an alternating minimisation of \(J\): neither step can increase it, and the update step sets each centroid to the mean of its points. It stops at a local minimum that depends on the initial centroids; \(K\) is chosen by the user, and no targets are involved.
В вопросах «select all» читай каждое утверждение отдельно, как вопрос «верно или нет». Здесь ловушки спрятаны в словах «always» и «found by the algorithm».
A dendrogram of 50 points (agglomerative clustering, Ward linkage) shows all merges below height 4, then one merge at height 40.7 and the last one at 69.1. (a) How many clusters would you choose, and where can you cut the tree to obtain them? (b) No two points of the data set are more than 19 apart. How can a merge be drawn at height 69.1?
Show model answer
(a) Three clusters: any horizontal cut between 4 and 40.7 crosses three vertical branches. The long range of heights without merges indicates that three is the natural number of clusters.
(b) With Ward linkage the height is not a geometric distance but the cost of the merge: a size factor times the distance between the two centroids. It equals \(\sqrt{2\,\Delta J}\), where \(\Delta J\) is the increase of the within-cluster sum of squares, so it grows with the cluster sizes. Here the clusters have 34 and 16 points and their centroids are 14.82 apart:
\[ \sqrt{\frac{2 \cdot 34 \cdot 16}{50}} \cdot 14.82 = 4.66 \cdot 14.82 \approx 69.1 \]В пункте (a) ждут и число, и допустимый диапазон высот. В пункте (b) достаточно сказать, что смысл вертикальной оси зависит от linkage; формула — бонус.
An agent receives the reward \(-1\) at each of the steps \(t = 0, 1, 2, 3\) and the reward \(+10\) at step \(t = 4\), when it reaches the exit. Compute the discounted return \(G\) for \(\gamma = 0.9\).
Show model answer
\[ \begin{aligned} G &= -(1 + 0.9 + 0.81 + 0.729) \\ &\phantom{=}\; {} + 10 \cdot 0.6561 \\ &= -3.439 + 6.561 = 3.122 \end{aligned} \]
For comparison, \(\gamma = 0.5\) gives \(-1.875 + 0.625 = -1.25\): a short-sighted agent finds the trip not worth it.
Ошибка номер один — начать степени с \(\gamma^1\): первая награда входит с весом \(\gamma^0 = 1\). Ошибка номер два — потерять знак у штрафов.
What is a Markov Decision Process? Why must the discount factor be strictly smaller than 1 in an infinite-horizon task?
Show model answer
An MDP is a tuple \((\mathcal{S}, \mathcal{A}, P, R, \gamma)\): a set of states, a set of actions, the transition probabilities \(P(s' \mid s, a)\), the reward function \(R(s, a)\) and the discount factor \(\gamma\). It satisfies the Markov property: the next state depends only on the current state and action, not on the earlier history.
If the rewards are bounded, \(\abs{r_t} \le R_{\max}\), then
\[ \abs{G} \le R_{\max} \sum_{t=0}^{\infty} \gamma^{t} = \frac{R_{\max}}{1 - \gamma} \]which is finite only for \(\gamma \lt 1\). With \(\gamma = 1\) an infinite sum of rewards can diverge (e.g. \(r_t = 1\) at every step), so the returns of different policies could not be compared. \(\gamma = 1\) is acceptable only for episodic tasks of finite length.
Первая половина — на знание определения: пять элементов и свойство Маркова. Если написать «task, experience, performance», как в конспекте, это ответ на другой вопрос. Во второй половине ждут геометрическую прогрессию.
Проверь себя
Из набора данных убрали столбец \(t_n\). Что у алгоритма кластеризации при этом осталось?
После очередного assignment step ни одна точка не сменила кластер. Какой вывод верен?
Данные одни и те же. Что из перечисленного может изменить итог K-means? Отметь всё подходящее.
Третий пункт — привет из Applied Statistics: перед любым методом, основанным на расстояниях, смотри на масштабы признаков.
На дендрограмме самый длинный участок высот без слияний лежит между 4 и 40, и разрез в нём пересекает три вертикальные ветки. О чём это говорит?
Агент сделал ход и получил \(r = -1\). Что именно он узнал?
Награда +10 придёт через 4 шага, \(\gamma = 0.5\). Какой вклад она даёт в return?
Чем данные в RL отличаются от данных в supervised learning? Отметь всё верное.
Унести с собой
- В unsupervised learning опыт — только \(x_1, \dots, x_N\), цель — построить representation. Нет target, но целевая функция есть.
- K-means чередует assignment и update; ни один ход не увеличивает \(J\). Остановка — когда assignment ничего не меняет. Итог — локальный минимум, зависящий от старта.
- Число кластеров задаёшь ты: \(K\) или высота разреза дендрограммы. Длинный участок без слияний подсказывает естественное число, а смысл высоты зависит от linkage.
- В reinforcement learning агент действует и сам добывает данные. Reward — оценка сделанного действия, а не правильный ответ.
- Цель агента — наибольший ожидаемый discounted return; награда через \(t\) шагов весит \(\gamma^t\). В бесконечной задаче нужен \(\gamma \lt 1\).
- MDP — это \((\mathcal{S}, \mathcal{A}, P, R, \gamma)\) со свойством Маркова, а не тройка \(T\), \(E\), \(P\).
- Курс занимается в основном supervised learning, «with some unsupervised spots».
Что посмотреть и почитать
-
StatQuest: Hierarchical Clustering
StatQuest with Josh Starmer11 мин
Если дендрограммы из Applied Statistics подзабылись: как сливают ближайшие пары, что значит высота ветки и как разрез даёт кластеры. После него виджет с разрезом читается с первого взгляда.
-
Visualizing K-Means Clustering
Naftali Harris
Тот же K-means по ходам, но на других данных. Попробуй наборы «Packed Circles» и «Pimpled Smiley»: на них видно, где правило «ближайший центроид» ломается совсем.
-
REINFORCEjs
Andrej Karpathy
Демо GridWorld: клетки, стены, награды, и policy, которая улучшается шаг за шагом прямо на глазах. Живое продолжение рисунка 4.
-
Reinforcement Learning: An Introduction, 2nd edition
Richard Sutton, Andrew Barto
Каноническая формулировка всех слов из второй половины урока. Хватит главы 1 и разделов 3.1–3.3: цикл агент — среда, return, discounting. Ссылка открывается по http.
-
Building high-level features using large scale unsupervised learning
Le et al., 2012
Та самая работа про нейрон-кошку из начала урока. Достаточно аннотации: в ней все числа из задачки.