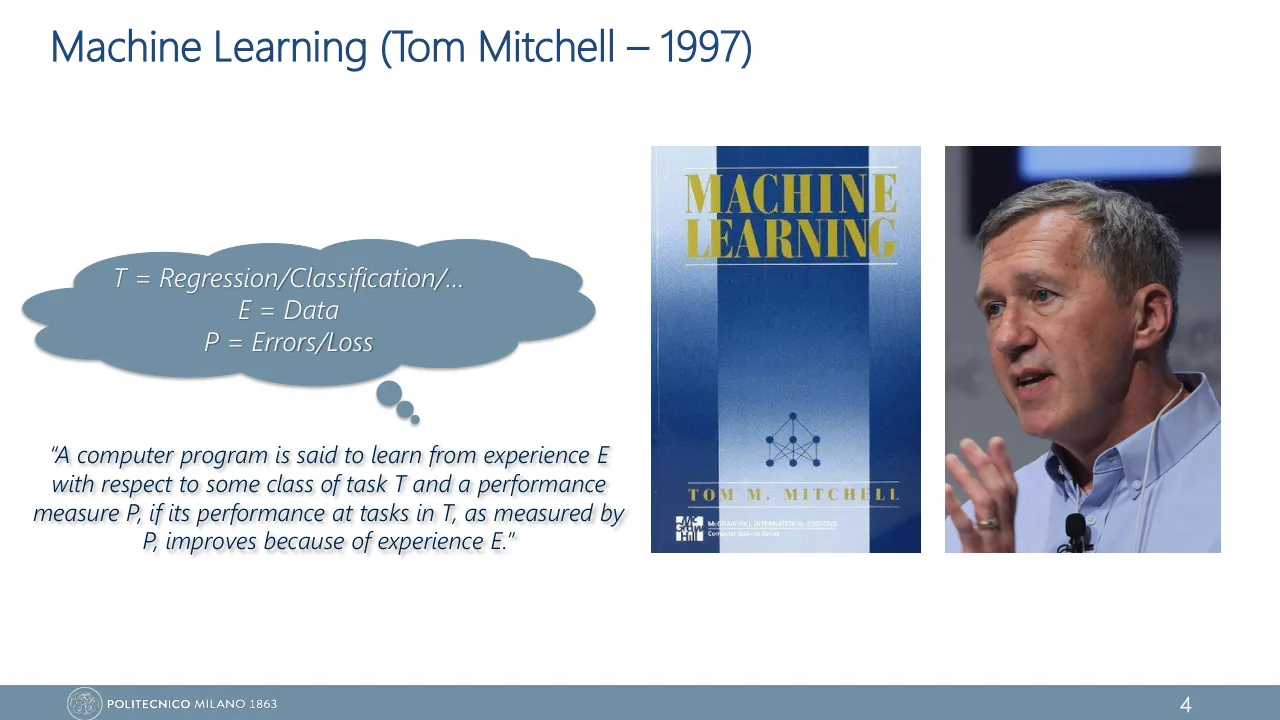
Само выражение machine learning появилось из-за шашек. Артур Сэмюэл из IBM ввёл его в 1959 году, описывая программу для компьютера IBM 701, которая играла в шашки и становилась сильнее от партии к партии. Википедия добавляет, что после публичной демонстрации этой программы акции IBM выросли на 15 пунктов. Митчелл разбирает в учебнике ту же игру: T — играть в шашки, E — партии против самой себя, P — доля выигранных.
Что значит «машина учится»
После этого урока ты для любой программы назовёшь её T, E и P, по одной кривой отличишь выучивание от зубрёжки и посчитаешь accuracy, precision, recall и F1 по четырём числам.
В автошколе два курсанта. Один весь месяц ездил по одному и тому же экзаменационному маршруту и проходит его без единой ошибки. Другой катался по всему городу и на том же маршруте изредка ошибается. Инструктор уверен, что водить научился только второй, и ты с ним наверняка согласишься.
Теперь то же самое про программы. Спам-фильтр A отвечает правильно на 100 % писем, на которых его настраивали. Спам-фильтр B отвечает правильно на 95 % новых писем. Цифры честные. При этом фильтр A ничего не выучил, а фильтр B не поймал ни одного спама.
Как это возможно и какой цифре тогда верить? В 1997 году Том Митчелл дал определение обучения, в котором всего три обозначения: T, E и P. К концу урока ты разберёшь этим определением оба фильтра.
Определение Митчелла: T, E, P
Вернёмся в автошколу и назовём три вещи, о которых шла речь. Есть задача — водить машину. Есть опыт — часы за рулём. И есть мерка — оценка экзаменатора на маршруте, по которому курсант ещё не ездил. Курсант учится, если с каждым часом практики эта оценка растёт. Часы идут, а оценка стоит — значит, практика была, а обучения не было.
Том Митчелл в учебнике Machine Learning (1997) записал ровно это, только про программу. Ниже его определение в близком пересказе; дословную формулировку возьми со слайда 4 лекции 1 или со стр. 8 конспекта и выучи по-английски.
Определение Митчелла. A computer program learns from experience E, with respect to a class of tasks T and a performance measure P, if its performance on the tasks in T, as measured by P, improves with E.
Три буквы — это три вопроса, которые можно задать любой обучающейся программе.
| Вопрос | Автошкола | Спам-фильтр | Слайд 4 лекции 1 | |
|---|---|---|---|---|
| T, task | что надо делать? | водить машину | отнести письмо к spam или not spam | regression, classification, … |
| E, experience | на чём учиться? | часы практики | письма с метками обоих классов | data |
| P, performance measure | каким числом мерить успех? | оценка на незнакомом маршруте | доля верных ответов на новых письмах | errors, loss |
Последний столбец запомни как есть. В остальном курсе задача почти всегда будет одной из двух — regression или classification, опыт — набором данных, а мерка — ошибкой, которую сеть старается уменьшить.
Так же раскладываются остальные примеры конспекта. Автопилот: T — доехать из A в B без происшествий, E — записи поездок и показания датчиков, P — число аварий на милю и время в пути. Шахматная программа: T — играть, E — сыгранные партии, P — доля побед.
Почему это определение называют operational
В нём нет слов «интеллект» или «понимание». Оно не объясняет, что такое обучение «на самом деле», а говорит, как его проверить: измерь P, добавь опыта, измерь ещё раз. Такое определение называют операциональным. Из него следуют три требования.
- Улучшение должно быть измеримым. Нет числа P — нечего обсуждать.
- Улучшение должно идти от опыта. На слайде определение кончается словами because of experience E: благодаря опыту, а не чему-то ещё.
- В центре стоят данные (E) и оценка (P), а не устройство программы. Поэтому определение годится для любого вида обучения.
А если P выросла, потому что программист дописал пару правил?
Тогда программа стала лучше, но не училась: её P выросла не благодаря E. Машинное обучение — это когда качество растёт от данных, а не от того, что решение закодировали руками.
Обратный случай тоже считается: опыта стало вдесятеро больше, а P не сдвинулась. По Митчеллу обучения нет.
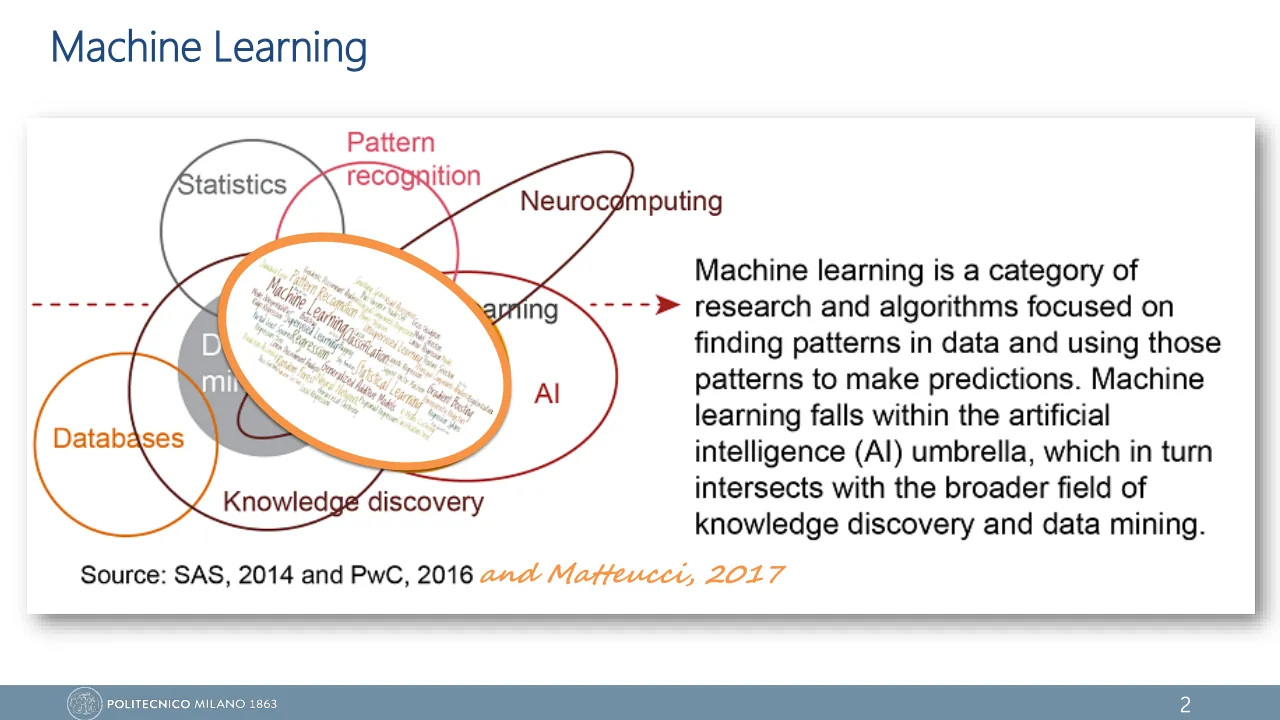
Слайды 2–3 ставят machine learning на карту. На слайде 2 это исследования и алгоритмы, которые находят закономерности в данных (patterns in data) и по ним делают предсказания. Область лежит под зонтиком AI и на диаграмме пересекается со статистикой, pattern recognition и data mining.
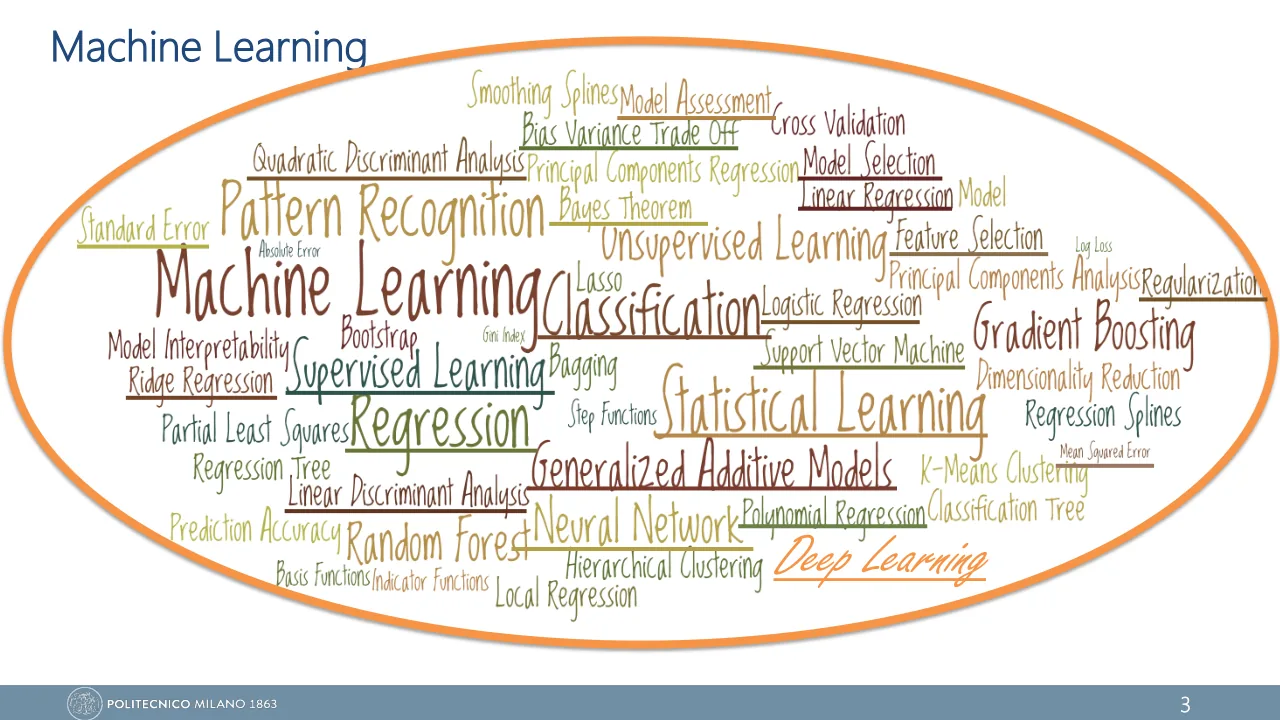
На слайде 3 — облако слов: regression, SVM, random forest, K-means, PCA, LDA. Большую часть ты знаешь из Applied Statistics. В углу от руки дописано Deep Learning: это ещё одно слово в том же облаке, а не отдельная наука.
Перед тем как обсуждать любую модель, спроси: какая у неё T, что лежит в E и чем меряют P.
Выучить или зазубрить
В определении всю нагрузку несут два слова: improves и measured. «Улучшается» — значит, одной цифры мало, нужна кривая: P как функция от количества опыта. «Измеряется» — значит, надо решить, на каких примерах мерить.
Возьмём фильтр A из начала урока. Внутри у него таблица: каждое письмо из опыта записано вместе с ответом. На этих письмах он не ошибается никогда. Но нового письма в таблице нет, и отвечать приходится наугад. Назовём его зубрилой: это курсант, выучивший один маршрут.
Рядом поставим ученика. Он не хранит письма, а ищет правило: по письмам из опыта проводит границу между спамом и обычной почтой. У каждого письма два признака: \(x_1\) — сколько в нём слов вроде «выигрыш» и «скидка», \(x_2\) — длина письма. Первый признак полезен, второй — чистый шум, но ученик заранее этого не знает.
После 10 писем: на своих 1.00, на новых 0.75
После 100 писем: на своих 0.93, на новых 0.90
На десяти письмах ученик не ошибся ни разу, но граница у него косая: случайный разброс по длине письма он принял за закономерность. На ста письмах шум усреднился. Под каждой панелью две цифры, и расходятся они по-разному. Какая из них говорит об обучении, проще всего увидеть, меняя количество опыта руками.
Пурпурная линия ученика — это кривая обучения (learning curve): P на новых данных как функция от количества опыта. В ней всё определение Митчелла: линия идёт вверх — программа учится, линия плоская — не учится.
Учится та программа, у которой с опытом растёт P на данных, которых она не видела.
«Научиться — значит запомнить обучающие данные». Наоборот: таблица ответов даёт безупречную P на собственном опыте и ничего не даёт на новом письме. Мерка P всегда про новые случаи.
То же самое формулой: два риска
У двух линий из виджета есть имена. Чтобы их записать, договоримся об обозначениях: конспект и слайды пишут одно и то же разными буквами, и на экзамене пригодятся оба набора.
| Что | Конспект | Слайды |
|---|---|---|
| модель и её параметры | \(f_\theta(x)\), параметры \(\theta\) | \(g(x|\vb{w})\), веса \(\vb{w}\) |
| правильный ответ | \(t\) | \(t_n\), target |
| ошибка на одном примере | \(L(f_\theta(x), t)\), loss | \(E(x_n, \vb{w})\), появится вместе с SGD |
| ошибка на всех данных | — | \(E(\vb{w})\), error function |
Дальше в курсе идут обозначения профессора. Только для ошибки на одном примере в этом уроке оставим \(L\) из конспекта: так пишут в учебниках, и буква не сливается с остальными E. На слайдах \(L\) позже достанется другой величине, likelihood (урок 15).
Буква E в этом уроке занята трижды. E у Митчелла — опыт (experience). \(E(\vb{w})\) на слайдах — функция ошибки (error function). \(\E[\,\cdot\,]\) в формулах — математическое ожидание (expectation). Конспект на стр. 10 смешал первую и третью; ниже видно, чем это кончается.
-
Ошибка на одном примере. Для классификации самая простая мерка — 0–1 loss: ноль за верный ответ, единица за неверный.
\[ L = \begin{cases} 0, & g(x|\vb{w}) = t \\ 1, & g(x|\vb{w}) \ne t \end{cases} \]Для регрессии берут квадрат отклонения: \(L = (t - g(x|\vb{w}))^2\).
-
Чего мы хотим на самом деле: мало ошибаться на всех письмах, которые когда-либо придут. Они приходят из распределения \(p_{\mathrm{data}}(x, t)\). Средняя ошибка по нему называется expected risk:
\[ R(\vb{w}) = \E_{p_{\mathrm{data}}}\bigl[\,L\bigl(g(x|\vb{w}),\,t\bigr)\bigr] \]Для 0–1 loss это вероятность ошибиться на новом письме, то есть \(R = 1 - \mathrm{accuracy}\). Круг в виджете показывал \(1 - R\).
-
Беда в том, что \(p_{\mathrm{data}}\) никто не знает. Есть только опыт: \(N\) примеров. Заменим ожидание средним по ним и получим empirical risk:
\[ \hat R_N(\vb{w}) = \frac{1}{N}\sum_{n=1}^{N} L\bigl(g(x_n|\vb{w}),\,t_n\bigr) \]Квадрат в виджете показывал \(1 - \hat R_N\).
-
Почему замена законна. Если веса зафиксированы, а примеры независимо взяты из \(p_{\mathrm{data}}\), среднее по выборке сходится к ожиданию: закон больших чисел.
\[ \hat R_N(\vb{w}) \;\longrightarrow\; R(\vb{w}) \quad \text{при}\;\; N \to \infty \]Чем больше примеров, тем точнее посчитанная ошибка показывает настоящую. Поэтому веса, подобранные по большой выборке, хороши и на новых данных: отсюда «больше E — лучше P».
-
Обучение — выбрать веса, при которых мала та ошибка, которую можно посчитать:
\[ \hat{\vb{w}} = \argmin_{\vb{w}}\; \hat R_N(\vb{w}) \]Но теперь веса подогнаны под эти самые \(N\) примеров, и шаг 4 для них уже не работает: \(\hat R_N(\hat{\vb{w}})\) в среднем меньше, чем \(R(\hat{\vb{w}})\). Разность \(R(\hat{\vb{w}}) - \hat R_N(\hat{\vb{w}})\) называется generalization gap; в виджете это число «разрыв». У зубрилы \(\hat R_N = 0\) и \(R = 0.5\): разрыв 0.5 при любом опыте.
-
Как это выглядит на слайдах. Профессор берёт квадратичную ошибку и не пишет множитель \(1/N\):
\[ E(\vb{w}) = \sum_{n=1}^{N} \bigl(t_n - g(x_n|\vb{w})\bigr)^2 \]Это Sum of Squared Errors, то есть \(N \cdot \hat R_N\) с квадратичным loss. Множитель \(N\) не меняет точку минимума, так что \(\hat{\vb{w}}\) та же.
Круг в виджете удалось посчитать точно только потому, что мы сами придумали, как устроена почта. В настоящей задаче \(p_{\mathrm{data}}\) неизвестно, и \(R\) оценивают на отложенных примерах, которых программа не видела. Как делать это правильно — урок 18.
Если нас интересует accuracy, почему при обучении минимизируют не её?
Потому что 0–1 loss — ступенька. Сдвинь вес чуть-чуть, и число ошибок не изменится: производная почти везде равна нулю, и спуску по градиенту не за что зацепиться (урок 13). При обучении берут гладкую замену, квадратичную ошибку или cross-entropy (урок 15), а accuracy считают потом как отчётную мерку.
На слайде 4 лекции 1 у профессора P — это errors, или loss. Для курса это верно, с двумя уточнениями: P меряют на новых данных, а функция, которую минимизируют, может не совпадать с меркой, по которой отчитываются.
Какой P выбрать: accuracy или F1
Теперь фильтр B: 95 % верных ответов на новых письмах и ни одного пойманного спама. Здесь P измерена честно, на новых данных. Подвела сама мерка.
Чтобы это увидеть, одной цифры мало, нужны четыре. Возьмём 200 новых писем, из них 45 — спам. Класс, который мы ищем, называют positive; здесь это спам. Каждое письмо попадает в одну из четырёх клеток матрицы ошибок (confusion matrix).
| на самом деле | ответ «спам» | ответ «не спам» |
|---|---|---|
| спам, 45 | TP = 40 | FN = 5 |
| не спам, 155 | FP = 10 | TN = 145 |
TP (true positive) — спам пойман. FN (false negative) — спам пропущен. FP (false positive) — ложная тревога: нужное письмо улетело в спам. TN (true negative) — обычное письмо не тронуто. Из этих четырёх чисел собираются все мерки классификации.
\[ \mathrm{accuracy} = \frac{\mathrm{TP} + \mathrm{TN}}{\mathrm{TP} + \mathrm{FP} + \mathrm{FN} + \mathrm{TN}} \]
\[ \mathrm{precision} = \frac{\mathrm{TP}}{\mathrm{TP} + \mathrm{FP}} \]
\[ \mathrm{recall} = \frac{\mathrm{TP}}{\mathrm{TP} + \mathrm{FN}} \]
\[ F_1 = \frac{2 \cdot \mathrm{precision} \cdot \mathrm{recall}}{\mathrm{precision} + \mathrm{recall}} \]
- accuracy
- доля верных ответов среди всех писем
- precision
- из того, что фильтр назвал спамом, сколько действительно спам
- recall
- из всего настоящего спама сколько поймано
- \(F_1\)
- гармоническое среднее precision и recall: высокое, только когда высоки обе
Подставим числа из таблицы. Accuracy: \(185 / 200 = 0.925\). Precision: \(40 / 50 = 0.800\). Recall: \(40 / 45 = 0.889\). И F1:
\[ F_1 = \frac{2 \cdot 0.800 \cdot 0.889}{0.800 + 0.889} = 0.842 \]На экзамене F1 быстрее и точнее считать сразу по клеткам: \(F_1 = \frac{2\,\mathrm{TP}}{2\,\mathrm{TP} + \mathrm{FP} + \mathrm{FN}} = \frac{80}{95}\). Заодно видно главное: в этой формуле нет TN. Письма, которые фильтр правильно не тронул, в зачёт не идут.
Пока спама в почте много, accuracy и F1 рассказывают одну историю. Посмотри, что будет, когда его станет мало.
Мерку P выбирают под задачу: когда positive класс редкий, смотри на precision, recall и F1, а не на accuracy.
Supervised learning: что лежит в опыте и что получается на выходе
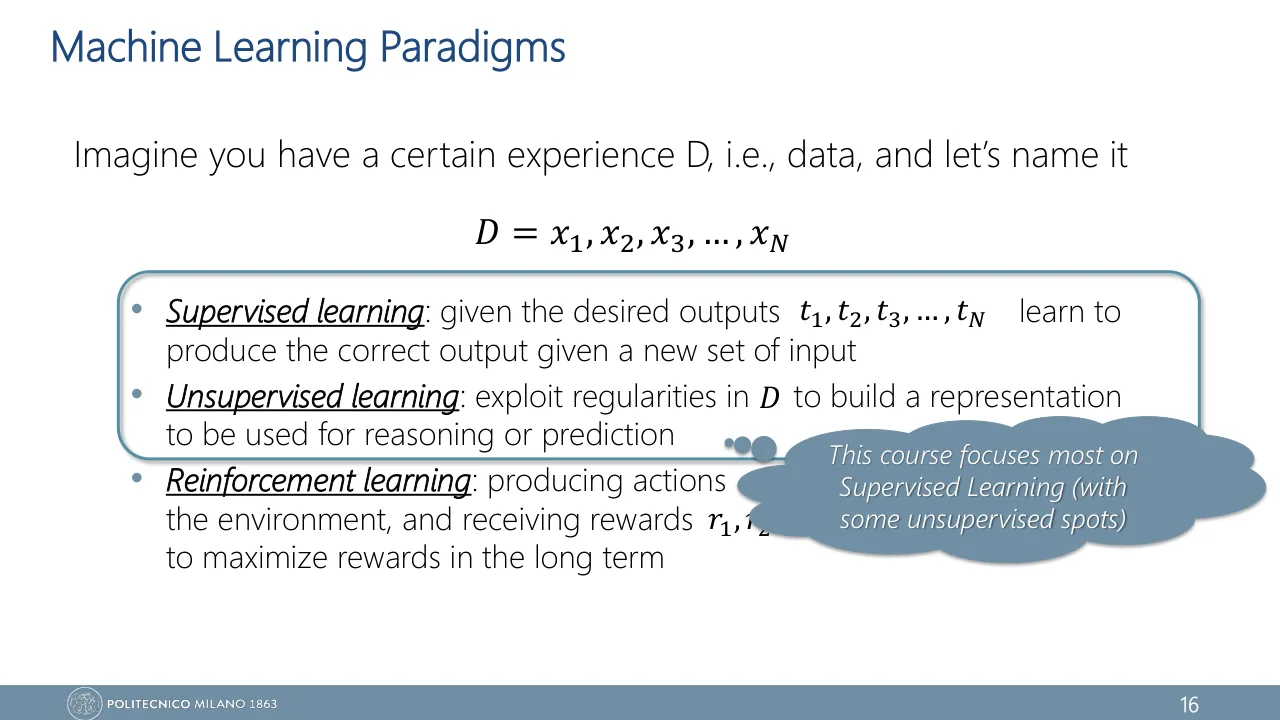
Определение Митчелла не говорит, из чего состоит опыт. Именно по этому признаку задачи делят на три парадигмы (paradigms). На слайде 5 лекции 1 профессор записывает все три одной строкой: пусть опыт — это данные \(D = x_1, x_2, \dots, x_N\).
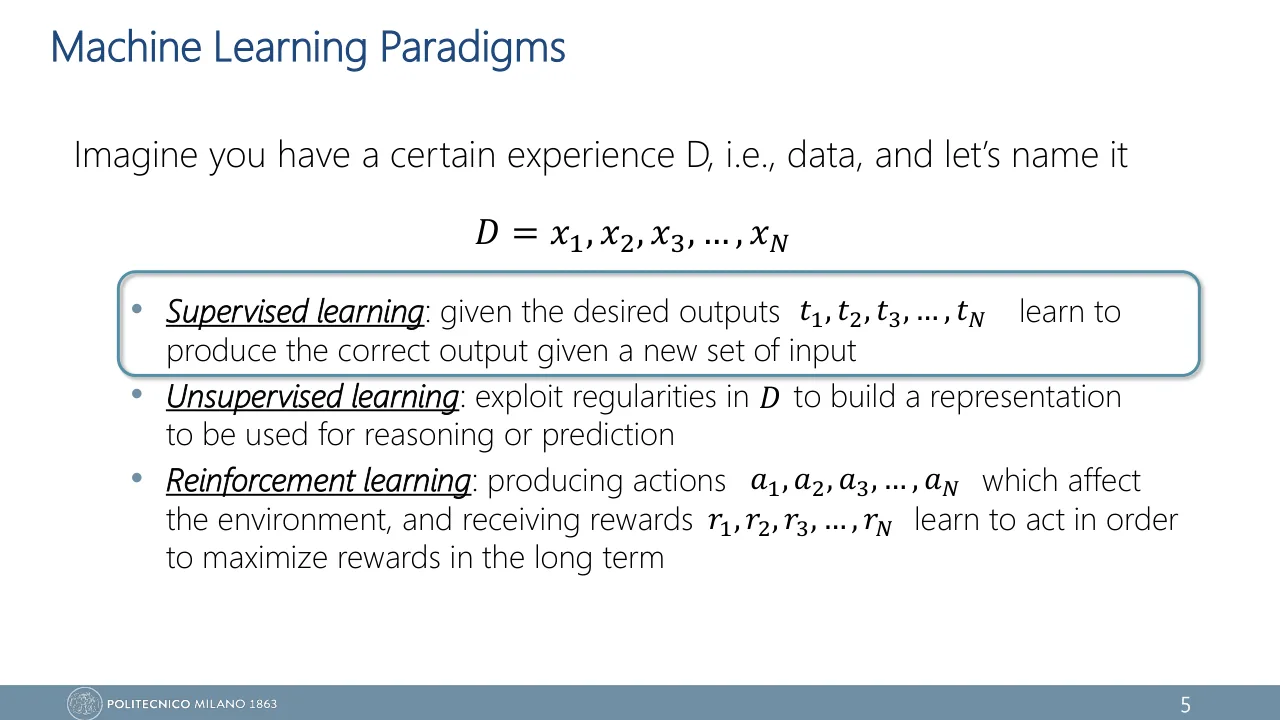
Три парадигмы на одном слайде
- Supervised learning (обучение с учителем). К каждому \(x_n\) дан желаемый выход \(t_n\). Цель — выдавать правильный выход для нового входа.
- Unsupervised learning. Есть только \(x_n\). Цель — по закономерностям в \(D\) построить представление данных (representation), пригодное для рассуждений и предсказаний. Кластеризация из Applied Statistics живёт здесь.
- Reinforcement learning. Программа совершает действия \(a_1, \dots, a_N\), которые меняют среду, и получает награды \(r_1, \dots, r_N\). Цель — выучить стратегию действий (policy), при которой награда как можно больше на длинной дистанции.
Почти любая задача машинного обучения относится к одной из трёх парадигм или сочетает их.
Конспект рисует ту же картину на трёх учениках: одному дают задачи с ответами, второму — стопку задач без ответов, третьему — игру, где за удачный ход начисляют очки. Курс в основном про первую строку и изредка заходит во вторую: так написано на слайде 16. Вторую и третью разберём в следующем уроке.
Classification и regression: всё решает target
В supervised learning опыт — это набор пар \(D = \{(x_1, t_1), \dots, (x_N, t_N)\}\), модель — функция \(g(x|\vb{w})\), которая должна выдавать \(g(x_n|\vb{w}) \approx t_n\), а обучение — подбор весов, при которых ошибка мала. Два вида задач различаются только тем, что такое \(t\).
Classification — target есть метка класса из конечного набора: \(g : \mathcal{X} \to \{1, \dots, K\}\). Два класса, \(\{0, 1\}\), — binary classification (спам или нет). Больше двух — multi-class (цифры от 0 до 9).
Regression — target есть вещественное число: \(g : \mathcal{X} \to \R\).
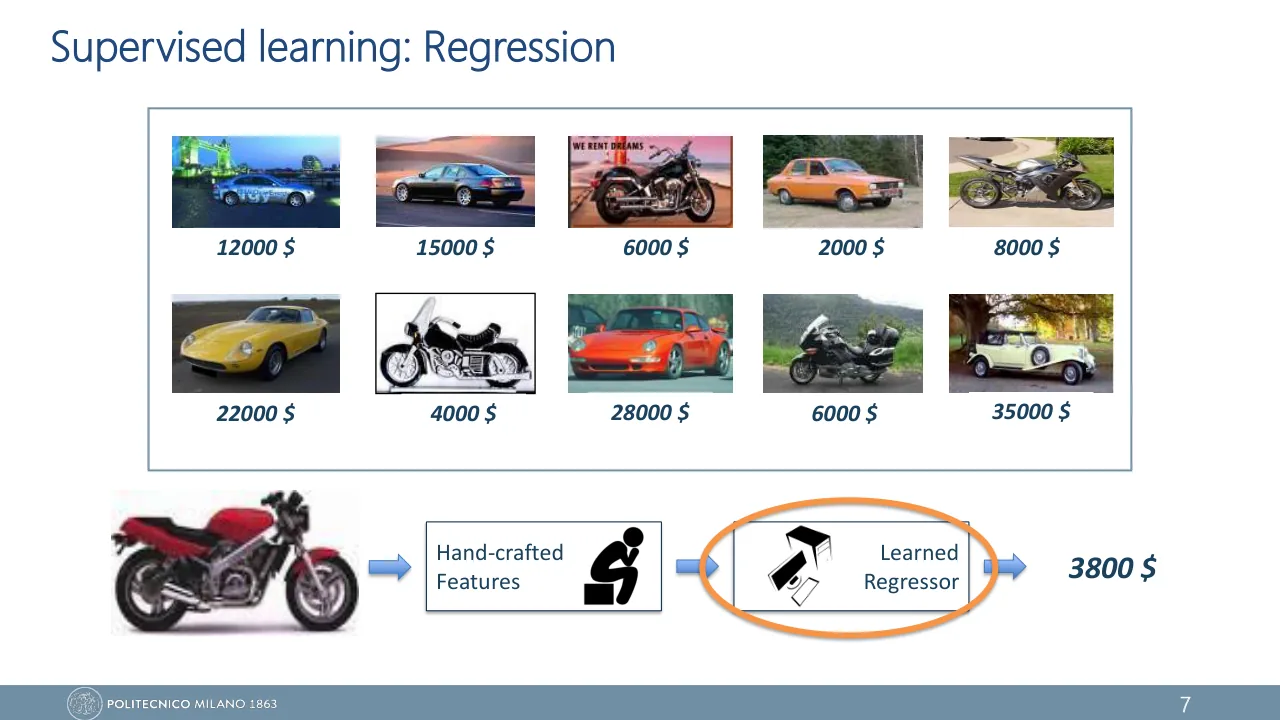
Профессор показывает разницу на одних и тех же фотографиях. На слайде 6 они разложены в два ящика, Cars и Motorcycles, и красный мотоцикл получает ответ «Motorcycle». На слайде 7 под теми же фотографиями стоят цены, от 2000 до 35000 долларов, и тот же красный мотоцикл получает ответ 3800 $.
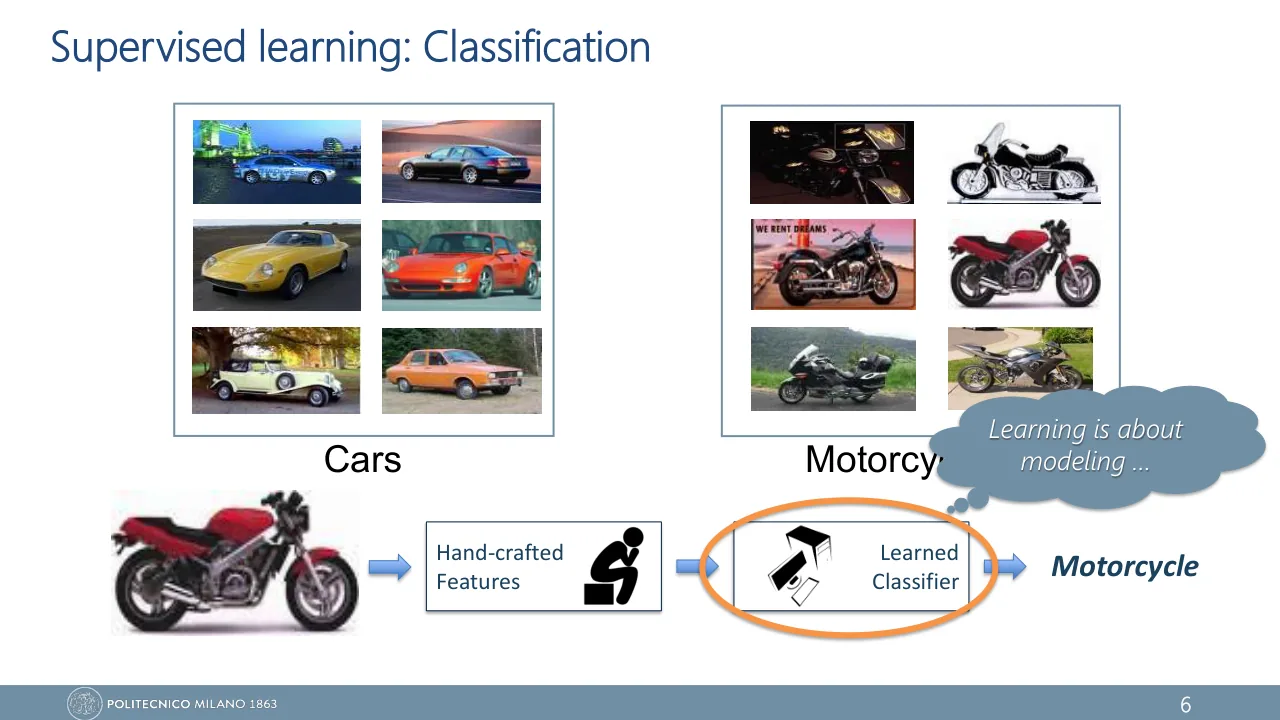
T: отличить машину от мотоцикла.
E: фотографии с метками класса.
P: accuracy, F1.
Выход: «Motorcycle».
T: предсказать цену.
E: те же фотографии с ценами.
P: MSE, MAE, \(R^2\).
Выход: 3800 $.
Вход тот же, устройство программы то же. Поменялся только target — и задача стала другой. Конспект заменил этот пример ценами домов, и главная мысль слайдов в нём потерялась.
А оценка в звёздах от 1 до 5 — это classification или regression?
Пограничный случай: классов конечное число, но они упорядочены, и ошибиться на одну звезду лучше, чем на четыре. Допустимы обе постановки, и выбор между ними — это выбор функции ошибки: classification штрафует любой промах одинаково, regression — тем сильнее, чем дальше ответ от правильного.
Чем мерить regression
В регрессии нет «верно» и «неверно», есть только «насколько мимо». Конспект называет три мерки, но не выписывает их. Вот они в обозначениях профессора.
\[ \mathrm{MSE} = \frac{1}{N}\sum_{n=1}^{N} \bigl(t_n - g(x_n|\vb{w})\bigr)^2 \]
\[ \mathrm{MAE} = \frac{1}{N}\sum_{n=1}^{N} \bigl|\,t_n - g(x_n|\vb{w})\,\bigr| \]
\[ R^2 = 1 - \frac{\sum_n \bigl(t_n - g(x_n|\vb{w})\bigr)^2}{\sum_n (t_n - \bar t\,)^2} \]
- MSE
- mean squared error: средний квадрат промаха; это SSE профессора, делённая на \(N\)
- MAE
- mean absolute error: средний промах в тех же единицах, что и target
- \(R^2\)
- коэффициент детерминации из Applied Statistics: 1 — идеально, 0 — не лучше, чем всегда отвечать средним \(\bar t\), меньше нуля — хуже этого; к риску \(R(\vb{w})\) отношения не имеет
Посчитаем на трёх фотографиях со слайда 7 с ценами 4000, 6000 и 12000 долларов. Пусть модель ответила 3800, 7000 и 10000.
| \(t_n\) | \(g(x_n|\vb{w})\) | промах | квадрат промаха |
|---|---|---|---|
| 4000 | 3800 | 200 | 40 000 |
| 6000 | 7000 | −1000 | 1 000 000 |
| 12000 | 10000 | 2000 | 4 000 000 |
| сумма | 3200 по модулю | 5 040 000 | |
Из последней строки получаются две первые мерки. MAE выходит в долларах, MSE — в долларах в квадрате.
\[ \mathrm{MAE} = \frac{3200}{3} \approx 1067 \] \[ \mathrm{MSE} = \frac{5\,040\,000}{3} = 1\,680\,000 \]Для \(R^2\) нужен разброс самих цен вокруг среднего \(\bar t = 7333\): сумма квадратов отклонений от него равна 34 666 667.
\[ R^2 = 1 - \frac{5\,040\,000}{34\,666\,667} = 0.855 \]Модель объясняет 85 % разброса цен. И обрати внимание на третью строку таблицы: один промах на 2000 даёт четыре пятых всей суммы квадратов. Квадрат наказывает крупные ошибки гораздо сильнее мелких, а MAE считает все доллары одинаково.
Конвейер из двух коробок
Осталось посмотреть, как supervised learning делали до deep learning. На слайдах 6 и 7 под фотографиями нарисован один и тот же конвейер.
- Hand-crafted features, признаки ручной работы. Сырые данные слишком сложны для простой модели, поэтому человек придумывает, какие числа из них вынуть: для фото — края, углы и формы колёс, для текста — частоты слов, для звука — высоту тона и MFCC, для цены дома — число комнат, площадь и расстояние до центра. В примере конспекта с мотоциклами признаков три (число круглых форм, преобладающий цвет, гистограмма направлений краёв), и фото превращается в вектор вроде \([2,\ 0.6,\ 0.8]\). Эта коробка решает, какая информация вообще дойдёт до модели.
- Learned classifier (или regressor). Модель, которая по векторам признаков проводит границу между классами (decision boundary) или подгоняет функцию. Только здесь параметры подбираются по данным. На слайде 6 обведена именно эта коробка, а выноска рядом говорит, что обучение — это про моделирование.
Это похоже на таможню: чиновник придумал анкету, а инспектор решает только по её графам. Если в анкете нет нужного вопроса, опыт инспектору не поможет.
«Всю трудную работу делает классификатор». В классическом конвейере её делает человек, придумавший признаки. Правило из конспекта «два колеса — мотоцикл, четыре — машина» выглядит надёжным, пока не посмотришь на фотографии со слайда 6 лекции 1: часть машин там снята сбоку, и колёс на фото видно тоже два. Информацию, которую выбросили признаки, не восстановит ни один классификатор.
В deep learning две коробки сливаются в одну: сеть сама учит признаки из сырых данных (пикселей, звука, текста), а человек больше не пишет анкету. Конвейер становится одним шагом «сырые данные → сеть → ответ»; это называют end-to-end. Почему это меняет всё — урок 3.
Развязка: два фильтра из начала урока
Обе цифры из завязки были честными, и обе обманывали. Теперь понятно, чем именно.
Ошибка в том, на чём измерена P. Сто процентов — это empirical risk, равный нулю, на тех самых письмах, которые были опытом. У таблицы ответов он нулевой всегда. На новых письмах тот же фильтр прав в половине случаев.
Ошибка в том, чем измерена P. В почте 5 % спама, фильтр не помечает ничего и прав на всех обычных письмах. Accuracy 0.95, recall 0, F1 = 0.
Чтобы сказать «программа научилась», определение Митчелла требует трёх вещей сразу. Мерка P должна подходить к задаче T. Мерить её надо на данных, которых не было в опыте E. И она должна расти, когда опыта становится больше. Фильтр A и курсант, выучивший один маршрут, не проходят по второму пункту, фильтр B — по первому. Все следующие уроки, от перцептрона до dropout, будут разными ответами на один вопрос: как устроить программу, чтобы все три условия выполнялись.
В формате экзамена
State Mitchell's definition of what it means for a computer program to learn. Then give T, E and P for (a) an email spam filter and (b) a chess program that trains by playing against itself.
Show model answer
A computer program learns from experience E with respect to a class of tasks T and a performance measure P if its performance at the tasks in T, as measured by P, improves with experience E.
(a) T: classify an email as spam or not spam. E: a set of emails labelled with both classes. P: accuracy (or error rate, or F1) on emails not used for training.
(b) T: play chess. E: the games played against itself. P: the fraction of games won.
Проверяют три вещи: все три буквы на месте и слово improves (в учебнике improves with experience E, на слайде 4 лекции 1 improves because of experience E; годится любой вариант); T — это действие («играть», «классифицировать»), а не результат («выигрывать»); P измеряется на новых данных. Потерять балл легче всего, написав в (b) T: win games.
A spam filter is evaluated on 200 unseen emails (positive class = spam): TP = 40, FP = 10, FN = 5, TN = 145. Compute the F1 score. Give three decimals.
Show model answer
Precision \(= 40 / (40 + 10) = 0.800\). Recall \(= 40 / (40 + 5) = 0.889\).
\[ F_1 = \frac{2 \cdot 0.800 \cdot 0.889}{0.800 + 0.889} = 0.842 \]Directly from the counts: \(F_1 = \frac{2 \cdot 40}{2 \cdot 40 + 10 + 5} = \frac{80}{95}\). For comparison, accuracy \(= 185 / 200 = 0.925\).
Типичные потери: посчитать accuracy вместо F1 или перепутать FP и FN местами. Во втором случае F1 не изменится, формула симметрична по FP и FN, но precision и recall поменяются ролями, и ответ на вопрос о любой из них будет неверным. Считай по клеткам и не округляй промежуточные числа.
Only 5% of the emails in a mailbox are spam. Which is more informative for evaluating a spam filter, accuracy or F1? Explain why.
Show model answer
F1. With strong class imbalance accuracy is dominated by the majority class: a filter that always answers "not spam" reaches 95% accuracy while detecting no spam at all. F1 is the harmonic mean of precision and recall of the positive (spam) class and does not count true negatives; for that trivial filter recall is 0, so F1 is 0.
Ответ без примера «всегда отвечает not spam — и получает 95 %» выглядит заученным. Одно предложение с этим числом показывает, что механизм понят.
A regressor predicts vehicle prices. The targets are 4000, 6000 and 12000 dollars, the predictions are 3800, 7000 and 10000 dollars. Compute \(R^2\). Give three decimals.
Show model answer
Residual sum of squares: \(200^2 + 1000^2 + 2000^2 = 5\,040\,000\).
Mean target: \(22000 / 3 = 7333.3\). Total sum of squares:
\[ 3333.3^2 + 1333.3^2 + 4666.7^2 = 34\,666\,667 \] \[ R^2 = 1 - \frac{5\,040\,000}{34\,666\,667} = 0.855 \]For the same data MSE \(= 1\,680\,000\) and MAE \(= 1066.7\) dollars.
Проверяют, знаешь ли ты, что стоит в знаменателе: разброс target вокруг среднего target, а не вокруг предсказаний. Вторая частая ошибка — забыть «один минус» и ответить 0.145.
Which of the following are classification tasks? Select all that apply.
Show model answer
Digit recognition and spam detection. In both the target is a label from a finite set. Price and temperature are real-valued targets (regression); grouping unlabelled photos has no targets at all (clustering).
Ловушек две: «числовая метка — значит regression» и «разложить по группам — значит classification». Classification требует, чтобы названия групп были даны заранее в виде target.
A spam filter reaches 100% accuracy on the emails it was trained on. Explain why this does not show that it has learned, and how its performance should be measured instead. Refer to empirical and expected risk.
Show model answer
Accuracy on the training emails is one minus the empirical risk, i.e. the average loss over the N examples that were used to choose the parameters. What we care about is the expected risk: the average loss over the unknown data distribution, i.e. over new emails.
Because the parameters were fitted to those N examples, the empirical risk is an optimistically biased estimate of the expected risk. A lookup table that memorises the training set has zero empirical risk but answers new emails at chance level.
Performance must therefore be estimated on data not used for training (a test set). By Mitchell's definition the program has learned if this performance improves as its experience grows.
Полный балл — за пару терминов empirical / expected risk, за слово optimistic (или biased) и за контрпример с таблицей. Фраза «потому что это overfitting» без объяснения механизма тянет на половину.
Проверь себя
За неделю accuracy спам-фильтра на новых письмах выросла с 0.90 до 0.94. Новых данных ему не давали: программист вручную дописал три правила. Научилась ли программа по Митчеллу?
У программы X доля верных ответов на своих письмах 1.00, на новых 0.50, и так при любом N. У программы Y на своих 0.93, на новых 0.90, и вторая цифра росла вместе с N. Что верно?
Обе программы видны в первом виджете: X — зубрила, Y — ученик при N = 400.
У ученика в виджете P на новых письмах не поднялась выше 0.90 даже при N = 400. Почему?
В тесте 1000 транзакций, 10 из них мошеннические (positive класс). Модель не отметила ни одной. Чему равны accuracy и F1?
Какие из задач — regression?
На слайдах 6 и 7 лекции 1 одни и те же фотографии и один и тот же конвейер. Что превращает задачу из classification в regression?
В классическом конвейере единственный признак — число круглых форм на фото. Для мотоцикла и для машины, снятой сбоку, он равен 2. Что исправит более мощный классификатор?
Унести с собой
- По Митчеллу программа учится, если её P на задачах T растёт благодаря опыту E. На слайде 4 лекции 1: T — regression или classification, E — данные, P — ошибки, или loss.
- P меряют на данных, которых не было в опыте. На своих данных оценка в среднем приукрашена (empirical risk ниже, чем expected risk), а у таблицы ответов empirical risk равен нулю при любом опыте.
- Кривая обучения — P на новых данных как функция от количества опыта. Она растёт и выходит на потолок, который ставят данные или сама модель.
- Мерку выбирают под задачу. Когда positive класс редкий, accuracy хвалит модель, которая ничего не делает; precision, recall и F1 — нет.
- Парадигмы различаются содержимым опыта: \(x\) и \(t\), только \(x\), действия и награды.
- Classification и regression различаются только типом target: метка класса или число.
- В классическом конвейере признаки придумывает человек, а учится только вторая коробка — классификатор или регрессор.
Что посмотреть и почитать
-
A Visual Introduction to Machine Learning, Part 1
R2D3 · Stephanie Yee, Tony Chu10 мин
Одна задача (дом в Сан-Франциско или в Нью-Йорке?) на движущихся точках. Пролистывая, назови T, E и P и найди место, где точность падает на домах, которых модель не видела. Модель там — дерево решений, а не сеть: бери только постановку.
-
A Neural Network Playground
TensorFlow Playground5 мин
Сейчас нужен один переключатель: Problem type. Поменяй Classification на Regression и посмотри, как при той же сети и тех же входах меняются target и картинка на выходе. Остальное на этой странице понадобится в уроке 3.
-
Deep Learning, глава 5, раздел 5.1
Goodfellow, Bengio, Courvilleоколо 10 страниц
Раздел открывается определением Митчелла и разбирает T, P и E по очереди. Это рекомендованный учебник курса: отсюда стоит взять английские формулировки для открытых вопросов экзамена.
-
Machine Learning (1997)
Tom Mitchell · страница автора
Первоисточник определения. Достаточно первой главы: дословная формулировка и пример с шашками, на котором Митчелл показывает тройку T, E, P.